

26年9月来自清华、港中文、CMU 、北大、新加坡国立、上海AI实验室、加州伯克利分校、华中科技、中科院自动化所、复旦、南洋理工、威斯康星大学、西湖大学、伊利诺伊大学芝加哥分校、香港理工大学和几个创业公司的论文“Recursive Self-Improvement in AI: A Survey”,由 H Wu 等人撰写。
这篇综述的核心观点:AI 已经能够利用自身经验改进模型、记忆、工具和程序,但“系统表现变好”不等于“系统改进自己的能力变强”,更不等于“能够持续加速地自我改进”。 全文最有价值的贡献,是建立了一套区分这些主张、检查实验依据的分析框架。
一、论文研究什么:从“自我改进”到“递归自我改进”
RSI 是 Recursive Self-Improvement,即“递归自我改进”。论文关注的问题是:
一次改进所获得的能力,能否反过来提升系统产生下一次改进的能力?
理解这一定义,需要区分三个层面。
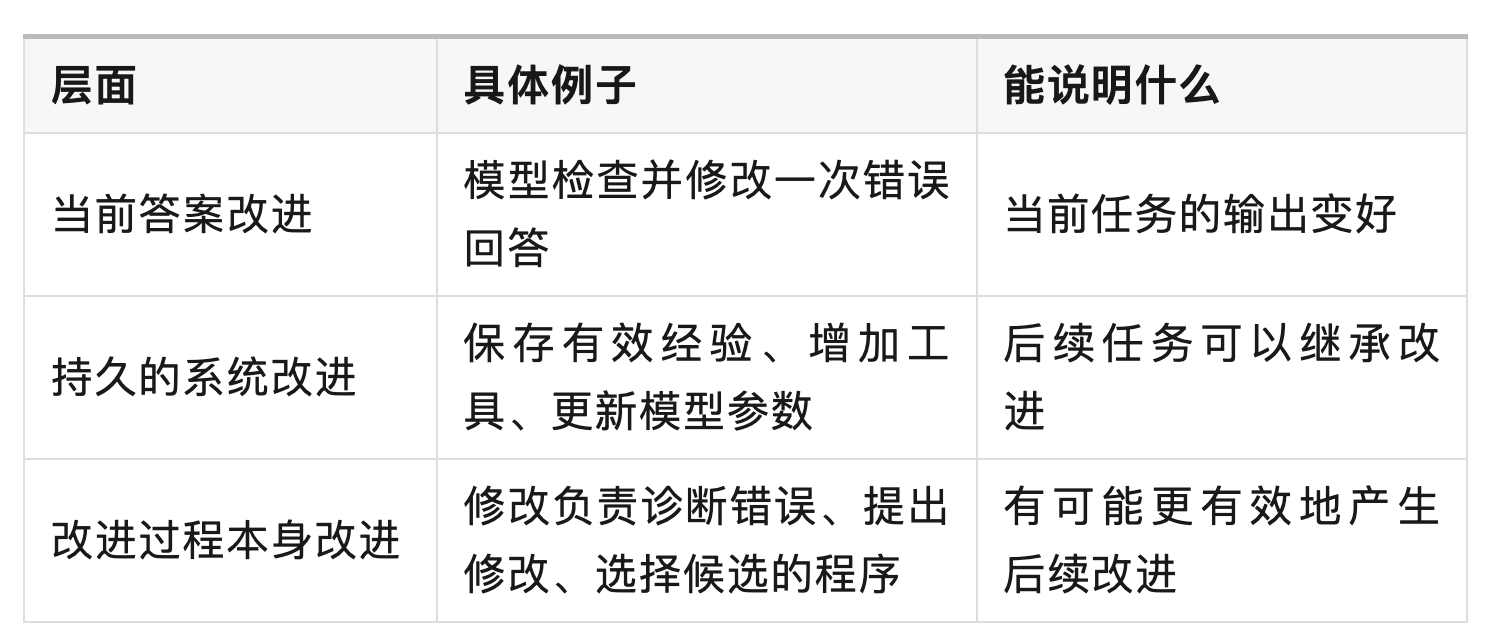
第三种最接近本文关心的 RSI,但修改“改进器”,仍需要证明修改后的改进器更有效。
例如,编程智能体修复用户仓库中的一个错误,属于任务完成;修改自己的修复流程,并使其在新仓库中更有效地修复错误,才提供了改进能力增强的证据。
作者还区分:
结构上的递归:系统存在作用于自身或后续改进过程的反馈路径。
实证上的递归改进:实验表明,这条反馈路径确实提高了后续改进的效果。
这一界限贯穿全文。它也解释为什么论文收录自训练、记忆和自动化设计等研究,却不认为这些工作都已经实现 RSI。
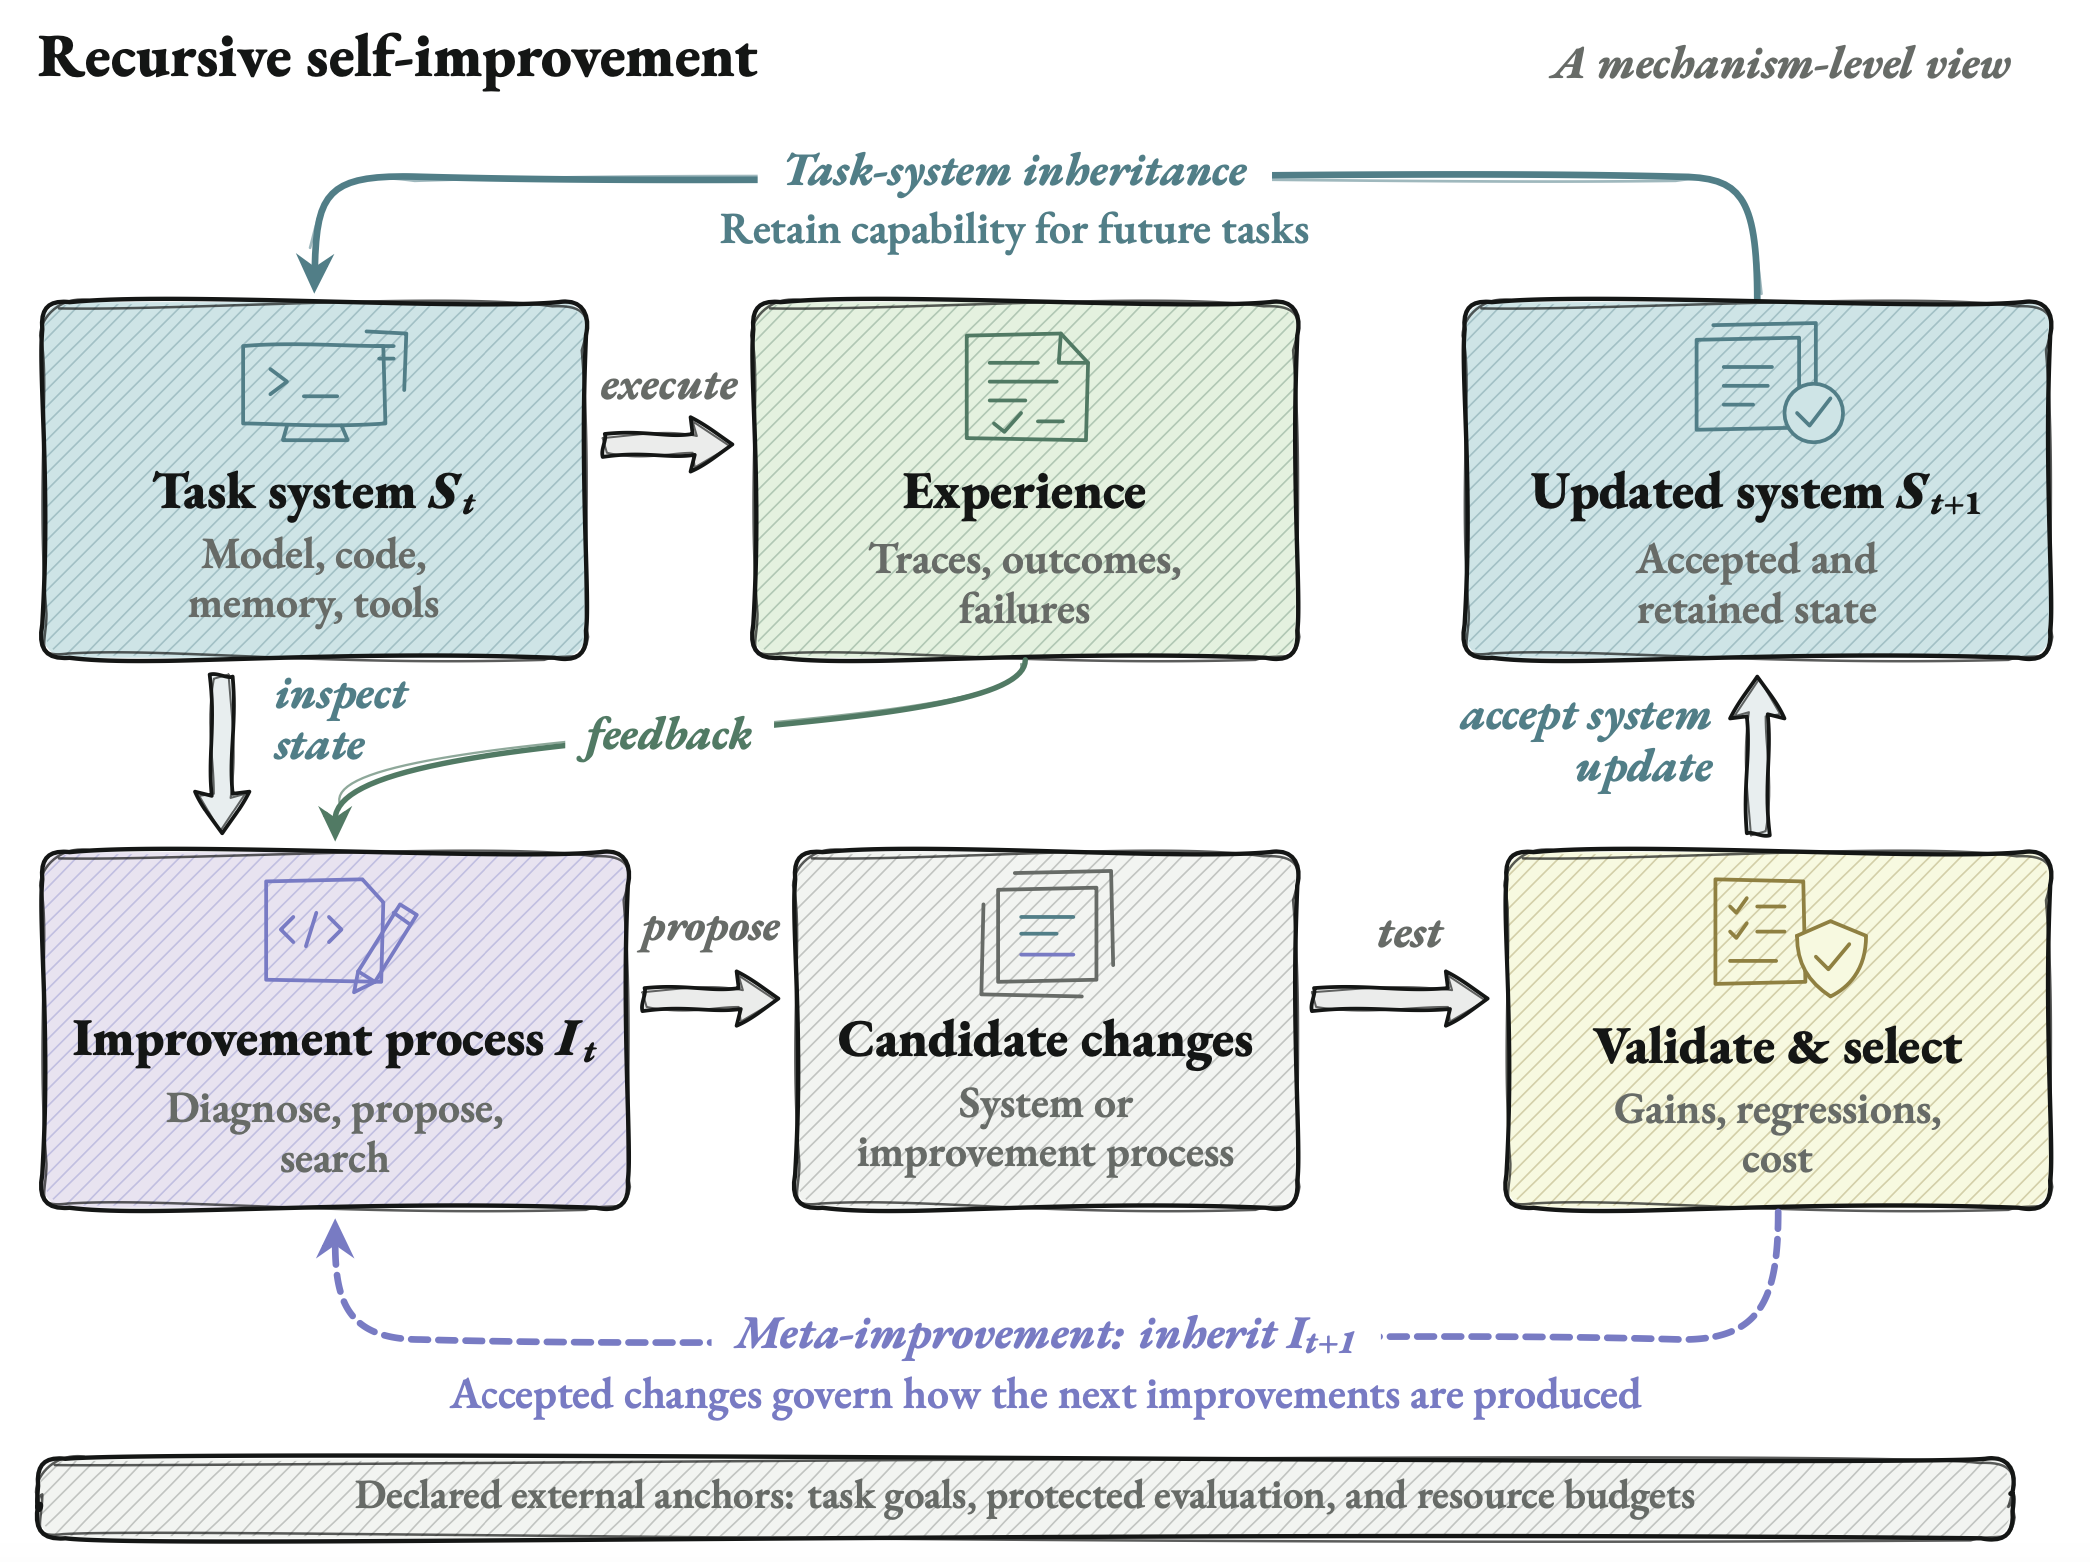
如图 1 所示这是关于递归自我改进(RSI)的机制层面视角。经验为候选变更提供依据,而验证过程则决定了哪些变更得以保留:上层循环将任务系统的状态传递给后续任务;下层虚线循环则将变更传递给负责生成后续改进的流程。外部锚点用于界定更新范围之外的条件。该图示描绘潜在的依赖关系,而非对性能提升的保证。
二、全文的论述结构与详细内容
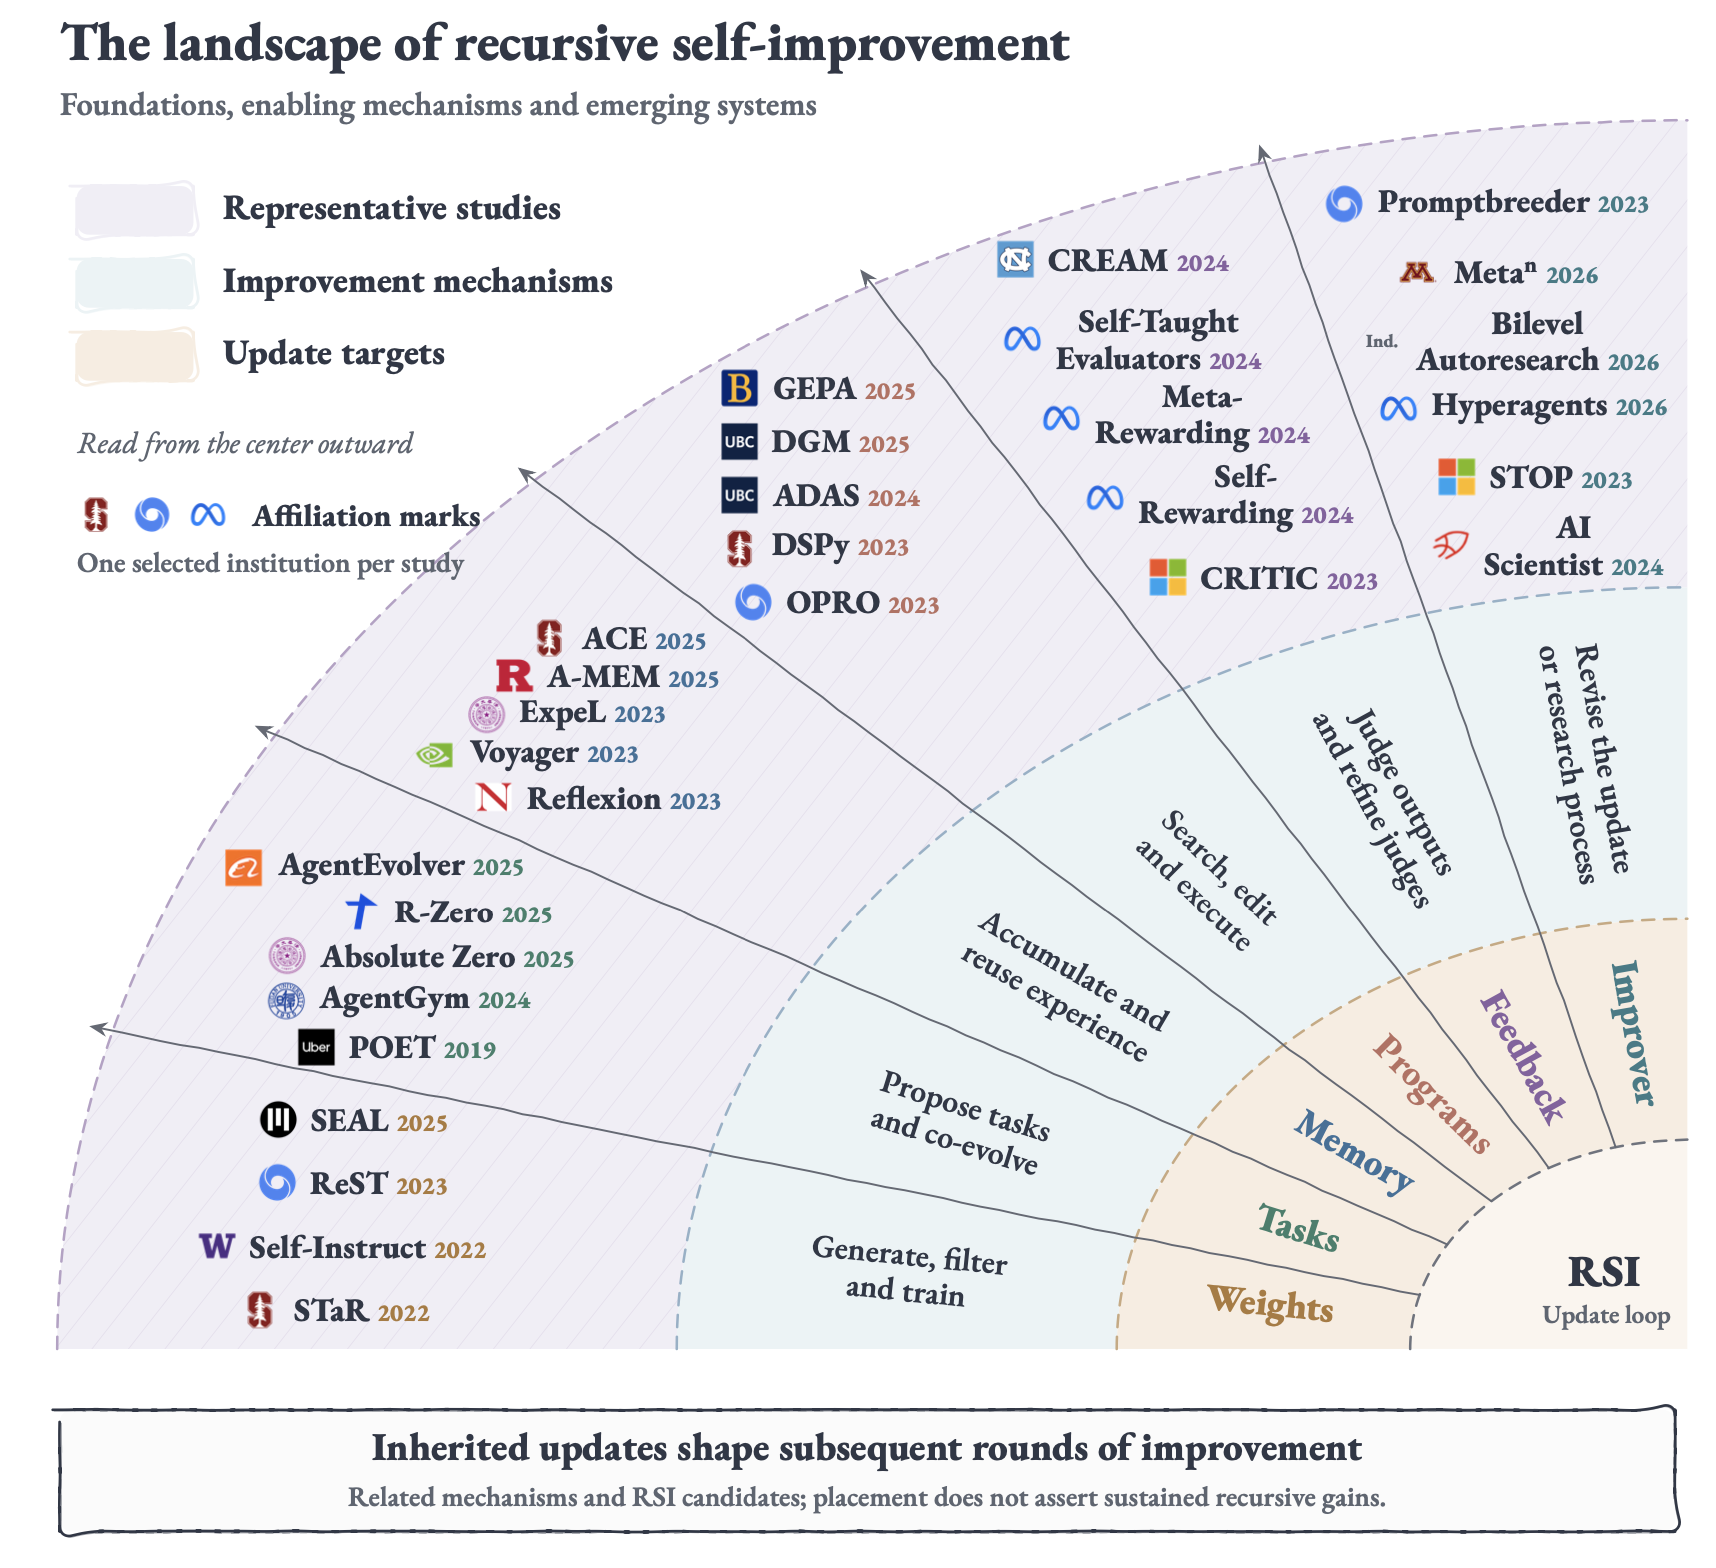
如图 3 所示展示与递归自我改进(RSI)相关机制的概览图。该图将内圈的更新目标、中圈的改进机制以及外圈的代表性研究联系起来。图中的六个扇区涵盖了权重、任务、记忆、程序、反馈及改进过程。单项研究可能涉及多个目标,但在图中的布局仅突出展示了其中一种关联。该图囊括了历史基础、赋能方法以及面向 RSI 的系统。图中的标识代表了入选研究的作者或所属机构,而非基础模型;其他合作机构可能未予列出。
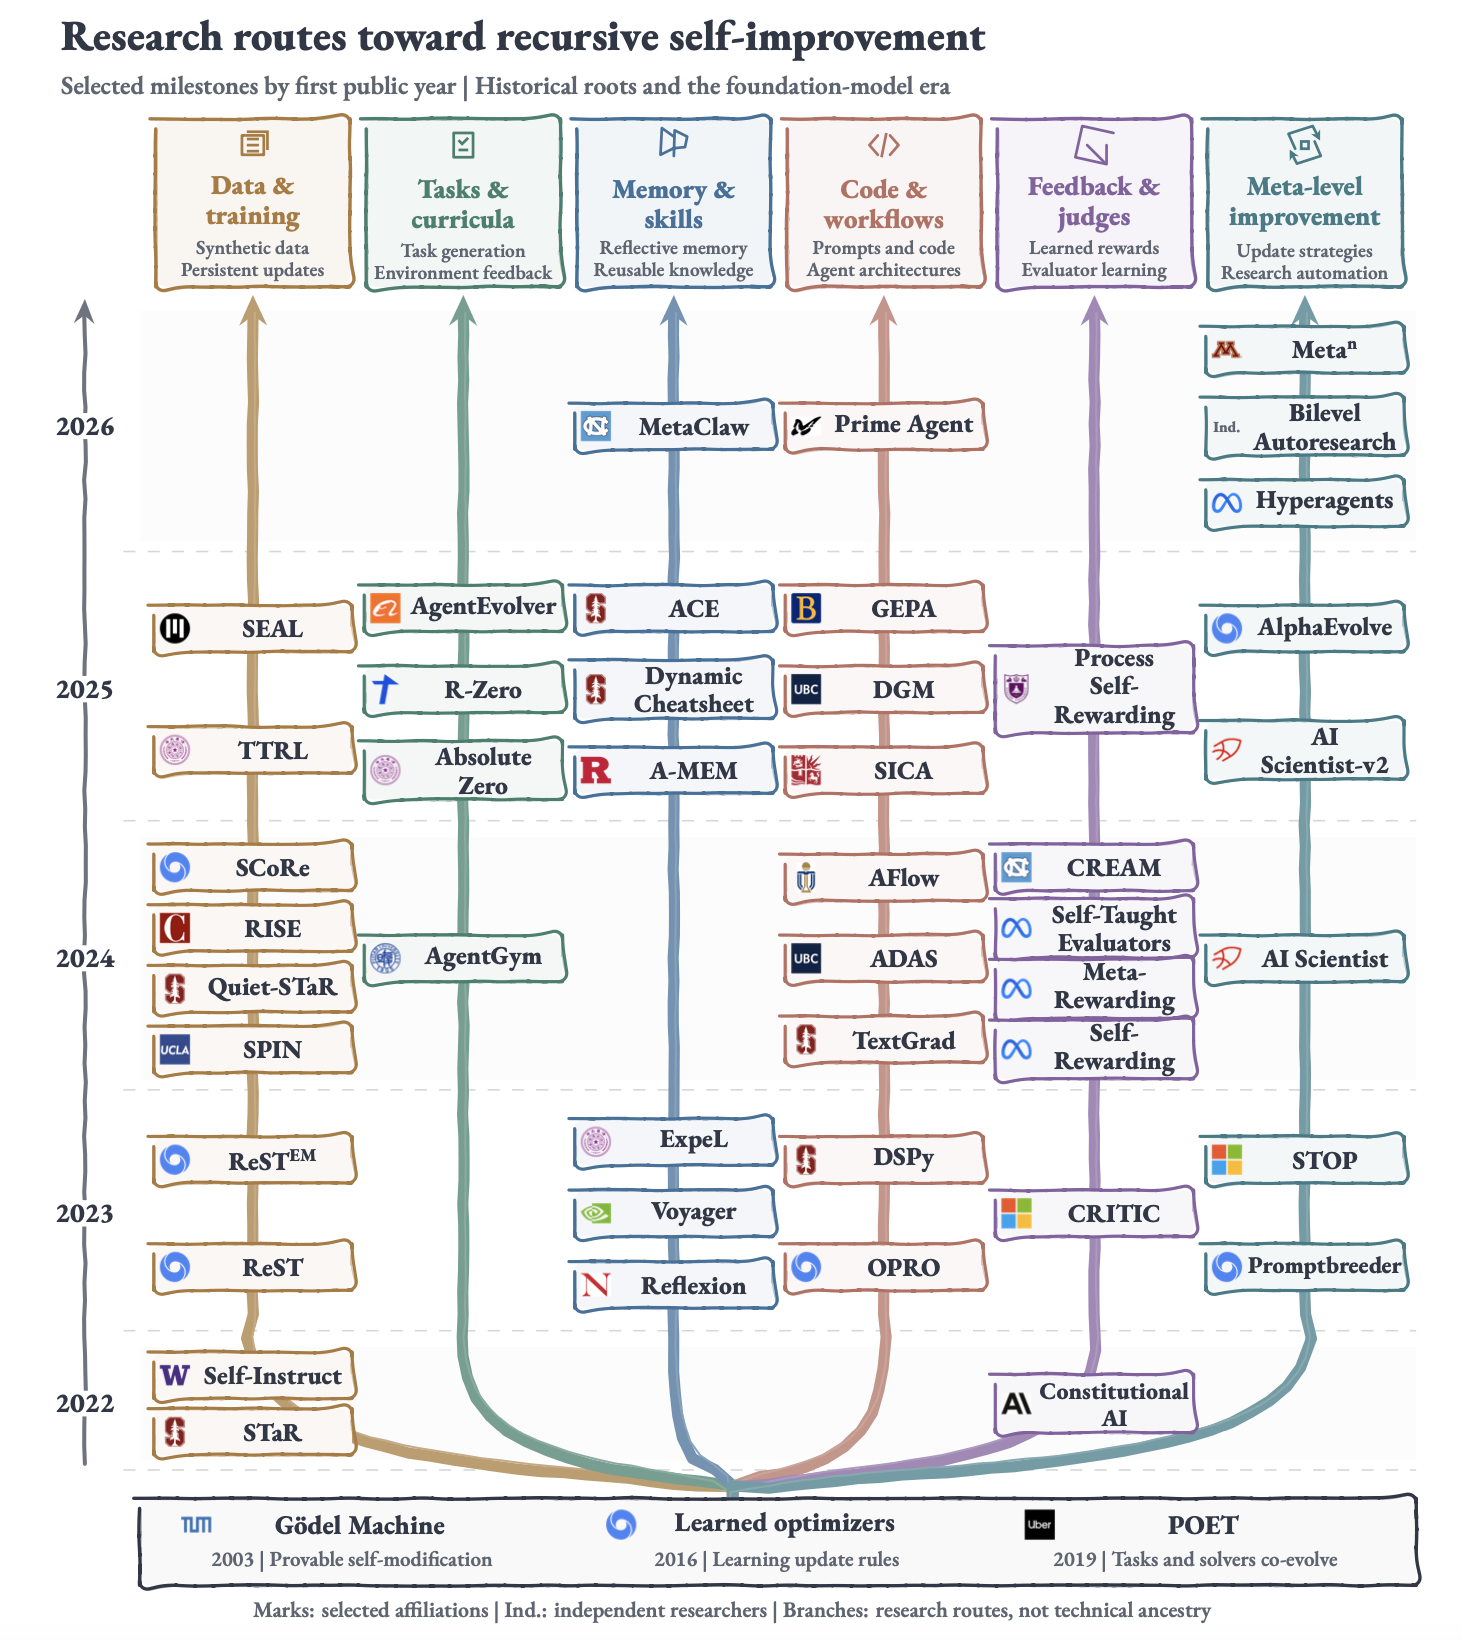
如图 4 所示探索实现递归自我改进的路径。45篇具有代表性的方法论论文被归纳为六条研究路径,并单独标示了三个历史性里程碑。时间段划分基于所查证资料中的首次公开日期;各时间段内的间距已针对可读性进行了调整。分支线条表示相关的研究系列。关于技术传承、跨路径迁移以及持续性递归收益的认定,需依据单独的证据。本选集涵盖了截至2026年9月12日的文献检索结果。标识(Logo)标示了每项研究中选定的一位作者或其所属机构;“Ind.”代表独立研究人员。机构信息及标识来源均有单独记录。
全文主线可以概括为:
定义与历史 → 两类工程目标 → 更新机制 → 代表方法 → 证据评估 → 失败机制与研究方向。
1.研究范围与文献方法:



 扫一扫


 322

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


