


原标题: Real-Time Grasp Detection Using Convolutional Neural Networks
基于卷积神经网络的实时抓取检测
原作者: Joseph Redmon1, Anelia Angelova
论文链接:下载地址 http:// https://link.zhihu.com/?target=https://pjreddie.com/media/files/papers/grasp_detection_1.pdf
-------------------------------------------------------正文开始------------------------------------------------------------
摘要:
我们提出了一种基于卷积神经网络的准确、实时的机器人抓取检测方法。我们的网络在不使用标准滑动窗口或区域提议技术的情况下对可抓取的边界框执行单阶段回归。 该模型的性能优于最先进的方法 14 个百分点,并在 GPU 上以每秒 13 帧的速度运行。 我们的网络可以同时执行分类,以便在一个步骤中识别对象并找到一个好的抓取矩形。 对该模型的修改通过使用局部约束的预测机制来预测每个对象的多个抓取。 局部约束模型的性能明显更好,尤其是在可以以多种方式抓取的对象上。
1、介绍
感知——使用感官(如果你是机器人,则使用传感器)来了解你的环境——很难。 视觉感知涉及将像素值和光信息映射到宇宙模型上以推断您的周围环境。 一般的场景理解需要复杂的视觉任务,例如将场景分割成组成部分,识别这些部分是什么,以及在视觉上相似的对象之间消除歧义。 由于这些复杂性,视觉感知是真实机器人系统的一大瓶颈。
通用机器人需要能够与物理世界中的对象进行交互和操作。 人类看到新奇的物体,几乎本能地立即知道他们将如何抓住它们来捡起它们。 机器人抓取检测远远落后于人类的表现。 我们专注于在给定对象的 RGB-D 视图的情况下找到良好掌握的问题。
我们在 Cornell Grasp Detection Dataset 上进行评估,这是一个包含大量对象和真实标记的抓取的广泛数据集(参见图 1)。 最近对该数据集的工作以每帧 13.5 秒的速度运行,准确率为 75% [1] [2]。 这意味着机器人在查看场景和找到移动抓取器的位置之间有 13.5 秒的延迟。
最常见的抓取检测方法是滑动窗口检测框架。 滑动窗口方法使用分类器来确定图像的小块是否构成对该图像中对象的良好抓取。 这种类型的系统需要将分类器应用于图像上的许多地方。 得分高的补丁被认为是良好的潜在把握。
我们采取不同的方法; 我们将单个网络应用于图像并直接预测抓取坐标。 我们的网络相对较大,但因为我们只将它应用于图像一次,我们获得了巨大的性能提升。
我们的网络不是只查看局部补丁,而是使用图像中的全局信息来告知其掌握预测,使其更加准确。 我们的网络达到了 88% 的准确率,并以实时速度(每秒 13 帧)运行。 这重新定义了 RGB-D 抓取检测的最新技术。
2、相关工作
过去的方法中使用三维模拟去寻找好的抓取位置,其中比较重要的工作有第三个到第七个参考文献,这些方法都是非常有用的,但是是借助全3d模型以及其他关于当前物体的物理信息来找到一个合适的抓取位置。但这种方法并不适用于所有物体,也就是说要抓取的物体不能作为一个先验。通用目的的机器人也许需要抓取新的物体,也就是说他之前并未见到过的物体,没有建立过该物体的3d模型。
机器人系统越来越多地利用RGB-D传感器等数据进行诸如物体识别[8],检测[9] [10]和映射[11] [12]等任务。 像Kinect这样的RGB-D传感器很便宜,而且与3-D环境交互的机器人的额外深度信息是无价的。
抓取检测的最新工作集中在仅从RGB-D数据中获取抓取的问题[13]。 这些技术依靠机器学习来查找特征,从数据中得到好的抓取预测。 抓取视觉模型对于新物体的泛化能力更强,只需单张物体的图像,而不是一个完整的物理模型[14] [2],就能预测出好的抓取位置。
卷积网络的学习能里很强,作为特征提取器和视觉模型[15] [16]效果很好。 Lenz et al在滑动窗口检测流程中,成功使用卷积网络进行抓取检测作为分类器[1]。 我们也解决了与Lenz等人相同的问题。 但使用不同的网络架构和处理流程,能够以更快的速度获得更高的精度。
三、问题描述
通过一张无题的图片我们想要找到如何握住这个物体的方法。我们用五个维度的数据表示机器人的抓取,该方法是Lenz et al.提出来的[1]。这种表示方法给出了两组平行的位置和方向信息(一个矩形框),最终的数据可以绘制成一个封闭的图形,也就是刚好能变成一个矩形。真实地抓取是一个有着某种姿态位置,尺寸,和方向的矩形。可用如下数学符号描述:
其中(x,y)是这个矩形的中心,θ是矩形相对于水平方向的角度,h则是高度(注:这里应该说的是矩形的长),w是矩形宽度,图2展示使用抓取表示的例子。

图2五维度的抓取数据表示,其中包含位置,尺寸,方向等信息。蓝色的线条是尺寸,水平线的方向,红色线条的距离是执行抓取时候的宽度。
这是七个维度抓取方法(该方法由Jiang et al提出 )的一种简化,我们没有使用完整的物体3d抓取的位置和方向信息,而是假设一个机器人查看这个场景的视角,假设二维图像的抓取,可以映射回到三维数据上。第二个参考文献等人描述了实现这一方法的过程,并且与此同时,他们并没有直接评估该方法,不过在他们的实验中,他们的方法表现很好。
使用了五个维度的数据表现形式,可以使这个抓取检测任务与计算机视觉的物体检测变得非常相像。有一点不同,就在于加入了抓取的方向。
四、使用神经网络进行抓取检测
卷积神经网络比起传统的或者其他的,计算机视觉的模型来说,有着更好的表现效果,尤其是对于分类或者检测问题。卷积神经网络也已经在抓取检测问题当中得到了很好的应用,它作为滑动窗口过程中的一个分类器。
我们想要使用一个小的分类器,多次的在同一张图像上的不同的小块图像上面执行,希望这样可以避免计算量过大的问题。我们利用大卷积网络的大容量,可以使得在整幅图像上进行考虑全局的抓取预测。
a. 模型架构
当构建一个抓取检测系统,是我们希望从一个比较鲁莽的原始模型开始搭建,我们使用的模型是基于Krizhevsky et al.的物体识别任务的AlexNet卷积网络模型。
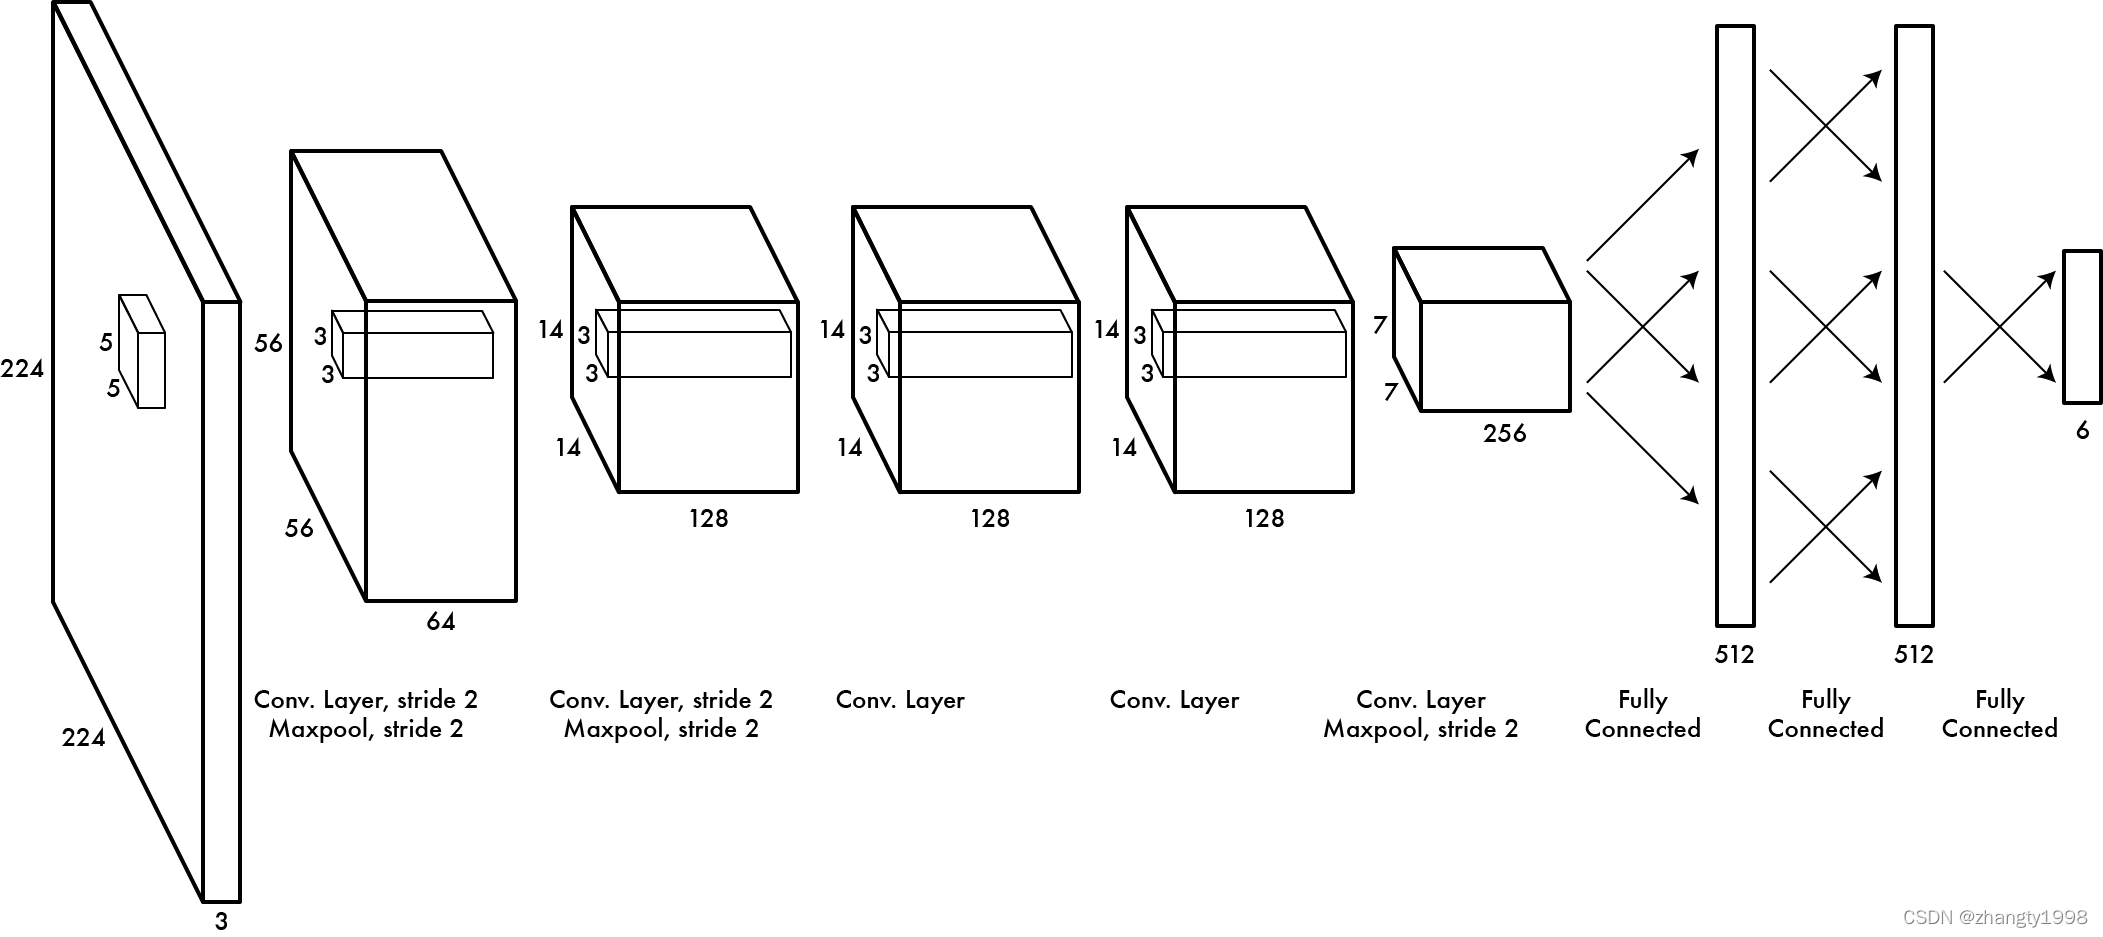
我们的网络有五个卷积层,紧随其后的是三个全连接层,卷积层的不同层中使用normalization技术,以及maxpooling,关于这个架构的完整描述可以在图3中找到。
b. 直接回归抓取(Direct regression to grasps)
我们发现的最简单模型,是基于对原始的RGBD图像数据直接回归去做坐标抓取。原始图像给卷积层后,卷积层会对原始图像进行特征提取。之后是六个神经元的输出(其中角度信息占2个,所以是6个输出)分别对应抓取的坐标信息等等,其中四个神经元对应着位置和高度信息,抓取的角度信息是双重旋转对称性,所以我们通过两个附加的坐标对角度参数化,也就是两倍角度的正弦和余弦。(Grasp angles are two-fold rotationally symmetric so we parameterize by using the two additional coordinates: the sine and cosine of twice the angle.)
这个模型有一个很强的假设,那就是每张图像只包含一个可以抓取的物体,并且对于那个物体,只需要预测一个抓取。这一较强的假设不能考虑到实验条件以外的情况,但是在实际中模型将会以一种流水线的形式执行,第一步对图像进行分割成不同的小块区域,这些小块区域包含了不同的物体。使用这一强假设的好处是不需要使用传统的滑动窗口的方法——对每一个小图像进行分类。我们只需要让模型观察一次图像,并做一个全局的预测就可以了。
在模型训练中,对于看到的物体,每一次只随机选择该物体所有可抓取中的一次真实地抓取信息进行训练。因为抓取也是经常会发生变动的,这样模型就不会在一个物体上过拟合(注:相当于一种防止过拟合的策略,或者可以称为正则策略)。我们对物体抓取的平方误差进行最小化,最终的效果也就是模型对一个物体所有可能抓取的平均情况的一种拟合。
然后直接回归的平均抓取在圆的物体上就表现不好了
c. 回归+分类
机器人要进行抓取物体的动作,第一步就需要对物体进行辨识。通过对我们模型的扩展,可以对识别和抓取检测的动作流程化。
我们将上节(直接回归模型)中所提到的模型架构进行修改,在输出层加入了额外的神经元,新加入的神经元对应着物体的类别。剩下的架构与我们先前的模型保持一致,这样我们就可以使用与前文中所述一样的架构,既可以识别也可以检测。
结合之后的模型在处理单张图片时,只需要一次正向传播,就可以预测出图像中物体的类别,以及对于该物体的一次抓取动作。因为模型的架构与前文中模型的架构并没有太大的改变, 模型执行速度与直接回归模型相同。
d. 多抓取检测, MultiGrasp Detection
直接回归相当于在NxN的path上预测一次。我们的第三种模型是对第一种模型的一种泛化,之前的模型都是假设对每张图像只有一个正确的抓取,并且预测那个抓取。而多抓取检测模型是将图像分成了NxN的网格,并且假设每一个网格内预测一个抓取(我的疑问:如何确定N的大小,后来想了想根据单张图像的ground truth label可以做到,但是作者并没有说这个N是固定的还是根据label的信息动态的调整的),并且预测物体上抓取是否可行,即预测抓取在网格中间的可能性。
加入额外输出(热力图,即抓取概率图)的网络
模型的输出结果是一个NxNx7的形式。第一个通道是一个热力图,这个热力图描述这个区域是否包含了一个正确抓取的可能。另外六通道包含了这次预测的抓取的坐标等具体信息。
对于热力图的误差反向传播
在康奈尔数据集上,我们的实验中使用了7×7的网格,输出层的形式是7×7×7(343个神经元)。第一个模型(直接回归模型)可以被视为一个网格尺寸是1×1的例子,各单元内抓取存在的概率是1。
训练多抓取模型需要一些额外考虑,每一次多次抓取需要观察一张图像的随机五个抓取作为真实抓取。热力图的构建是在这5个小格子内标注成1,剩下的格子填补0,此外也需要计算抓取会落在哪些格子,并且把真实抓取的其余具体数据信息填入适当的列中。因为大多数列都是空白的(即网格内没有真实抓取),所以即使有误差对应的7×7×7格子在训练过程也不会进行数值上的反向传播。反而对于整个热力图通道以及含有真实抓取的格子中,才进行误差的回传。
我们提出的物体检测模型是基于前人的一些工作的,但在一些重要的层面来说,这个模型也是新颖的。Szegedy et al在一张图像上使用深度神经网络,预测二进制的物体的掩码,并用预测出的掩码生成边界框[17]。我们预测出的热力图和物体掩码的方法非常相似,但是我们也预测完整的边界框,并用热力图去平衡预测的结果(only use the heatmap for weighting our predictions)。我们的整个系统不借助于后端处理或者用启发式的方法去得到边界框,而是直接预测。
Erhan et al提出的多边界框预测以及对应打分[18],该方法和我们的方法非常相似,我们也是预测多个边界框和对应分数来,最重要的不同在于我们的预测结构——每个单元格只对其图像局部区域预测。
五、实验和评估
康奈尔抓取数据集包含了240种不同的物体,共计885张图片。它们都被标记了真实的抓取标记,每一张图片都包含多个抓取标记,对应抓取该物体的不同方式,这个数据集是专门为机器人的平行板夹机器手设计的。这些标记在方向、位置和抓取规模方面都是全面且多样的,但并不是详尽无遗的。只是包含了不同样式的恰当合适的抓取。
图4. 多抓取模型在测试图像(飞碟)上的可视化。多抓取模型将一幅完整的图像切分成NxN的网格,对于每一个网格,模型在网格的中心预测是否有抓取包围边界框的概率。可视化时是以该边界框的粗细来表示它的概率。例如,模型选择概率最高的值的边界框作为最终抓取。
A. 抓取检测

之前的工作是用两种不同的方法在康奈尔数据集上进行抓取工作的评估。点测量的评估方法是在计算距离,计算预测的抓取的中心距离真实抓取的中心的距离,如果这些距离中任意一个小于某一个阈值,那么这次抓取就被被视为一次成功抓取。
然而对于这种测量方法也有很多的问题。因为它没有考虑到抓取的角度或者大小,进一步说之前的工作也并没有说明采取的阈值是多少,这也是为什么我们没有采用这种点来测量进行评估的方法。
第二种测量方法考虑的是一个完整的抓取矩形,一次成功抓取需要保证以下是正确的:
1、预测抓取角度与真实抓取的角度在30度以内
2、预测抓取比真实抓取的Jaccord index大25%
其中,计算公式如下:
矩形测量方法在对于好的和不好的抓取时,它的效果要比点测量的估计方法要更好一些,这种测量方法相比相似的物体检测的评估方法,设定的Jaccord index是25%,还是比较低的。这里的25%,并不是计算机视觉中更标准常见的50%。这也是因为真实的抓取并不是非常详尽的缘故导致的。如果预测的矩形框与实际正确抓取的方向有25%的重叠,那么我们也认为这次预测的抓取仍是一个好的抓取结果。我们在所有的实验中都使用了矩形测量评估的方法。
与之前的工作一样,我们在实验的结果计算上也使用了五折交叉验证集。我们使用两种不同的方法对数据进行split。
1、逐图片split,将图片随机split。
2、逐个物体split,对一个问题事例随机分开,将所有图像中相同的物体分到相同的交叉验证集的split中。
逐图像的split在测试的时候可以验证模型的泛化能力(对于见过的物体但不同角度的时候);逐个物体的split在做交叉验证可以更进一步地测试网络对于新物体的泛化能力。在实际应用中,上述的两种方法具有一定的等价性,可能是由于数据集中的一些物体具有一定的相似性。(例如不同的太阳镜在形状和颜色上也只是稍许不同)
B. 物体分类
我们人工地对康奈尔抓取数据集的图像分成了十六种不同的类别,比方说有瓶子,鞋子,运动器械等等。康奈尔原始数据集中各种类的图像张数的分布差距很大,即每类样本数量并不是相同的,但是每一种类别的图像都有足够的数目表示本身的含义。图像张数最小的那个种类只有20张,但最多图像的种类有156张。
我们使用这些类别标记训练并测试了结合了回归和分类的模型。在测试时间上,结合后的回归分类模型可以预测最佳抓取的同时预测物体种类。我们在上述相同的交叉验证的分割方法中,已经报告了分类的准确率。
C. 预训练
在抓取数据集上训练我们的网络之前,我们先在ImageNet的分类任务上进行了预先的训练[20]。现有文献中的经验表明,通过对大的卷积神经网络进行预训练,可以大大减少训练时间,有助于避免过拟合[21][22]。Krizevsky et al.设计了针对标准RGB图像的AlexNet,像Kinect这样的低成本立体视觉系统可以使RGB-D数据在机器人系统中不断增加。但是如果要使用AlexNet和RGB-D数据,我们只需要用深度信息替换图像中原本的蓝色通道,这样修改后的架构可以具有另一个输入通道,但是无法预训练完整的网络。
当领域数据很限时,预训练是非常重要的。通过对模型进行预先训练,可以使网络找到更有用,更具泛化能力的滤波器,这样可以更好的将原始数据转化为特定应用[22]。即使在数据格式和实际的输入有变化的情况下,仍然发现预训练的滤波器的性能还不错,这可能是因为训练过的视觉滤波器也是深度空间中好的滤波器。
D. 训练
我们针对每个城市的模型进行类似的训练方案。对于交叉验证的每个折叠,每个模型都是用25个epoch,学习率0.0005,权重衰减0.001,在全链接层的隐含层中,使用0.5的dropout概率作为正则化的附加形式。
在对模型进行训练和测试时候,我们使用Tesla K20显卡和cuda-convet2包计算。GPU提供了强大的计算能力,其运算到时间也是我们整个流程的一部分。虽然这GPU在机器人平台方面不是主流,但由于其在视觉任务中的实用性,它越来越受欢迎。
E. 数据预处理
在数据给网络之前,我们需要对数据进行少量的预处理操作,如前文中所述深度信息,被放入了图像中的蓝色通道,深度信息同时也被重新映射在0到255之间,由于一些像素缺少深度信息,他们被遮挡在立体图像中,所以用0来代替这些像素值,之后再对每张图像减去像素平均中心(approximately mean-center the image)144。
在这之后我们对数据平移和旋转,从而扩增图像数据。我们取出原始图像中心320×320像素大小的区域。在xx和yy方向上,将其旋转50个像素,并再旋转一个随机像素数。之后把图像重新缩放成224×224的大小,这样就可以适用于网络的输入层。对于原始图像,我们生成了三千个训练样本(比例是1:3000),在测试图像上,我们只是简单取出原始图像中心的320×320区域,并缩放到网络的输入尺寸,没有平移和旋转操作。
 五、 结果
我们的模型无论是在准确性还是速度方面,是目前最先进的。
图5 直接回归模型的正确(顶部)和不正确(底部)示例。一些不正确的抓取(例如罐头开瓶器)可能实际上是可行的,而其他的(例如碗)显然是不可行的。
我们将结果和以前的工作使用矩形度量法得到的准确率相比较。直接回归模型在抓取检测任务中,得到了一个新的基准线,在逐个图像和逐个物体的交叉验证上达到了大约85%的准确率,比之前版本的最高准确率要高出十个百分点。在测试时,也就是计算一次正向的直接回归模型,对于每一个批次的处理在76毫秒,每一个批次(batchsize)有128张图像。也就是说,每秒钟会处理超过1600张的图像,延迟在整个抓取检测的过程所占用的时间非常的多,以至于每一秒钟只能处理13帧(每次使用1张图像和128张所需要的时间相同)。得到加速的主要是由原本的扫描滑动窗口的分类模型,转换为我们的单次传播模型,并且使用GPU硬件进行计算加速。对于在GPU上的一个完整的批次计算,这里只需要原本1/128的浮点计算操作,CPU无疑至少需要76毫秒(这里没太理解这句话,76 milliseconds per frame is certainly achievable on a CPU because it would require only 1/128th of the floating point operations required for processing a full batch on a GPU)。
在直接回归模型的训练过程当中,我们每一次针对每张图像都是用随机的真实抓取,而不是该图像的所有真实抓取。因为这个缘故,所以模型学到的预测是物体的一个平均真实抓取。对于某些种类的物体预测平均抓取非常有效,例如,形状上比较长且细的物体如马克笔。该模型大多数失败的主要原因是平均抓取并不能转换成一种切实可行的抓取,例如一些圆形的物体,如飞碟。图5展示了一些正确和不正确的抓取,这些都是使用直接回归模型进行预测的。
结合了回归和分类的模型展示了在检测模型的基础之上,还可在不牺牲检测精度的同时进行分类;表2是该模型的分类结果。当我们的模型已经看到该物体9次或10次时,他就可以正确地预测出物体的类别,但是当给出一个新的物体时,准确率只有60%。相比最常见的类别占总数据集的比例来说,用占比最多的类别进行预测,准确率有17.7%。
即使加入了分类任务结合之后的模型,仍然保持高检测准确率。之前逐对象的交叉验证集上有同样的性能,比之前逐图像交叉验证事后的性能还要稍微好一些,这个结合了抓取检测和物体分类后的模型,在康奈尔数据集上建立了更好的性能基准线。
多抓取模型要比直接回归模型的基准线要好一大截。多抓取模型在对于大多数物体与直接回归模型得到的结果非常相似,然而多抓取模型并没有直接回归模型的较差的平均抓取的问题(这也是为什么多抓取模型能够减少大多数错误的原因)。图6展示了多抓取模型比直接回归模型要好的几个例子,以及在这两个模型上都出现失败的例子。
图6 直接回归模型和MultiGrasp的性能比较。前两行显示了直接回归模型由于平均效应而失败的示例,但MultiGrasp预测了可行的掌握。底部的两行显示了两个模型都无法预测好抓握的示例。直接回归模型图像上的蓝色和红色展示出真实的抓握。
多次抓取模型与直接回归模型有相似的架构,以及相似的实时处理速度。多抓取模型在机器人抓取检测方面保持世界领先,检测准确率为88%,性能为13帧/秒。
七、讨论
我们提出了在保证速度和高准确率下的模型。计算显卡提供了强大的计算能力,尤其是基于卷积神经网络的。在视觉任务上,卷积神经网络一直在统治着相关的技术。这也是计算显卡成为任何高性能机器人系统的一个重要组件的原因。计算显卡在模型训练中非常重要以及整个过程中都有优化,然而却有着很大的延迟。在测试时,CPU可以少于一秒的处理单张图像,这可以使机器人应用实时化。
从模型层面上考虑对实现高性能来说是非常重要。为了图像在模型中单次上处理就可以完成准确的抓取预测,我们对数据进行强约束。
与滑动窗口的方法不同,直接回归模型使用了图像上的全局信息进行预测。滑动窗口分类器只能看到较小的局部的图像,因此他们不能在一堆候选抓取结果中做出有效的决定,而且很容易被假阳性的样本所迷惑。Lenz et al.报告他们的分类器有很高的识别率,94%,然而对于假阳性样本来说,其检测精度要低很多,在这一方面与只能看到局部信息的模型相比,考虑全局的模型具有很大的优势。
考虑全局的模型也有其缺点,值得注意的是,直接回归模型通常会在几个好的抓取之间进行差异化(注:这里我理解不是差异化,而是平均化),很最后预测出不正确的抓取,然而滑动窗口方法永远不会造成在圆形物体上预测中心位置的错误抓取,比方飞盘。
性能比较
我们的多抓取模型结合了只考虑全局和局部信息这两种模型的优势。他会观察整幅图像并找到最佳抓取,并忽略假阳性样本,然而因为图像上每个单元格会做局部预测,这也可以避免陷入不好抓取的预测陷阱。
考虑局部的模型也有在单幅图像上预测多个抓取的能力。因为目前没有哪些数据集可以对单张图像预测多抓取的合适评估,所以我们没能给出一种定量评估该模型的方法。
另一个重点考虑是在于构建大规模卷积神经网络时,预训练的重要性。如果没有在ImageNet数据集上进行预训练,模型很快的会在训练数据集上过拟合,更不会学习出好的抓取的特征表示。有趣的是,预训练在不同的领域以及特征类型上都有效果。我们对原本的模型中的蓝色通道,用深度信息将其替换,仍然得到了不错的结果。重要的是,使用深度信息的通道比起原本只用三种颜色的图像通道来说,得到了更好的结果。
八、 总结
我们提出了一种快速,高准确的系统,用来预测机器人处理RGB-D的图像数据进行物体抓取。模型达到世界领先水平,并比先前的方法提高了150倍。我们也展现了在不损失精度和性能的前提下,可以将抓取检测和物体分类的模型进行结合。多抓取模型在康奈尔抓取数据集上,通过结合全局的信息,可以进行局部预测,并达到当前已知的最佳性能。
 295


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


