猿码记
码龄9年
求更新 关注
提问 私信
  • 博客:56,572
    社区:17
    56,589
    总访问量
  • 66
    原创
  • 92
    粉丝
  • 28
    关注
IP属地以运营商信息为准,境内显示到省(区、市),境外显示到国家(地区)
IP 属地:北京市
加入CSDN时间: 2017-06-01

个人简介:微信搜索【猿码记】关注我

博客简介:

weixin_39001207的博客

查看详细资料
个人成就
  • 获得139次点赞
  • 内容获得13次评论
  • 获得263次收藏
  • 代码片获得1,865次分享
  • 博客总排名1,821,722名
创作历程
  • 9篇
    2024年
  • 57篇
    2023年
成就勋章
TA的专栏
  • Go基础篇
    14篇

TA关注的专栏 0

TA关注的收藏夹 0

TA关注的社区 3

TA参与的活动 0

创作活动更多

【多重好礼】鸿蒙心迹 · 开发录原创征稿活动

鸿蒙开发者的实战经验,值得被记录。从踩坑排查到项目复盘,从工具脚本到学习笔记,每一段真实的开发经历,都是社区最宝贵的技术资产。「鸿蒙心迹 · 开发录」正式启航,不限主题、随时可写,只要是鸿蒙开发相关的真实经验都欢迎投稿。 本活动为 [HarmonyOS 7.0 创新内容共创季](https://builderx.csdn.net/activity-site/harmonyos/activity2026)双轨征文之一,与[「共创季 · 稿事节」](https://harmonyosdev.csdn.net/6a97f0de2b83d06f0ecadec5.html)深度征文互补——「稿事节」写深度技术长文,「开发录」写日常开发实战笔记。 「开发录」每月一期,12月截止,本季共三期,投稿即有机会获得京东卡、CSDN博客流量券、亿万Token、社区定制周边好礼!

268人参与 去参加
  • 最近
  • 文章
  • 专栏
  • 代码仓
  • 资源
  • 收藏
  • 关注/订阅/互动
更多
  • 最近

  • 文章

  • 专栏

  • 代码仓

  • 资源

  • 收藏

  • 关注/订阅/互动

  • 社区

  • 帖子

  • 问答

  • 课程

  • 视频

搜索 取消

Python框架篇(9):FastApi-SQLAlchemy集成

框架将数据库中的表(表结构)映射为面向对象的类(对象),将表中的记录(行)映射为类的实例(对象的实例),将表中的字段(列)映射为类的属性(对象的属性)。框架提供了自动化的数据库映射和对象关系管理,减少了开发人员对数据库操作的工作量,提高了开发效率。框架通常具有良好的跨数据库兼容性,可以轻松地切换不同的数据库,而不必修改大量的代码。框架,可以直接使用面向对象的方式来进行数据库操作,比如增删改查等,而不必编写复杂的。@注意: 此处为了节省篇幅,忽略注册控制到框架的代码,具体使用可参考之前的代码。
原创
博文更新于 2024.05.10 ·
3941 阅读 ·
9 点赞 ·
2 评论 ·
19 收藏

Python框架篇(8):FastApi-文件处理

在某些场景下,我们需要提供一个地址,可以让前端工程师或者第三方来访问静态资源,比如返回一张图片或者一个文件。,然后在下载列表中查看状态并下载结果。@注意: 发现框架生成的SwaggerUI演示cookie传参会报错,这里以命令行的形式展示~在工作中下载文件的场景,大部分都是异步导出文件,如发个异步任务,查出数据并把结果上传到。, ... 是元数据,可以是任何类型的对象,如字符串、字典等。模块提供的一个工具,用于在类型提示中添加元数据(这行代码,即可进行静态资源进行访问。1.1 注解Annotated。
原创
博文更新于 2024.04.01 ·
2462 阅读 ·
6 点赞 ·
0 评论 ·
10 收藏

Python框架篇(7):FastApi-依赖项

有时选择太多也会让人陷入焦虑,比如突然有一段自由时间,却因为想做的事情太多,最后把时间都浪费在了摇摆不定上,静不下心做最重要的事,或者说根本不知道最重要的事情是什么。---------- 《认知觉醒:开启自我改变的原动力》依赖注入:主要用于解耦组件之间的依赖关系,使得组件之间的耦合度降低,同时提高了代码的灵活性和可测试性。装饰器可以修改函数的行为、添加额外的功能或者改变函数的返回值,而不需要修改函数的原始定义。,我们主要关注的是参数是怎么接收,它的底层本质就是使用的依赖注入,才能把参数传递给函数。
原创
博文更新于 2024.03.26 ·
786 阅读 ·
3 点赞 ·
0 评论 ·
7 收藏

AI学习(4): PyTorch实战-手写数字识别

方法的一种实际应用,通过统计学的标准数学方法我们能够得到大量的可以用函数来表达的局部结构空间,另一方面在人工智能学的人工感知领域,我们通过数学统计学的应用可以来做人工感知方面的决定问题(也就是说通过统计学的方法,人工神经网络能够类似人一样具有简单的决定能力和简单的判断能力),这种方法比起正式的逻辑学推理演算更具有优势。)的基本使用,为防止陷入枯燥的理论学习中,在这篇文章,我们将进行项目实战学习,项目主要内容: 基于。上面介绍了数据集下载和加载的工具包,结合本篇文章的主题,下面函数演示。
原创
博文更新于 2024.02.27 ·
1362 阅读 ·
31 点赞 ·
1 评论 ·
36 收藏

AI学习(5):PyTorch-核心模块(Autograd):自动求导

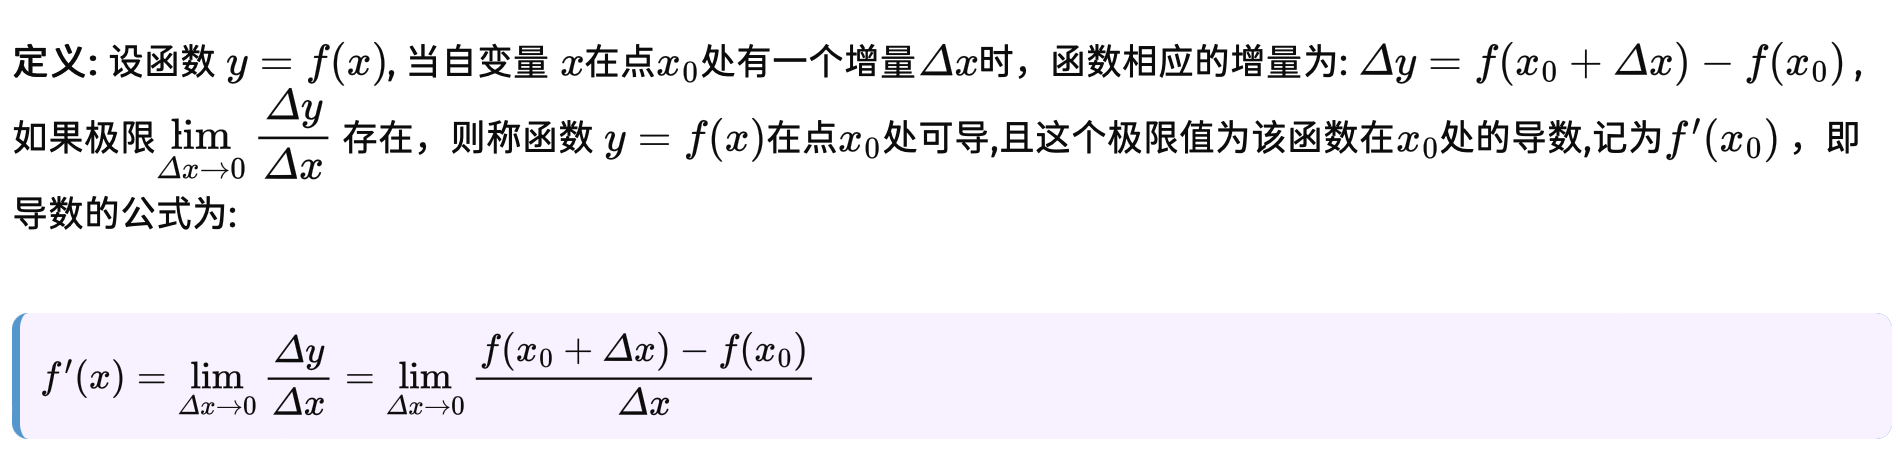
上面说了求导的本质就是某点的切线,切线则有斜率,斜率越大的地方也就是越陡峭的点,然后沿着相反的方向进行,这也是梯度下降算法的原理。通过上面运行输出,发现自动求导的结果(梯度)进行了累积,为了避免这种问题的出现,通常需要我们在模型训练过程中,手动清除之前计算的梯度。因此,在训练深度神经网络时,通常建议避免梯度累积,确保每次迭代都使用当前的梯度进行更新,以保证训练的稳定性和收敛速度。通过局部禁用梯度计算,可以灵活地控制梯度计算的范围,提高训练和推断的效率,并且可以避免不必要的梯度计算和内存消耗。
原创
博文更新于 2024.02.27 ·
1271 阅读 ·
30 点赞 ·
1 评论 ·
15 收藏

AI学习(3): PyTorch-初识张量

这些方法在处理不同类型的数据和内存共享方面有所不同,开发者可以根据具体需求选择合适的方法来创建张量;中,张量的常见访问方式包括索引、切片、以及一些常用的方法。类的实例,它提供了丰富的方法和功能,用于进行数值计算和深度学习模型的构建与训练。)是其核心数据结构,表示任意维度的数组。张量可以用于存储和处理数据,是。是否启用自动求导机制,以便追踪对张量的操作并计算梯度,默认。创建张量,将共享底层数据,对张量的修改会影响原始数据。中常用于创建张量的函数之一。指定张量的数据类型。指定张量存储的设备,可以是。
原创
博文更新于 2024.02.27 ·
787 阅读 ·
5 点赞 ·
0 评论 ·
6 收藏

AI学习(2): PyTorch2.x环境安装

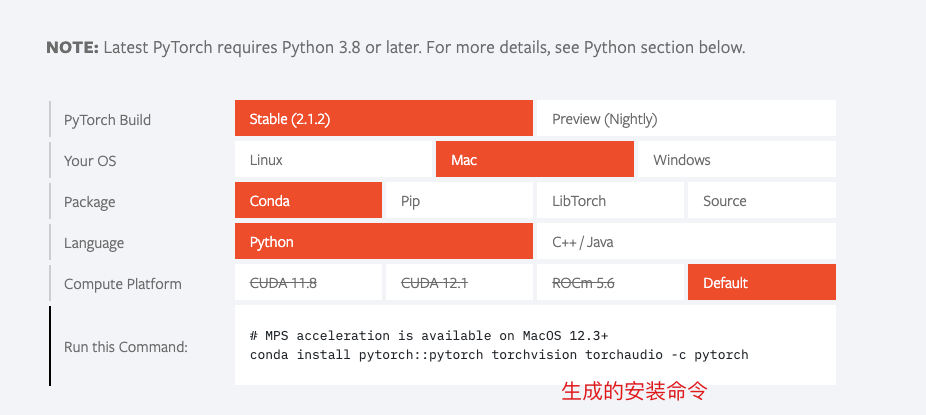
(即动态计算图)和TorchScript(即静态计算图)的融合,使得用户可以在训练和部署中选择合适的计算图方式。包含一些不具有内部状态的函数,这些函数通常在神经网络的中间层中使用,例如激活函数、池化操作等。提供了强大的数组和矩阵操作,与 PyTorch 的张量操作兼容,常用于数据处理和转换。,这是用于模型部署和分布式训练的工具,使得将PyTorch模型投入实际应用更为方便。的编程环境,以及全面的深度学习功能,使得神经网络的构造和训练都变得非常直观。,据官方描述,其可以大幅提高模型训练速度。
原创
博文更新于 2024.02.27 ·
835 阅读 ·
6 点赞 ·
0 评论 ·
9 收藏

AI学习(1):初识AI,踏上未来之旅

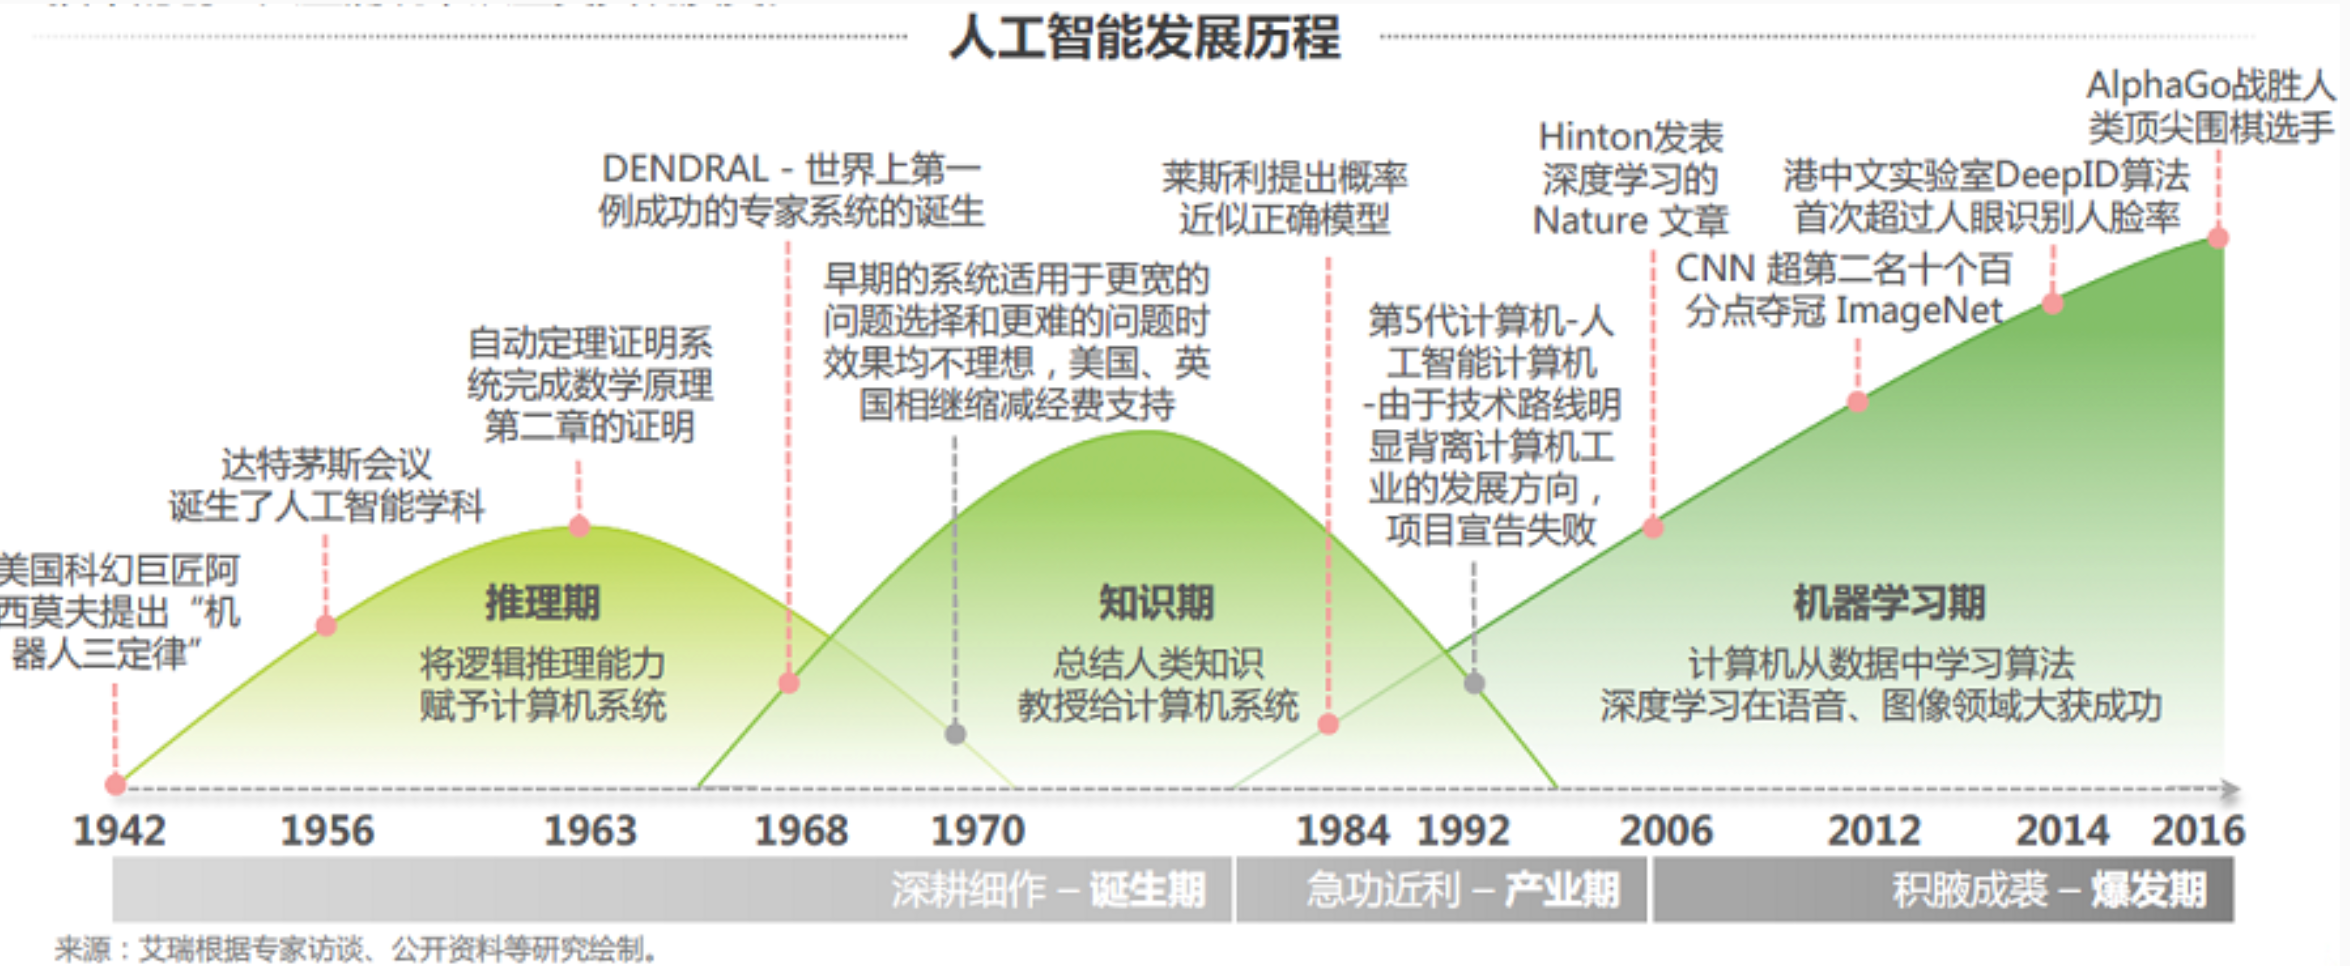
当我们准备想了解或者学习人工智能时,经常会听到或者看到各种各样的名词,如: 机器学习、深度学习、神经网络、自然语言处理、计算机视觉、强化学习、自动驾驶、模型训练等等。上面这些还算好的,网上搜一搜也能知道什么意思,最大的拦路虎可能是高数相关或者算法相关的,比如: 线性代数、微积分、概率论、梯度下降、决策树、朴素贝叶斯....下面图片是在网上搜索而来,从图片上可以很清晰的看出: 人工智能、机器学习、深度学习之间的关系,以及每个领域内包含的重点知识,对于初步认识。具有高度的灵活性,支持多种网络结构和优化算法。
原创
博文更新于 2024.02.27 ·
601 阅读 ·
9 点赞 ·
0 评论 ·
7 收藏

Python库学习(十四):ORM框架-SQLAlchemy

相反,它仅是为了创建一个数据库引擎对象,该对象封装了连接到数据库的配置和行为,但直到实际执行数据库操作时才会尝试建立连接。会话允许你在应用程序中创建、更新、删除数据库中的数据,并提供了一系列方法来管理事务的提交和回滚。模型类相关代码,不用我们挨个去写模型,它的实现原理:通过连接到数据库,然后分析数据库结构,最后生成对应的。返回查询结果的第一列的第一个值,通常用于获取单个聚合函数的结果,如。执行外连接操作,返回左表中的所有记录以及右表中匹配的记录。在插入新记录时,如果没有提供该列的值,则将使用默认值。
原创
博文更新于 2024.01.07 ·
2247 阅读 ·
22 点赞 ·
1 评论 ·
35 收藏

Python库学习(十三):爬虫框架Scrapy

上面配置信息只是九牛一毛,更多配置信息可以查看文档: https://www.osgeo.cn/scrapy/topics/settings.html 记住一些常用的,其他的用到时候查看下文档即可;提供了一个清晰的结构,将爬虫的不同部分组织起来,包括爬虫代码、中间件、下载器等。是一个很成熟,功能很强大的爬虫框架,通过本文我们只是触及到了它众多功能的表面,不同的项目有不同的需求,在使用。走到这一步,说明我们学会了项目的基础使用,解决了403问题,但是我们还没有解析网页内容,网页往往是由一堆。
原创
博文更新于 2023.12.21 ·
399 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

Python框架篇(6):FastApi-配置管理

根据官方文档介绍,如果通过上面方式使用配置,每次导入都会创建一个配置实例,而且从磁盘中读取文件通常是一项耗时的(慢)操作,所以尽可能的复用这个配置实例。装饰器,相当于是缓存了函数结果,当相同入参请求时,返回的是缓存结果,不相同时则会重新计算结果,以下是官方给的代码示例和配套讲解图。@注意: 使用uvicorn启动时,命令行参数只能按照uvicorn的文档来,不能传自定义参数。在大型项目中,良好的配置管理是确保系统可维护性和灵活性的关键,,这里有坑,里面有很多属性都给删除了,而且升级。3.2 编写配置模型。
原创
博文更新于 2023.12.19 ·
2582 阅读 ·
4 点赞 ·
2 评论 ·
15 收藏

Python框架篇(5):FastApi-中间件使用

CORS 是一种浏览器机制,允许 Web 页面从不同的域请求不同域的资源。实例在一个文件才能通过注解的方式,这种虽然使用起来比较简单,但是不太合适扩展和项目结构管理,下面是通过函数。级别越高,压缩率越高,但耗费的 CPU 越多。: 允许前端访问的额外响应头,可以是字符串、字符串列表,一般很少指定。: 允许的 HTTP 头信息,可以是字符串、字符串列表,或通配符。: 允许的 HTTP 方法,可以是字符串、字符串列表,或通配符。压缩的最小响应体大小,单位为字节。压缩的媒体类型,可以是字符串或字符串列表。
原创
博文更新于 2023.12.14 ·
2165 阅读 ·
1 点赞 ·
2 评论 ·
11 收藏

Python框架篇(3):FastApi-响应模型

简单学习了一些基础且常用的模型,下面稍微在学点复杂点的模型和使用方法。# 用于验证列表或元组字段的元素个数不少于指定的最小值。# 用于验证列表或元组字段的元素个数不大于指定的最大值。#指定一个函数,该函数的返回值将被用作字段的默认值。针对错误会有些报警之类的处理,在统一地方加即可;把每个字段的中文说明加上,这样方便使用者理解;# 用于指定数值字段的值必须是某个特定值的倍数。如果想忽略响应模型中的默认值时,可以设置属性。对于每个字段,最好在文档中,都能给个示例;# 字段说明,用于文档生成,,场景1。
原创
博文更新于 2023.12.09 ·
477 阅读 ·
1 点赞 ·
0 评论 ·
1 收藏

Python框架篇(4):FastApi-错误处理

在上面验证错误使用中,我们可以看到返回的错误信息是英文的,那么怎么翻译成中文呢,在官方文档中未找到使用方法,后来在网上搜到需要使用。在厉害的程序员都无法避免程序错误,特别是运行中遇到的异常。如果遇到异常时,我们不希望用户看到500,或者页面崩溃。按照官方文档说法,我们需要自定义错误处理器,并以此来覆盖框架默认的异常处理器,参数验证错误处理器默认走的是。@注意:上面方法,只是提供一种解决思路,如果有更好的方式,喜欢能留言通知,一起学习~这个属性,按照网上示例发现未为生效,后来在。3.3 改造自定义处理器。
原创
博文更新于 2023.12.09 ·
1407 阅读 ·
2 点赞 ·
0 评论 ·
7 收藏

Python框架篇(2):FastApi-参数接收和验证

更多使用方法可见官方文档: https://fastapi.tiangolo.com/zh/tutorial/path-params/更多验证方式可查看文档: https://docs.pydantic.dev/latest/concepts/validators/它通过声明性的方式定义数据模型,并提供了强大的数据验证和转换功能。具体可参见官方文档: https://docs.pydantic.dev/latest/@注意:上面列举的都是基本使用,实际中可以组合进行多项组合使用,如。
原创
博文更新于 2023.11.17 ·
2087 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

Python框架篇(1):FastApi-快速入门

模式启动后,就可以打断点进行代码调试,具体使用方法可参考官方文档:https://fastapi.tiangolo.com/zh/tutorial/debugging。规范,通过访问 http://127.0.0.1:8000/openapi.json,我们可以看到整个项目的。文件在包被导入时会被执行,可以用于初始化包级别的变量、设置环境或执行其他必要的初始化操作。中定义变量、函数或类,可以将它们添加到包的命名空间中,使得在导入包时可以直接访问这些元素。这样可以通过导入包的方式来组织和访问模块。
原创
博文更新于 2023.11.15 ·
1583 阅读 ·
0 点赞 ·
0 评论 ·
6 收藏

使用篇(一):Ai绘图-Stable Diffusion WebUI

安装方式一对于一些朋友来说,可能会由于网络的限制,而无法正常下载,即便上面下载成功,在运行的时候,可能还需要下载依赖项目和模型,之后在运行过程中又是各种坑,为此会把项目和模型进行压缩放到阿里云盘,通过以下方式可以获取。相同的种子值每次都会产生相同的图像集,这对于再现性和一致性很有用,如果将值设置为-1,则每次运行都会生成一个随机种子。:输出图像的大小长和宽。,能够在1000个步骤中将一张完全没有噪点的图像转化为一张充满噪点的无法辨认的图像。的自由发挥空间,值越大AI就越放飞自我,值越小就越按照原图重绘;
原创
博文更新于 2023.11.09 ·
2997 阅读 ·
0 点赞 ·
2 评论 ·
4 收藏

Python库学习(十二):数据分析Pandas[下篇]

表示要读取的工作表的名称或索引。默认为 0,表示读取第一个工作表。:表示的是颜色,可以使用字符串表示颜色名称,也可以使用十六进制颜色码。: 用作列名的行的行号。默认为 0,表示使用第一行作为列名。: 值是一个元组,用于指定要冻结的行和列的位置。如果指定列名列表,将只写入指定的列。: 用于表示缺失值的字符串,默认为空字符串。: 覆盖 header 的结果,即指定列名。: 要读取的列的列表,可以是列名或列的索引。: 用于指定行索引列的名称。: 散点图特有的属性,表示散点大小。如果是文件名,将创建一个。
原创
博文更新于 2023.11.03 ·
889 阅读 ·
0 点赞 ·
0 评论 ·
2 收藏

Python库学习(十一):数据分析Pandas[上篇]

是一个表格型的数据结构,包含有一组有序的列,每列可以是不同的值类型(数值、字符串、布尔型等),用于排序的函数,可以是函数、类实例或类的方法。可以是一个布尔值或布尔值的列表,用于指定每个列的排序顺序。: 是一种类似于一维数组的数据结构,它可以存储任意类型的数据,并附带有标签(可以看作是由两个数组组成,一个是数据值的数组,一个是与之相关的标签的数组。上使用,用于删除指定的行或列,并返回一个新的对象,原始对象保持不变。如果是一个字典,字典的值可以是列表、数组或其他字典,它们将成为。
原创
博文更新于 2023.10.31 ·
314 阅读 ·
0 点赞 ·
0 评论 ·
0 收藏

Python库学习(十):Matplotlib绘画库

每个点的位置由两个变量的值决定,横轴表示一个变量,纵轴表示另一个变量。必需,表示每个部分的大小,可以是一个数组或一个标量。用于指定散点的颜色。也可以是一个数组,表示每个点的颜色。的图表是通过对象导向的方式创建的,这意味着用户可以直接操作图表的元素,使得定制化和复杂的图表更加容易。也可以是一个数组,表示每个点的大小。扇形的颜色,可以是一个颜色列表,表示每个扇形的颜色;提供了内置的样式表和颜色映射,使得用户可以轻松地应用一致的风格和颜色。用于指定散点的标记样式,例如 'o' 表示圆点,'^' 表示三角形等。
原创
博文更新于 2023.10.16 ·
813 阅读 ·
0 点赞 ·
0 评论 ·
4 收藏
加载更多