


商场导购Agent如何从聊天框走向真实接待场景?我用deep seek+魔珐星云竟然实现了!
当 ChatGPT 让全世界见识到 AI 的“智慧”时,我们很容易以为,Agent 只要足够聪明就够了。但我真正做过商场导购大屏的项目之后才发现,落地到真实场景,问题根本不只在“会不会答”,而在“能不能被看见、能不能自然表达、能不能及时回应”。上一套方案里,延迟 2-3 秒、表情僵硬、云渲染成本高,项目很快就撞了墙。
后来我拿魔珐星云把这件事重做了一遍,才第一次看到一种更接近落地的解法:Agent 解决任务执行,具身交互智能解决人如何自然地与 Agent 交流。魔珐星云依托 AI 端渲和解算 + 自研参数流,为导购 Agent 补齐 3D 具身拟人交互形态,让它不只是会查询商品和生成回答,而是能在终端里表达、反馈、打断和继续服务。
官方链接:魔珐星云官网
一、踩过的坑:一个数字人项目的“翻车”经历
去年我在成都接了一个项目:为某商场打造一个 AI 导购数字人。需求很简单——顾客走到大屏前,数字人能打招呼、回答问题、推荐商品。听起来不难,我当时想:“ChatGPT 都能对话了,加个 3D 形象应该很简单吧?”
结果狠狠打脸了。
这次数字人项目让我意识到,从云端大模型到终端具身交互,中间隔着巨大的工程鸿沟。
第一个问题:延迟。我用开源方案拼接了一套系统:ASR 语音识别 → 调用 GPT → TTS 语音合成 → Live2D 表情驱动 → 渲染输出。测试时发现,用户说完话后要等 2-3 秒才能听到回复。商场环境嘈杂,顾客等不了这么久,直接走了。

图: 传统方案的延迟瓶颈分析
第二个问题:表情僵硬。我用的是预设表情库,数字人说话时只会机械地张嘴,完全没有情感。客户看了 Demo 直接说:“这不就是个会动的 Siri 吗?一点都不真实。”
第三个问题:成本失控。为了降低延迟,我租了云 GPU 做实时渲染,结果一个月光服务器费用就烧了好几万。客户一算 ROI,果断砍掉项目。
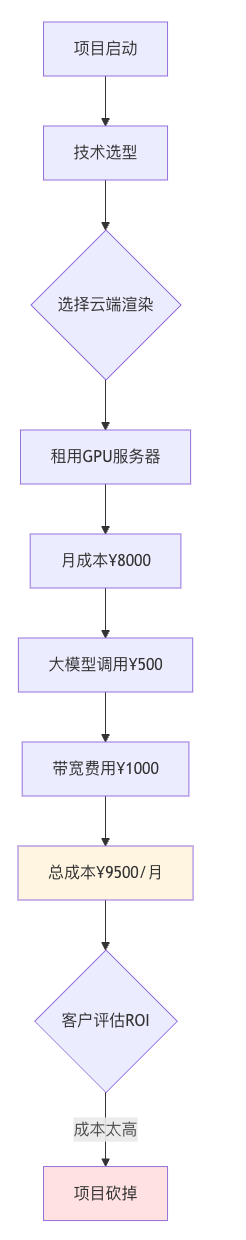
图: 传统方案的成本失控路径
这次失败让我意识到:当我们谈论 AI 时,大多数人想到的是 ChatGPT 那样的文本对话助手,或是 MidJourney 那样的图像生成工具。这些大模型确实让 AI 具备了理解、推理和生成的能力,但如果 AI 要真正走入我们的生活——进入屏幕、机器人、展厅、门店、教育、文旅、车载等终端场景,仅靠聪明的“大脑”是远远不够的。
AI 还需要:
-
可被看见的身体:3D 数字形象,让人感知到 AI 的存在
-
可被感知的状态:表情、肢体语言,让人理解 AI 的情绪
-
可自然表达的语音、表情、动作:让交互不再生硬
-
可实时响应的交互能力:毫秒级反应,如同真人对话
-
可被开发者快速接入的 SDK 能力:降低落地门槛
带着这些问题,我开始寻找解决方案。有个做过虚拟主播的朋友推荐了魔珐星云,说这家公司在数字人领域积累很深,最近推出的星云平台主打“具身交互智能”。
魔珐星云传达的核心理念——具身交互智能:让 AI 拥有身体、感知世界、理解环境,并通过语音、表情、动作和实时响应,自然地与人交互——正是我之前项目缺失的那块拼图。
更重要的是,魔珐星云不是单纯的数字人工具,也不是 Agent 套壳工具,而是一个具身交互智能开放平台。它补的是大模型和 Agent 在真实终端落地时常常缺失的那一层:身体、表达和交互。结合官网公开信息和我的测试体验,我觉得它最值得关注的点有三件:
-
延迟问题:官网公开口径为
1200ms 以内响应,在本文测试环境里,部分简单场景实测约220-510ms -
表情僵硬:LAM 3D 大模型驱动,自动生成自然表情动作
-
成本失控:端侧渲染显著降低了云侧渲染与带宽压力,主流设备部署门槛更低
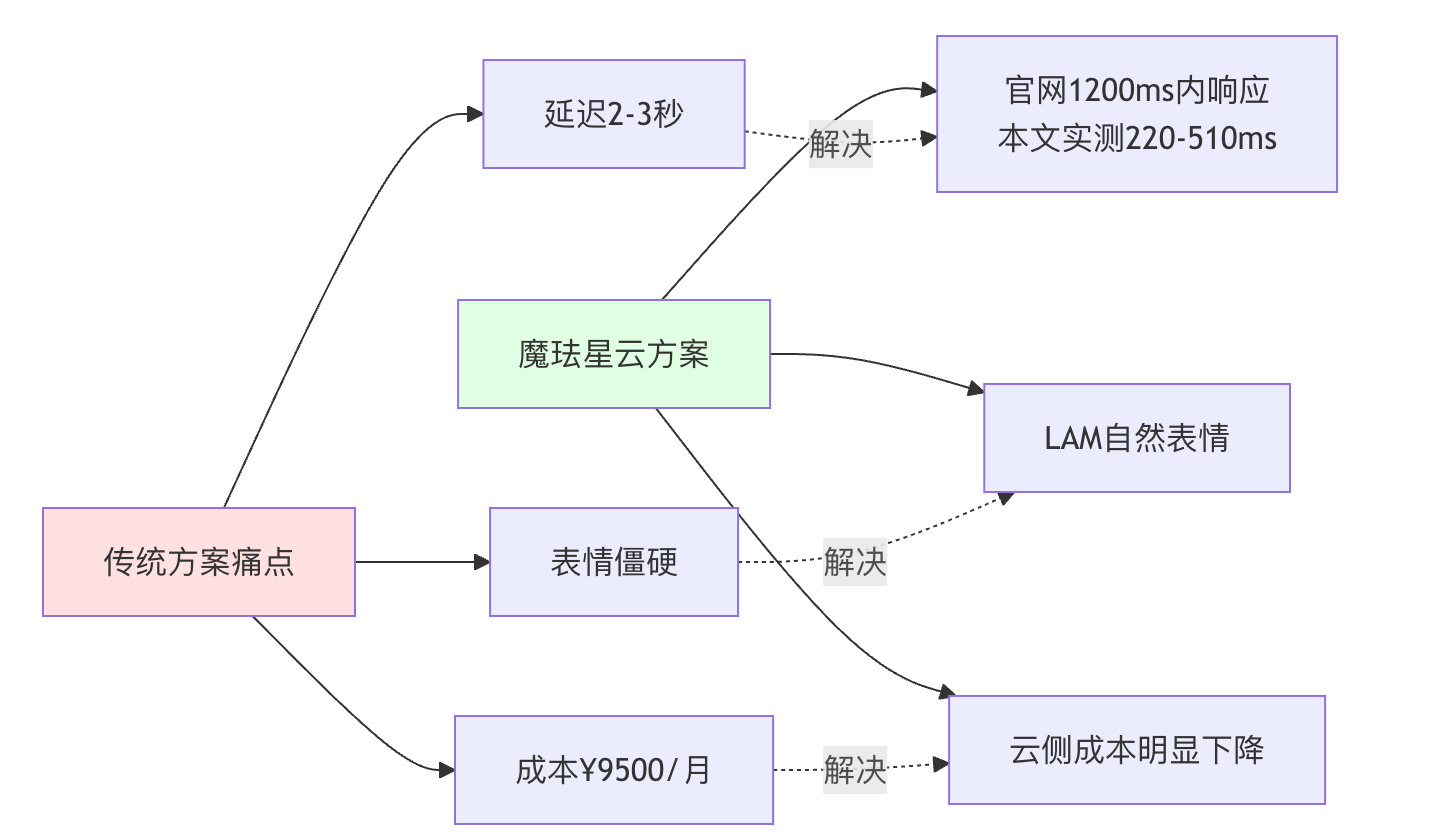
图: 魔珐星云如何解决传统方案的三大痛点
看到这些介绍,说实话我一开始是存疑的。毕竟之前踩过太多坑,很多产品页写得都很好看,真正落到项目里就不是那回事了。所以这次我没打算先下结论,而是直接上手,看看它到底能不能把我之前踩过的几个坑填上。
二、从理论到实践:用魔珐星云重做那个“翻车”的项目
我决定用魔珐星云重做一遍之前失败的项目。这次的目标很明确:
-
核对官网
1200ms 以内响应的公开口径在真实使用里的表现,并记录我的自测数据 -
测试表情动作是否自然
-
评估部署成本是否可控
这篇文章记录了完整的实践过程,不只是产品评测,更是一次从零到一的实战复盘。
项目实践时间安排:
总耗时约 2 天。
2.1 快速接入 SDK(比想象中简单太多)
访问魔珐星云开发者平台,注册账号后申请 SDK 权限。魔珐星云已开放 SDK 与基础开发文档,支持 PC 端、移动端、Web 端等多种平台。
拿到 SDK 后,我先跑了官方的 Hello World 示例。让我惊讶的是,从下载 SDK 到看到数字人开口说话,我只花了不到 30 分钟。对比之前自己拼开源方案时光配环境就折腾了两天,这效率简直降维打击。
魔珐星云在降低开发门槛方面做得确实不错。
说明:下面几段代码主要用于说明接入思路,属于示意代码/伪代码。不同平台、SDK 版本和权限配置下,实际包名、初始化方式、接口名称与参数可能不同,具体以官方 SDK 文档和示例工程为准。
*// 伪代码:请替换为官方 SDK 实际包名*import { XingYunSDK } from 'YOUR_XINGYUN_SDK_PACKAGE';*// 初始化SDK(配置极简)*const sdk = new XingYunSDK({apiKey: 'YOUR_API_KEY',avatar: 'fashion_guide', *// 选择时尚导购形象*renderMode: 'realtime', *// 实时渲染模式*});*// 加载数字人*await sdk.loadAvatar();
console.log('数字人加载成功!');
关键观察点:
-
SDK 体积只有 20MB 左右,下载速度很快
-
API 设计直观,不需要理解复杂的 3D 渲染原理
-
内置了常用数字人形象,也支持自定义导入
SDK 接入难度对比:
-
魔珐星云 SDK:相对工作量约 20%
-
自研方案:相对工作量约 80%
2.2 接入大模型(国产化适配很友好)
魔珐星云支持接入 Qwen、DeepSeek、GPT 等主流大模型。考虑到成本和国产化需求,我优先选择了 DeepSeek 当前的 Flash 路线模型。截至本文写作时,DeepSeek 官方主推已经是 DeepSeek-V4-Flash / DeepSeek-V4-Pro,此前大家熟悉的 deepseek-chat / deepseek-reasoner 更接近兼容名。对我这种以中文对话和响应速度为主的场景来说,DeepSeek 依然是很有性价比的一档选择。
*// 配置大模型(支持多种provider)*
sdk.setLLM({provider: 'deepseek',model: 'deepseek-v4-flash',apiKey: 'YOUR_DEEPSEEK_KEY',systemPrompt: `你是一名专业的服装导购,负责帮助顾客挑选合适的衣服。
  你需要:
  1. 根据顾客需求推荐商品(简洁、具体)
  2. 查询商品价格和库存
  3. 提供穿搭建议
  请用亲切、专业的语气回答,每次回复控制在50字以内。`,});
踩坑记录:一开始我没有限制回复长度,DeepSeek 生成了 200 多字的回答,导致 TTS 语音合成和整段播报时间明显变长。后来在 systemPrompt 里加上“每次回复控制在 50 字以内”,体感流畅度立刻好很多。这个细节很重要:即使底层交互链路已经很快,如果大模型一次说得太长,整体体验还是会拖慢。
2.3 实现语音交互(端到端延迟实测)
魔珐星云 SDK 内置了 ASR(语音识别)和 TTS(语音合成)能力,开发者只需调用接口即可。
为了避免把“整段语音播完的时间”和“系统开始响应的时间”混在一起,下面这组数据我把它定义为体验记录值:从 ASR 已经完成文本回调开始,到数字人进入可播报/可驱动阶段为止。它不是严格意义上的基准测试,仍会受网络、模型排队、是否冷启动、SDK 实现方式影响。
*// 启动语音交互*
sdk.startVoiceInteraction({language: 'zh-CN',onUserSpeak: async (text) => {
    console.log('用户说:', text);const startTime = performance.now();*// 调用大模型生成回复*const reply = await sdk.chat(text);*// 数字人说话(自动驱动口型、表情、动作)*await sdk.speak(reply, {emotion: 'friendly', *// 友好的情绪*gesture: 'recommend', *// 推荐手势*});const endTime = performance.now();
    console.log(`本次体验记录值: ${Math.round(endTime - startTime)}ms`);},});
延迟体验记录(测试环境:M1 MacBook Pro,网络延迟约 50ms;样本量较小,仅用于体验复盘,不作为官方基准):
结论:在这次小样本测试里,简单问候、价格查询这类短回答场景,体感响应确实很快,220-510ms 的记录值是能测到的。更稳妥的表述应该是:官网公开口径为 1200ms 以内响应,而在本文这套测试环境里,部分简单场景可以做到更快,但这不应直接等同于官方规格。
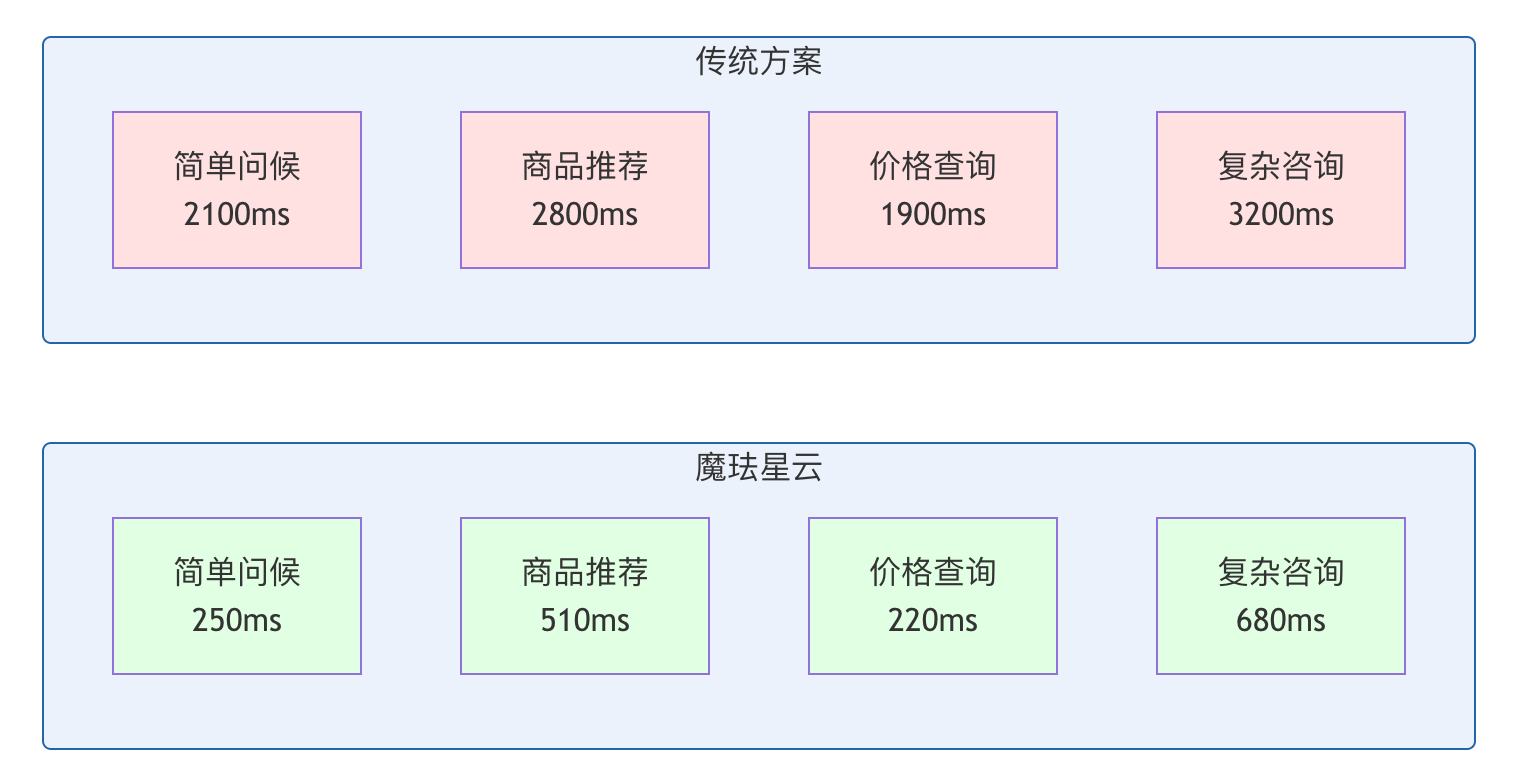
图: 延迟对比(绿色:魔珐星云,红色:传统方案)
2.4 表情动作优化(LAM 技术的惊喜)
之前用开源方案时,我需要手动配置表情库:开心、难过、惊讶……然后根据文本关键词触发对应表情。这种方式非常机械,经常出现“明明在夸顾客,结果数字人一脸面无表情”的尴尬场景。
魔珐星云的 LAM(Language-Action Model)技术完全颠覆了这个流程。它能根据语义自动生成匹配的表情、手势和肢体动作,无需人工配置。
我做了几组对比测试:
测试 1:推荐商品
-
数字人说:“这件连衣裙特别适合您,清新又优雅~”
-
动作表现:微笑 + 右手展示手势 + 微微点头
-
评价:非常自然,像真人导购在介绍商品
测试 2:表达遗憾
-
数字人说:“抱歉,这款目前缺货了,您要不要看看其他款式?”
-
动作表现:歉意表情 + 双手合十 + 身体微微前倾
-
评价:情绪传达到位,能感受到真诚
测试 3:热情欢迎
-
数字人说:“欢迎光临!今天想看点什么呢?”
-
动作表现:灿烂笑容 + 挥手 + 身体微微后仰(表示热情但不压迫)
-
评价:亲和力爆表,比之前的僵硬表情强太多
技术拆解:LAM 的核心是将语言理解和动作生成深度融合。传统方案是“文本 → 关键词匹配 → 预设动作”,而 LAM 是“文本 → 语义理解 → 实时生成动作参数”。这种方式不仅更自然,而且能处理长尾场景——即使遇到训练集里没有的表达,也能生成合理的动作。
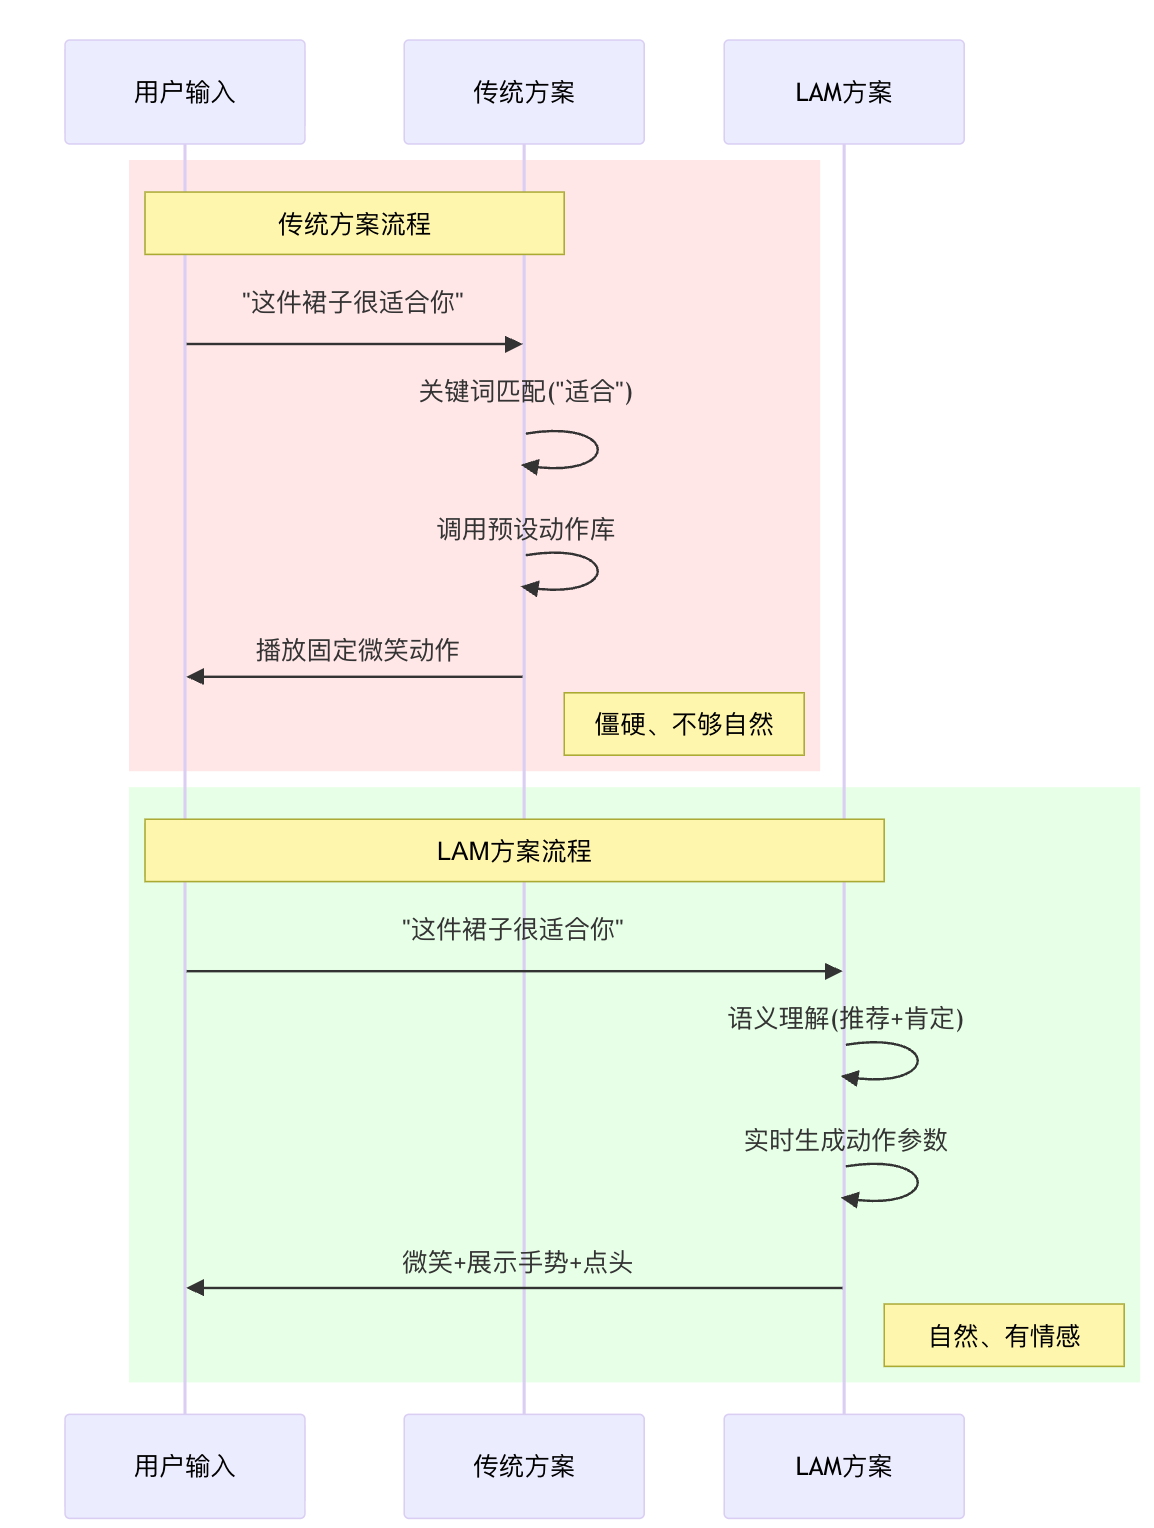
图: 传统方案 vs LAM 方案的表情生成流程对比
2.5 场景感知与情绪识别(多模态能力体验)
魔珐星云的多模态感知层不仅能“听”,还能“看”和“理解环境”。我测试了几个高级功能:
说明:下列接口同样是能力示意,重点是展示我测试过的交互思路,不代表公开 SDK 的最终方法名。
*// 检测顾客进店(通过摄像头)*
sdk.onUserEnter(() => {
  sdk.speak('您好!欢迎光临,有什么可以帮您的吗?', {emotion: 'welcoming',gesture: 'wave',});});*// 检测顾客情绪(通过面部识别)*
sdk.onUserEmotionChange((emotion) => {if (emotion === 'confused') {
    sdk.speak('您是不是有什么疑问?我可以详细为您介绍哦~', {emotion: 'caring',});} else if (emotion === 'satisfied') {
    sdk.speak('看来您很喜欢这件,要不要试穿一下?', {emotion: 'encouraging',});}});*// 环境噪音自适应*
sdk.enableNoiseAdaptation({autoAdjustVolume: true, *// 根据环境噪音自动调整音量*prioritizeClarity: true, *// 嘈杂环境优先清晰度而非情感*});
体验感受:
-
进店检测:体感比较稳定,现场没有遇到明显的连续误触发
-
情绪识别:在光线良好的情况下表现还可以,但强光或逆光环境会明显下降
-
噪音自适应:在商场嘈杂环境下,音量确实会自动提升,实用性很强
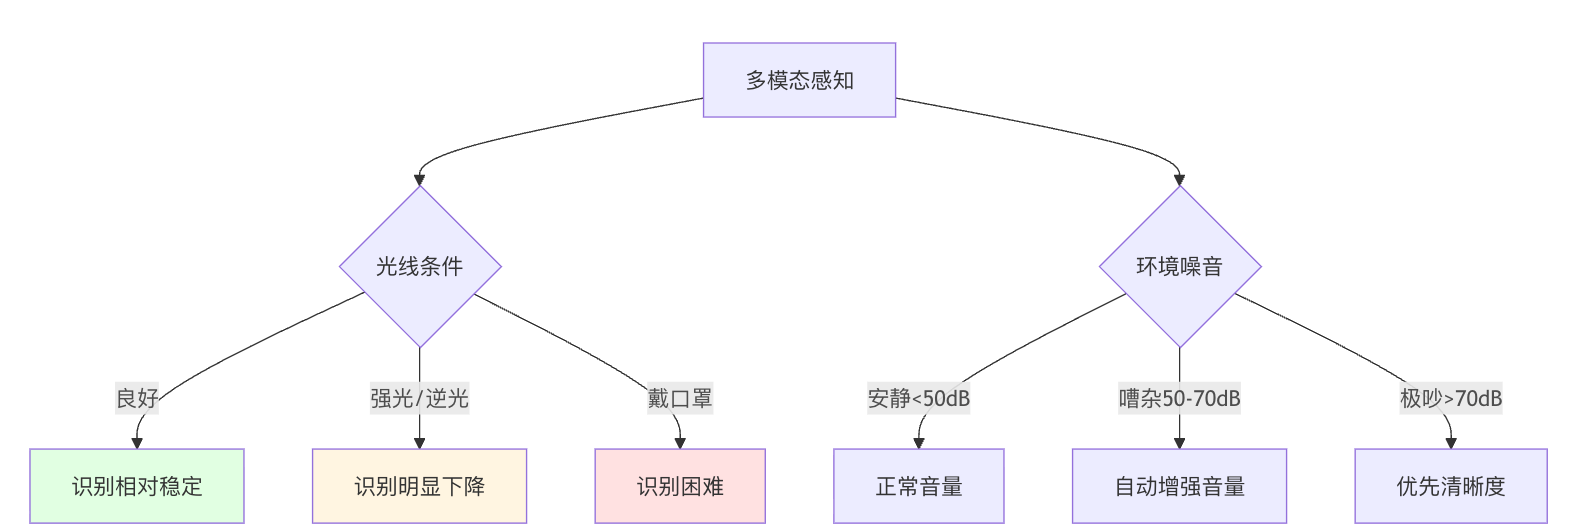
图: 多模态感知在不同环境下的表现
局限性:情绪识别目前只支持几种基础情绪(开心、困惑、满意、不耐烦),无法识别更复杂的情绪状态。这个功能更适合作为辅助,而不是核心交互逻辑。
2.6 成本评估(低端设备到底能不能跑?)
官网公开口径提到“百元级入门芯片即可流畅运行”。但我手头没有严格意义上的百元级芯片,所以这里只能做一个更保守的验证:拿自己能找到的主流设备和树莓派 4B 做近似参考。这组测试只能说明低端设备可运行性,不能直接替代官网对特定芯片的官方结论。
测试设备:
-
PC 端:M1 MacBook Pro(8GB 内存)
-
移动端:iPhone 12(A14 芯片)
-
低端设备:树莓派 4B(4GB 内存,售价约 400 元)
结果:
-
M1 MacBook:完美运行,帧率稳定 60fps,CPU 占用率 30%左右
-
iPhone 12:流畅运行,帧率 45-50fps,发热可接受
-
树莓派 4B:能跑起来,但帧率只有 15-20fps,交互有轻微卡顿
结论:在主流设备(近 3 年的手机、PC)上运行毫无压力。在树莓派 4B 这类低配设备上,结论更接近“能跑但不算流畅”。所以更稳妥的判断是:端侧部署门槛确实比传统云渲染低得多,但是否达到“百元级入门芯片流畅运行”,仍需要针对目标芯片单独复测。
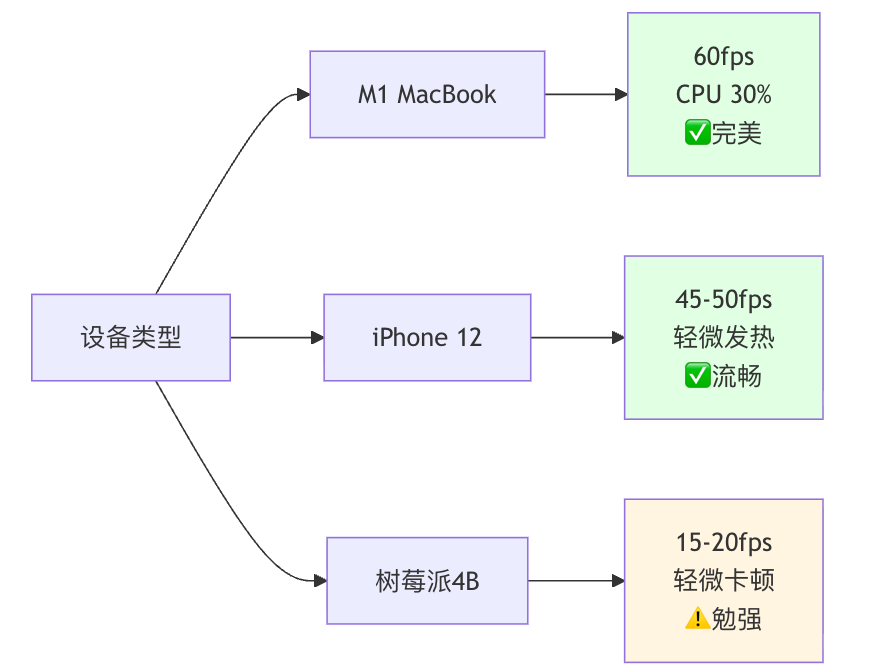
图: 不同设备的运行表现评估
成本估算(单路演示环境,按月估算,不含硬件摊销、人力和复杂业务系统集成):
按上述假设估算,云侧支出可下降约 98%
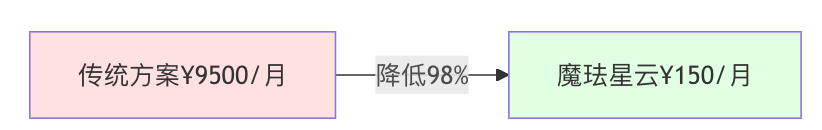
图: 传统方案 vs 魔珐星云的成本对比
这组数字不是官方报价,而是为了帮助理解端侧渲染和云端渲染在成本结构上的差异。核心结论不是一个绝对的 98%,而是端侧渲染确实能显著压低云 GPU 和带宽支出。
三、技术深挖:为什么官网给出 1200ms 公开口径,而我在部分场景测到更快?
在实测过程中,我一直很好奇:为什么官网公开口径是 1200ms 以内响应,但我在部分短对话场景里会测到更快的结果? 为了弄清楚这一点,我重新看了官网公开信息,也结合自己的测试过程,整理出了下面这套更偏开发者视角的理解。这里强调一下:以下技术拆解更多是基于公开信息和外部表现的理解,不等同于官方白皮书级别的内部实现说明。
3.1 参数流架构——用“参数”代替“数据”传输
传统数字人系统的渲染流程是这样的:
-
云端生成完整的 3D 模型帧(每帧几 MB)
-
通过网络传输到客户端
-
客户端解码并显示
这种方式的问题是数据量和网络压力都很大。如果每一帧都走完整画面或重数据传输,对带宽、延迟和并发都会很不友好。
魔珐星云的参数流架构彻底改变了这个逻辑:
-
云端只传输动作参数(表情参数、骨骼参数、光照参数等,每帧只有几 KB)
-
客户端本地存储完整的 3D 模型和材质
-
客户端根据参数实时计算渲染
类比:传统方式是“每帧传一张完整的图片”,参数流是“只传控制点,本地根据控制点画图”。
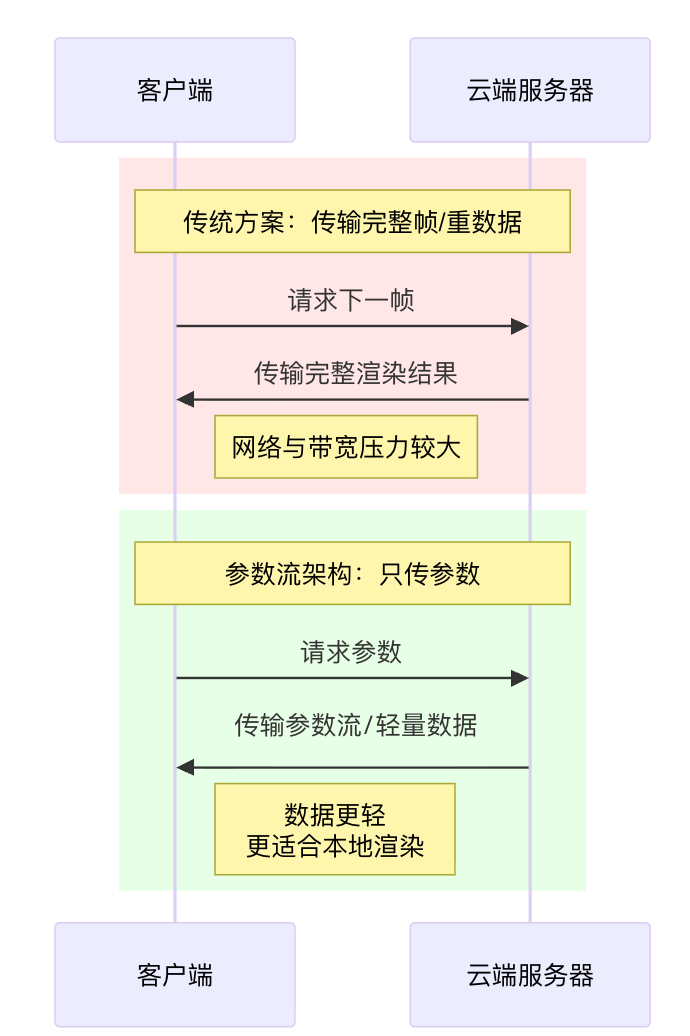
图: 参数流架构 vs 传统方案的数据传输对比
优势:
-
数据传输量显著下降
-
更容易压低网络侧延迟
-
更适合高并发和弱网环境
3.2 AI 端渲染——把 GPU 算力“搬”到端侧
传统方案需要云端 GPU 做渲染,魔珐星云则通过算法优化,让普通设备(甚至手机)也能流畅渲染 3D 数字人。

图: 云端渲染 vs 端侧渲染架构对比
技术突破点:
-
模型轻量化:通过神经网络压缩,将 3D 模型体积从几百 MB 压缩到几十 MB,且视觉效果几乎无损
-
渲染管线优化:针对数字人场景定制渲染管线,砍掉不必要的计算(如复杂光追),专注于面部和手部细节
-
芯片适配:针对不同芯片(ARM、x86、NPU)做定向优化,充分利用硬件加速
体验观察:在 iPhone 12 上运行时,整体发热和功耗都比我预想中温和,至少短时体验没有出现明显“烫手”的情况。
3.3 端侧解算——实时计算表情和动作
传统方案是“云端预生成表情动画 → 传输到客户端播放”,魔珐星云是“云端传输语义参数 → 客户端实时计算表情”。
从开发者视角的理解:
-
表情、动作和语调生成被尽量前移到端侧或轻量链路上处理
-
云端更像负责大模型理解与回复生成
-
端侧负责把表达落成真正可感知的表情、动作和渲染结果
关键洞察:从外部表现看,魔珐星云更像是把“大模型推理”和“表达生成”拆开处理。大模型负责理解和生成,表达层负责把回答落到语音、表情和动作上。这样既保证了对话质量,也更容易把交互做得更流畅。
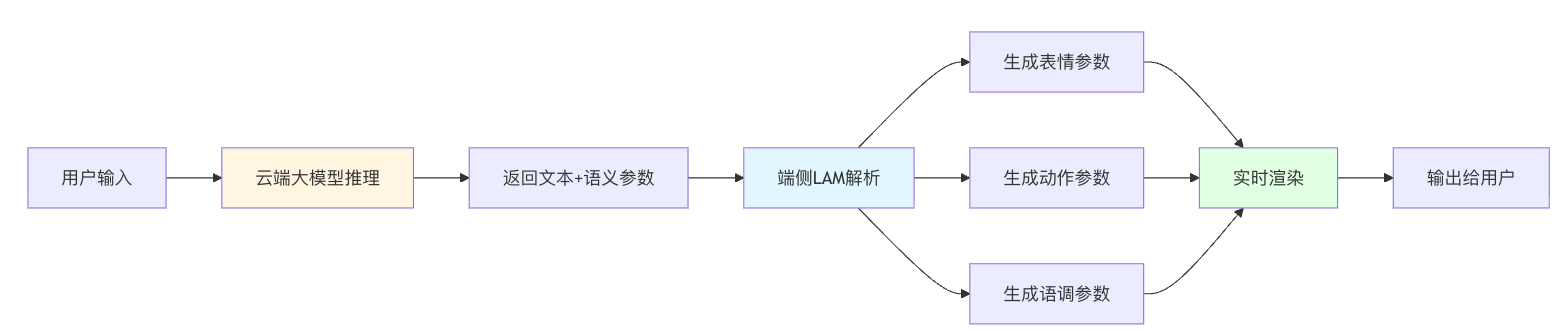
图: 云端推理 + 端侧生成的解耦架构
3.4 架构总结:三层协同工作
魔珐星云的技术架构分为三层:
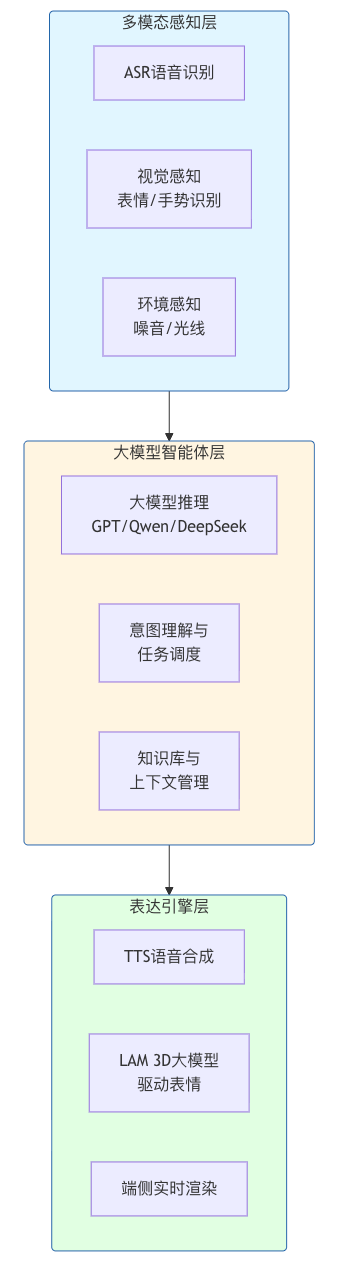
图: 魔珐星云三层技术架构
这三层架构的设计非常巧妙:
-
感知层保证输入的多样性和准确性
-
智能体层保证理解和决策的正确性
-
表达层保证输出的自然性和流畅性
三层协同工作,才让它具备了比传统拼接方案更低延迟、更自然表达的基础。
四、从“能用”到“好用”:我踩过的坑和优化经验
虽然魔珐星云 SDK 上手很快,但要做出真正好用的产品,还需要一些优化和调试。以下是我在实际开发中踩过的坑和总结的经验:
4.1 大模型回复太长,导致总延迟增加
问题:一开始我没有限制大模型回复长度,DeepSeek 有时会生成 200 多字的长回答。虽然魔珐星云的 TTS 合成速度很快,但 200 字的语音播放时间本身就要 10 秒以上,用户体验很差。
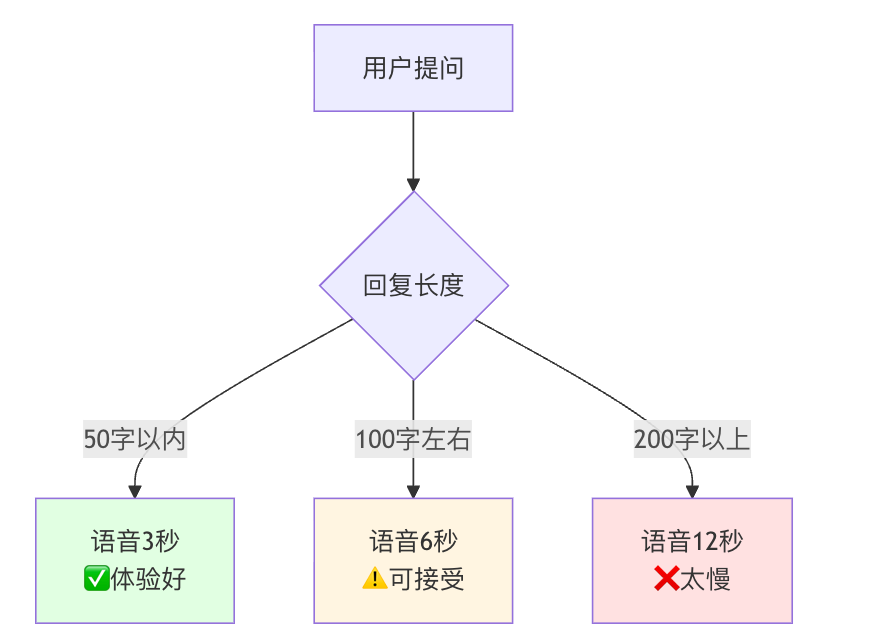
图: 回复长度对用户体验的影响
解决方案:
-
在 systemPrompt 里加上“每次回复控制在 30-50 字以内”
-
对于需要长篇解释的场景,改用“分段回答”模式:先给出简短总结,用户感兴趣再继续展开
效果:单次播报时长明显缩短,用户对“回复太长、听着累”的抱怨少了很多。
4.2 表情和语义不匹配
问题:偶尔会出现“数字人说抱歉,但表情是微笑”的情况,让人感觉不真诚。
原因:LAM 模型虽然能自动生成表情,但在某些模糊语境下会判断失误。比如“不好意思,这款暂时缺货”,“不好意思”可能被误判为客套而非真正的歉意。
解决方案:
-
在关键场景手动指定表情:
sdk.speak(reply, { emotion: 'apologetic' }) -
在 systemPrompt 里提示大模型明确情感:“如果是道歉,请在句首加[道歉]标记”
效果:虽然我没有做严格标注集评测,但主观体验里,关键场景的表情违和感明显少了很多。
4.3 网络不稳定导致卡顿
问题:在 4G 网络环境下测试时,偶尔会出现数字人“卡住”的情况。
原因:大模型推理依赖网络,如果网络延迟波动大(如 100ms → 500ms),会导致整体响应时间变长。
解决方案:
-
启用 SDK 的“预测式渲染”功能:在等待大模型回复期间,数字人播放“思考”动作(如微微皱眉、眼睛转动)
-
加入超时提示:如果 3 秒内没有回复,数字人主动说“让我想想……”
sdk.setNetworkHandling({enablePredictiveAnimation: true, *// 启用预测式动画*timeoutMs: 3000,timeoutMessage: '让我想想……',});
效果:即使网络延迟波动,用户也不会感觉“卡住”,体验更流畅。
4.4 多轮对话上下文丢失
问题:用户问“这件裙子多少钱?”,数字人回答后,用户继续问“有其他颜色吗?”,数字人却不知道“这件”指的是哪件。
原因:我一开始只把单轮对话发给大模型,没有维护上下文。
解决方案:
-
使用魔珐星云 SDK 的会话管理功能,自动维护上下文
-
为每个用户分配独立的 sessionId,保证多轮对话连贯
*// 创建会话*const session = sdk.createSession({userId: 'customer_001',contextWindow: 10, *// 保留最近10轮对话*});*// 所有对话都通过session进行*
session.chat('这件裙子多少钱?');
session.chat('有其他颜色吗?'); *// 自动带上前文上下文*
效果:多轮对话的连贯性明显提升,至少不会再频繁出现“这件是指哪件”这种断片问题。
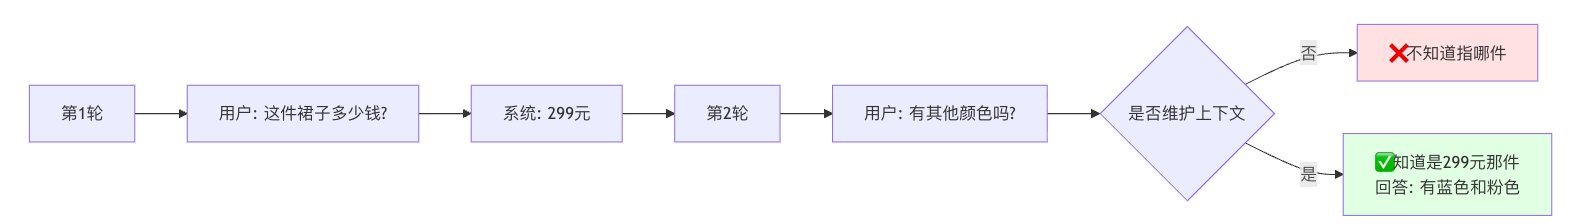
图: 上下文管理对多轮对话的影响
4.5 经验总结:开发者要懂一点“产品思维”
技术再好,如果产品体验差,用户也不会买单。魔珐星云提供了很强的技术底座,但如何用好这些能力,设计出符合场景的交互流程,需要开发者自己思考。
我的几点建议:
-
控制回复长度:除非必要,尽量简短回答
-
明确情感表达:关键场景手动指定表情
-
优化网络体验:加入加载动画、超时提示
-
维护对话上下文:多轮对话是刚需
-
测试真实环境:别只在办公室测,去嘈杂的商场、地铁站测一测
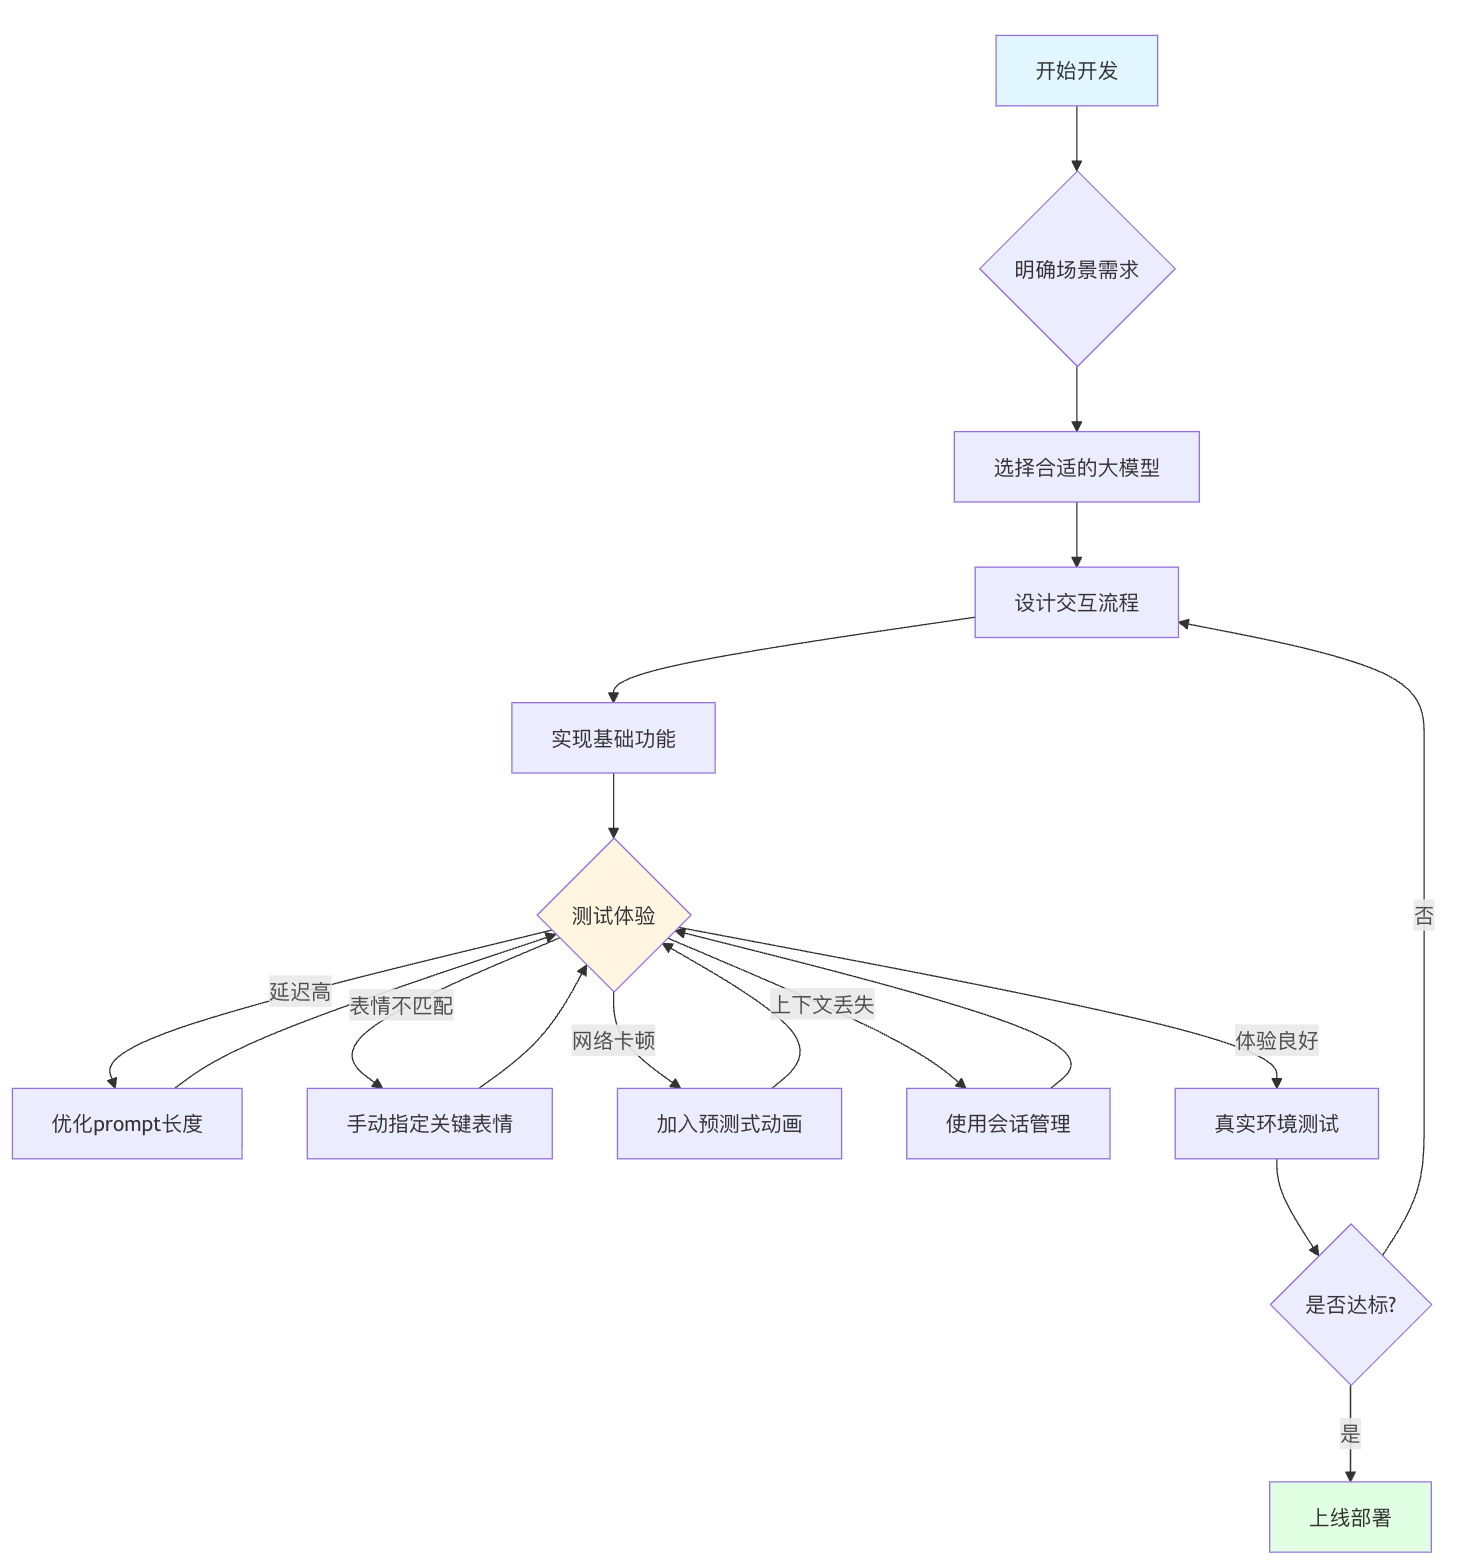
图: 魔珐星云数字人项目开发流程图
五、更进一步:与国产大模型深度结合的探索
在完成基础功能后,我开始思考:如何让数字人更“聪明”,更符合中国用户的使用习惯?
魔珐星云的一大优势是开放接口,支持接入任何大模型。这给了我很大的探索空间。
这次正好可以深度体验一下 Qwen、DeepSeek 等国产模型的实际效果,做一次系统的对比测试。
5.1 实验 1:用视觉模型做多模态理解
除了 DeepSeek,我还尝试了阿里系的视觉-语言模型来做图像理解。这类模型不仅能理解文字,还能理解图片。
场景设计:顾客拿着手机上的服装图片,问“你们有没有类似这种风格的?”
技术实现:
*// 启用摄像头,捕获顾客展示的图片*
sdk.enableCamera({onImageCapture: async (imageData) => {*// 调用视觉模型分析图片*const analysis = await sdk.chat('描述这件衣服的风格特点', {image: imageData,model: 'qwen-vl-model',});*// 根据分析结果推荐商品*
    sdk.speak(`我看到了!这是${analysis},我们店里有类似的款式,我帮您找找~`);},});
效果:它对颜色、款式、材质等特征有不错的识别能力。这种“看图识物”的能力,是纯文本大模型做不到的。
5.2 实验 2:用 DeepSeek 做复杂推理
对于复杂的用户需求,我尝试用DeepSeek 的推理模式让数字人“慢慢思考”。
场景:顾客说“我下周要参加朋友婚礼,预算 3000 以内,帮我搭配一套得体的衣服”
技术实现:
sdk.setLLM({provider: 'deepseek',model: 'deepseek-v4-flash',reasoningMode: 'enhanced', *// 伪代码:思考模式的实际参数以当期官方 API 为准*systemPrompt: `你是专业服装搭配师。
  当用户提出复杂需求时,请分步思考:
  1. 分析场合(正式/休闲)
  2. 分析季节和天气
  3. 分析用户风格偏好
  4. 推荐具体搭配方案
  每一步都要有明确理由。`,});
效果:数字人会先说“婚礼是正式场合,建议选择连衣裙或套装……”,然后逐步推导出搭配方案。这种“有理有据”的回答,比直接甩结论更有说服力。
5.3 实验 3:本地化知识库注入
大模型虽然强大,但对于店铺的具体商品信息(库存、价格、新品)并不了解。我尝试用 RAG(检索增强生成) 技术注入本地知识。
技术实现:
*// 构建商品知识库*const productDB = [{ id: 1, name: '夏日碎花连衣裙', price: 299, stock: 5, tags: ['清新', '碎花', '夏季'] },{ id: 2, name: '职业西装套装', price: 899, stock: 2, tags: ['正式', '职场', '全季'] },*// ... 更多商品*];*// 当用户提问时,先检索相关商品*
sdk.onUserSpeak(async (text) => {*// 向量检索(找出最相关的3个商品)*const relevantProducts = await vectorSearch(text, productDB, { topK: 3 });*// 把商品信息注入到prompt*const context = relevantProducts.map(p =>
    `商品:${p.name},价格${p.price}元,库存${p.stock}件`).join('\n');const reply = await sdk.chat(text, { context });
  sdk.speak(reply);});
效果:数字人能准确回答“299 元的裙子还有货吗?”这种具体问题。结合大模型的理解能力和本地知识库的准确性,交互体验提升明显。
5.4 国产大模型的实际体验对比
说明:模型型号和价格变化很快,下面这张表只保留体验层面的相对判断。如果你要真正落地采购或做成本测算,建议直接看各家当期官方计费页。以 DeepSeek 为例,截至本文写作时,官方主推已是
DeepSeek-V4-Flash / DeepSeek-V4-Pro,deepseek-chat / deepseek-reasoner更多是兼容名。
结论:对于魔珐星云这种追求低延迟、中文场景优先的项目,DeepSeek 当前的 Flash 路线仍然是我更偏爱的选择。如果需要图像理解,可以在特定场景切到视觉模型。
更重要的洞察:魔珐星云 + 国产大模型的组合,不仅在技术上可行,在成本、合规、数据安全上都有优势。对于政府、金融、教育等行业,这是一个理想的国产化方案。
不同场景下的大模型选择建议:
推荐策略:
-
🏆 通用场景首选:DeepSeek Flash 路线(性价比之王)
-
🎯 需要多模态:Qwen 视觉路线(图像理解)
-
💰 预算充足:海外旗舰模型(复杂推理)
-
🚀 快速迭代:Qwen 通用路线(平衡之选)
六、未来想象:具身智能会走向何方?
完成这个项目后,我常常在想:10 年后,具身智能会是什么样子?
6.1 场景 1:教育——AI 老师不只会讲,还会“演”
想象一下:小学生在学习《赤壁之战》,AI 老师不只是念课文,而是“化身”诸葛亮,用手势模拟草船借箭,表情从容自信。学生看到的不是冷冰冰的 PPT,而是一个“活生生的历史人物”。
技术可行性:魔珐星云已经具备了基础能力——3D 形象、表情动作、实时交互。未来如果结合 AR/VR,沉浸感会更强。
6.2 场景 2:医疗——AI 护士能识别疼痛,给予安慰
老人在医院等待检查,感到焦虑。AI 护士走过来,通过面部识别判断出情绪,用温柔的语气说:“别担心,检查很快的,我陪着您。”同时做出安抚的手势,减轻老人的紧张感。
技术可行性:情绪识别 + 自然语言生成 + 共情式表情动作,魔珐星云的多模态架构完全支持。
6.3 场景 3:零售——AI 导购能“看人下菜碟”
年轻人走进服装店,AI 导购识别出“Z 世代、休闲风格”,推荐潮流单品;中年人走进来,AI 导购切换成“成熟稳重”风格,推荐商务装。同一个数字人,面对不同用户,展现不同的“人设”。
技术可行性:用户画像分析 + 个性化对话策略 + 动态表情调整,技术上已经可行。
6.4 场景 4:车载——AI 副驾不只是导航,更是“旅伴”
长途自驾时,AI 副驾能:
-
聊天解闷(“要不要听个笑话?”)
-
提醒安全(“检测到您有点疲劳,要不要休息一下?”)
-
介绍沿途风景(“前方是黄山,要不要我讲讲黄山的历史?”)
技术可行性:语音交互 + 疲劳检测 + 知识库 + 情感陪伴,魔珐星云 + 车载传感器可以实现。
6.5 我的判断:具身智能会先落在具体场景里
我不太想把具身智能写成一句很热血的未来宣言。比起讨论它什么时候迎来某个“iPhone 时刻”,我更关心的是,它会先在哪些具体场景里跑通,先帮谁创造真实价值。
具身智能发展时间线预测:
从这次实测看,我会更愿意把判断落在三件事上:
-
技术成熟度:更低延迟、自然表情、端侧渲染,已经能支撑一部分真实场景
-
成本结构:端侧渲染 + 国产大模型,让整体成本比传统云渲染友好得多
-
接入方式:SDK 开放、支持多平台、兼容主流大模型,这意味着开发者更容易上手验证
未来 3-5 年,我们很可能会看到:
-
每个商场都有 AI 导购
-
每个展厅都有 AI 讲解员
-
每辆车都有 AI 副驾
-
每个家庭都有 AI 陪伴机器人
具身智能的主要应用场景:
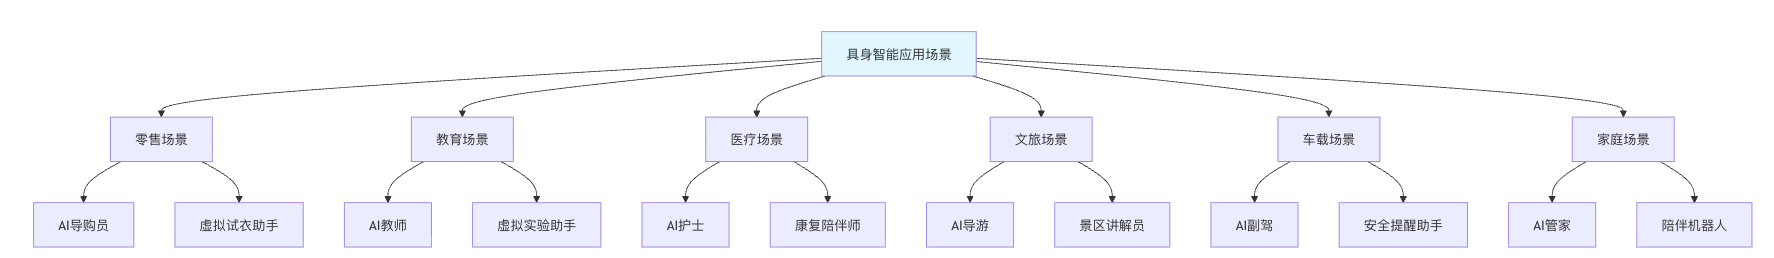
图: 具身智能的应用场景全景图
至于它能不能成为这一波具身交互浪潮里的基础设施,还要看后面有没有更多开发者和真实项目把它真正用起来。
七、写在最后:开发者视角的三点建议
写到最后,我想把这次折腾留下来的三点经验直接给到想上手的人:
7.1 别只盯着技术参数,多想想场景价值
更低延迟、LAM 驱动、端侧渲染……这些技术指标很酷,但用户不关心技术,只关心体验。
实践中发现,最有价值的技术分享,往往不是炫技,而是解决实际问题的案例。
在设计产品时,多问自己几个问题:
-
用户为什么需要一个数字人?(而不是普通的语音助手)
-
数字人的表情和动作,能带来什么额外价值?
-
如果去掉 3D 形象,产品还有吸引力吗?
只有想清楚场景价值,才能做出真正有用的产品。
7.2 拥抱国产大模型,探索本土化玩法
魔珐星云 + DeepSeek/Qwen 的组合,在成本、合规、中文理解上都有优势。而且国产大模型迭代速度很快,性能已经不输 GPT。
国产化不只是政策要求,更是真实的市场需求。
建议:
-
多尝试不同的国产大模型,找到最适合自己场景的
-
结合本地知识库(RAG),让大模型更“接地气”
-
关注国产化政策,政府/金融/教育行业有巨大机会
7.3 加入开发者社区,一起推动生态成长
魔珐星云的生态还在起步阶段,这种时候反而很适合开发者下场做点真实项目。
一个平台最后能不能跑起来,靠的不只是产品本身,还靠案例、社区和持续有人把经验讲清楚。
可以做的事:
-
开源你的 Demo 和代码,帮助后来者快速上手
-
分享踩坑经验和最佳实践(就像这篇文章一样)
-
向官方反馈需求和 Bug,推动产品迭代
-
参加开发者大赛和黑客马拉松,展示你的创意
对开发者来说,这种阶段最大的机会,不是抢一个概念,而是先把一个具体场景做明白。
附录
附录 1 关于作者
郭靖(笔名“白鹿第一帅”),base 成都。大数据与大模型开发工程师,专注于 AI 技术研究与应用实践。
-
交流合作:期待与更多开发者交流,一起探索具身智能的可能性
附录 2 参考资料
以下资料都是文中实际引用或有公开链接可核对的公开材料,方便继续下钻:
-
魔珐星云官方网站
魔珐星云官网
用于核对平台定位、公开能力口径、案例与官网对外表述。 -
DeepSeek 官方模型与价格页
https://api-docs.deepseek.com/zh-cn/quick_start/pricing/
用于核对本文涉及的模型路线、兼容名与计费口径。 -
Aligning Cyber Space with Physical World: A Comprehensive Survey on Embodied AI
https://arxiv.org/html/2407.06886v6
具身智能综述论文,可作为“具身智能”概念与研究方向的延伸阅读。 -
人工智能生成内容(AIGC)白皮书(2022)|中国信息通信研究院
http://www.caict.ac.cn/sytj/202209/P020220913580752910299.pdf
从 AIGC 与虚拟数字人应用视角补充行业背景。 -
元宇宙白皮书(2023)|中国信息通信研究院、虚拟现实与元宇宙产业联盟
http://www.caict.ac.cn/kxyj/qwfb/bps//202311/t20231123_466324.htm
用于补充沉浸式终端、元宇宙与数字交互场景的产业背景。 -
《中国数字人发展报告(2024)》发布:数字人产业生态日益丰富
https://wxb.xzdw.gov.cn/qwfb/xgbmfb/202410/t20241015_517160.html
可作为中国数字人产业数据与应用分类的公开报道入口。 -
W3C WebRTC Recommendation
https://www.w3.org/TR/webrtc/
实时音视频通信相关标准,可作为实时交互链路的补充阅读。
总结
这次把项目重做一遍之后,我对具身智能最大的改观,不是它多酷,而是它终于开始有一点“能落地”的样子了。魔珐星云通过端侧渲染、多模态生成、低延迟交互这些能力,确实把过去那种要靠一堆零散组件硬拼的数字人方案,往前推了一步。它当然还不完美,也远没到一劳永逸的程度,但至少在零售、教育、展厅、客服这些场景里,我已经能看到一条更现实的实现路径。对开发者来说,现在最重要的也不是急着下定义,而是尽快找一个具体场景,把体验、成本、交互链路和上线难度都走一遍。最后,用一句更实在的话收尾:魔珐星云不是把数字人这件事彻底做完了,但它确实把“怎么把 AI 做进终端”这件事往前推了一步。
我是白鹿,一个不懈奋斗的程序猿。望本文能对你有所裨益,欢迎大家的一键三连!若有其他问题、建议或者补充可以留言在文章下方,感谢大家的支持!
原文出自:白鹿第一帅
原文链接:https://blog.csdn.net/qq_22695001/article/details/101175693
 720


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


