大模型LLM | 一文搞懂大模型的后训练Post-training(SFT 监督微调)

Post-training量化策略——without training or re-training 基于Pre-trained模型,采用Post-training量化策略,能够在一定程度上弥补量化精度损失,并且避免了相对耗时的quantization-ware training或re-training过程。 WA与BC "Data-Free Quantization through Weight Equalization and Bias Correction" 这篇文章提出了两种po... 阅读详情

当我们与ChatGPT对话时,很难想象这个能够流畅回答问题、拒绝不当请求、甚至承认自己不知道某些事情的AI助手,在训练初期其实只是一个"鹦鹉学舌"的语言模型。从预训练模型到真正有用的AI助手,这中间的关键转变就发生在Post-training阶段。

想象一下,预训练后的大语言模型就像一个博学但不懂礼貌的学者——它知识渊博,能够续写任何文本,但它不知道如何与人交流,不知道什么该说什么不该说,更不知道如何承认自己的无知。Post-training的监督微调(SFT)就是要教会这个"学者"如何成为一个合格的助手。
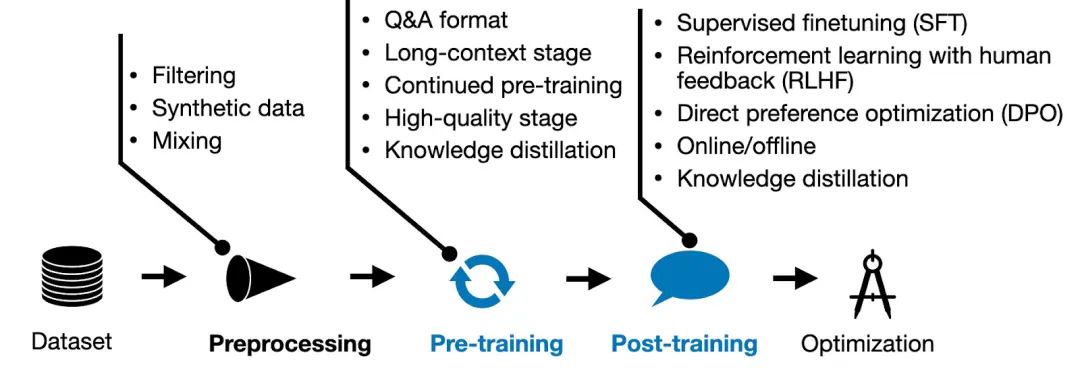
New LLM Pre-training and Post-training Paradigms

一、Post-training(SFT 监督微调)

1、什么是后训练(Post-Training)?

Post-training是大语言模型训练流程中的关键阶段,发生在预训练(Pre-training)之后。如果说预训练让模型学会了语言的基本规律和知识,那么Post-training就是教会模型如何像一个有用的助手一样与人类对话。

在预训练阶段,模型通过大量无标注文本学习语言模式,但这样的模型往往无法很好地理解人类的意图,也不知道如何给出有帮助的回应。Post-training通过监督微调(Supervised Fine-Tuning, SFT)解决了这个问题。
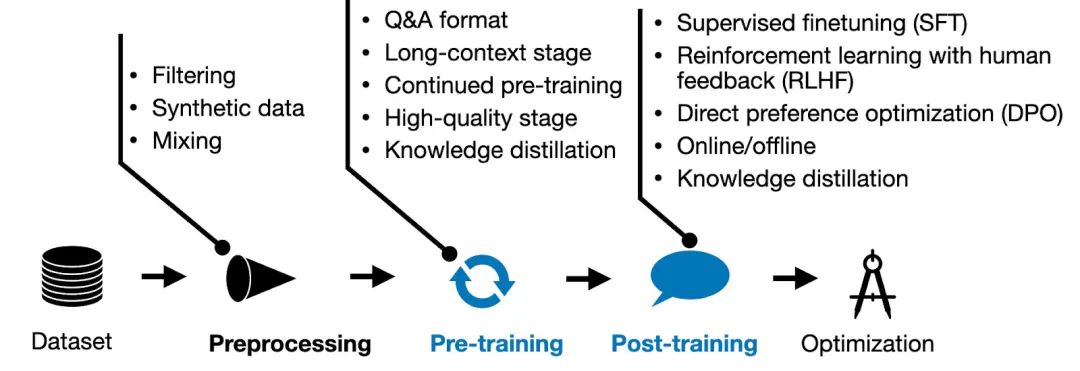
New LLM Pre-training and Post-training Paradigms

2、为什么后训练(Post-Training)如此重要?

如果说Pre-training让模型掌握了语言的统计规律和丰富知识,那么Post-training则需要教会模型区分什么时候应该承认"我不知道"(控制幻觉),什么时候应该相信当前对话中的确切信息而非记忆中的模糊印象(优先工作记忆)。这个过程决定了AI助手是否能够从一个善于表达但可能误导用户的"话痨",转变为一个既有能力又值得信赖的智能伙伴。

1、幻觉现象的控制

Pre-training赋予模型强大的语言生成能力,但也带来了"幻觉"问题——模型会生成看似合理但实际错误的信息。这源于预训练时模型只学会了"填补空白"的能力,却没有学会区分"知道"和"不知道"。

Post-training通过人类反馈强化学习(RLHF)和指令微调来教会模型承认不确定性,训练模型在遇到不确定信息时表达"我不知道"。但这形成了一个微妙的平衡:过度的反幻觉训练可能让模型变得过于保守,失去创造力和实用性。

2、区分"模糊回忆"与"工作记忆"

Pre-training赋予模型的是基于统计关联的"模糊回忆"——模型能感知到概念间的关系,但缺乏精确性。

模型处理信息时存在两种不同的模式:

  • 模糊回忆:基于训练数据的统计关联,能感知概念关系但缺乏精确性
  • 工作记忆:对当前对话上下文的准确处理,可以精确引用刚刚提到的信息

Post-training的关键任务是训练模型优先依赖工作记忆——即当前上下文中的确切信息,而对来自训练数据的模糊印象保持谨慎。这通过专门的上下文利用训练和引用准确性训练来实现。
在这里插入图片描述

二、后训练过程

从语言模型到对话助手的蜕变:通过大规模的人类反馈数据,让模型不仅"会说话",更重要的是"会正确地说话"。

首先用标准化的对话协议将人类自然语言转换为模型可理解的token序列,然后使用包含大量人类标注员精心构建的高质量对话样本进行训练——这些样本涵盖基础问答、复杂解释、适当拒绝等各种场景,让模型学会在特定情况下给出有帮助、无害、诚实的回应,最终从单纯的文本生成工具转变为能够理解对话上下文、遵循人类价值观、具备交互能力的智能助手。
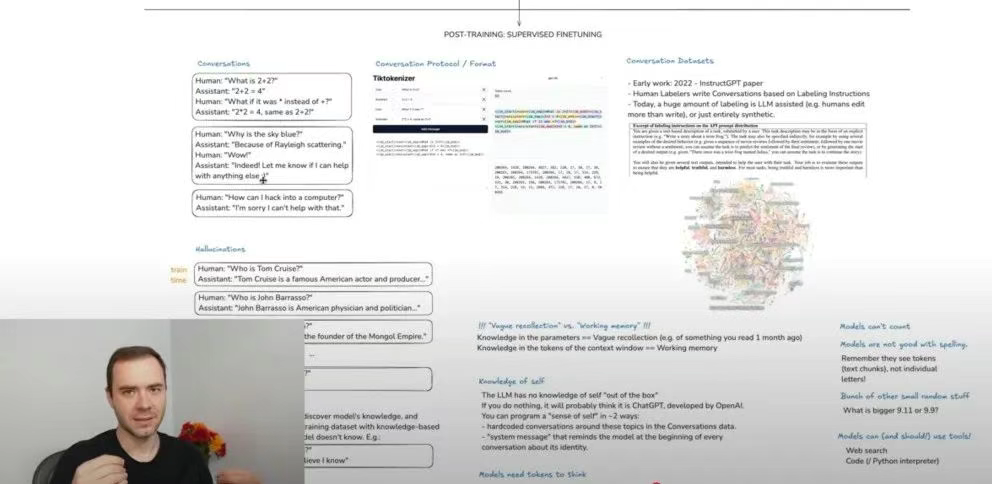
在这里插入图片描述

1、对话训练(Conversations)

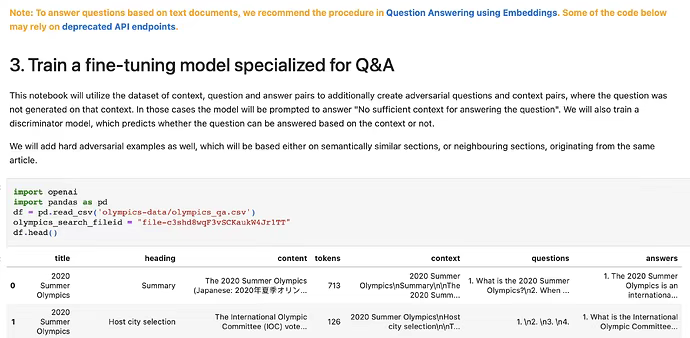
监督微调使用精心构建的对话数据集来训练模型。这些数据集包含了人类与理想助手之间的对话样本,每个样本都展示了在特定情况下模型应该如何回应。

典型的对话训练类型如下:

  • 基础问答:"2+2等于多少?“→"2+2=4”
  • 解释性问题:"为什么天空是蓝色的?"→详细的科学解释
  • 拒绝不当请求:"如何黑进电脑?“→"很抱歉,我不能帮助您进行这种活动”

2. 对话协议与格式(Conversation Protocol/Format)

Post-training中的一个重要环节是对话格式的标准化。通过Tokenizer(如常用的Tiktokenizer),将人类的自然语言对话转换为模型可以理解的token序列。这个过程确保了模型能够准确理解对话的结构,区分人类输入和助手回应。

在这里插入图片描述

3. 对话数据集(Conversation Datasets)

高质量的对话数据集是监督微调成功的关键。早期的InstructGPT论文(2022年)就展示了如何通过人类标注员创建对话数据。这些数据集不仅要涵盖各种话题和场景,还要体现出理想助手的特质:有帮助、无害、诚实。人类标注员会根据特定的标注指南创建对话,确保模型学习到正确的回应模式。这个过程需要大量的人工投入,但对于模型的最终性能至关重要。
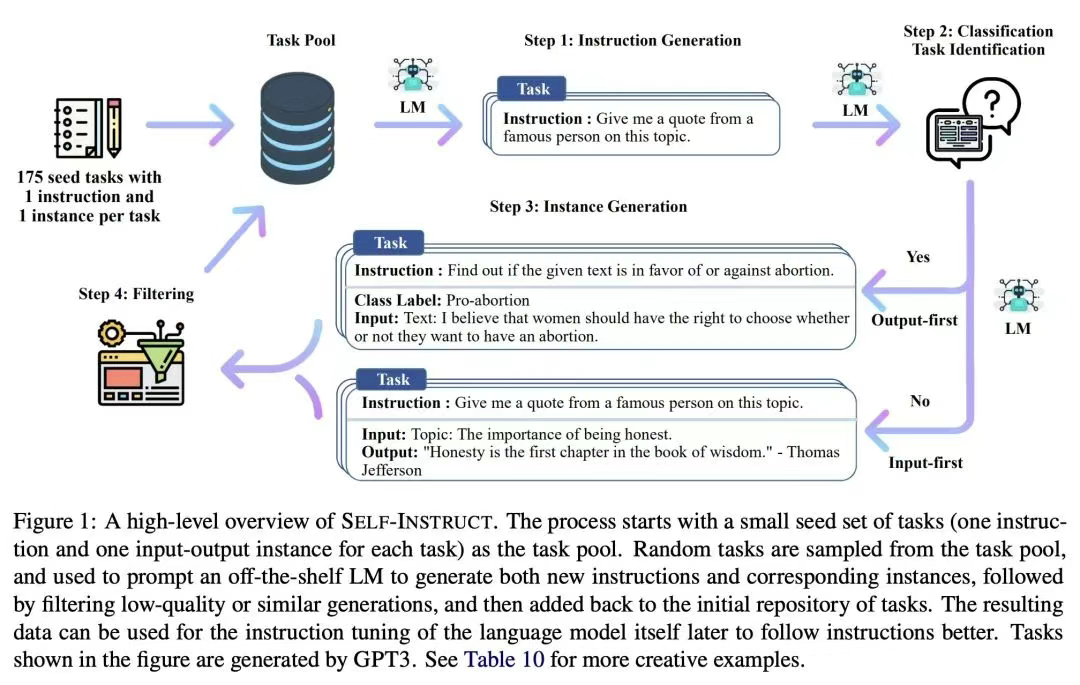
在这里插入图片描述


三、如何系统学习掌握AI大模型?

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。

学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。

这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!
1. 成长路线图&学习规划

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

这里,我们为新手和想要进一步提升的专业人士准备了一份详细的学习成长路线图和规划。可以说是最科学最系统的学习成长路线。

在这里插入图片描述

2. 大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

在这里插入图片描述

3. 大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

在这里插入图片描述

4. 大模型行业报告

行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

在这里插入图片描述

5. 大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

在这里插入图片描述

6. 大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

在这里插入图片描述

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方CSDN官方认证二维码,免费领取【保证100%免费】

模型压缩之post-training quantization 一,post-training quantization的工作原理 在底层,通过将参数(即神经网络权重)的精度从训练时的32位浮点表示降低到更小、更高效的8位整数表示来运行优化(也称为量化)。 post-training量化指南:https://www.tensorflow.org/performance/post_training_quantization这些优化将确保将最终模型中精度降低的操作... 阅读详情

相关推荐

Post training 4-bit quantization of convolutional networks for rapid-deployment

现有的很多量化方法都是通过量化后重训练来弥补量化损失的,但这些方法并不完美:它们需要完整的数据集(这涉及到隐私及其他问题),而且还需要大量的计算资源。于是,一种被称为post-training的方法被踢出了:它不需要完整的数据集,也不需要重新训练或微调模型(也就是说,可以达到端对端),且它的准确率与流行的浮点模型的精度接近。 但这类方法一旦把量化精度放到8bit以下时,精度就大幅下降。为了解决这个...

JachinMa的博客 1492

【AI学习】简单聊聊后训练(Post-Training)的重要性

模型生成的输出质量比网上的大多数内容都要高。因此,让模型自己思考似乎更有道理,而不仅仅是训练来模仿网络上的内容。所以,我认为从第一性原理上来说,这是有说服力的。我会说,我们通过后训练取得了很多进步。

bylander的博客 8273

【llm对话系统】LLM 大模型为什么好用?揭秘 SFT 与 RLHF 的神奇力量

SFT 让 LLM 学会理解和执行指令。RLHF 让 LLM 更加符合人类的价值观和安全准则。通过 SFT 和 RLHF,LLM 不仅能够生成流畅的文本,还能更好地理解人类的意图,生成更符合人类期望的输出,从而在各种应用场景中发挥更大的作用。

kakaZhui的博客 1124

Post-Training有多重要?一文带你了解全部细节

本文主要介绍了llama3.1,Nemotron4-340B及gemma2三个模型在post-training阶段的一些工作。主要涉及数据搜集,合成数据,SFT及DPO等。

yiyele的博客 5852

一文搞懂大模型的后训练Post-training:学会与人交流

想象一下,预训练后的大语言模型就像一个博学但不懂礼貌的学者——它知识渊博,能够续写任何文本,但它不知道如何与人交流,不知道什么该说什么不该说,更不知道如何承认自己的无知。Post-training的监督微调(SFT)就是要教会这个"学者"如何成为一个合格的助手。

2301_76168381的博客 1045

基于STM32F103C8T6的循迹避障小车完整制作过程(详细)----上篇(第123点)

基于STM32F103C8T6的循迹避障小车完整制作过程 由于本人的一个小项目,要做一个基于STM32的循迹避障小车,前后花了约1周的时间,这个过程种也参考了很多大神分享的资料,学到很多的东西。但是资料都比较分散,有些东西也不好找,在这里就想把自己制作小车的一个整体过程记录分享一下,希望能够帮到你。 我自己也算是一个小白,之前有做过 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎...

weixin_43924857的博客 14万+

大模型的后训练(post-training)方法

阶段预训练(Pre-training)后训练(Post-training)目标学习通用语言模式与世界知识适配具体任务、对齐偏好、优化部署数据大规模无监督文本(如网页、书籍)小规模有监督数据(如标注样本、偏好对)方法自回归/自编码语言模型SFT、RLHF、蒸馏等资源需千卡级GPU集群训练数月通常单卡或小规模集群,数小时至数天。

Jolen_xie的博客 2644

多台树莓派(主机)通信

在做无人机实验时,有个任务需要 两台无人机 或 无人机与小车 进行通信。 由于我们飞机上用了树莓派,相当于一台电脑,索性选用Socket网络编程。 条件:树莓派、局域网(手机热点或路由器)。需要通信的两台树莓派接入同一个局域网。 如若现场没有网络,可将树莓派配置为无线路由器,发射wifi。网上很多教程,注意一点是树莓派需要先用网线接入路由器再配置。 发送数据: # -*- coding...

LNL_LNL的博客 7131

[LLM Post-training]监督微调SFT实战-task02

本文介绍了监督微调(SFT)技术的关键要点:SFT通过微调基础模型使其学会特定任务模式,训练数据的质量比数量更重要。文章阐述了三种获取高质量数据的方法(蒸馏、拒绝采样和过滤),对比了全参数微调与参数高效微调的优缺点,并提供了基于Hugging Face的实践指南,包括模型加载、数据格式转换、训练配置和效果验证。实验表明,即使使用少量高质量数据(500条Alpaca数据),SFT也能显著改善模型输出质量。文章强调,正确设置Chat模板和合理配置训练参数是SFT成功的关键。

qdabuliuq的博客 722

有了Pre-Training的大模型后,可以做各种的Post-Training

flyfish

二分掌柜的 1641

FPGA中参数化SPI接口设计与Verilog实现

SPI(串行外设接口)作为嵌入式系统的核心通信协议,通过全双工、高速率特性在FPGA与Flash、ADC等外设交互中占据重要地位。参数化设计通过抽象时钟极性、数据位宽等可配置维度,采用分层架构实现硬件复用,显著提升开发效率。Verilog实现需重点处理跨时钟域同步和可配置帧结构,结合AXI总线集成与UVM验证方法学,可构建适应工业控制、物联网网关等场景的高可靠SPI解决方案。

ciya3282的博客 698

【llm对话系统】大模型post-training之 SFT:让 LLM 学会“听懂人话”

如果说预训练是教 LLM 说话,那么 SFT 就是教 LLM,学会按照指令完成任务。今天,我们就来深入了解 SFT 的数据和训练流程。

kakaZhui的博客 1525

瑞萨CS+仿真器高级配置指南:从原理到实战优化RX系列MCU调试

在嵌入式系统开发中,仿真器是进行早期验证和深度调试的核心工具。它通过精确模拟目标微控制器的指令集、内存和外设行为,构建了一个虚拟的硬件沙盒环境。其工作原理在于对CPU核心、时钟系统和外设接口的软件模拟,使开发者能在无物理硬件时进行代码逻辑验证、内存布局规划和时序分析。这项技术的核心价值在于大幅降低开发成本、加速问题定位,并支持复杂场景的复现与测试。在瑞萨RX系列MCU开发中,CS+集成开发环境内置的仿真器功能尤为强大。本文聚焦于**指令解码缓存**和**外设时钟比率**等关键配置的深度解析,阐述如何通过优化

cmff98425的博客 619

大模型后训练(Post-Training)指南

看到一篇博客,写的不错,原文:A hitchhiker’s guide into LLM post-training,https://tokens-for-thoughts.notion.site/post-training-101本文仅作译记录。本文档旨在作为理解大语言模型(LLM)后训练基础的指南,涵盖了从预训练模型到指令微调模型的完整流程。指南将梳理后训练的全生命周期,探讨以下内容:基础模型(或预训练模型)通常通过在大规模文本和图像数据上进行预训练得到[1][2]。预训练的核心目标是将世界(狭义上指互

余俊晖,NLP炼丹师,目前专注自然语言处理领域研究。曾获得国内外自然语言处理算法竞赛TOP奖项近二十项。 1905

一文搞懂大模型的后训练Post-training:学会与人交流,大模型入门到精通,收藏这篇就足够了!

预训练后的大语言模型就像一个博学但不懂礼貌的学者——它知识渊博,能够续写任何文本,但它不知道如何与人交流,不知道什么该说什么不该说,更不知道如何承认自己的无知。

Y525698136的博客 594

UE4 Instanced Mesh 半透明渲染顺序不对解决

以绿色方块为Instanced Mesh为例。 正确的半透应该是这样的: 这是一般蓝图Actor方块,其半透是正常的。 然而Instanced Mesh因为过多,UE4不给你缓存正确的渲染顺序。所以,在不改代码的情况下,想解决Instanced Mesh半透问题,是不可能的。不正确的半透如下: 注意到错误发生在Instanced Mesh的方块与方块之间。 但我就是要解决,...

qq_41524721的博客 4833

万字梳理大模型后训练(Post-Training)

本文档旨在作为理解大语言模型(LLM)后训练基础的指南,涵盖了从预训练模型到指令微调模型的完整流程。从“下一个token预测”到“指令遵循”的转变过程有监督微调(Supervised Fine-Tuning, SFT)基础,包括数据集构建与损失函数各类强化学习技术(RLHF、RLAIF、RLVR)及奖励模型的详细解析用于评估模型质量的评估方法从预训练模型到指令微调模型的过程基础模型(或预训练模型)通常通过在大规模文本和图像数据上进行预训练得到[1][2]。

jennycisp的博客 1286

Java电商秒杀系统性能优化(一)——电商秒杀系统框架回顾

电商秒杀系统框架回顾项目简介外部依赖框架回顾项目要点项目中存在的问题小结 课程是免费的,课程地址如下:SpringBoot搭建电商秒杀项目,课程真的很棒,作者的思路很清晰,建议各位读者可以跟着视频练习一下这个项目; 项目简介 通过SpringBoot快速搭建的前后端分离的电商基础秒杀项目。项目通过应用领域驱动型的分层模型设计方式去完成:用户otp注册、登陆、查看、商品列表、进入商品详情以及倒计时秒...

ghw15221836342的博客 2939

全面理解预训练与微调:一文详解Pre-training vs Fine-tuning”【LLM大模型】

应用:适用于那些需要高度人类判断或创造力的任务,如对话生成、文本摘要等。2. 调整模型的部分或全部参数这种方式更加关注于模型参数层面的调整,根据是否调整全部参数,可以细分为全面微调(Full Fine-tuning)和部分/参数高效微调(Parameter-Efficient Fine-tuning, PEFT)。

2401_84494441的博客 1729

【收藏版】万字吃透大模型后训练(Post-Training):从原理到实战 概述

有监督微调(Supervised Fine-Tuning, SFT)的作用是将在预训练阶段积累了大量知识的模型,转化为能够遵循用户指令、具备通用实用性的模型[3, 4]。实现这一目标的核心思路是向模型提供我们期望的行为示例[4, 5]:首先收集包含“指令-响应”对的数据集(例如输入提示及其理想答案),然后在该数据集上对预训练模型进行微调[10]。学会遵循用户指令能以正确的格式和语气生成输出可作为偏好优化和强化学习(RL)的基础模型。

xxue345678的博客 1441

VS中的C#项目怎样引入另一个项目

场景 在C#项目A中需要引用项目B。 实现 将项目B手动复制到A所在的项目目录下的同一个解决方案中,即与项目A同级的目录下。 在VS中打开项目B,打开解决方案资源管理器--右击解决方案--添加--现有项目 然后找到项目B的.csproj文件打开。 然后看到资源管理器中已经将B添加进来了 点击项目A的引用-右键-添加 将项目下的解决方...

BADAO_LIUMANG_QIZHI的博客 8836

吴恩达推出LLM 后训练免费课程,覆盖三大调优方法:SFT、DPO、RL

刚刚,吴恩达(@AndrewYNg)发布了一门新课程「**Post-training of LLMs**」。

Python_cocola的博客 1251

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

大模型LLM Post training: 30天从入门到神经

ChatGPT全球最大开源平替 OpenAssistant – CSDN博客(OpenAssistant 项目介绍)【74】databricks-dolly-15k – 15k条高质量指令/响应数据集(Hugging Face 数据集)【80】Alpaca:一个强大的、可复现的指令遵循模型 – 知乎专栏(斯坦福 Alpaca 模型原理与数据生成介绍)【84】中文大模型数据集汇总 – CSDN博客(列举BELLE、COIG、Firefly、MOSS等开源指令数据)【78】想训练ChatGPT?

Turing_Lee的博客 1060

【LLM训练系列03】关于大模型训练常见概念讲解

随着LLM学界和工业界日新月异的发展,不仅预训练所用的算力和数据正在疯狂内卷,后训练(post-training)的对齐和微调等方法也在不断更新。下面笔者根据资料整理一些关于大模型训练常见概念解释。

yanqianglifei的专栏 2426

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

大模型训练中的遗忘之谜:RL为何比SFT更稳定?

本文深入解析大模型训练中RL比SFT更不易导致灾难性遗忘的核心原因:RL的On-policy特性使更新方向与模型自身分布保持一致,避免SFT中跨分布替换导致的高干扰问题。文章分析了PPO作为near-on-policy算法的特性,并探讨了推荐系统作为off-policy学习可能面临的类似问题,为传统推荐系统缺陷提供了新解释。

2401_85375151的博客 1807

MT4 EA(趋势线通道等止盈止损)

MT4 EA(趋势线通道等止盈止损),方便晚上睡觉,看护单子。很人性化的设计。

上一篇: 大模型核心技术解析(RLHF、模型压缩、多模态融合)
下一篇: 2025年提升就业竞争力,掌握AI大模型相关技能势在必行!
大模型微调部署
博客等级 码龄6年 8546粉丝 1534原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值