


 本文深入解析了深度学习中的反向传播算法与梯度下降法,介绍了如何通过链式法则计算梯度,并利用梯度下降优化神经网络参数,减少损失函数,实现模型训练。
深度学习之反向传播与梯度下降
有了前馈神经网络,又有了损失函数,就可以使用反向传播算法来更新神经网络中的参数,使得网络的输出尽可能地接近真实值。反向传播算法就是通过链式法则,从最后面的损失函数开始到前面的每一层网络都对参数进行求导,得到梯度之后再使用梯度下降算法更新参数,使得模型的损失函数的输出尽可能小,本质上是损失函数的最优化问题。假设神经网络的输入值为x,输出值为y,激活函数为f,参数为W,偏置量为b,损失函数为L。则第n层的输入值为x(n)x^{(n)}x(n) 输出值为y(n)y^{(n)}y(n) ,参数为W(n)W^{(n)}W(n) , 偏置量为b(n)b^{(n)}b(n) ,有:
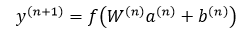
求参数W(n)W^{(n)}W(n) 以及偏置量b(n)b^{(n)}b(n) 对于损失函数L的梯度,使用链式法则:
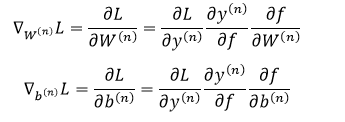
又由于:
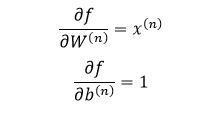
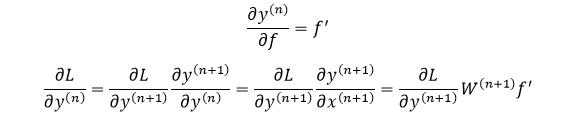
利用上述式子即可求得神经网络第n层的参数W(n)W^{(n)}W(n) 以及偏置量b(n)b^{(n)}b(n) 对于损失函数L的梯度▽W(n)L\bigtriangledown_{W^{(n)}}L▽W(n)L和▽b(n)L\bigtriangledown_{b^{(n)}}L▽b(n)L,求第n层的偏导数需要用到第n+1层求得的偏导数以及参数,所以整体的计算过程应该是从后向前反向进行,这也是反向传播算法名称的由来。有了梯度之后,由于梯度指示的是损失函数上升最快的方向,所以按着梯度的相反方向就可以使损失函数的值下降,因此可以使用梯度下降算法来对参数进行优化,计算公式如下:
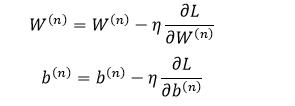
上述式子中η表示学习率,可以理解为学习的速率,学习率是深度学习训练时最重要的超参数之一,学习率选取的好坏直接决定了模型能否训练到最优以及训练到最优所需的时间。学习率设置太小,模型收敛速度会很慢,设置太大,梯度下降时有可能会跨越过最优点。在神经网络实际训练过程中通常会使用一些技巧来加快网络的收敛速度,例如批规范化(Batch Normalization)和Dropout正则化等。


 扫一扫


 1万+

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


