35岁前端危机破局:收藏!被优化3个月后,我发现的AI转型捷径

AI写作不是提示词工程,而是人机认知对齐 AI写作本质上是人与大语言模型之间的认知协同过程,其核心在于弥合人类意义理解与模型模式匹配之间的语义鸿沟。它并非简单优化提示词技巧,而是通过角色定义、场景锚定、约束设定等系统化方法,实现目标读者、业务目标与语言表达的三重对齐。这一过程强调人类在价值判断、情感温度和伦理权衡上的不可替代性,同时将确定性文字任务交由AI高效执行。技术价值体现在提升信息精准度、降低沟通损耗、加速内容迭代;典型应用场景覆盖营销文案、政务公文、医疗科普、法律文书等强专业性与高对象敏感性领域。本文聚焦‘认知对齐工程’这一底层逻辑,提供可 阅读详情

老张被优化 3 个月了,踩了无数坑,最后发现能走通的路比想象中少。

这篇文章,我记录了他的真实经历和收入数据,帮你少走弯路。

开篇:老张的 35 岁危机

还记得我上一篇写的那个 35 岁前端朋友老张吗?

就是那个"技术栈没问题,Vue3+TS 都会,项目经验也够"的老张。3 个月前被 HR 叫进会议室,拿了 N+1 走人。

这 3 个月,我看着他从一个自信满满的"老前端",变成每天刷招聘软件到深夜的焦虑中年。

但他也有优势:10 年项目经验,知道怎么把需求落地,知道怎么跟产品撕,带过好几批新人。

所以他决定转型 AI。不是转行,是用 AI 重新武装前端技能。

3 个月,他试了 5 条路。今天我把他的真实经历和收入数据都摊开说,帮你少走弯路。

5 条路的总览

❌ 路 1:纯学 Python 转后端
❌ 路 2:死磕算法转 AI 研究
❌ 路 3:做培训/知识付费
✅ 路 4:AI+ 前端工程化
✅ 路 5:AI 应用开发

前 3 条他走了,发现走不通。后 2 条目前最稳,有收入验证。

下面一条条说。

❌ 路 1:纯学 Python 转后端

老张的想法:AI 都是 Python 写的,学会 Python 就能转 AI 开发。

实际情况:

  • • 花了 1 个月学 Python 语法、Django、FastAPI
  • • 发现后端岗位也在裁员,35 岁后端一样难找
  • • 跟 25 岁的计算机硕士拼算法和底层,拼不过

为什么走不通:

    1. 年龄劣势没解决 - 后端也吃青春饭
    1. 竞争更激烈 - 后端岗位少,候选人多
    1. 前端积累浪费了 - 10 年前端经验用不上

老张的总结:“别为了转 AI 而抛弃自己的核心优势。”

❌ 路 2:死磕算法转 AI 研究

老张的想法:学深度学习、Transformer,进大厂做 AI 算法工程师。

实际情况:

  • • 买了吴恩达的课,看了 3 周,数学基础跟不上
  • • 去面试算法岗,对方问"发过什么论文"
  • • 人家要的是硕士博士,他连简历关都过不了

为什么走不通:

    1. 门槛太高 - 算法岗基本要求硕士起步
    1. 时间成本 - 补数学至少要 1-2 年
    1. 岗位太少 - 一个算法岗几百人抢

老张的总结:“除非你有数学底子或愿意读研,否则别碰。”

❌ 路 3:做培训/知识付费

老张的想法:把转型经验做成课程,卖给别人。

实际情况:

  • • 录了 3 节课,发到 B 站,播放量 200
  • • 知识星球开了,进了 5 个人(3 个还是朋友)
  • • 没人愿意为"没结果的人"付费

为什么走不通:

    1. 没结果就没信任 - 你自己都没转型成功,凭什么教别人
    1. 市场饱和 - 割韭菜的太多了,用户被教育聪明了
    1. 需要流量 - 没粉丝基础,内容再好也卖不出去

老张的总结:“等你转型成功了,再考虑做培训。顺序别搞反。”

✅ 路 4:AI+ 前端工程化(目前最稳)

核心思路:不抛弃前端技能,用 AI 增强前端能力,做别人做不了的事。

具体做什么

    1. RAG 知识库 + 前端界面
  • • 帮企业搭建内部 AI 助手
  • • 用现成框架(LangChain、LlamaIndex)
  • • 前端负责交互界面和用户体验
    1. VS Code AI 插件开发
  • • 给前端工作流做 AI 增强
  • • 发布到市场,收赞助或付费版
    1. AI 工作流咨询
  • • 帮传统公司搭建 AI 开发流程
  • • 按小时或按项目收费

收入参考(老张的实际数据 + 市场调研)

类型项目描述时间投入收入范围
企业内训给传统公司讲 AI+ 前端工作流1 天5k-15k/次
私活外包RAG 知识库 + 前端界面2-4 周20k-50k/项目
技术咨询帮公司搭建 AI 开发流程按小时500-1500 元/小时
开源赞助VS Code AI 插件/工具库持续维护$100-1000/月

注:以上数据来自程序员客栈、电鸭社区、GitHub Sponsors 等平台的公开报价,实际收入因个人能力/地区/客户类型而异。

为什么能走通

    1. 前端经验是优势 - 你知道怎么做好用户体验
    1. 竞争相对小 - 纯后端不懂前端,纯前端不懂 AI
    1. 需求真实存在 - 传统公司都想上 AI,但不知道怎么做

老张目前的进展:接了一个 3 周的外包项目(RAG 知识库 + 管理后台),报价 35k,正在开发中。

✅ 路 5:AI 应用开发(被动收入潜力)

核心思路:用 AI API 快速开发小工具,做订阅制或广告变现。

具体做什么

    1. 订阅制 SaaS 工具
  • • AI 写作助手、AI 绘图工具、AI 效率工具
  • • 定价¥29-99/月,100 用户就能月入 3k-10k
    1. 微信小程序
  • • AI 头像生成、AI 文案助手、AI 翻译
  • • 广告 + 内购,日活 1000≈1k-3k/月
    1. 企业定制开发
  • • AI 客服、智能助手、自动化流程
  • • 单项目 30k-80k,3-6 周交付

收入参考(社区案例)

类型项目描述时间投入收入范围
订阅制工具AI 写作/绘图/效率 SaaS初期开发 + 运营100 用户×¥29=¥3k/月
微信小程序AI 头像/文案/工具类1-2 周开发广告 + 内购 1k-10k/月
定制开发企业 AI 客服/智能助手3-6 周30k-80k/项目
模板/课程AI 工作流模板/教程一次性99-299 元×销量

注:数据来源《2025 中国独立开发者报告》及公开社区案例,取中位数。

为什么能走通

    1. 开发成本低 - 用现成 API,不用自己训练模型
    1. 可规模化 - 一次开发,多人使用,边际成本低
    1. 前端优势大 - 用户体验决定留存率

老张的计划:外包项目做完后,用 2 周时间做一个 AI 写作助手的小程序,测试市场反应。

📋 给 35 岁前端的具体建议

基于老张的经历,我总结了几条实操建议:

建议 1:别和 AI 比写代码,比懂业务

错误做法:

  • • ❌ 花 3 个月学 Rust(和 AI 比谁写得好)
  • • ❌ 追求"手写所有代码"(证明自己的能力)
  • • ❌ 抵触 AI 工具(“AI 生成的代码不可靠”)

正确做法:

  • • ✅ 深入理解所在行业(电商/金融/教育…)
  • • ✅ 成为"最懂业务的技术"(产品愿意拉你聊需求)
  • • ✅ 用技术解决业务问题(而不是炫技)

老张能接到 RAG 项目,不是因为他懂 LangChain,而是因为他懂"企业知识库"的业务场景——他知道员工会怎么查资料、会遇到什么问题。

建议 2:建立"前端+"优势

纯前端没壁垒,但"前端+X"有。选一个方向,深耕 3-6 个月:

组合价值学习路径
前端 + AI 工程化帮团队提效Prompt 设计、工作流、自动化
前端 + 数据用数据驱动决策埋点、分析、可视化
前端 + 产品能独立负责功能需求分析、原型、用户调研
前端 + 全栈独立交付完整功能后端 + 数据库 + 部署

老张选的是前端 + AI 工程化 + 全栈,现在能独立负责一个 AI 功能从 0 到上线的全流程。

建议 3:尽早让自己"不可替代"

问自己 3 个问题:

    1. 我的工作,应届生 + AI 能做吗?
  • • 如果答案是"能",你现在就在危险区
    1. 如果明天被优化,我的简历有亮点吗?
  • • 如果只有"做了 XX 个项目",没有"解决了 XX 问题",需要补充
    1. 离开现在平台,我还能找到同样薪资的工作吗?
  • • 如果答案不确定,说明你的价值绑定在平台上,不是个人能力

如果答案是否定的,现在就开始改变。

📋 30 天行动计划

如果你也想转型,照这个节奏来:

第 1 周:打基础

  • • 学会用 Cursor/Codeium 等 AI 编程工具
  • • 了解 LangChain/LlamaIndex 基础概念
  • • 用 AI API 做一个小 Demo(如聊天机器人)

第 2 周:做项目

  • • 选一个方向(工程化 or 应用开发)
  • • 做一个完整项目(能展示的那种)
  • • 发到 GitHub,写清楚技术栈和功能

第 3 周:找客户

  • • 注册程序员客栈/电鸭社区
  • • 完善个人主页,展示项目
  • • 主动联系 5-10 个潜在客户

第 4 周:收反馈

  • • 接第一个小单(价格可以低)
  • • 收集客户反馈,优化流程
  • • 把案例写成文章,发公众号/知乎

⚠️ 避坑建议

    1. 别辞职转型 - 先兼职做,有稳定收入再考虑全职
    1. 别追求完美 - 先做出能用的,再优化
    1. 别闭门造车 - 多跟社区交流,找同行者
    1. 别忽视前端 - 你的核心优势还是前端,AI 是增强不是替代

最后说两句

老张上周跟我说了一句话:

“我以为 35 岁是经验的起点,没想到差点成了终点。”

但好消息是,他正在把 35 岁变成真正的起点。

35 岁危机是真实的,但路不是只有一条。

老张走了 3 条弯路,花了 2 个月时间。希望你看完这篇文章,能直接走那 2 条最稳的。

转型不是重新开始,是用新技能武装旧经验。

前端 10 年,不是包袱,是底气。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
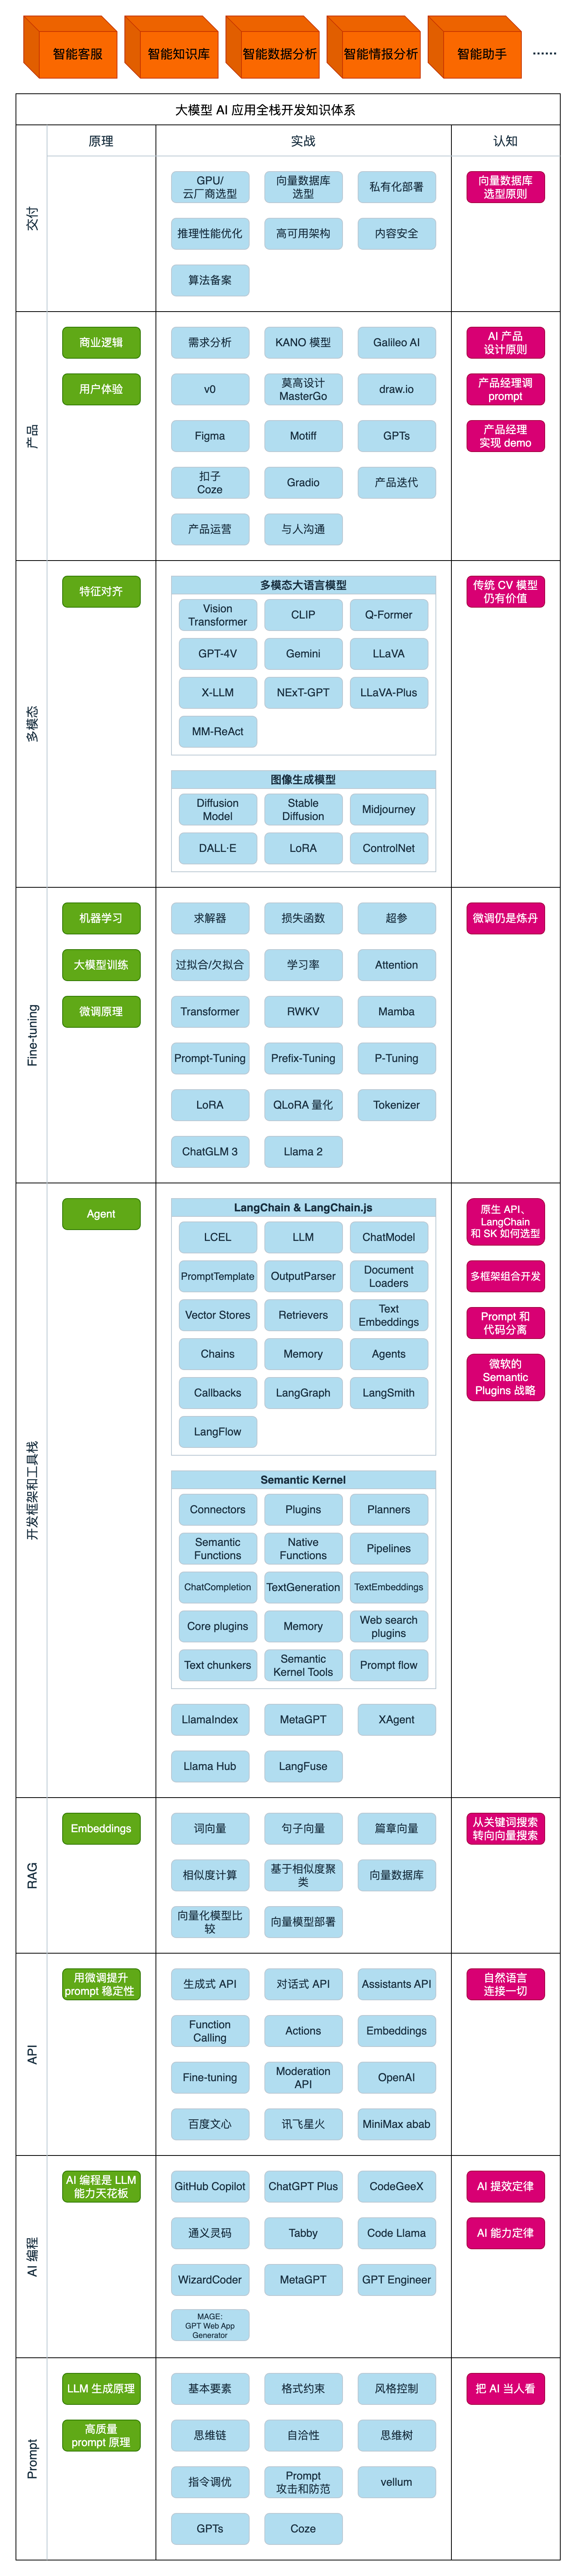
第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

Zoomla!逐浪CMS一键升级至v8.5.4完整解决方案 Zoomla!逐浪CMS作为国内领先的内容管理系统,基于ASP.NET技术栈构建,采用分层架构与插件化设计,支持高内聚、低耦合的模块扩展。系统核心由内容管理引擎、模板渲染中心、权限控制模型与多终端适配中间件组成,全面支撑企业级网站集群建设。v8.5.4版本通过重构安全框架、优化缓存机制及引入自动化升级通道,显著提升系统稳定性与运维效率。其技术演进始终围绕用户需求驱动,从早期单站模式发展为支持分布式部署、微服务集成的现代化平台,广泛应用于政府、教育、金融等领域,成为国产CMS生态中的标杆产品。 阅读详情

相关推荐

基于PbootCMS的响应式高端网站模板设计与实现

编辑媒体查询:/* 针对iPad Pro (1024px) */width: 96%;/* 手机竖屏 */

weixin_42311427的博客 1927

F407 做激光雷达数据解析可行性分析

本文探讨如何利用STM32F407单片机高效处理激光雷达原始数据,实现协议解析、坐标变换与点云输出。通过DMA接收、FPU加速和查表优化,F407可在低成本场景下稳定完成边缘预处理,显著降低主控负载,适用于教育、AGV避障等实时性要求高的应用。

n7o8p的博客 4万+

FPGA以太网接口设计避坑指南:GMII与RGMII时序转换的三种实现方案对比

本文深入解析FPGA以太网接口设计中GMII与RGMII时序转换的三种实现方案,包括Xilinx官方IP核、手工原语逻辑和开源方案gmii_to_rgmii。通过对比分析各方案的优缺点和适用场景,为工程师提供技术选型指南,帮助避免常见设计陷阱,提升高速网络设备开发的效率和可靠性。

weixin_42570484的博客 362

STM32F407VET6 值得买吗?

本文从性能、外设、开发体验和实际应用出发,全面解析STM32F407VET6在嵌入式开发中的优势与局限,探讨其在工业控制、HMI和通信网关等场景的适用性,并对比国产替代方案,为工程师选型提供参考。

sam99的博客 1万+

Stable-Baselines3性能优化:多环境训练对比指南(DummyVecEnv vs SubprocVecEnv)

本文深入对比了Stable-Baselines3中DummyVecEnv与SubprocVecEnv两种向量化环境的性能差异与应用场景。DummyVecEnv适用于轻量级、步进快的环境,调试友好且开销低;而SubprocVecEnv则通过真正的多进程并行,能显著加速计算密集型环境的训练。文章通过基准测试与决策树,指导开发者根据环境计算成本、CPU核心数等关键因素做出最优选择,以实现训练效率最大化。

weixin_29063979的博客 141

90nm CMOS工艺下6μW超低功耗LDO设计实战:从原理图到版图全解析

本文详细解析了在90nm CMOS工艺下设计一款静态功耗仅为6μW的超低功耗LDO(低压差线性稳压器)的全过程。文章深入探讨了如何通过改进型翻转电压跟随器(FVF)架构实现无输出电容设计,在满足极低功耗和芯片面积高效(chip-area-efficient)要求的同时,确保环路稳定性与快速瞬态响应,为物联网、可穿戴设备等应用提供关键电源管理解决方案。

weixin_29196613的博客 264

为什么92%的MCP国产化项目在第三阶段崩溃?深度解析国密SSL双向认证调试断点(含GDB+Wireshark联合抓包实录)

直击MCP国产化部署调试痛点,详解第三阶段崩溃根因与国密SSL双向认证调试断点定位。结合GDB源码级调试与Wireshark协议层抓包实录,覆盖金融、政务等高合规场景,提升排障效率5倍以上,值得收藏。

InstrFun的博客 7141

PySide6多线程避坑大全:信号槽崩溃、内存泄漏,这些雷我都帮你踩过了

本文深入探讨了PySide6多线程开发中的常见问题与解决方案,包括信号槽崩溃、内存泄漏等典型陷阱。通过实战案例和优化策略,帮助开发者避免UI线程操作错误、有效管理资源生命周期,并提升跨线程通信的可靠性。特别针对PySide6多线程特性,提供了线程安全日志、死锁检测等实用调试技巧。

weixin_32288959的博客 394

RWK35xx语音合成TTS播报血压心率数据

本文介绍如何利用国产RWK35xx语音合成芯片,在电子血压计等医疗设备中实现离线TTS语音播报。该方案支持本地化、低功耗、快速响应的中文语音输出,适用于老年人和视障人群的健康监测场景,结合STM32可轻松集成到嵌入式系统中。

weixin_35835018的博客 1万+

YOLO系列算法改进 | Head改进篇 | 融合Detect_LSCD轻量共享卷积检测头 | 轻量化设计破解计算瓶颈,增强复杂场景目标感知能力

YOLO系列算法改进 | Head改进篇 | 融合Detect_LSCD轻量共享卷积检测头 | 轻量化设计破解计算瓶颈,增强复杂场景目标感知能力 (以YOLO26最新目标检测模型为基础,融合Detect_LSCD检测头进行改进)

2502_91881744的博客 697

C# 实现 Modbus 通信全教程(支持 TCP 和 RTU,含完整错误处理)

环境准备:安装 NModbus4 库,明确设备参数(IP/串口、地址、数据类型);连接设备:TCP 用 TcpClient,RTU 用 SerialPort,注意超时和参数匹配;读写数据:根据数据类型调用对应方法(读保持寄存器用 ReadHoldingRegisters);错误处理:捕获连接、超时、协议等异常,针对性排查问题。掌握这些后,即可轻松实现与工业设备的 Modbus 通信,为上位机开发提供稳定的数据交互能力。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 2051

收藏!35岁程序员裸辞转行大模型:从焦虑到月薪翻倍,我踩过的坑与捷径

很多人说,35岁是程序员的“职业终点”,但我想说,35岁也可以是“新起点”。大模型带来的技术革命,给了我们30+程序员一次“换道超车”的机会。我们的经验不是包袱,而是让我们更快抓住技术本质、更好落地价值的底气。如果你现在正处于迷茫中,不妨从今天开始,花1小时了解一下大模型,写一个简单的API调用程序。行动起来,就会发现,焦虑会慢慢消失,未来也会越来越清晰。

m0_48891301的博客 908

用 CDS 作为 Referenced Data Source 开发 SAP Gateway OData 服务,一条更轻的 SEGW 路线

本文介绍了SAP Gateway项目中从传统手工建模到基于CDS View的现代化开发方式转变。主要内容包括: 传统方式需要在SEGW中手动创建Entity Type、Entity Set等元素,并在DPC_EXT中编写大量查询逻辑,存在模型层和业务逻辑重复表达的问题。 7.50版本后,SAP Gateway与ABAP CDS深度集成,可通过SEGW直接引用CDS View作为数据源,自动生成数据模型和SADL读取逻辑,支持完整的OData查询功能。 最佳实践建议通过Consumption View而非直接

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 678

前端破局必看!AI 大模型是小白 & 程序员的高薪捷径,建议收藏反复学

当前前端领域仍有稳定的市场需求,但不可否认的是,需求规模正逐步收缩。这种行业变化并非前端独有,纵观整个技术领域,随着技术迭代速度加快,开发者们常会陷入两种状态:要么在重复工作中逐渐麻木,陷入技术舒适区;要么敏锐察觉到行业变化,产生强烈的危机感。而想要在行业变革中立足,主动探索新方向、实现自我突破,已成前端开发者的必然选择。

python12345_的博客 911

零基础学simulink仿真建模--使用Simulink来构建一个混合动力无人机中燃料电池与锂电池协同控制的仿真模型

延长飞行时间:燃料电池的能量密度高于锂电池,适合长时间稳定供电。提高功率密度:锂电池能够快速响应瞬时高功率需求,比如起飞和加速阶段。优化能源管理:通过有效的能量管理系统,可以根据实际需求动态调整燃料电池和锂电池的工作状态,从而提高整体效率。通过上述步骤,我们简要介绍了如何基于Simulink实现混合动力无人机中燃料电池与锂电池协同控制的仿真模型。

amy_mhd的博客 187

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

结构可学习剪枝全解:从 Dynamic Pruning 到模块级稀疏策略实战

本文聚焦于 **结构可学习剪枝(Structure-Aware / Dynamic Pruning)** 技术,从算法机制、训练融合策略到工程部署落地路径全面解析,帮助你从“剪多少”走向“剪得动 × 剪得准 × 部署得掉”。 > > 我们将覆盖: > > - 各类结构剪枝方案的机制与优劣分析(Head、Neuron、Channel) > - 动态稀疏训练(DST) × 可学习门控机制 × L0 正则剪枝策略 > - LLaMA / GPT 等模型上的剪枝实践结果与部署可行性验证 > - 与量化

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1万+

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

shell 脚本编程4

shell 脚本编程 一、字符串处理 1.字符串截取及切割 1)子串截取 子串截取的三种用法: 应用:隐藏身份证后6位;做验证码a=’0123456789‘ 随机截取四位数字;给电脑配随机密码,每次取四位,用for循环; (1)KaTeX parse error: Expected 'EOF', got '#' at position 39: …始计位数) #̲phone='1...

570588398 1万+

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

吐血测评!国产三大顶流大模型API实战踩坑:DeepSeek数学代码封神,Kimi长文本Agent杀疯了,GLM稳如老狗!

意图识别层:接入轻量级模型,判断用户是闲聊、代码求助、还是业务数据查询。分发路由层路由 A:遇到代码生成、SQL 优化、复杂逻辑推导 ➡️ 转发至。路由 B:遇到长文档总结、合同比对、多文档交叉分析 ➡️ 转发至Kimi-K2.6。路由 C:遇到系统状态查询、内部工单流转、API 调用 ➡️ 转发至GLM-5.1。后处理层:统一进行敏感词过滤和结果包装,返回给前端。拒绝捧一踩一,作为工程师,我们要做的是把合适的模型放在合适的业务漏斗里,用最少的 Token 算力,解决最大的问题。

Kimi的博客 1188

借助RTX4090的DeepSeek推理框架提升政务热线助手效果调优

本文探讨基于DeepSeek模型与RTX4090显卡的政务智能热线系统构建,涵盖模型推理优化、硬件适配、部署实践及性能评估,提出通过KV Cache、量化、LoRA微调等技术提升响应速度与准确性,支持高并发低延迟服务。

weixin_42592399的博客 6559

OpenAI跨境直播带货翻译脚本生成落地应用

本文探讨OpenAI在跨境直播带货中的应用,重点分析其翻译脚本生成的技术原理、系统架构与落地实践,涵盖多语言处理、提示工程、合规风控及未来多模态演进方向。

weixin_36122351的博客 1万+

大学生买什么开发板最合适?F407 性价比分析

本文分析了STM32F407开发板为何适合大学生学习嵌入式系统,对比F103与H7系列,指出F407在性能、外设和学习成本间的平衡优势。结合主流品牌正点原子、野火、安富莱的特点,帮助学生做出合理选择,并展示其在电赛、毕业设计等实际项目中的应用价值。

alpha的博客 1872

为什么92%的PHP表单项目在麒麟V10+达梦V8上首次部署失败?国产化引擎选型避坑指南

解决PHP表单国产化适配难题,详解麒麟V10+达梦V8部署失败根因。聚焦PHP低代码表单引擎国产化,提供中间件兼容改造、SQL方言适配、信创环境测试三步法,提升一次部署成功率。覆盖政务、金融等信创场景,值得收藏。

ByteGlow的博客 694

RWK35xx语音识别引擎切换备用方案

本文探讨在RWK35xx语音芯片缺货情况下,如何通过架构设计实现主备语音引擎无缝切换。提出基于ESP32、Synaptics SDK和科胜讯CX20921的三种替代方案,并强调抽象驱动层与统一接口的关键作用,确保应用层零修改,提升产品供应链韧性与技术自主性。

weixin_42393362的博客 1122

github镜像网站收藏夹公开:高效获取开源AI项目

借助国内GitHub镜像站点,开发者可高效下载并部署IndexTTS2情感语音合成系统。该项目支持中文情感控制、参考音频驱动与一键启动脚本,显著降低本地化语音合成的技术门槛,提升开源AI项目的落地效率。

weixin_28729843的博客 637

Jira低成本国产方案大揭秘:2025年最值得选择的国产替代产品

【摘要】随着企业对成本控制和数据合规性需求的提升,Jira项目管理工具的高昂费用和本土化不足问题日益凸显。本文对比分析了2025年主流国产替代方案(飞书项目、板栗看板、Ones等)的核心功能与适用场景,指出国产工具在中文化支持、私有化部署和成本效益方面的优势,并提供了从Jira平稳迁移的实施建议。数据显示,国产替代方案可降低80%成本,同时满足敏捷开发需求,特别适合预算有限且重视数据安全的中小企业。选择时需综合考量功能匹配度、团队适配性和迁移成本等因素。

linT_T的博客 1420

前端的焦虑,你想过30岁以后的前端路怎么走吗?

曾几何时,我总会很庆幸自己进了前端这个行业。因为在这个职业范畴里面,我如鱼得水,成长很快,成就感满满。然而,随着年龄和工龄的增长,渐渐发现自己的瓶颈越来越明显了,我感觉自己似乎碰到了前端的天花板。 原因何在 1.从客观原因来看,前端相对于后端的入门门槛确实低了不少。公司对前端的需求量虽然很旺盛,但是对前端的技术能力要求却不是很高,特别是一些小公司或者不是技术驱动的公司。这给人一种错觉,好像只需要懂...

weixin_34247155的博客 777
上一篇: AI时代,从“纯码农“到“业务+AI“双驱动高薪架构师的转型指南
下一篇: 程序员正在经历裁员潮,真相不是AI抢饭碗这么简单
爱喝白开水a
博客等级 码龄2年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值