


目前单个嵌入式设备算力不足以训练模型,运行大语言模型进行推理,算力也是很吃紧的。嵌入式设备上可以部署轻量模型推理软件栈。
如何构建嵌入式设备模型软件栈:
1、构建自己的模型文件格式;
模型文件 = 权重(token向量表,每一层W/B)+计算图(onnx有,可选)+元信息(张量型状,数据类型)
2、数据处理流程,如下图,当然如果前处理和后处理适合在NPU上计算,也可以push到NPU上;

3、构建python,c接口库,提供模型构建工具集,模型推理接口库等;
4、支持TensorFlow,PyTorch,ONNX等模型,并提供工具将这些模型转换成自己的模型,而且提供工具分析自己的模型;
5、提供模型评估工具,支持精度评估,性能评估,内存评估等;提供模拟器支持在PC等平台下加载、执行模型;精度分析一般用余弦距离或欧氏距离等分别分析完整模型推理精度和逐层推理精度;
| 字段 | 说明 |
| OpType | 算子 |
| Call |
单帧内核算子运行次数
|
| CPU(ns) |
单帧内核算子在 CPU
上的总耗时
|
| NPU(ns) |
单帧内核算子在 NPU
上的总耗时
|
| Total(ns) |
单帧内核算子的总耗时
|
| Ratio(%) |
单帧内核算子的总耗时与单帧总耗时的比值
|
| 字段 | 说明 |
| Core |
使用的核心数
|
| Command |
寄存器配置及相关控制信息的内存占用(
MB
)
|
| Internal |
模型中间
Tensor
的内存占用(
MB
)
|
| Weight |
模型权重
Tensor
的内存占用(
MB
)
|
| KVCache |
模型
KV Cache
的内存占用(
MB
)
|
| Total |
模型整体内存总占用(
MB
)
|
6、支持推理,量化,稀疏,矩阵运算,自定义算子,动态shape,数据排布等特性和功能;支持NPU/GPU/CPU调度,Cache管理等;支持图级别/算子级别/内存优化等优化机制和流程;
7、为了提高推理性能,需要提供分级缓存,数据零拷贝特性,构建高效神经网络算子执行流水线;下图显示了典型层的推理过程中(涉及四个操作)缓存的使用情况。操作 1 是 DMA 将数据直接从 DDR 传输到 L2。操作 2 将数据从 L3 移动到 L2。操作 3 将数据从 L2 传输到 L3。操作 4 将数据从 L3 移动到 DDR。操作 2 和 3 的效率比操作 1 和 4 高十倍以上。利用前一层的特征映射可能导致三种情况:只有操作 1(如果输入层和前一 层输出完全位于 DDR 中);只有操作 2(如果前一个特征映射完全适合 L3/MSMC);或操作 1 和 2(如果前一 个输出对于 L3 太大,部分存储在 DDR 中)。计算出当前层的特征映射后,操作 3 会优先将数据移动到 L3。如 果超过 L3 容量,操作 4 会将多余的数据存储在 DDR 中。权重值始终存储在 DDR 中,并在需要时直接提取到 L2。这种三级高速缓存架构避免了计算周期内缓慢的 DDR 读取/写入操作并节省了 DDR 带宽,从而显著提高了推理效 率。提高效率和节省带宽的关键在于最大限度地提高 L3 利用率,从而防止在 DDR 中存储特征映射。下一节将介 绍如何分析模型的内存使用情况。图中NPU为C7xMMA,该名称来源于 NPU 的两个组成部分:C7000 系列浮点数字信号处理器和矩阵乘法加速器 (MMA)。C7x 系列 DSP 内核会运行 RTOS,在模型内负责数据调度和非线性处理。MMA 与 C7x 深度耦合,负责线性代数运算(如矩阵乘法和 2D 卷积);

| 内存使用说明 | 可缓存 | 属性 |
| L1 SRAM | - | 暂存 |
| L2 SRAM | - | 暂存 |
| L3 SRAM | - | 暂存 |
| 存储每层的固定输入,如权重 | 是 | 永久性 |
| 中间层输出结果(用于模型转换) | 否 | 暂存 |
| 中间层输出结果(模型推理) | 否 | 永久性 |
| 每个层临时使用的空间,用于累积输出值并取最大值 | 否 | 暂存 |
| 存储统计信息和一些记录信息 | 否 | 暂存 |
| 记录每层的基本信息 | 是 | 永久性 |
| 每个层的算法应用使用的空间 | 是 | 暂存 |
| 在处理抢占时存储上下文 | 否 | 永久性 |
| 网络结构 | 是 | 永久性 |
| 用于多核模式下的多核同步 | 否 | 永久性 |
| 存储一些常量,例如卷积参数 | 是 | 永久性 |
8、软件栈根据导入的模型文件,构建计算图和数据处理流水线;
9、端侧推理这块,只有约20%的算力需要GPU/NPU处理,约80%的算力都部署在CPU上了,CPU上需要运行软件栈和维护算法流水线;
10、端侧推理需要解决五项关键的 ODML 约束条件:延迟时间(无需往返服务器)、隐私性(没有个人数据离开设备)、连接性(无需连接到互联网)、大小(缩减了模型和二进制文件大小)和功耗(高效推理和缺少网络连接);
11、端侧使用GPU运行算子可以用OpenGL,OpenCL,Vulkan等库,MNN,NCNN是对这些库进行了封装;在NPU上运行算子需要使用专用的NPU软件栈,ARM的NPU软件栈是ARM NN;Android NNAPI已废弃,改成提供TensorFlow Lite 运行时库,方便更新;华为昇腾的CANN和英伟达CUDA也有嵌入式方案,但不支持手机设备;Pytorch TensorFlow都有自己的端侧软件栈;
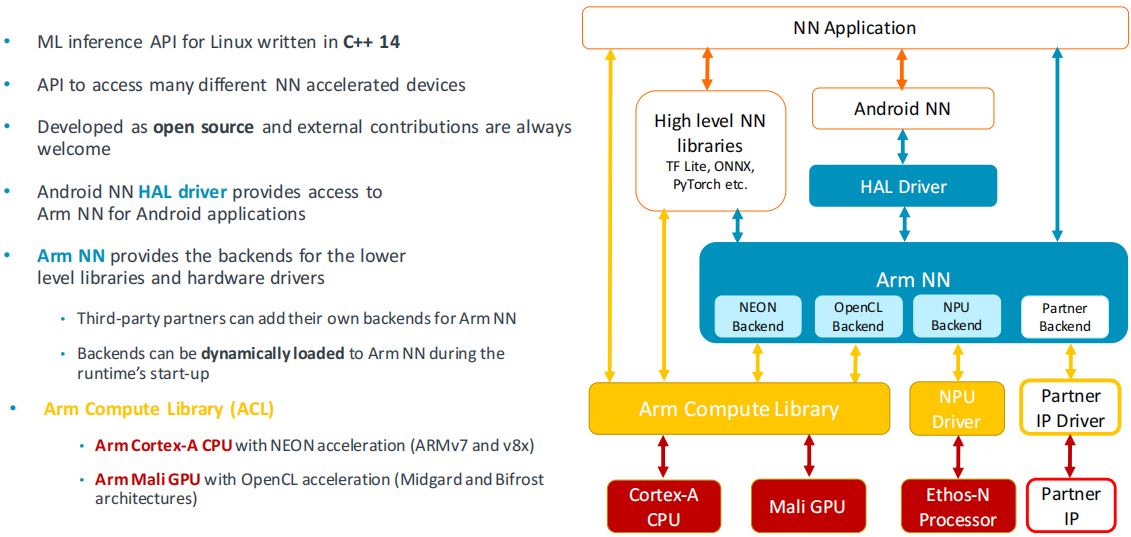
ARM NN Overview
12、算子可以运行在CPU上(ARM芯片组可用SME,SVE,NEON等指令扩展优化性能),可以运行在GPU,NPU,TPU上,其中TPU是谷歌自研的,主要优化TensorFlow网络;主流后端硬件加速有:
13、端侧往往提供NPU模块,NPU对向量运算,卷积,激活函数等性能优化进行专用硬件设计,NPU通常采用SIMD(Single Instruction, Multiple Data,单指令多数据)或更专用的架构;GPU采用SIMT(Single Instruction, Multiple Threads,单指令多线程)。
OS软件栈大致分层:SDK如ARMNN,CANN,CUDA;AI框架如Pytorch TensorFlow;LLM+Tools就是各类AI应用,比如人脸识别,实体识别,语音合成等等,其中包括模型文件。端侧中SDK和AI框架往往融合在一起了,比如NCNN,MNN,Pytorch Mobile,TensorFlow LiteRT。

常见开源模型:
CNN模型:MobileNetV2、ResNet50、YOLOv5、YOLOv6、YOLOv8等视觉识别与检测模型
LLM模型:Qwen2.5 0.5B、1.5B、3B、Qwen3 0.6B、 1.7B、 4B等大语言模型
VLM模型:FastVLM、Qwen2.5 VL、Qwen3 VL等视觉语言多模态模型
常见的国产NPU:瑞芯微RK182X系列
典型架构:RISC-V/DSP + MAC阵列 + SRAM + DMA + NoC + 高速接口


应用场景:
| 应用领域 | 代表技术模型 | 示例任务 |
|---|---|---|
| NLP | Transformer, LLM | 翻译、问答、摘要、对话生成 |
| CV | CNN, Vision Transformer | 分类、检测、分割、合成 |
| Speech/Audio | RNN, Tacotron, Wav2Vec | 识别、合成、去噪、风格迁移 |
| 时间序列预测 | LSTM, TCN, Transformer | 股票、电力、交通、气象 |
| 控制与机器人 | 强化学习、模仿学习 | 自动驾驶、机械臂控制 |
| 医疗健康 | CNN, Transformer | 医学影像、基因、药物发现 |
| 遥感GIS | CNN + 地理信息处理 | 土地分类、灾害检测 |
| AIGC生成内容 | GAN, Diffusion, LLM | 文本、图像、音频、代码生成 |
题外话:2025年国内产业主要缺少成熟硬件方案和训练软件栈
 215


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


