


目录
一、RAG定义
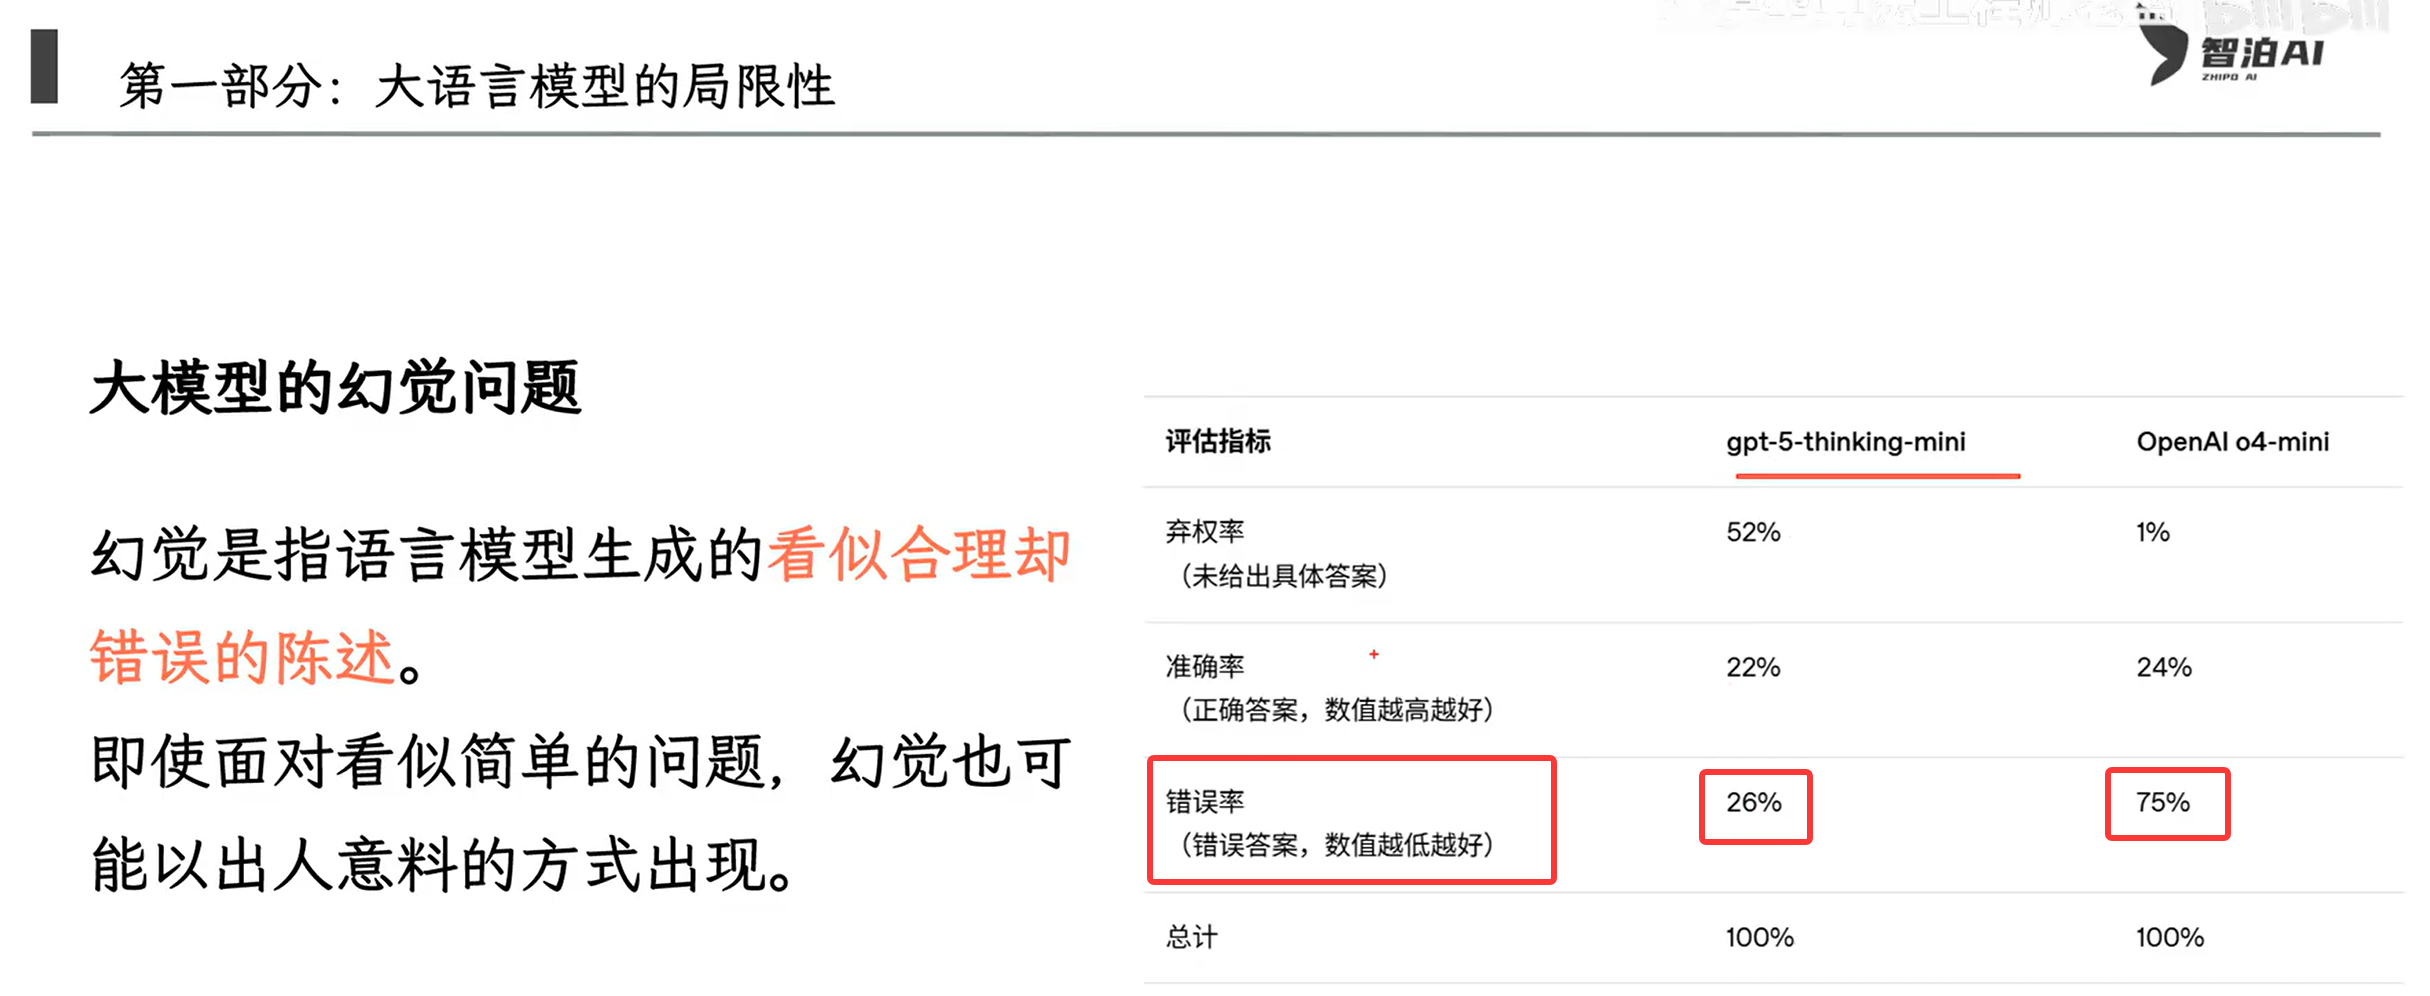
1.目前大模型的幻觉问题(看似合理却错误的陈述),仍然比较高,26年错误率高达26%
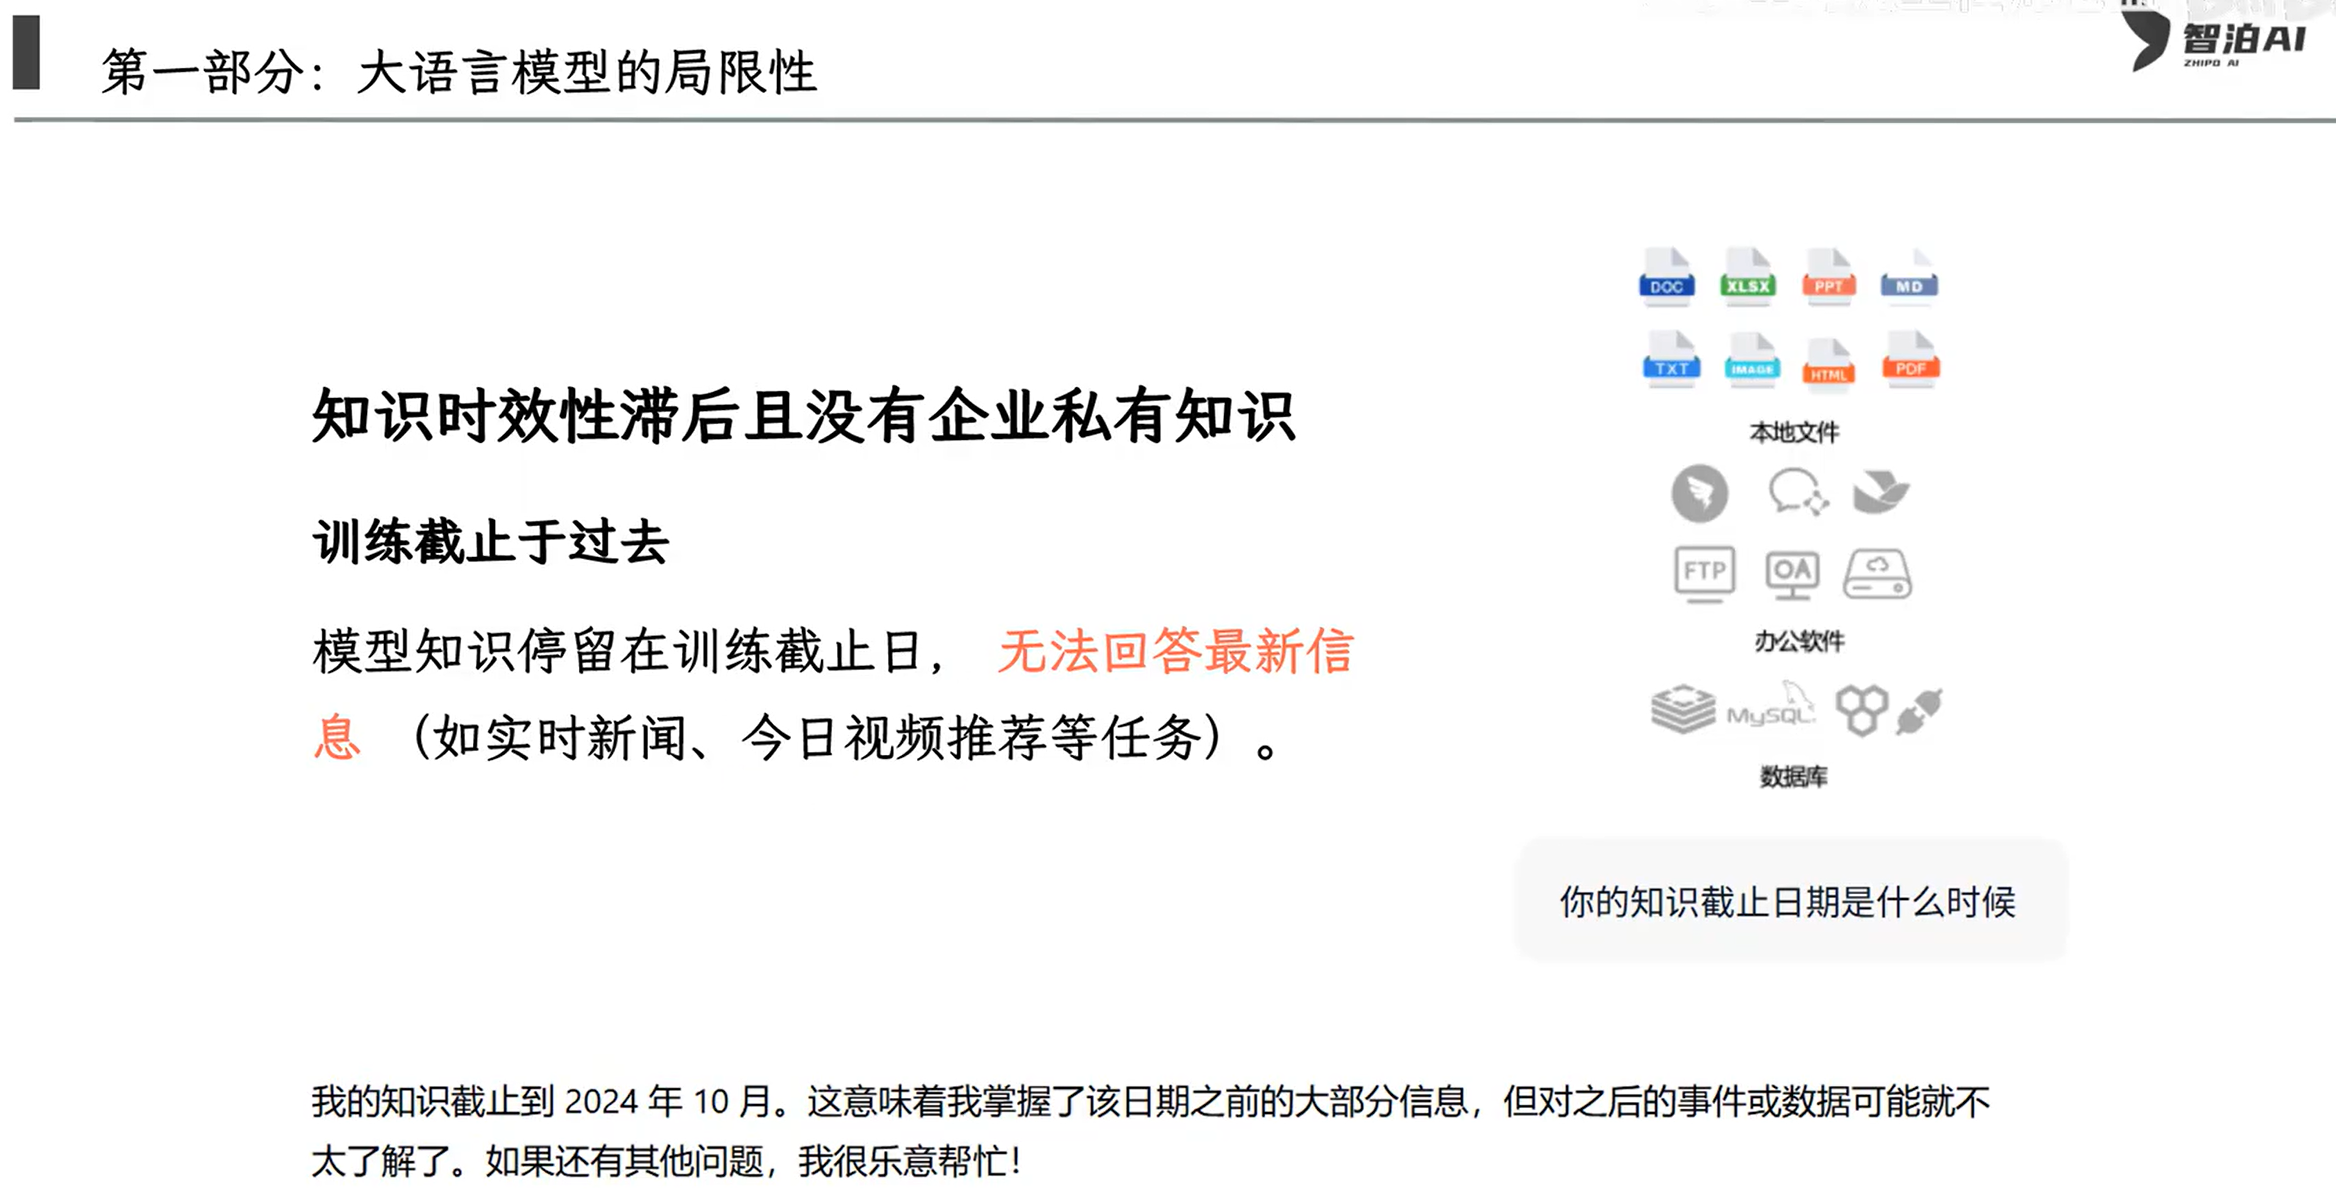
2.无法回答最新信息,回答内容只停留在训练截止日,私有知识也无法回答。每日训练成本高。
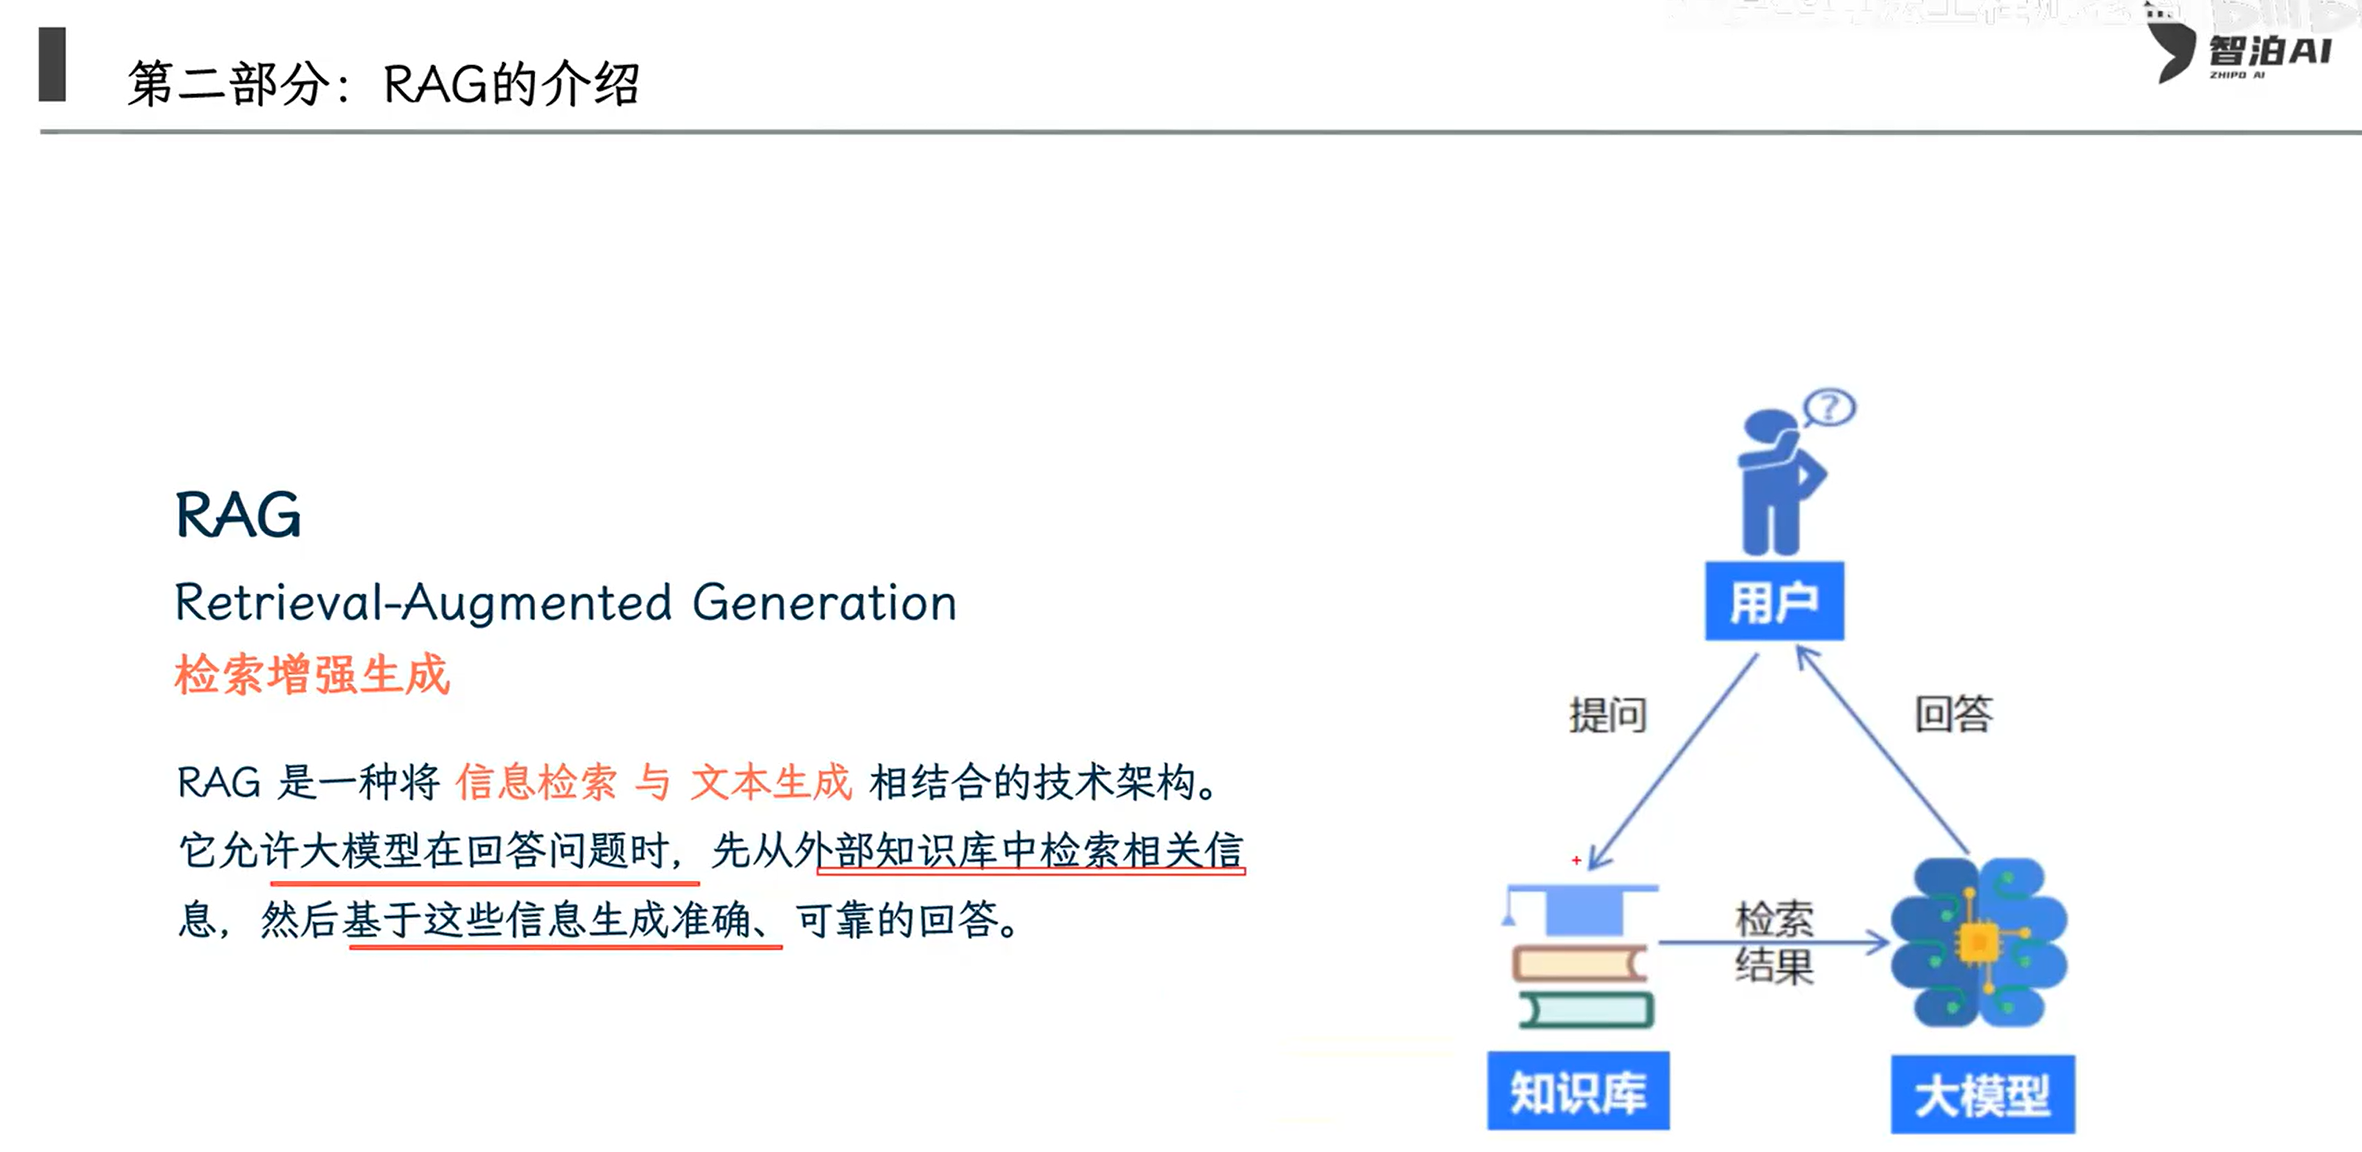
RAG检索增强生成:将信息检索与文本生成相结合的技术架构。允许大模型在回答问题时,先从外部知识库中检索相关信息,然后基于这些信息生成准确、可靠的回答。
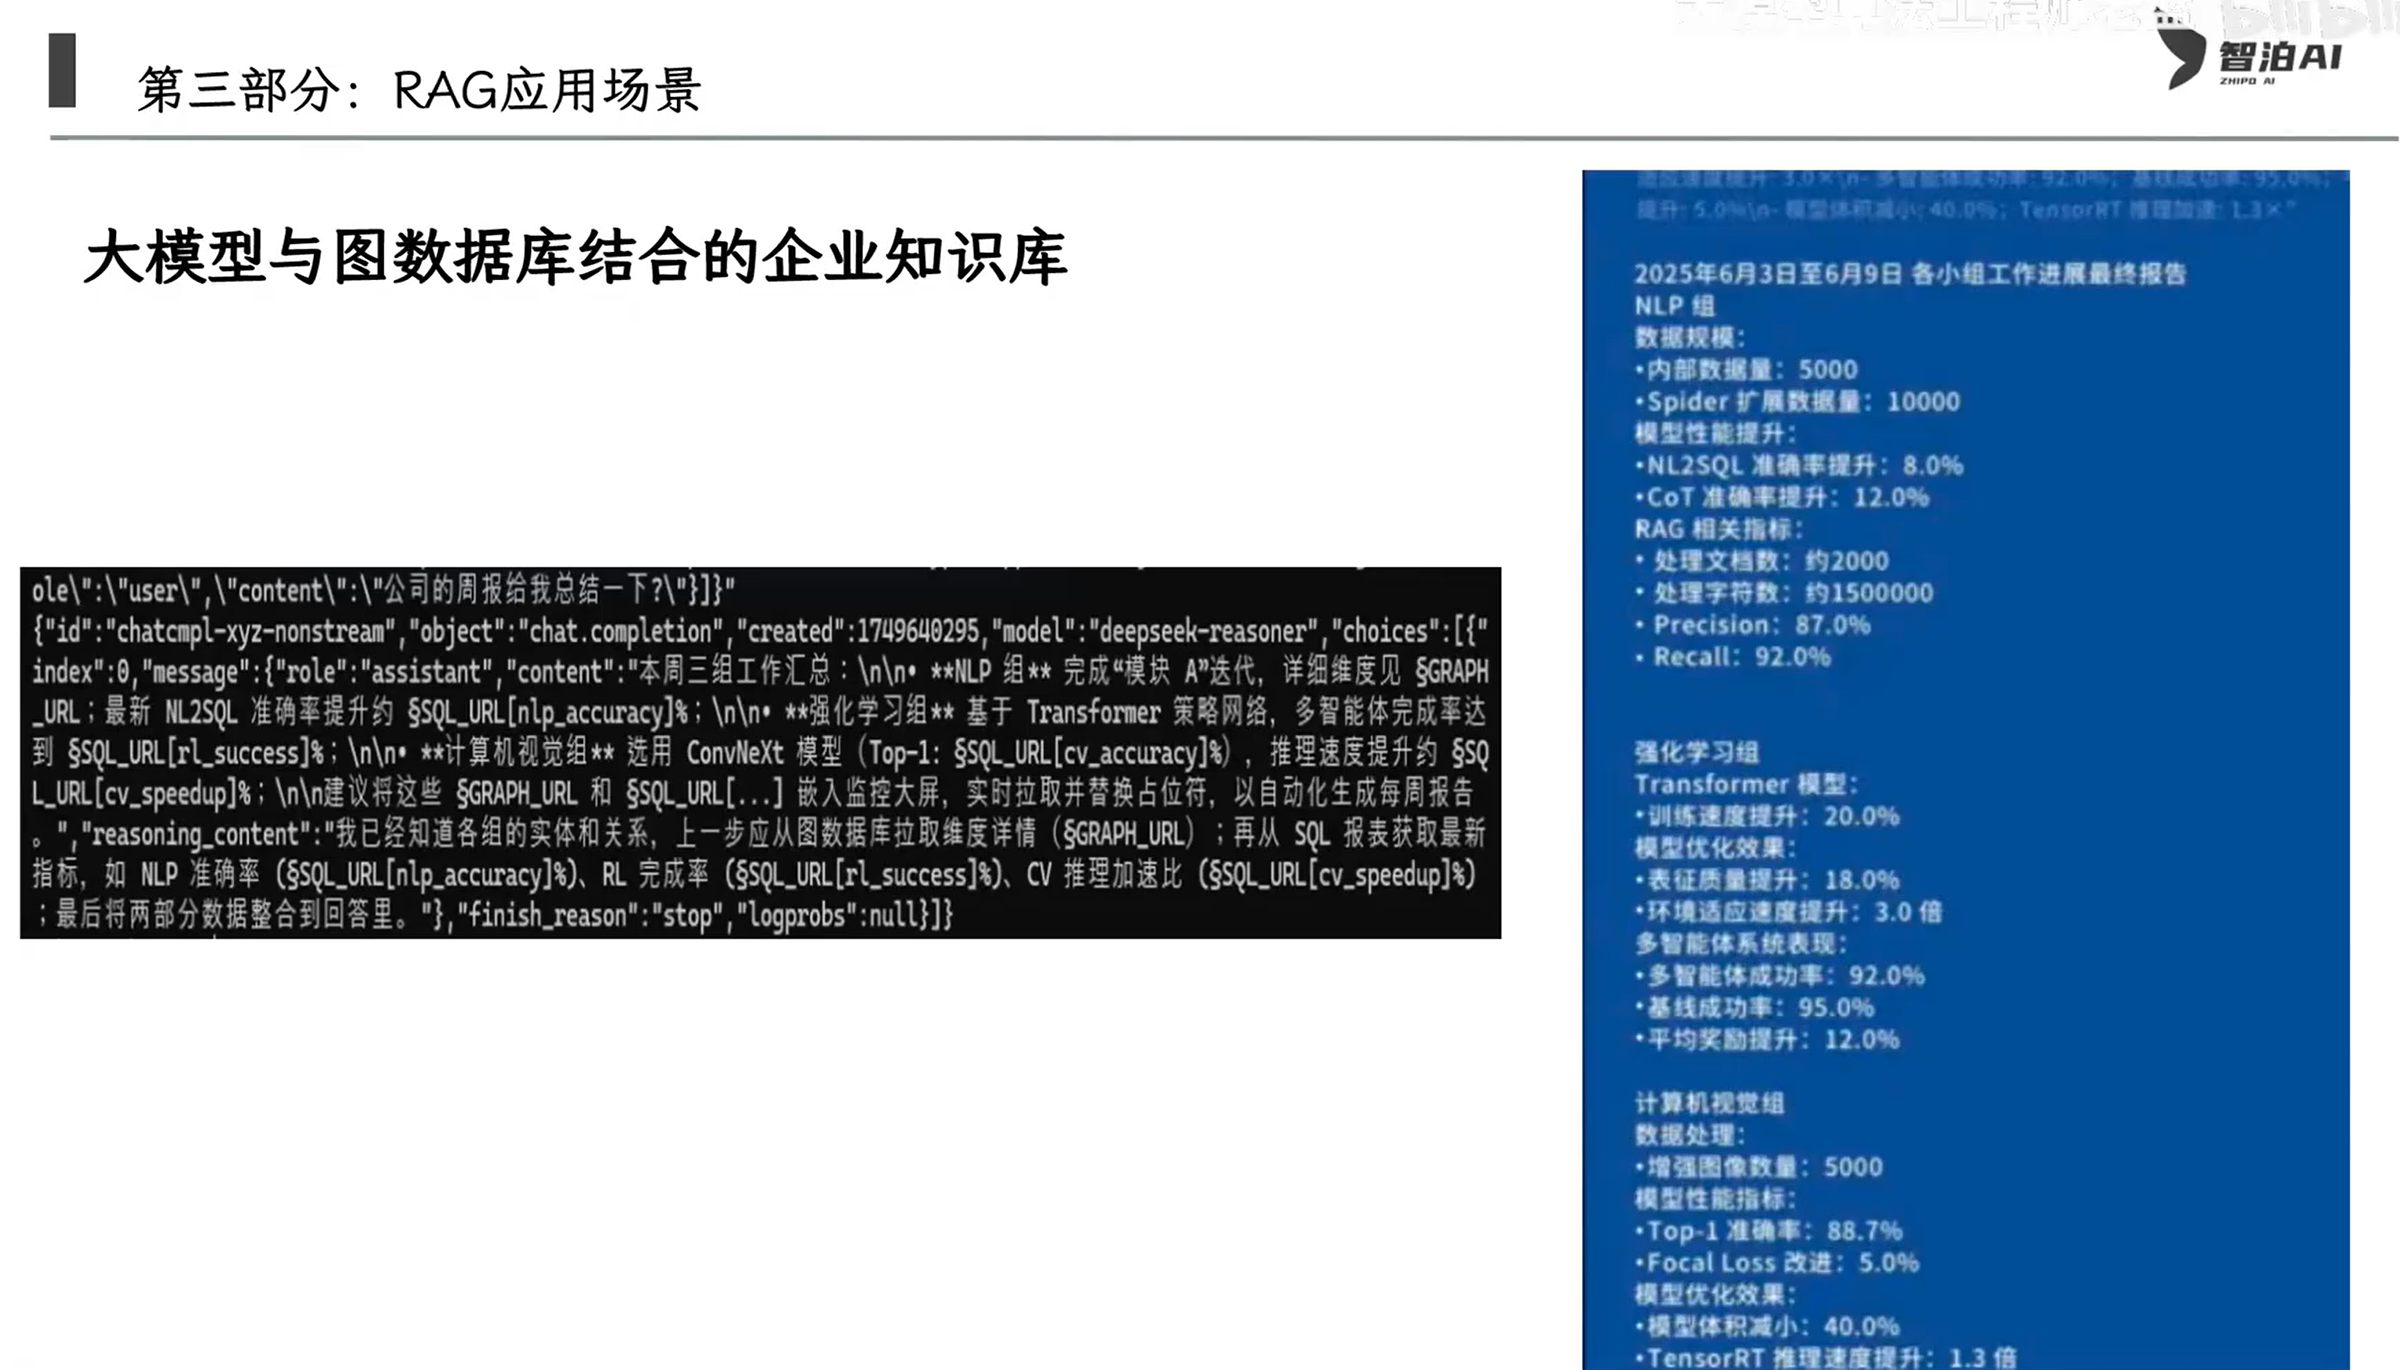
案例一:大模型与企业知识库的应用
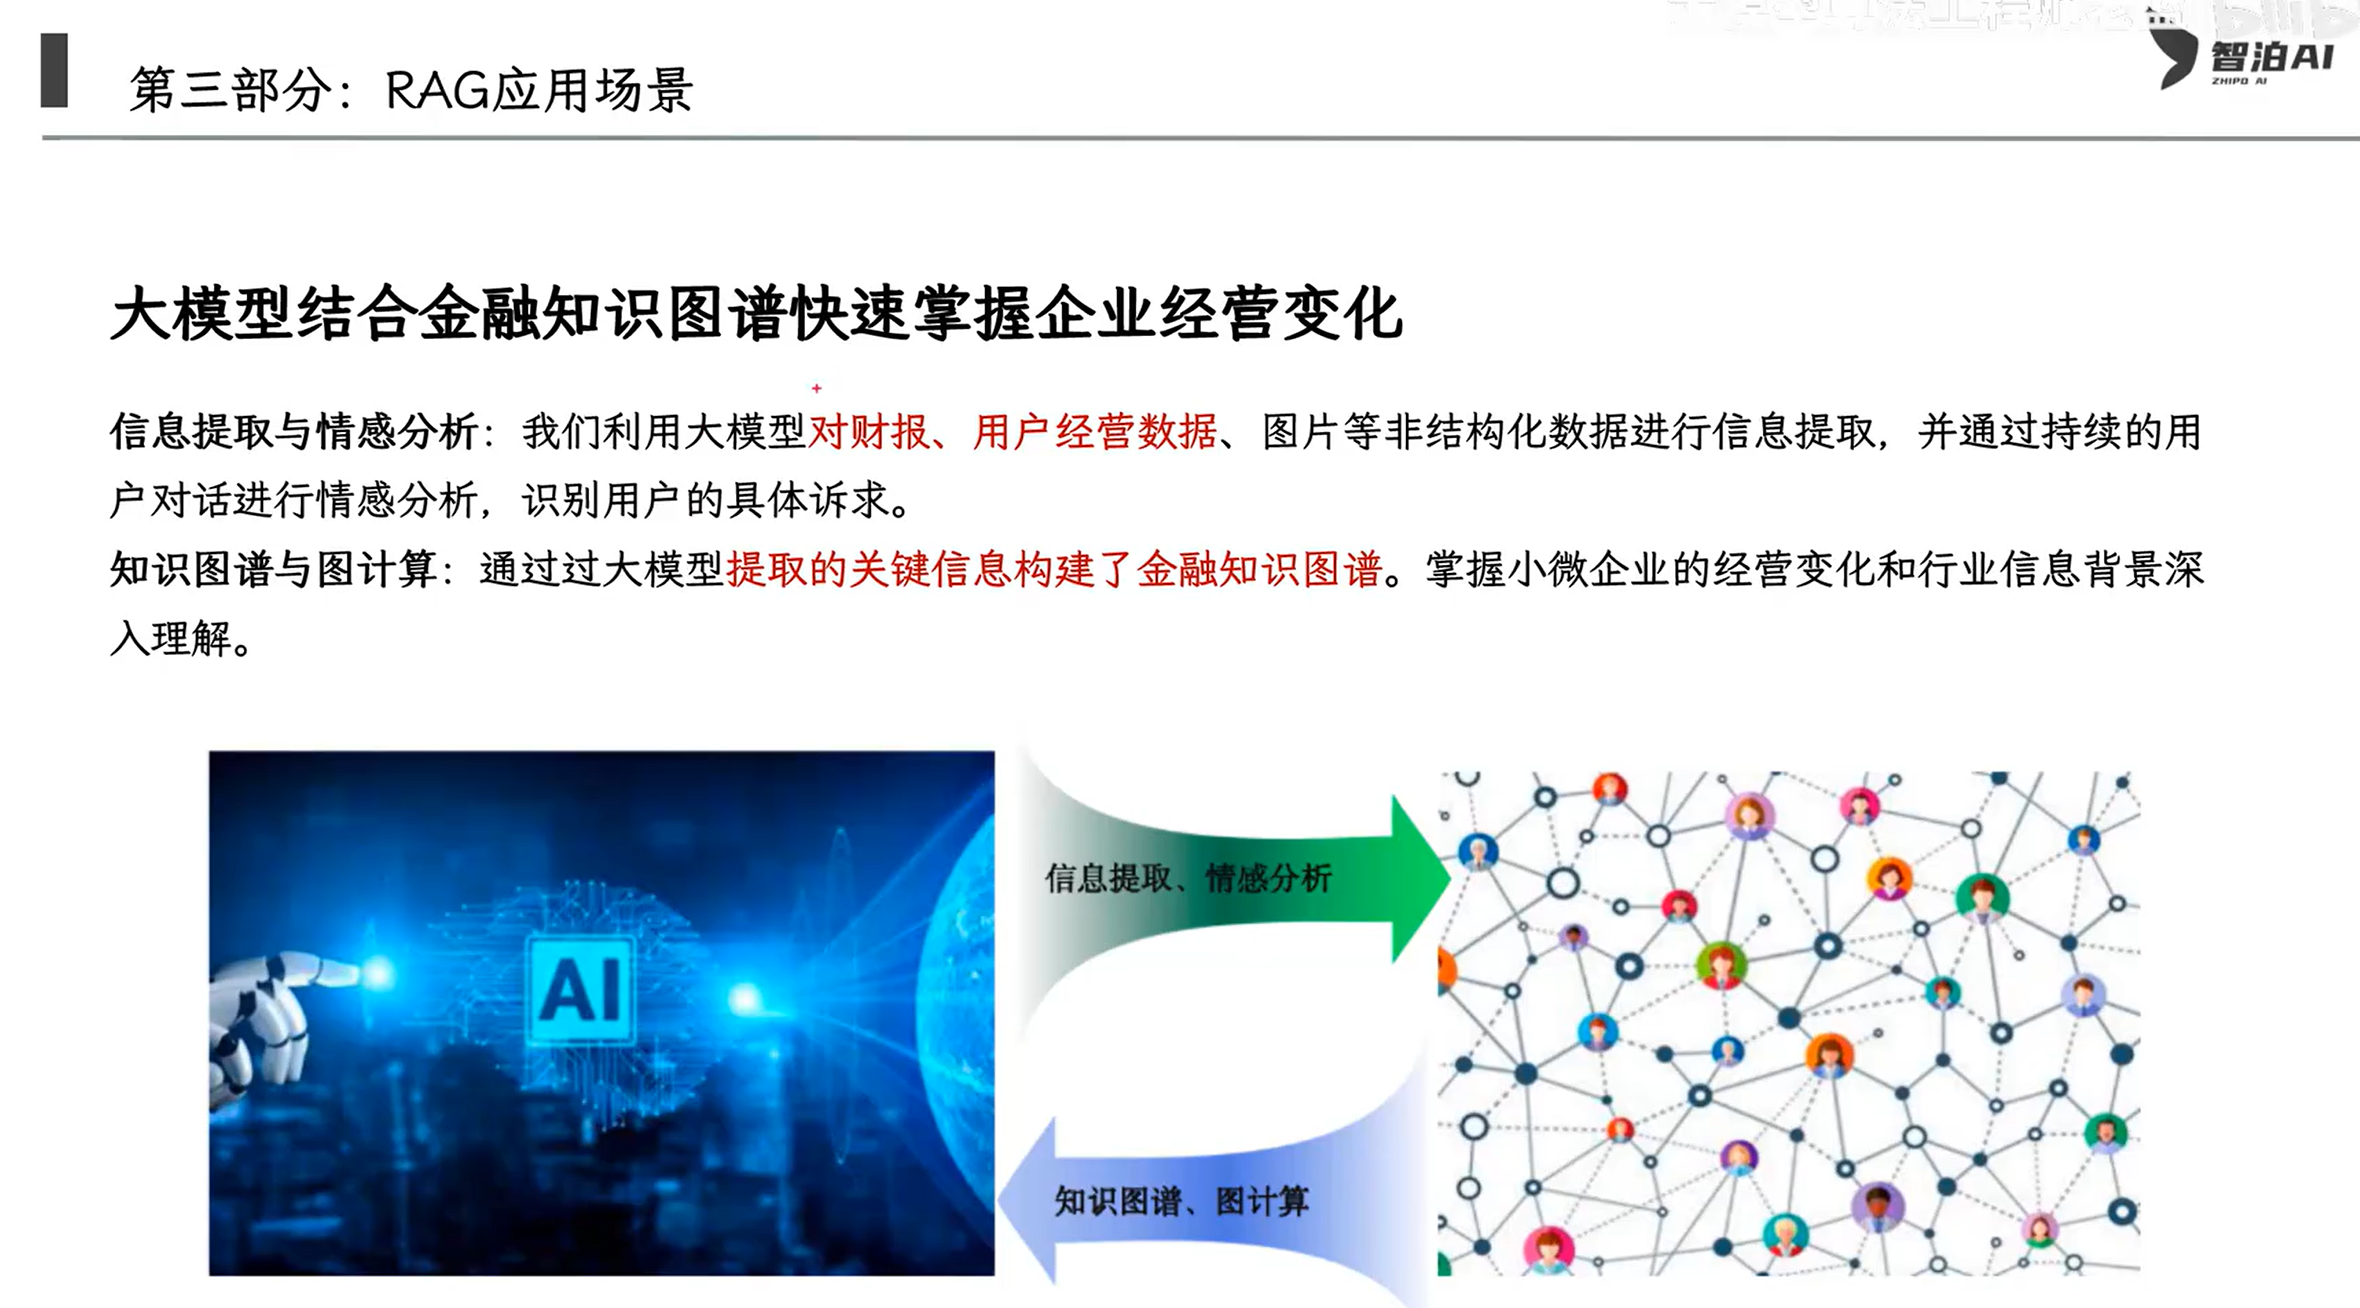
案例二:大模型与金融
Graph RAG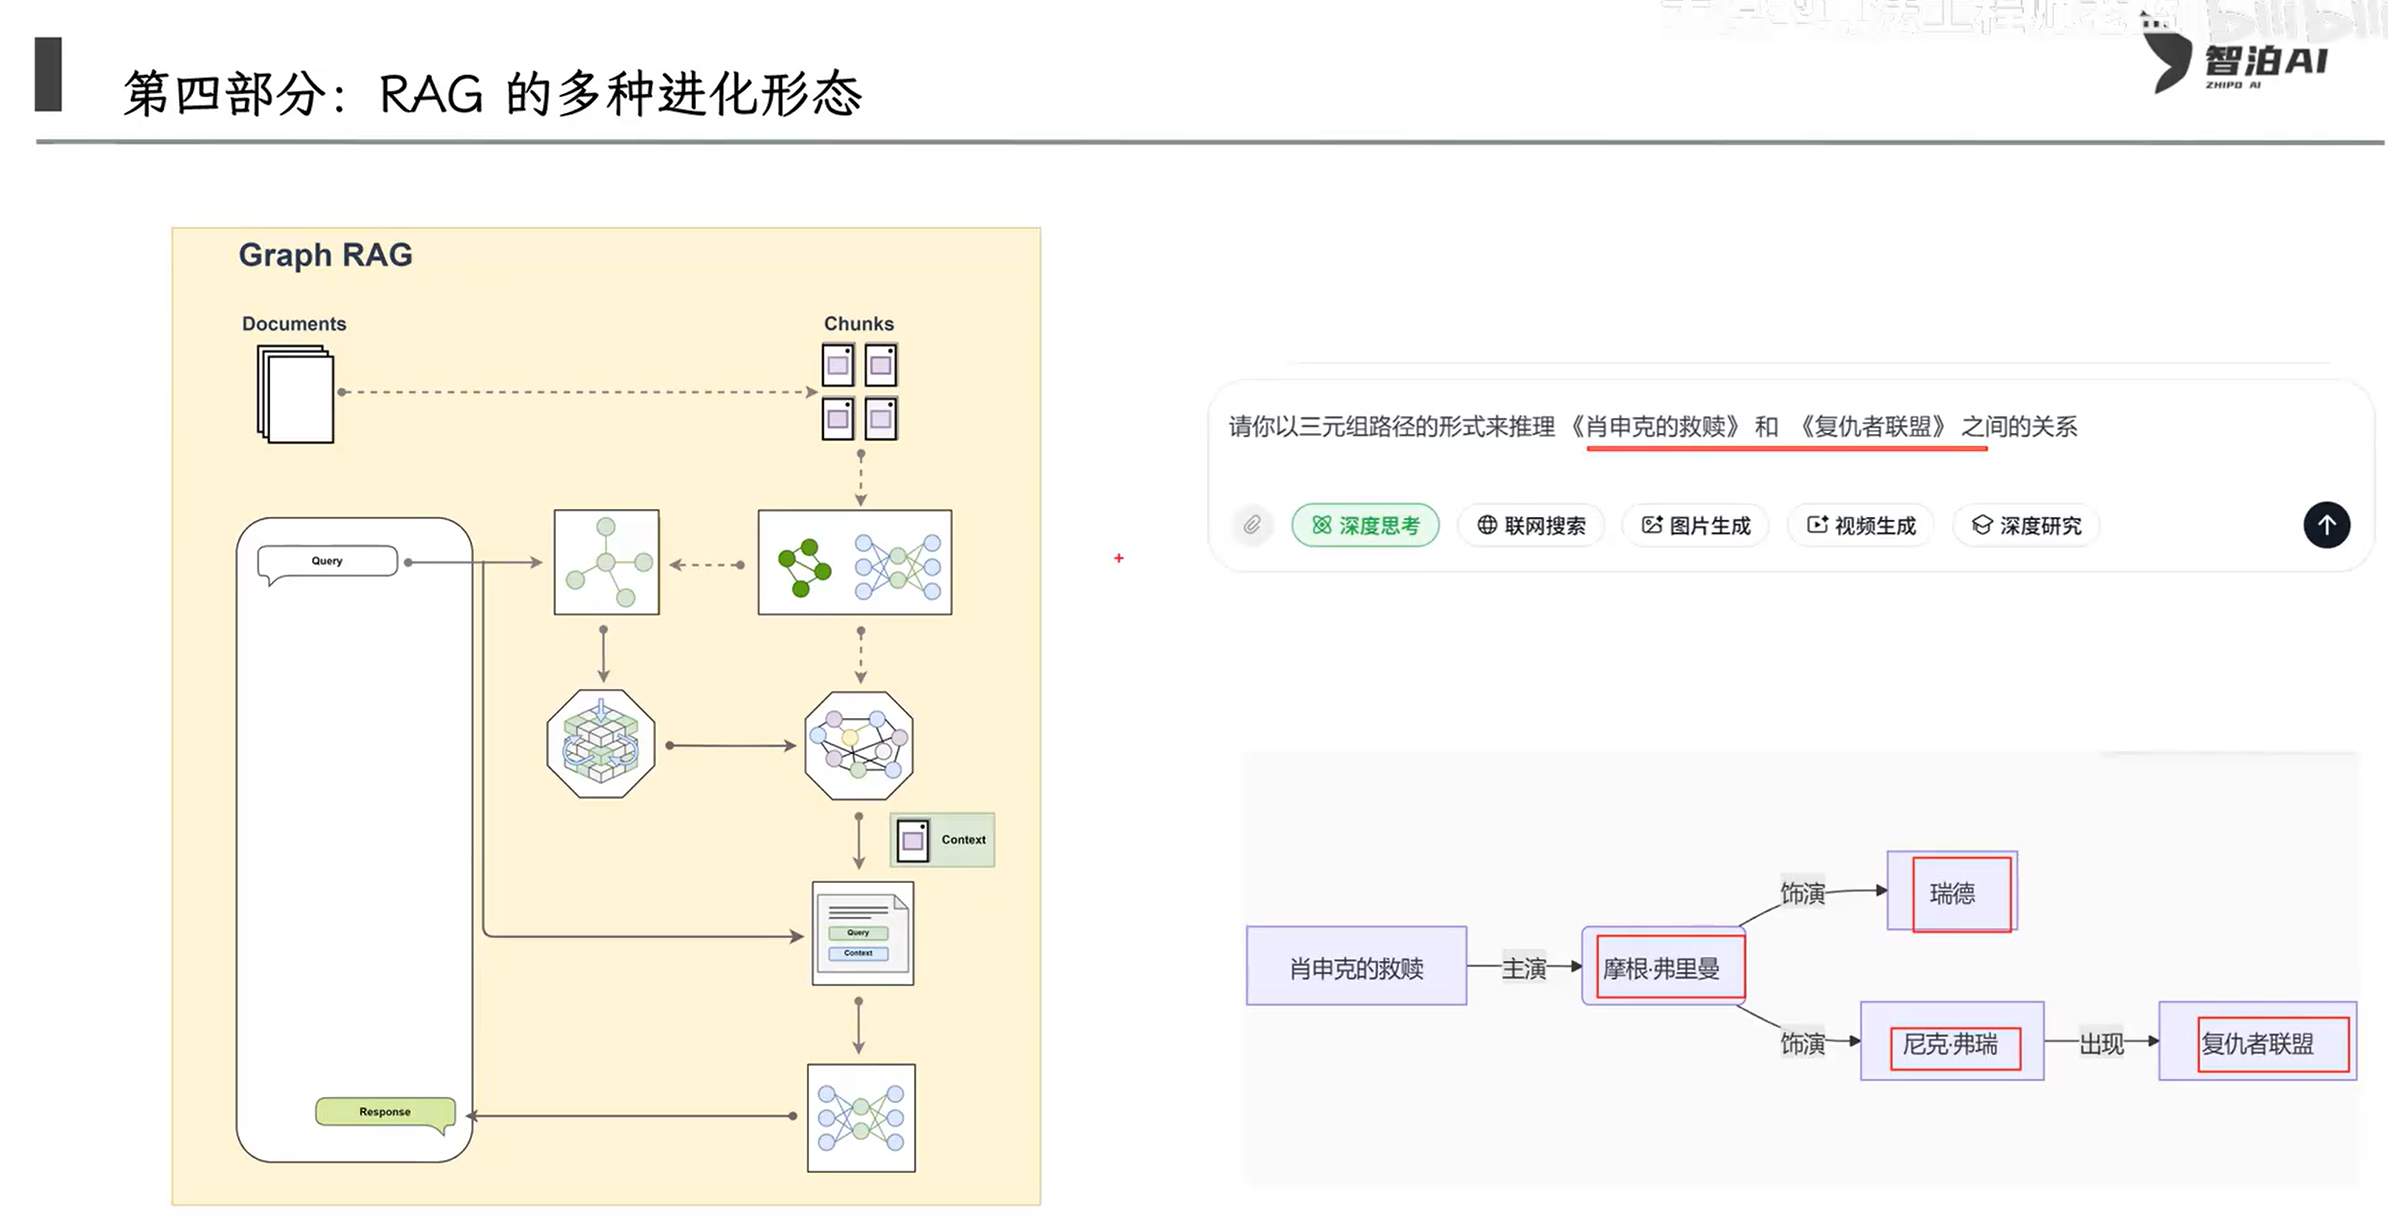
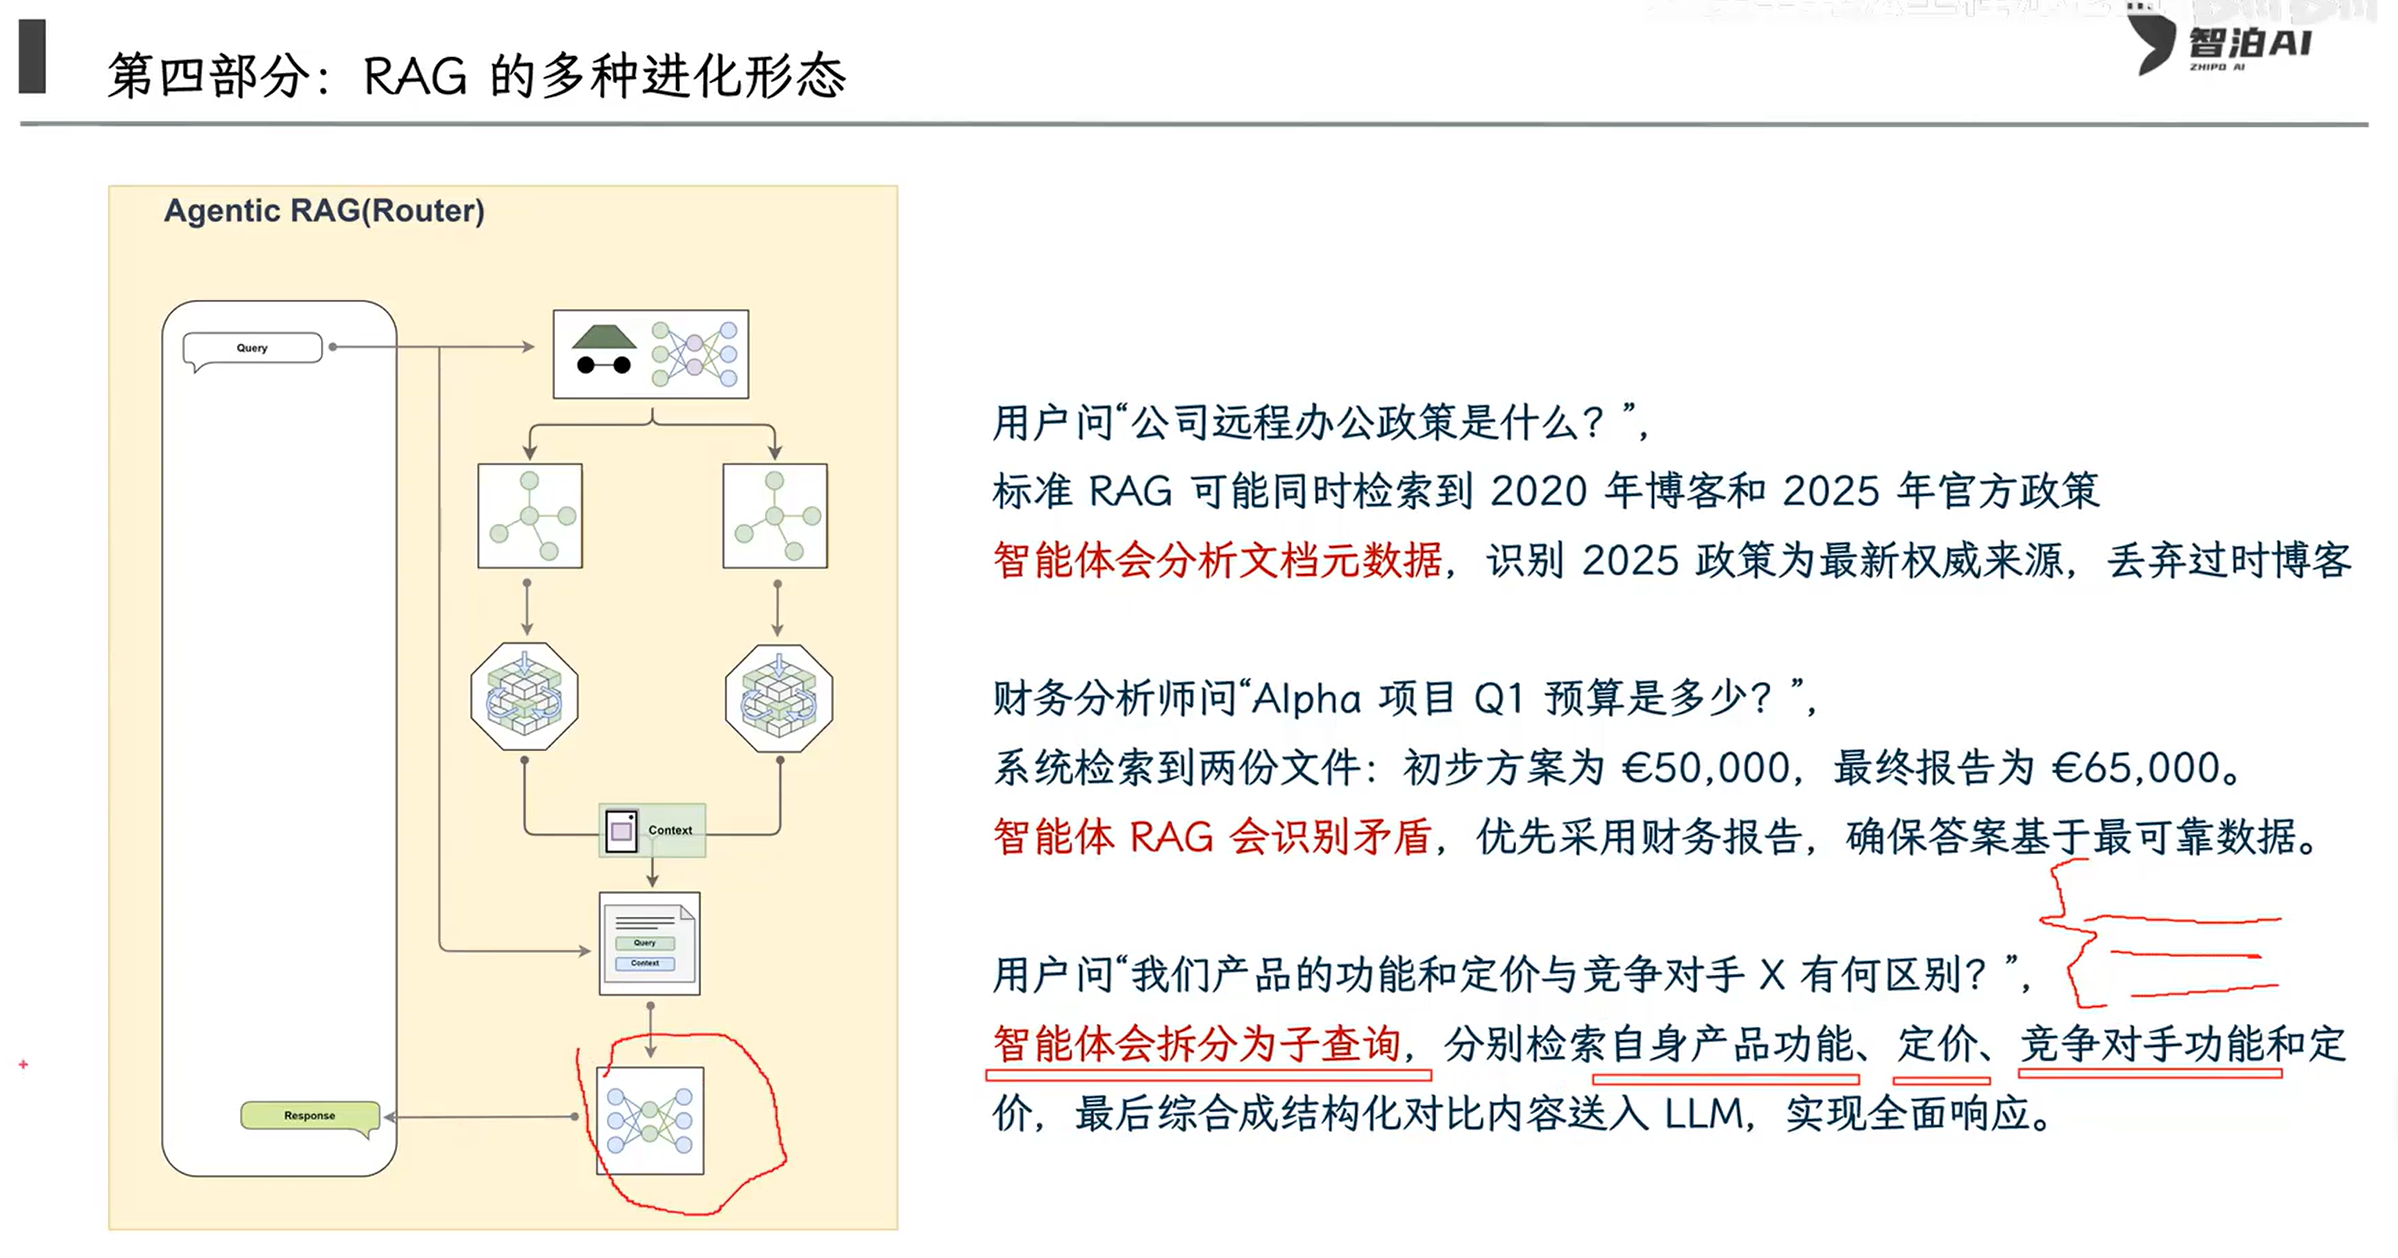
Agentic RAG(智能体RAG)
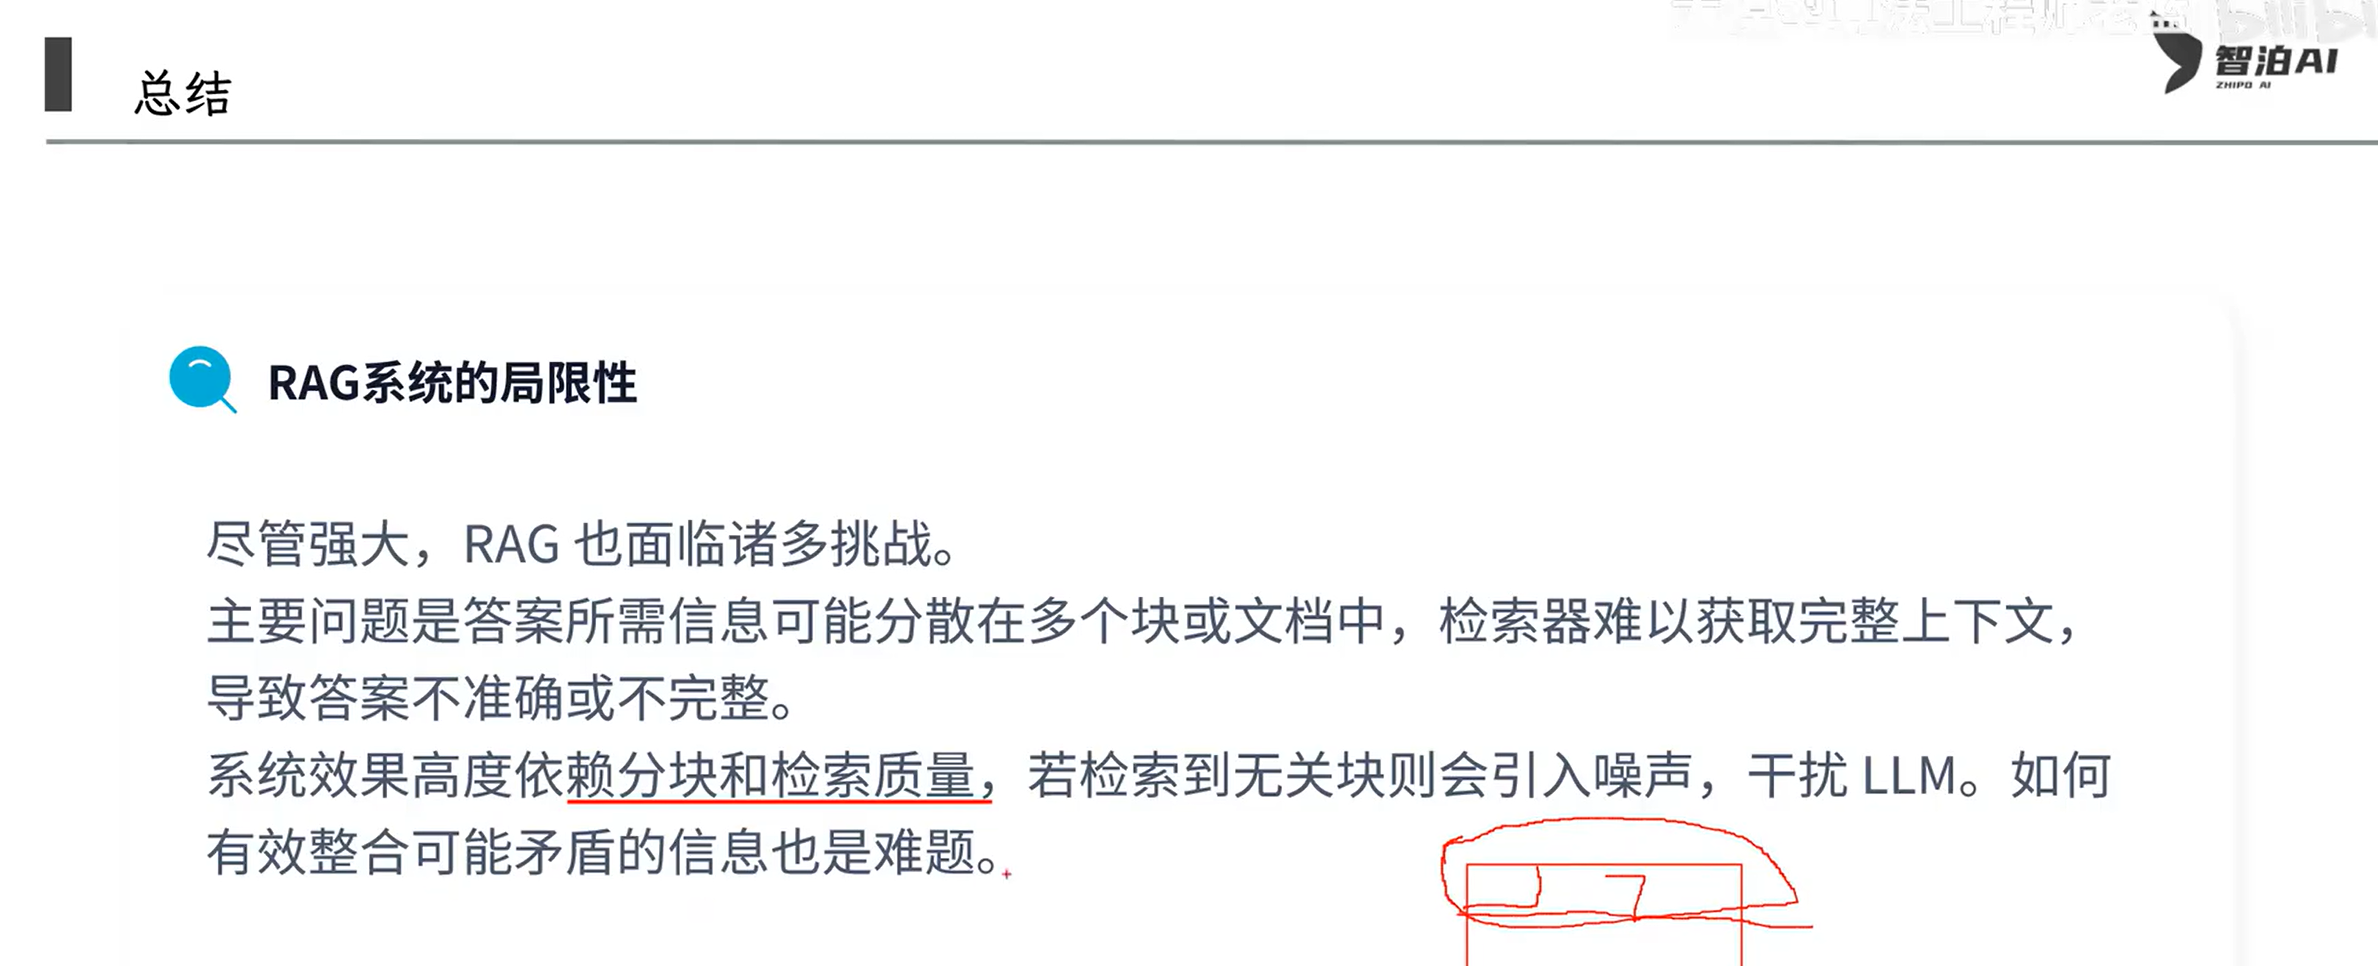
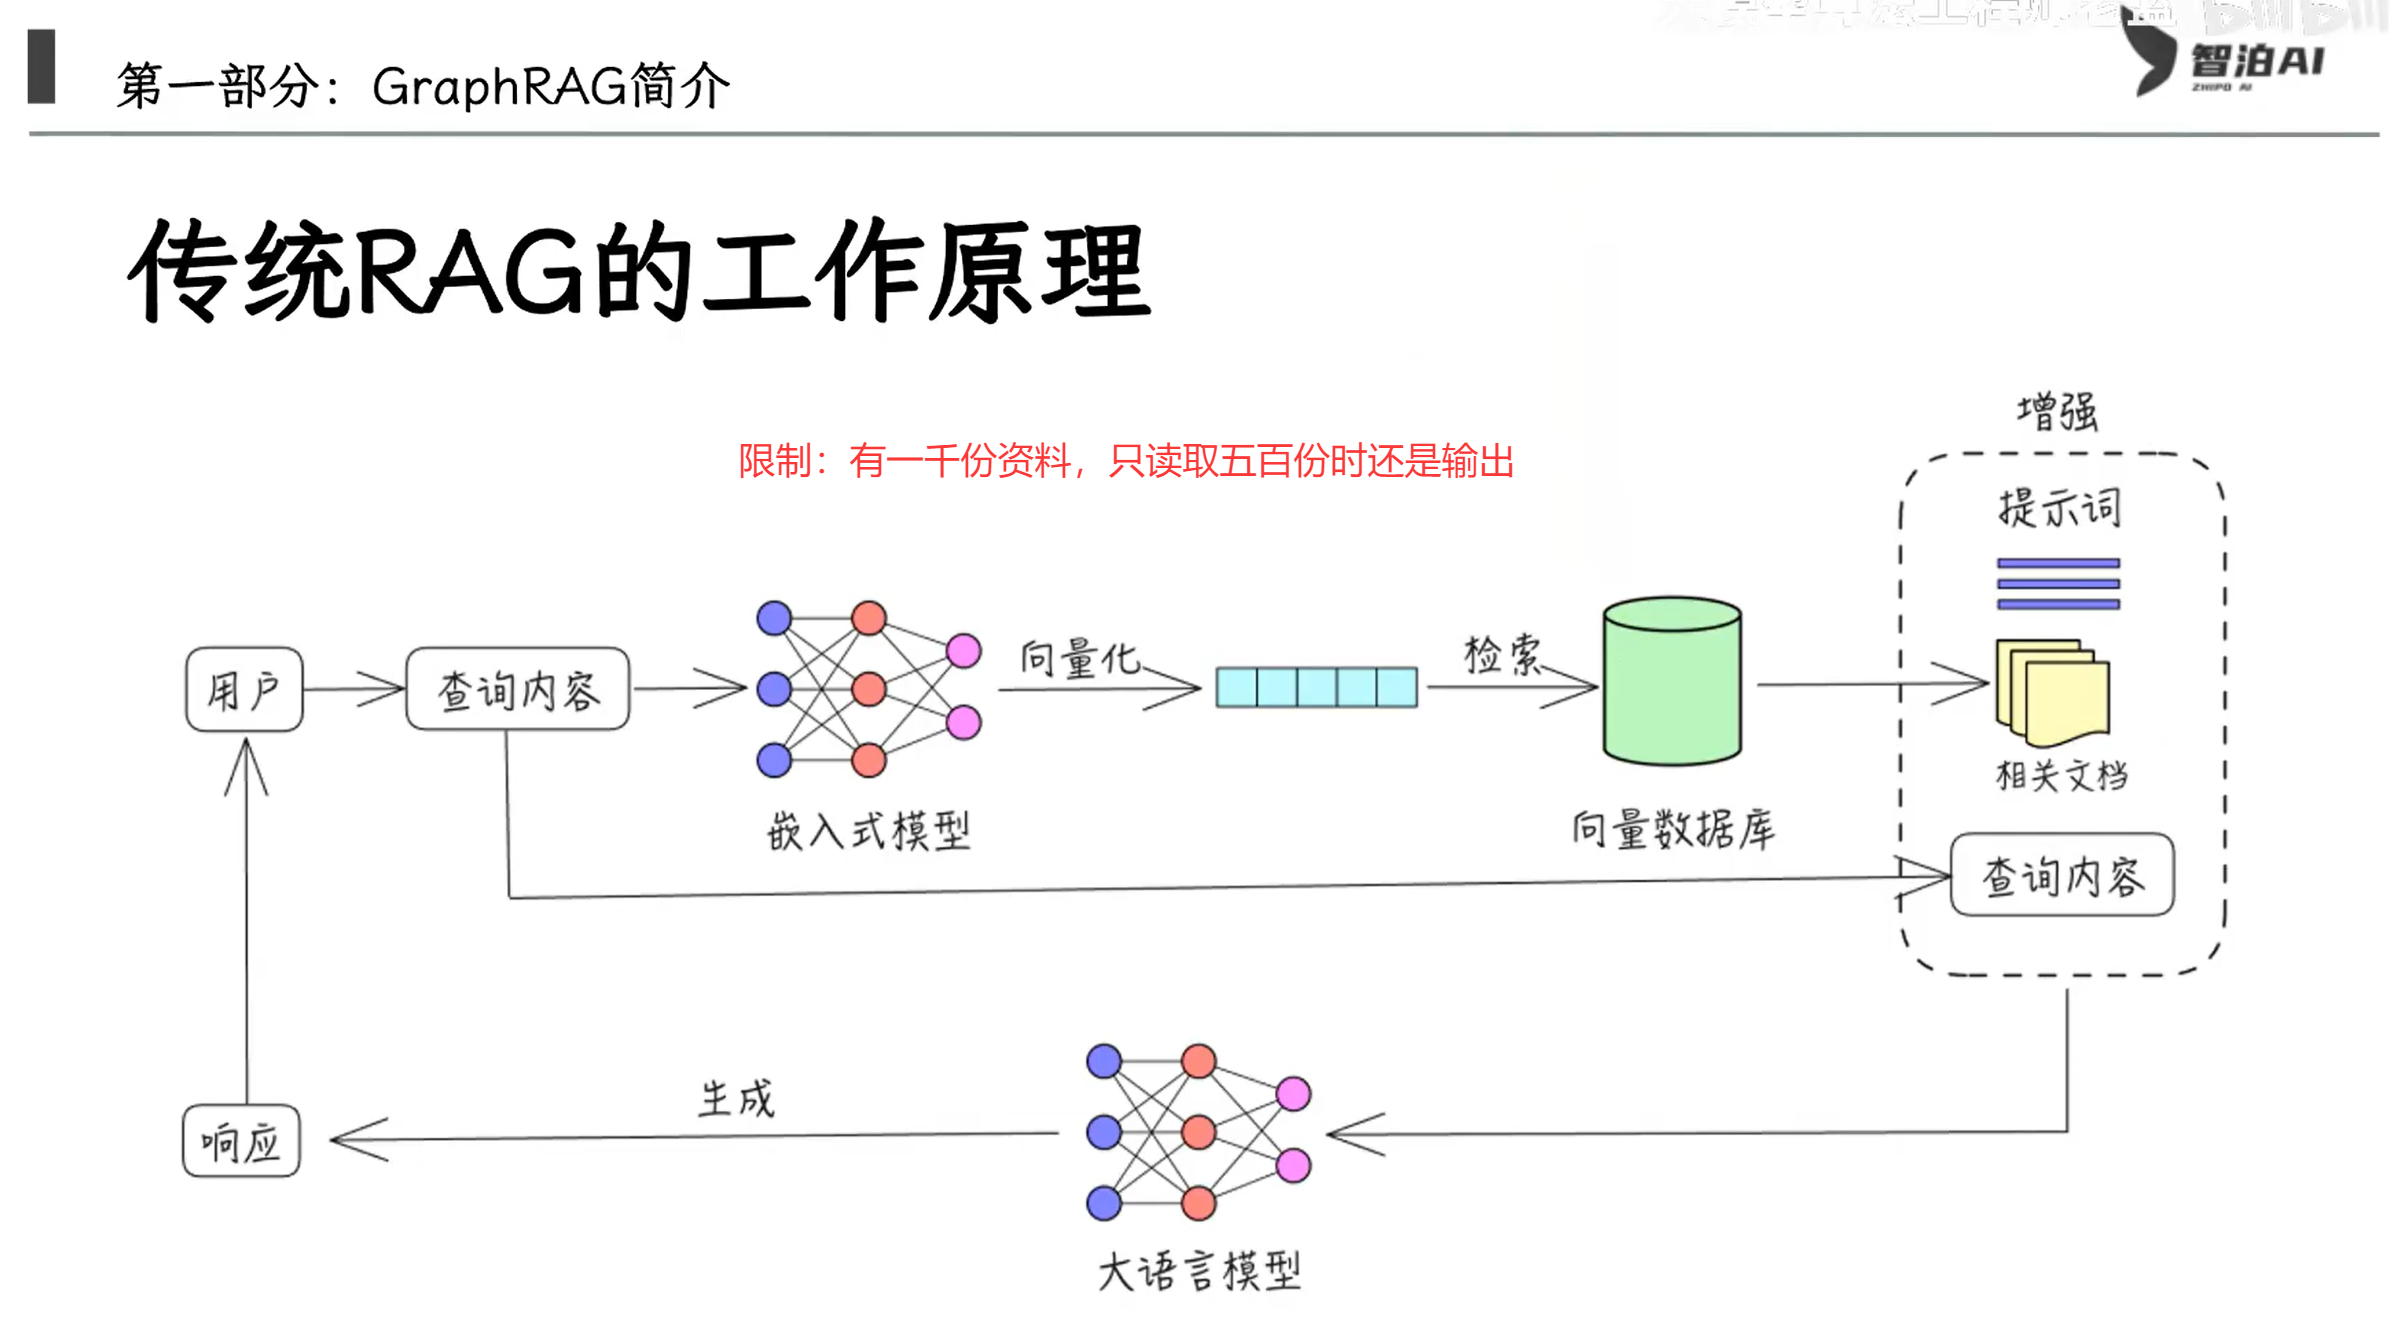
RAG技术的局限性:高度依赖分块和检索质量,如果检索的数据不好,会影响回答的准确性。
二、RAG索引的构建
2.1 RAG定义与用途
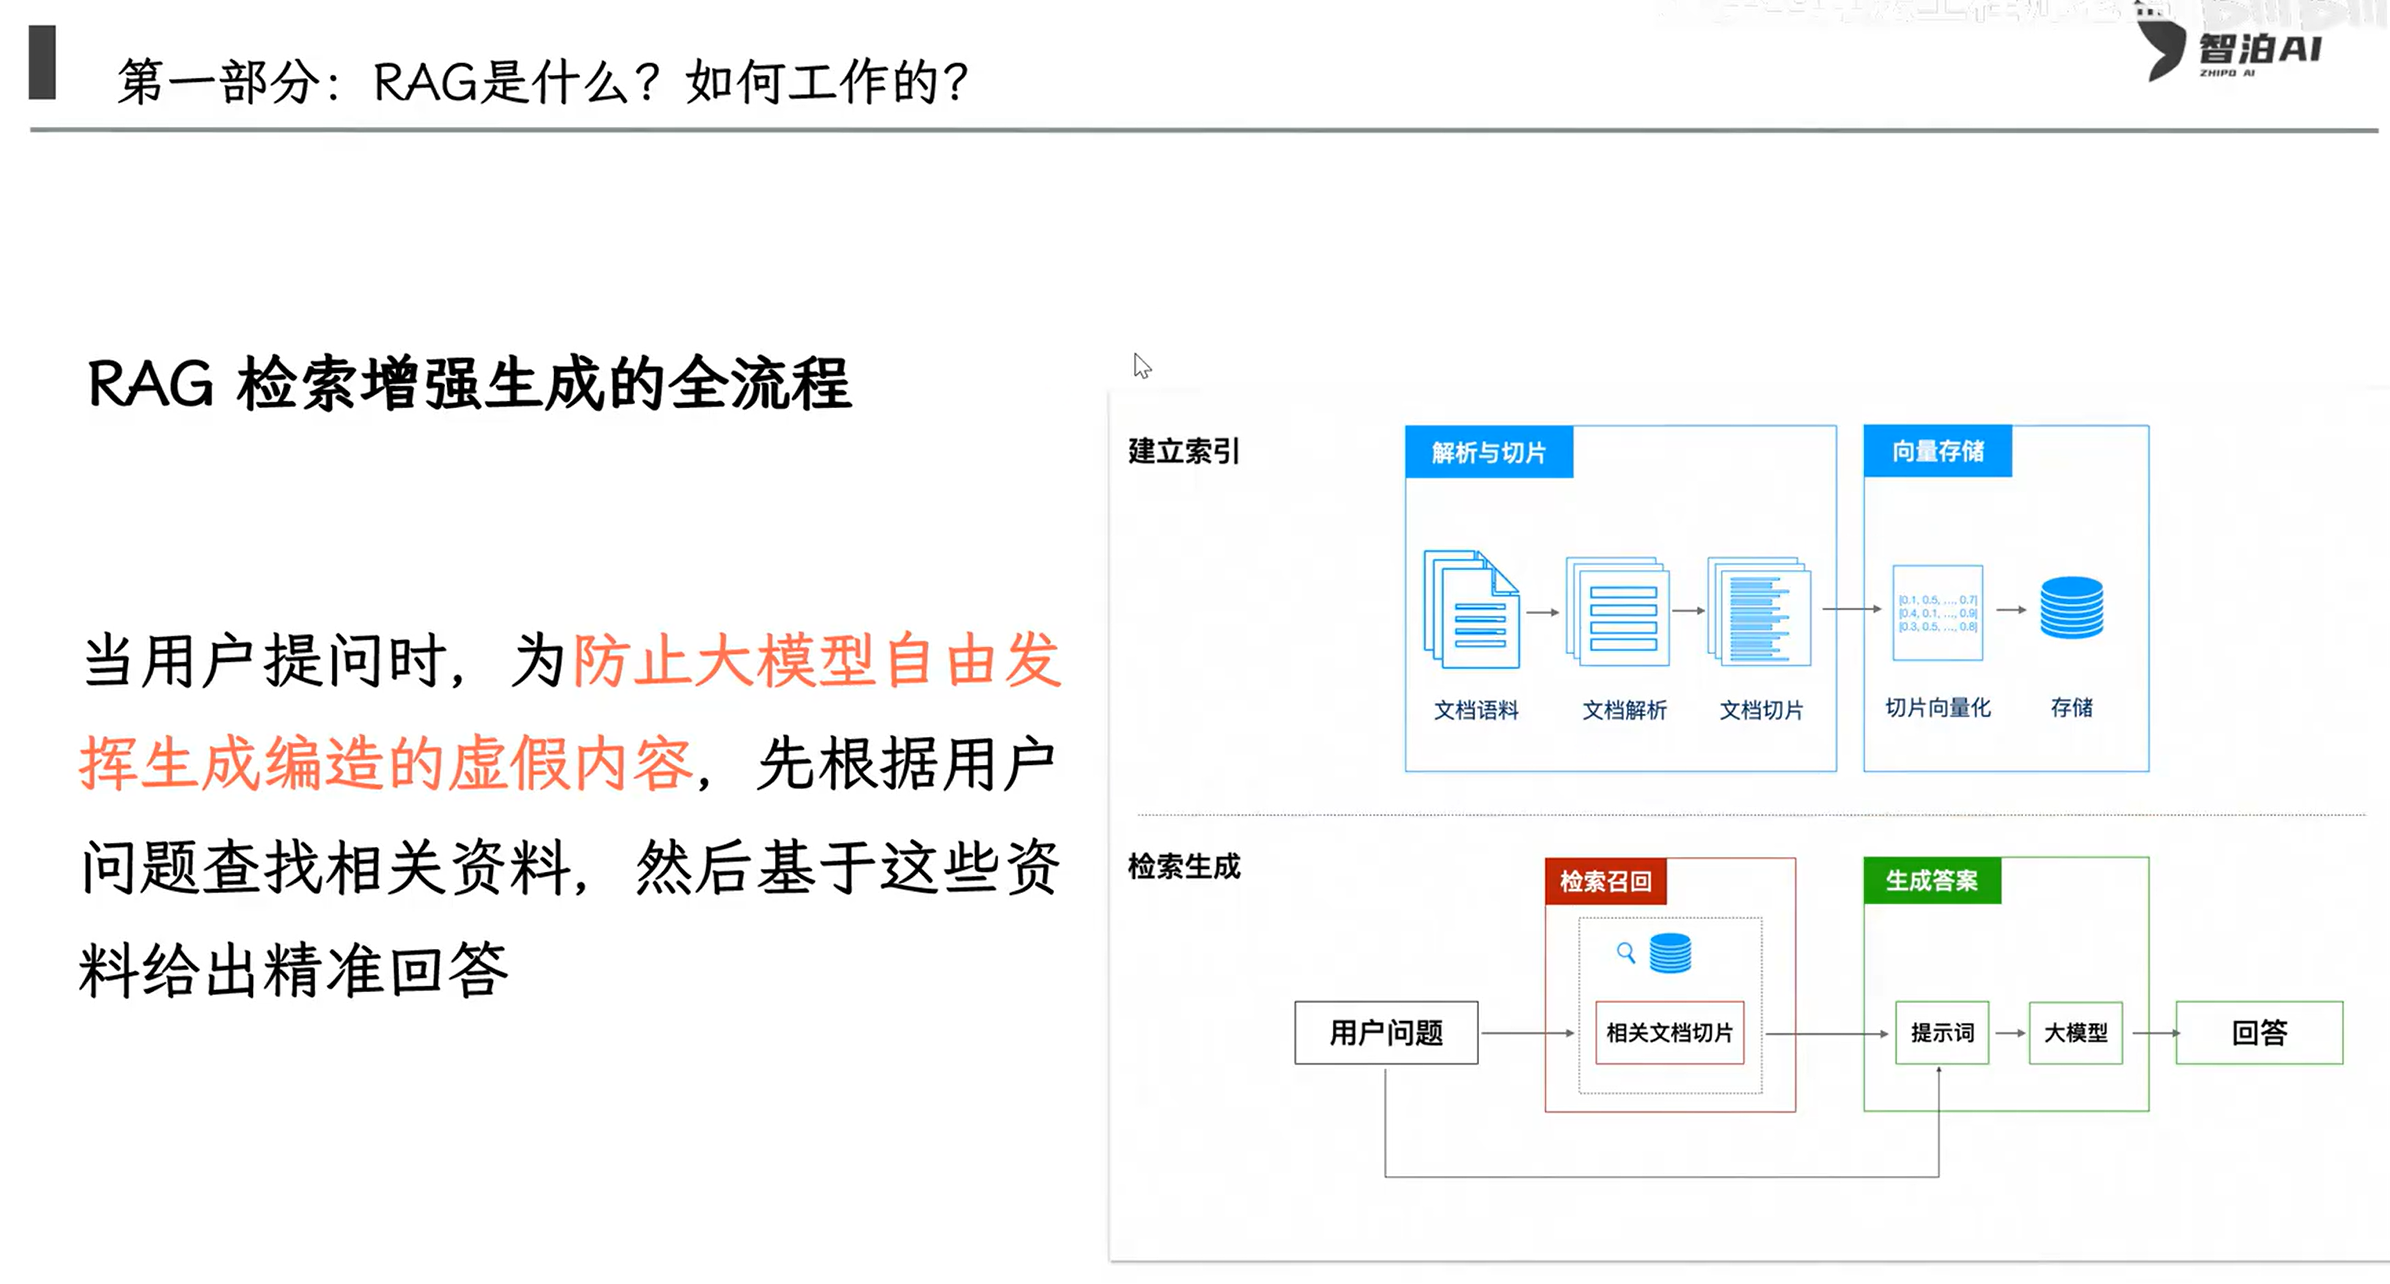
2.2 RAG中索引的原理
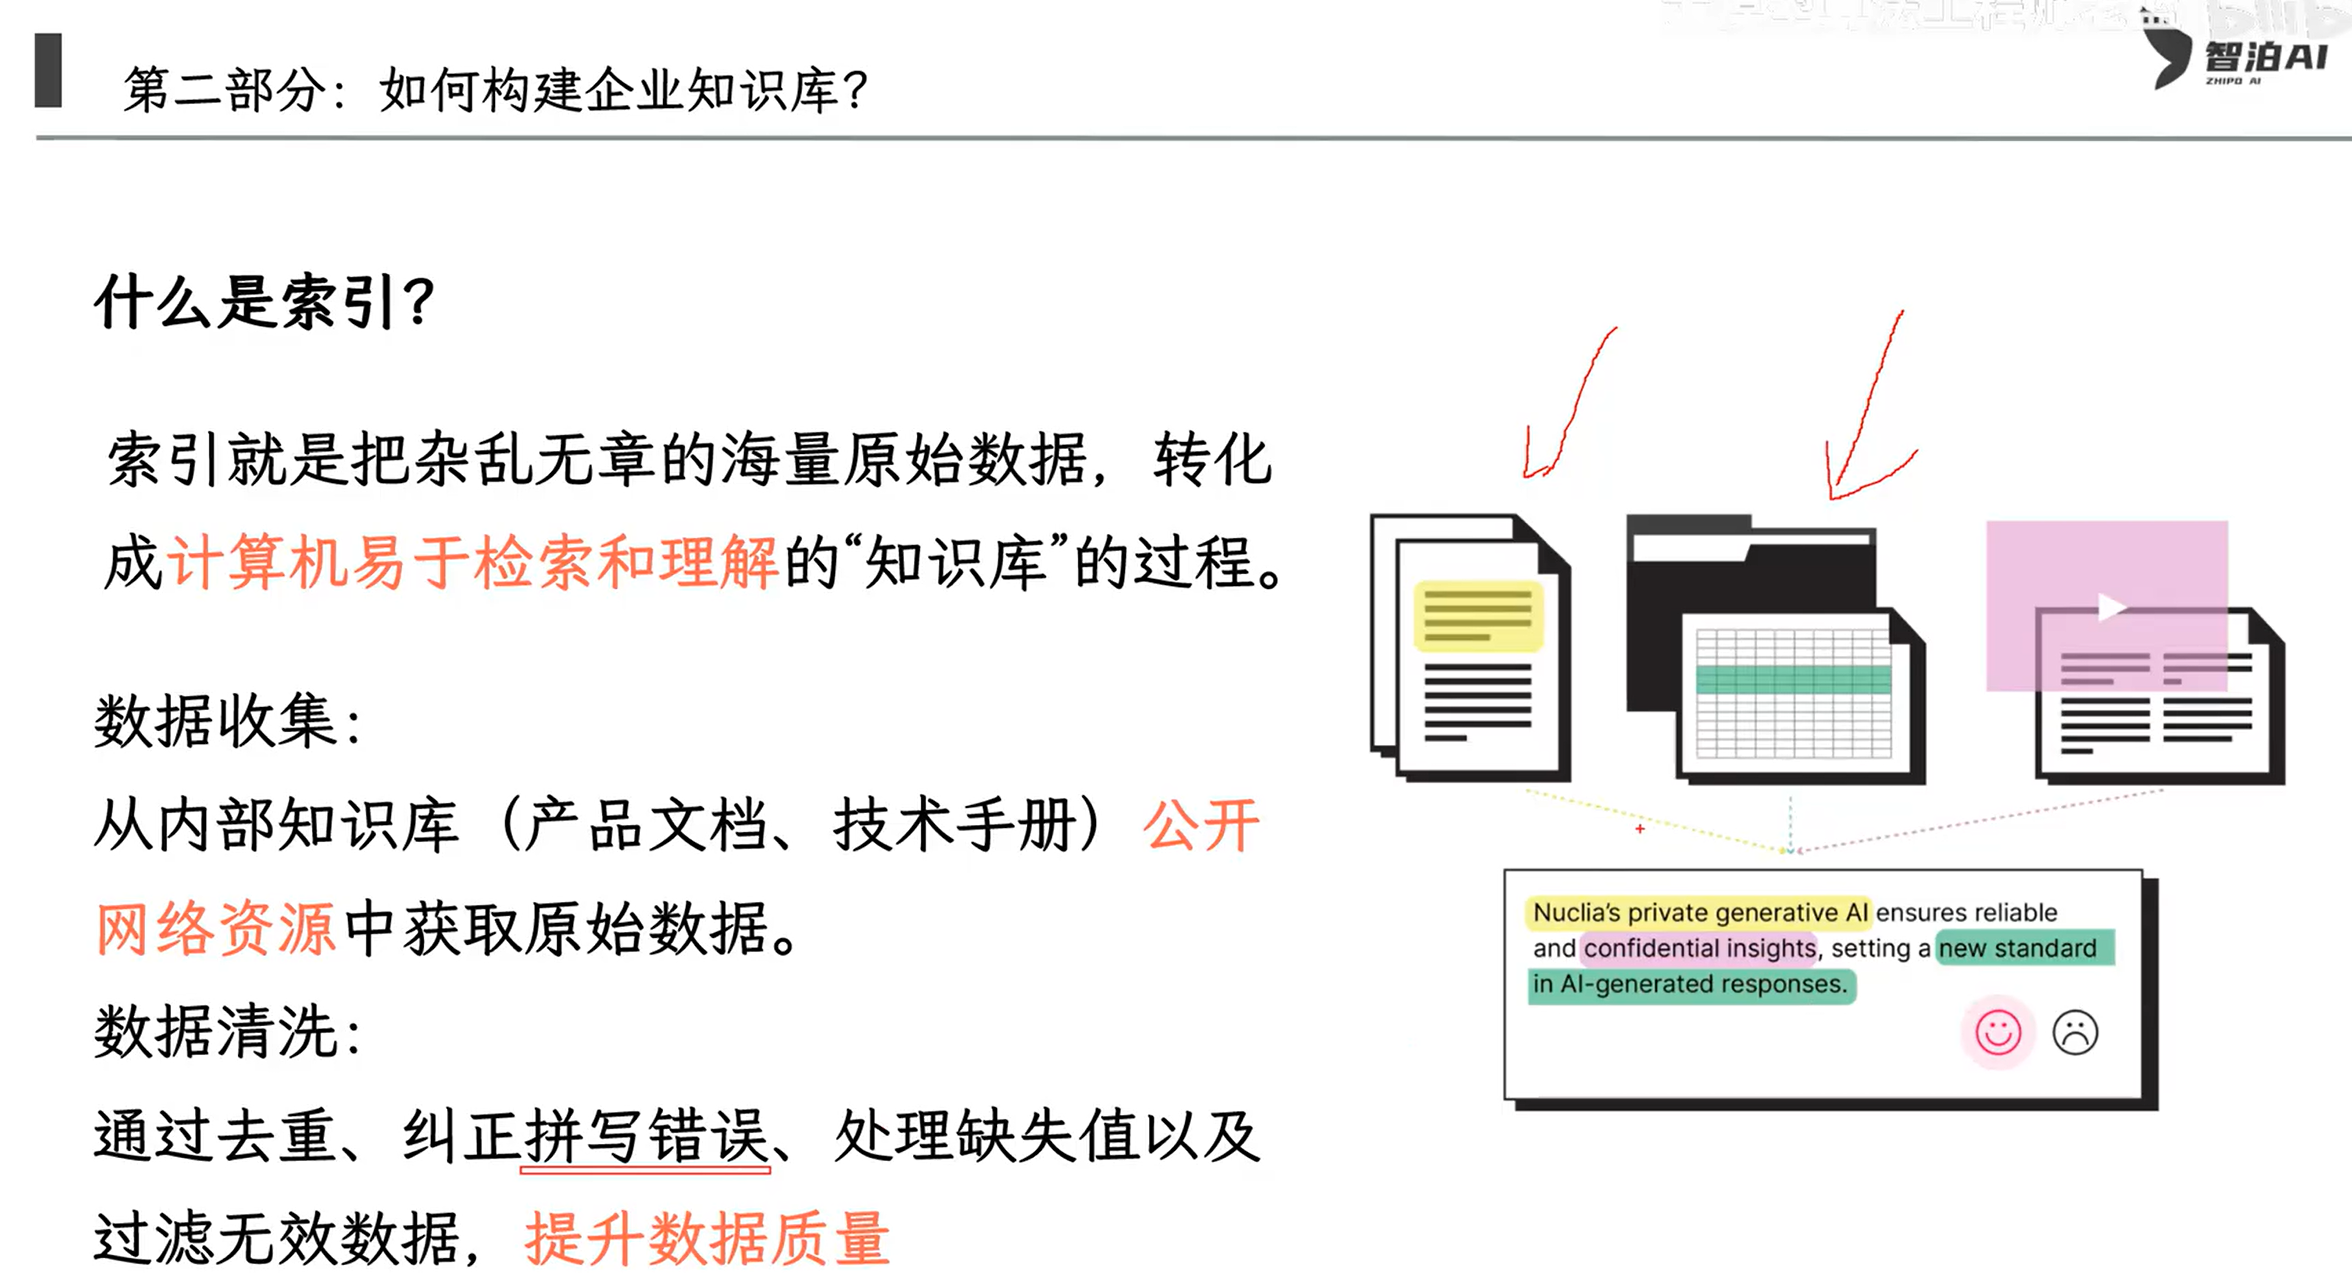
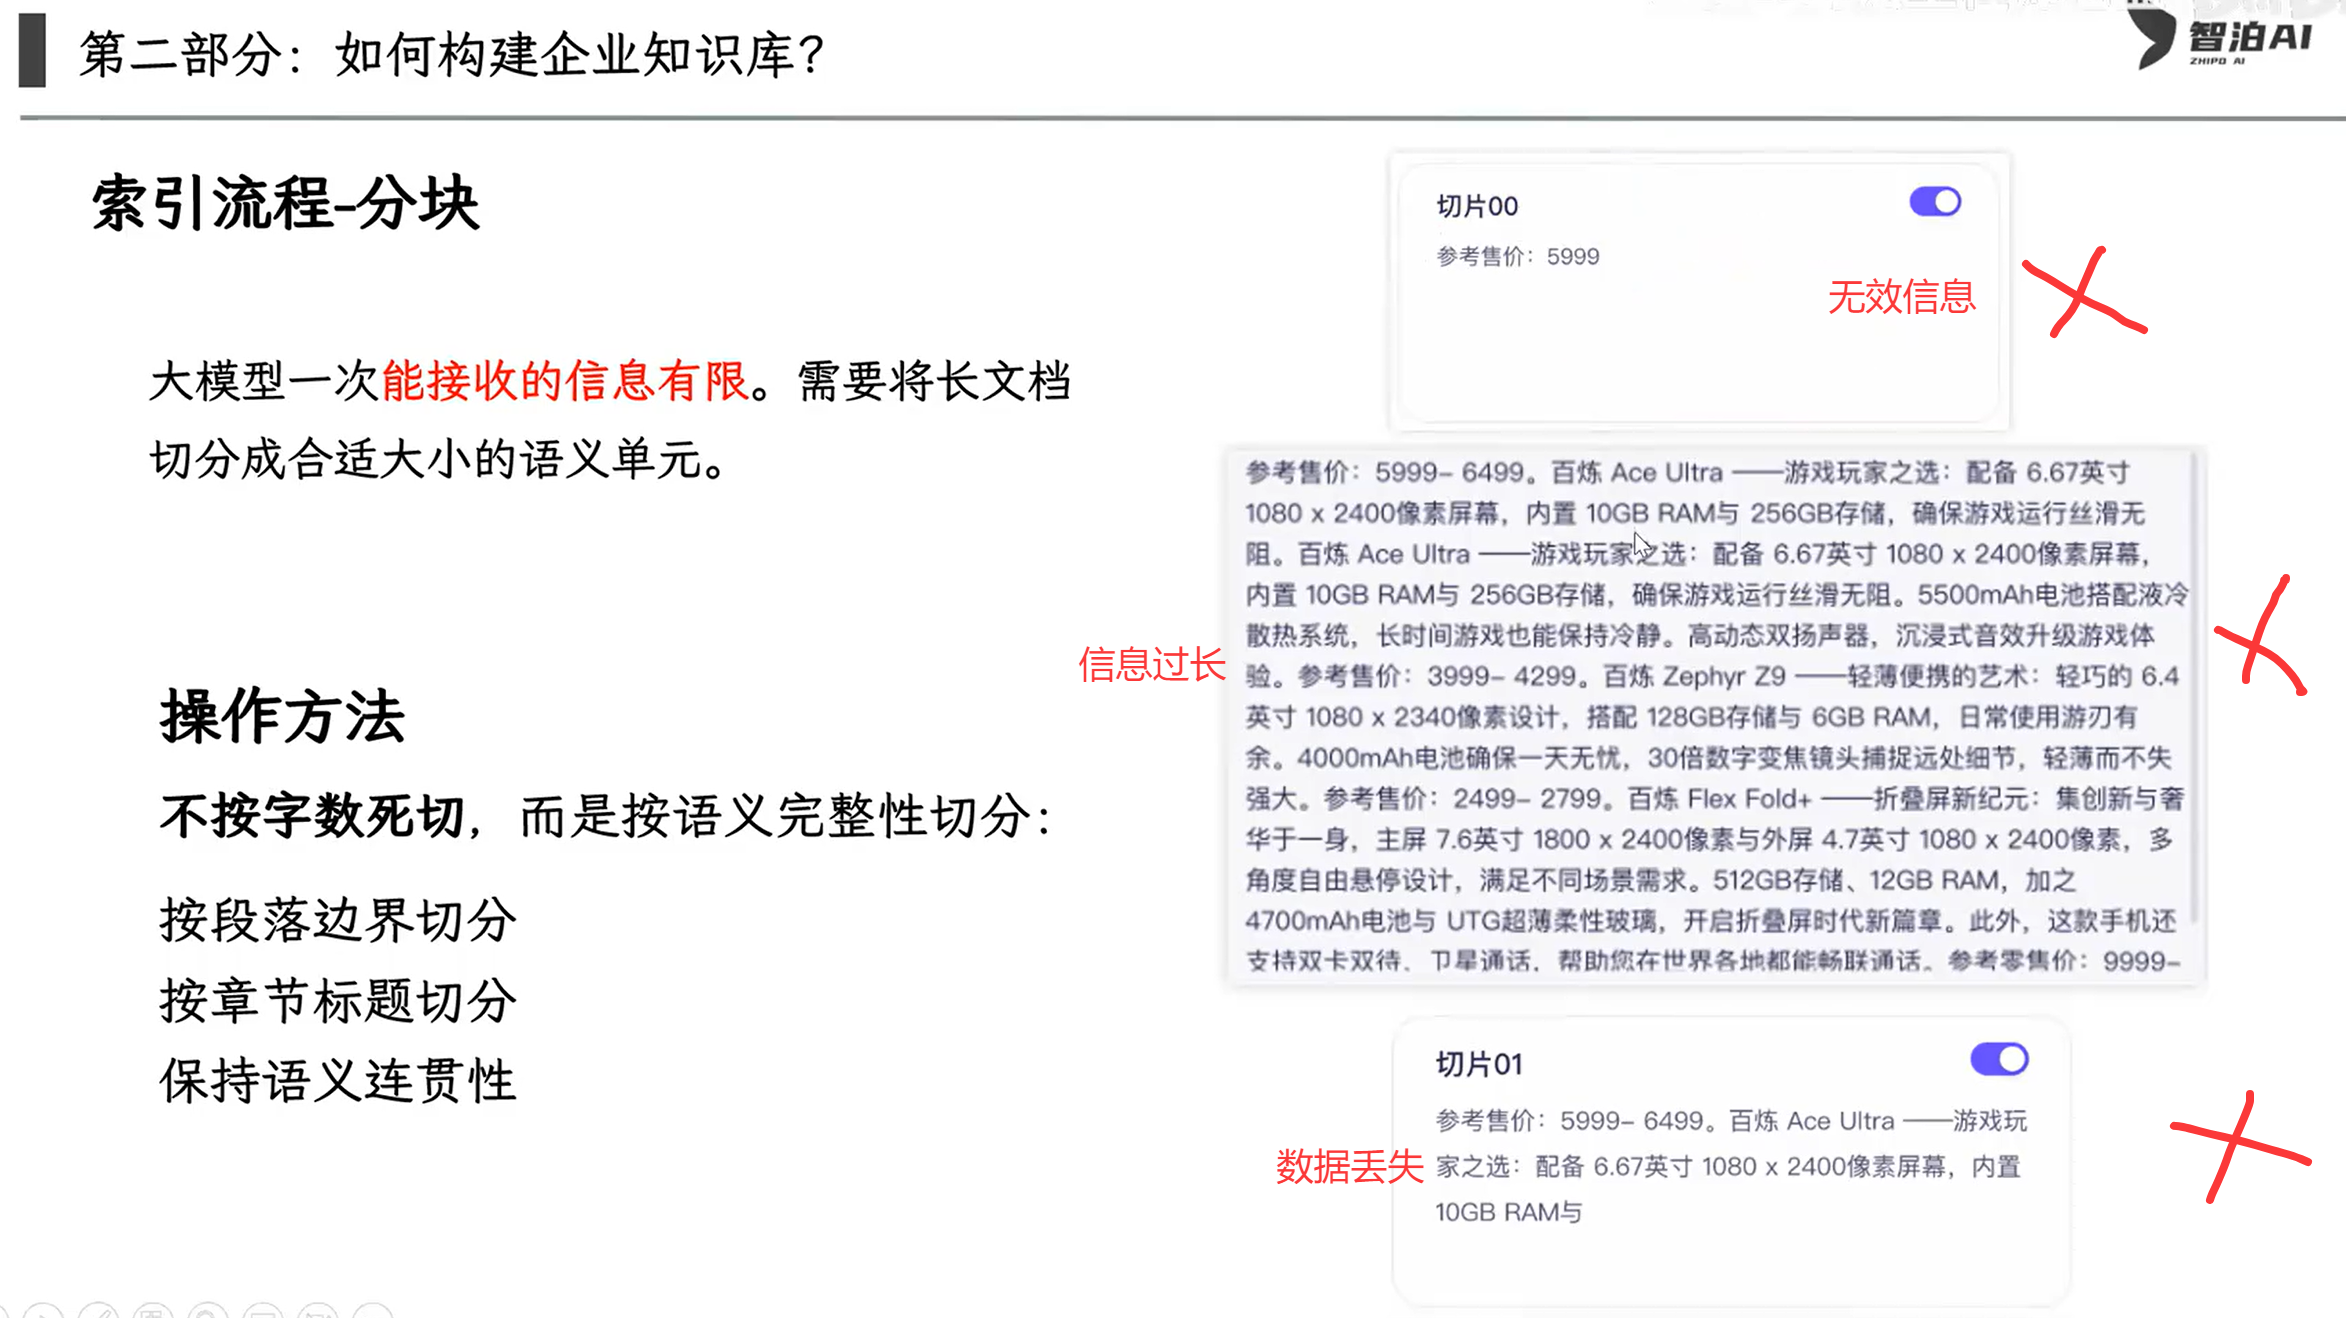
2.3 文档向量化
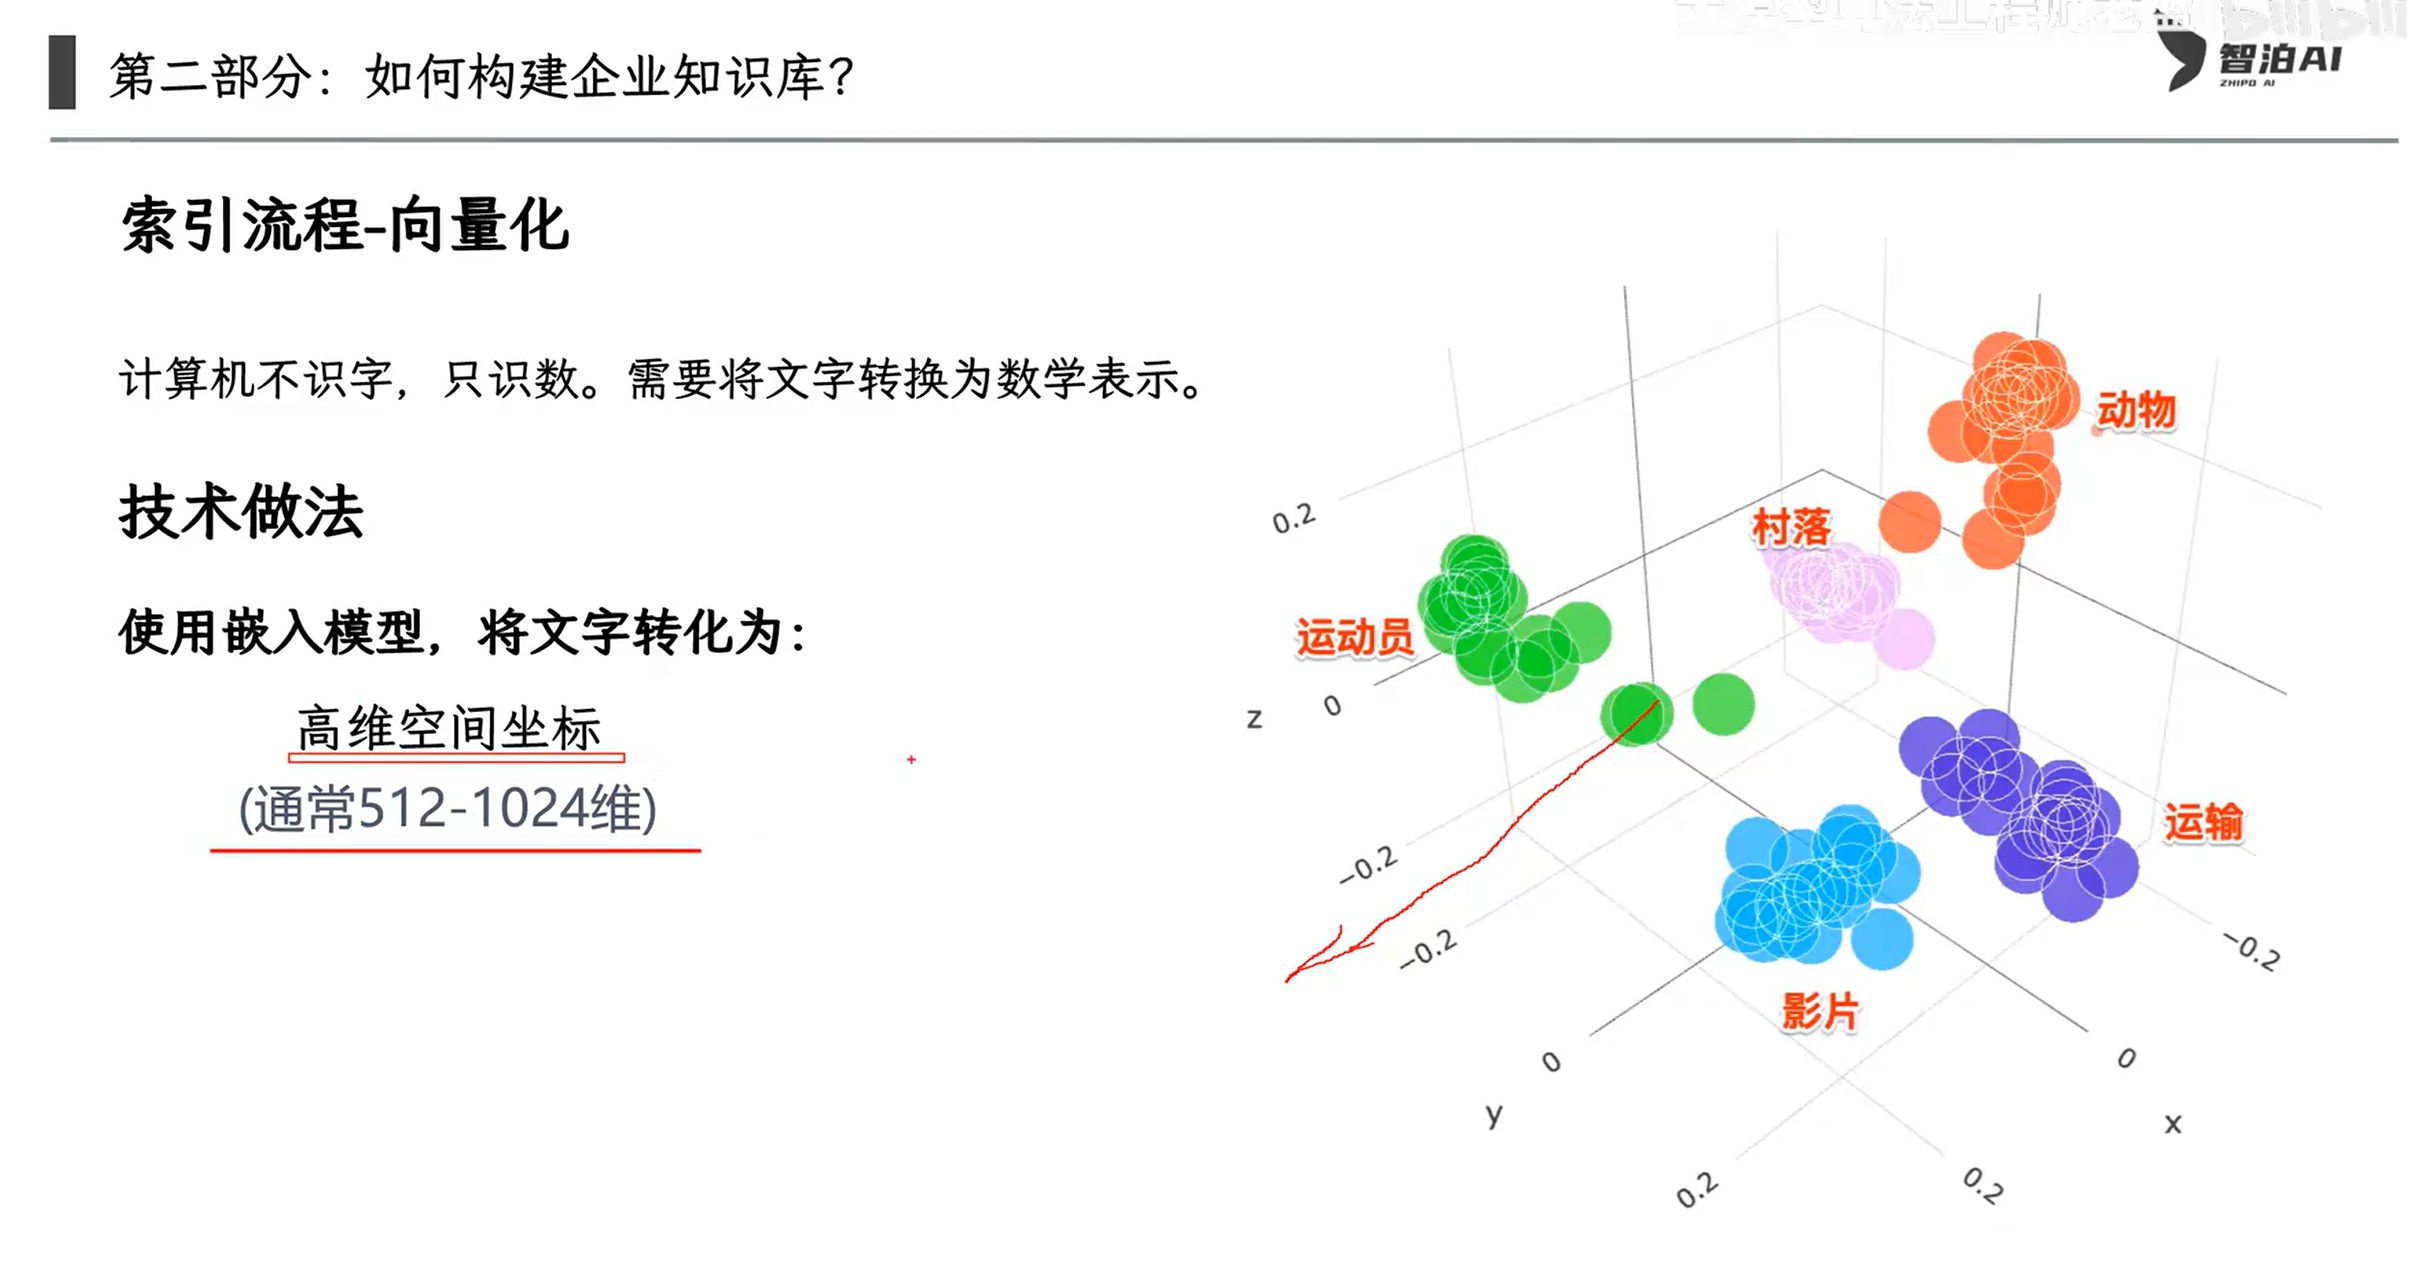
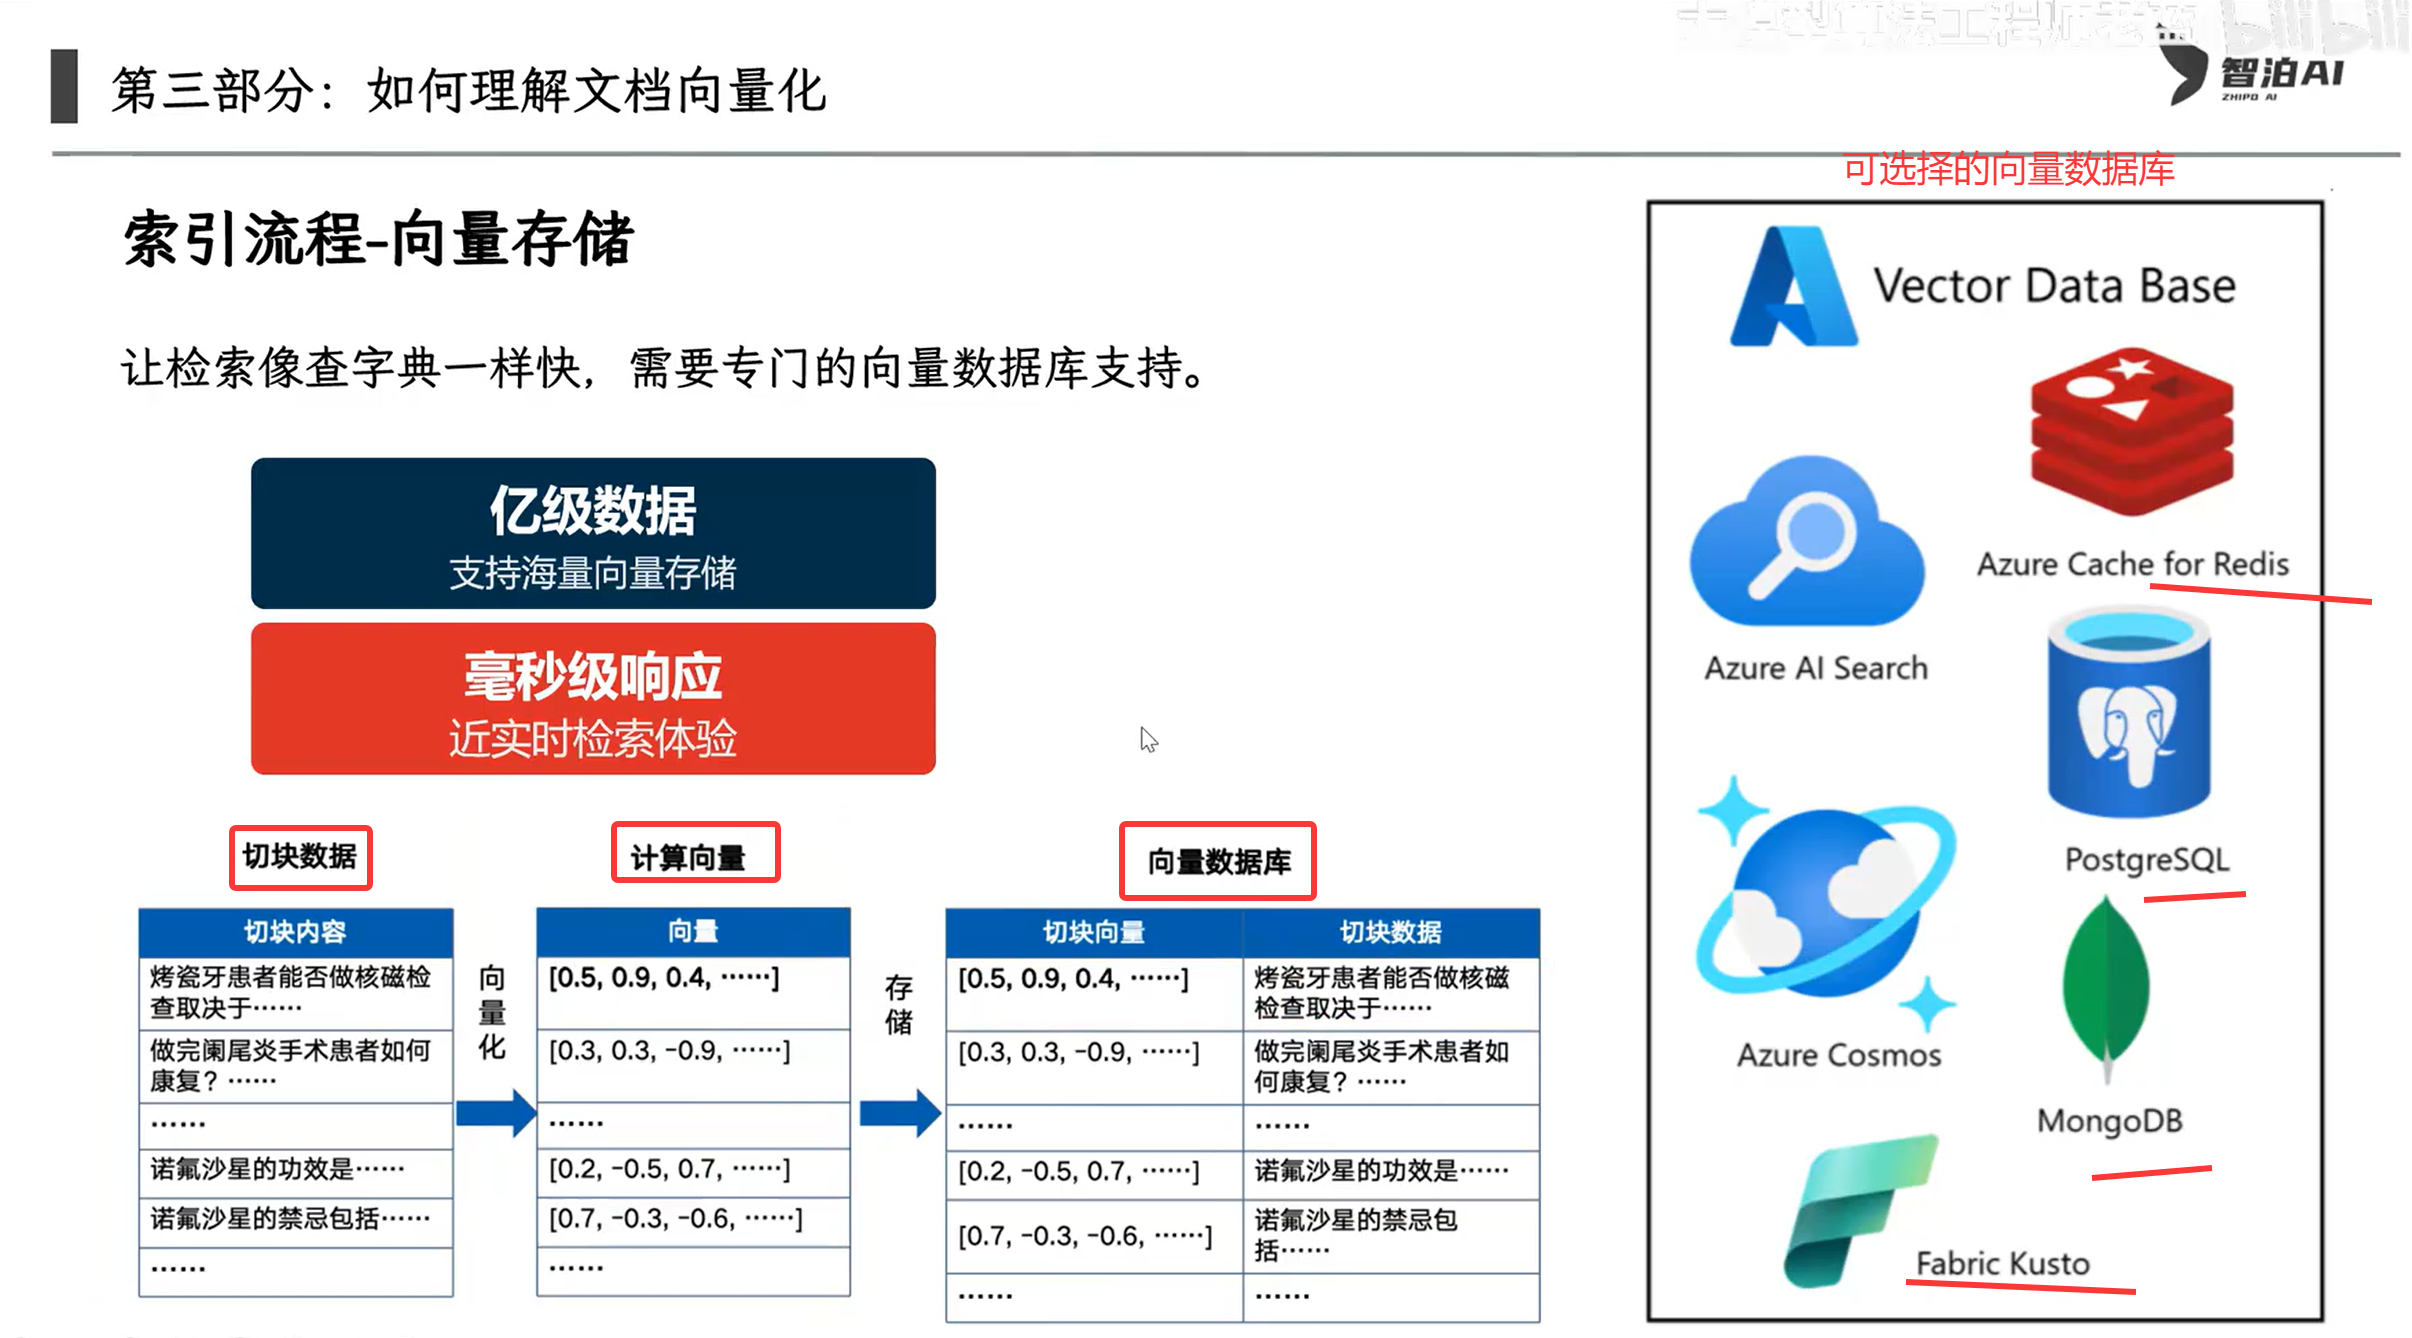
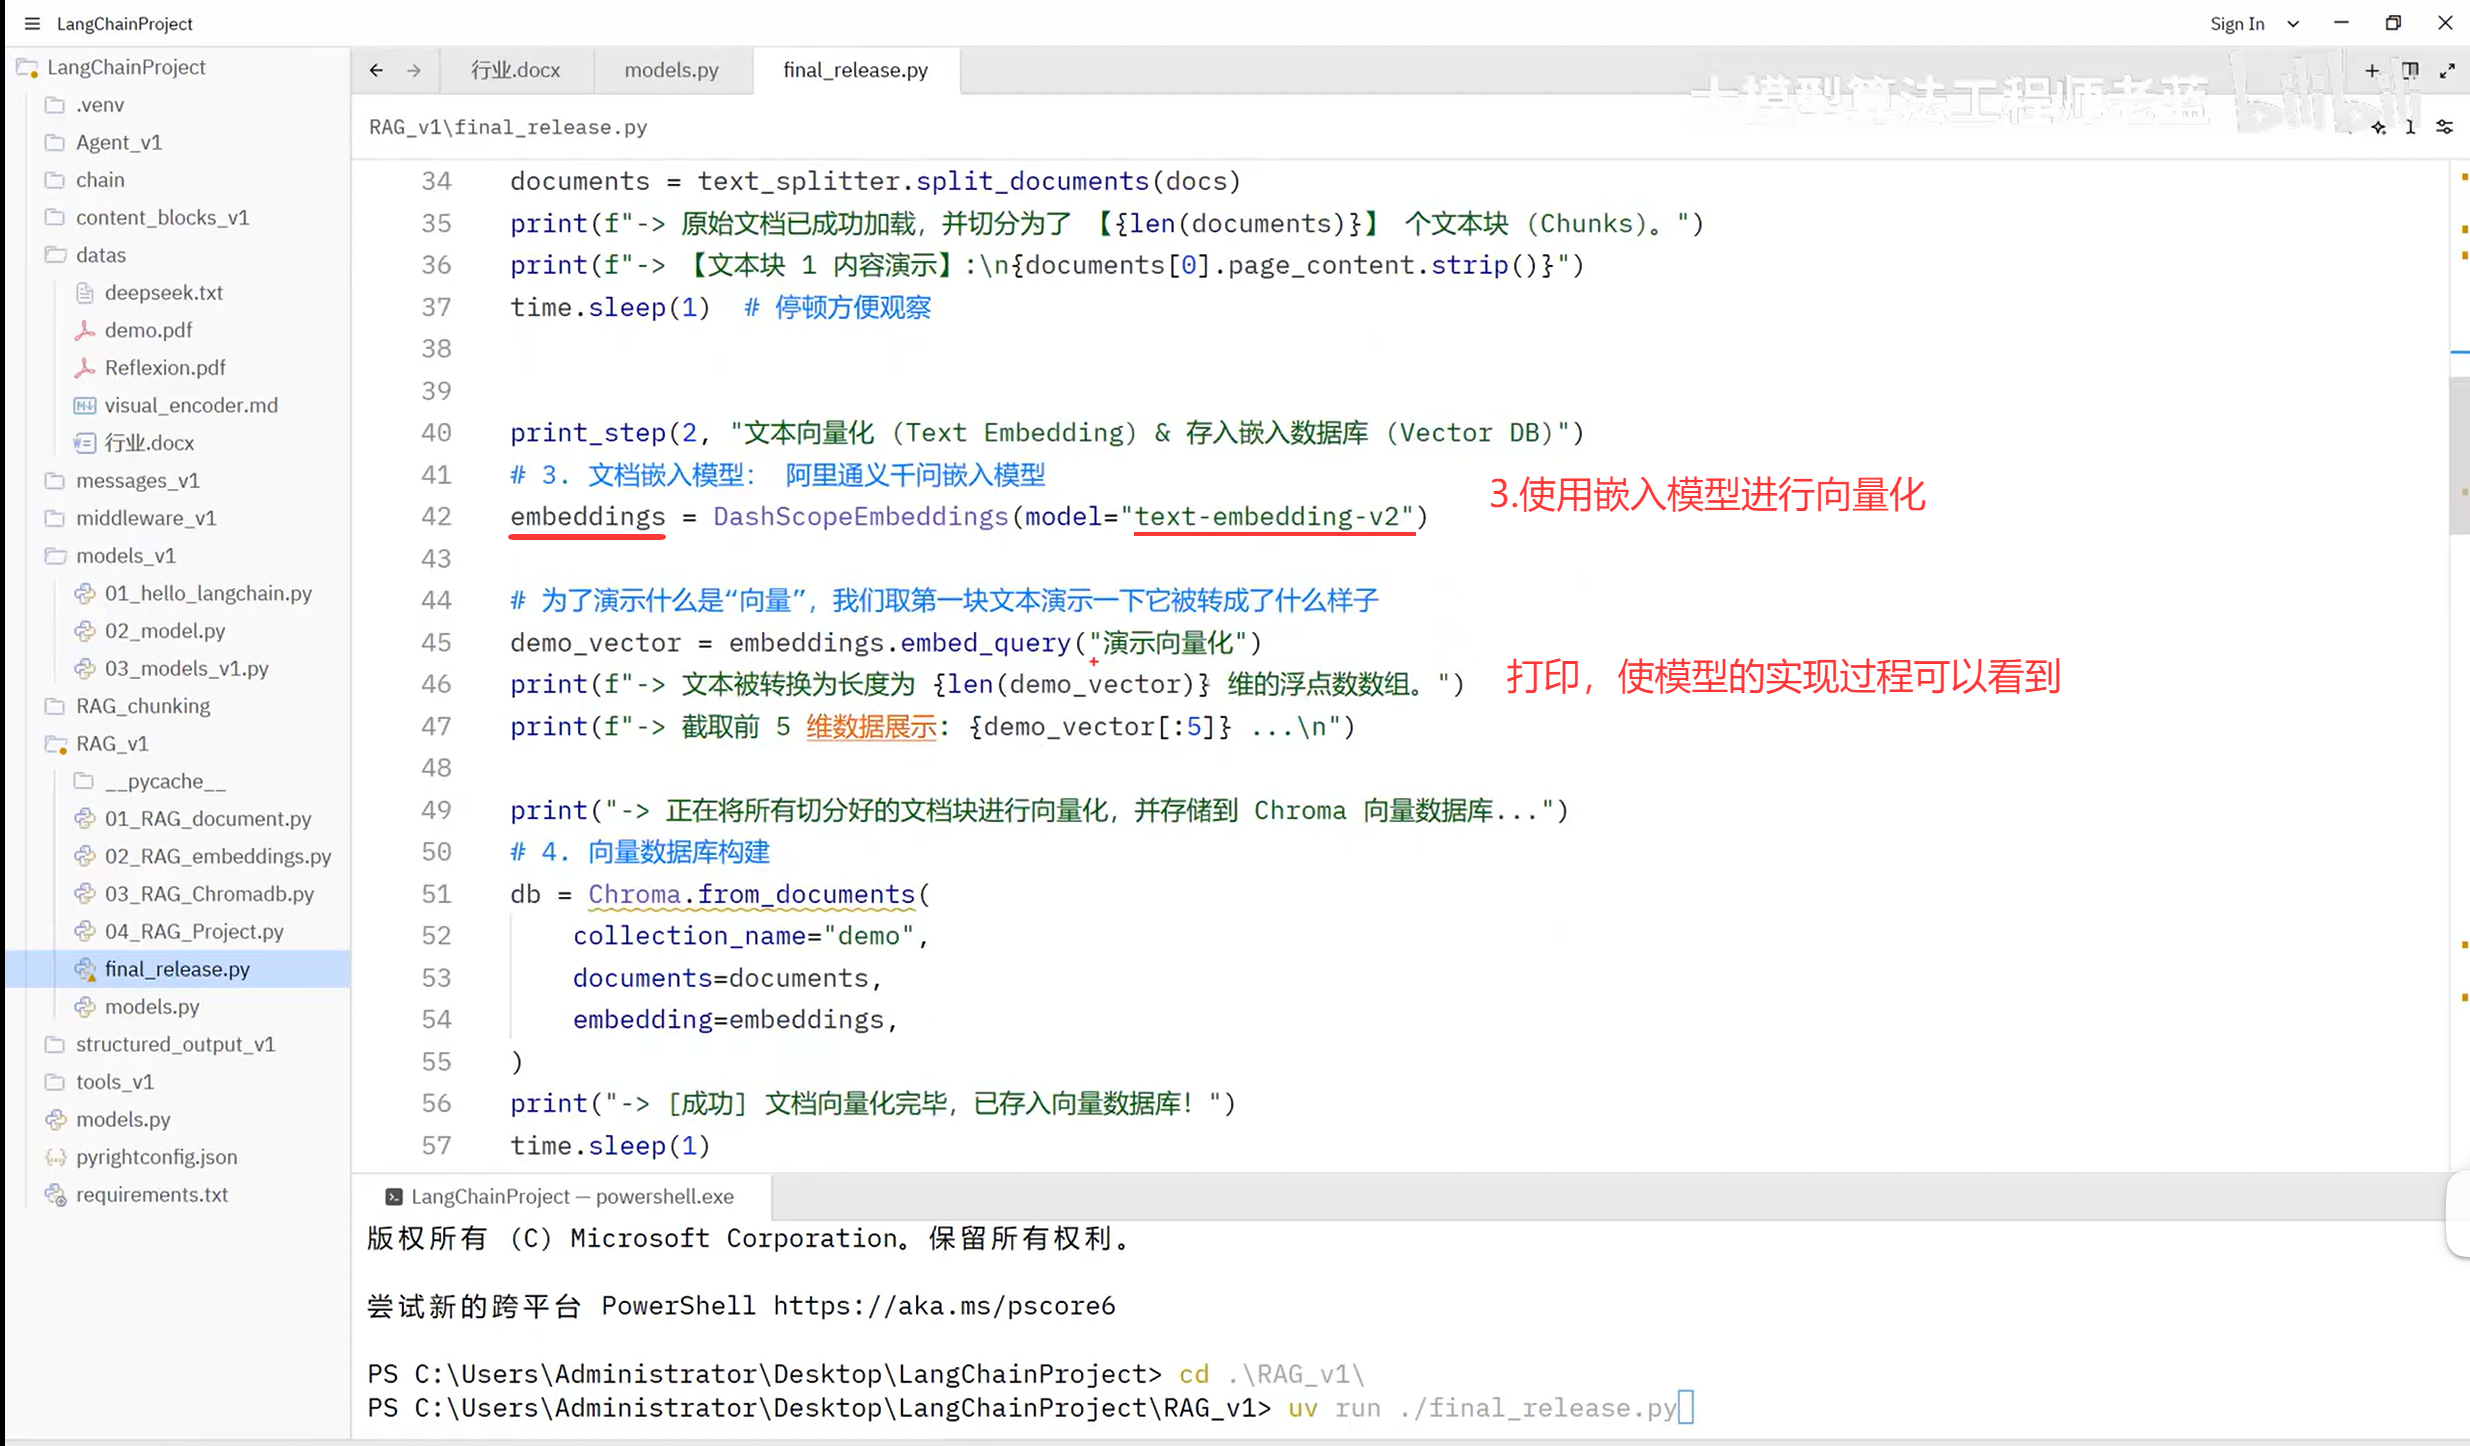
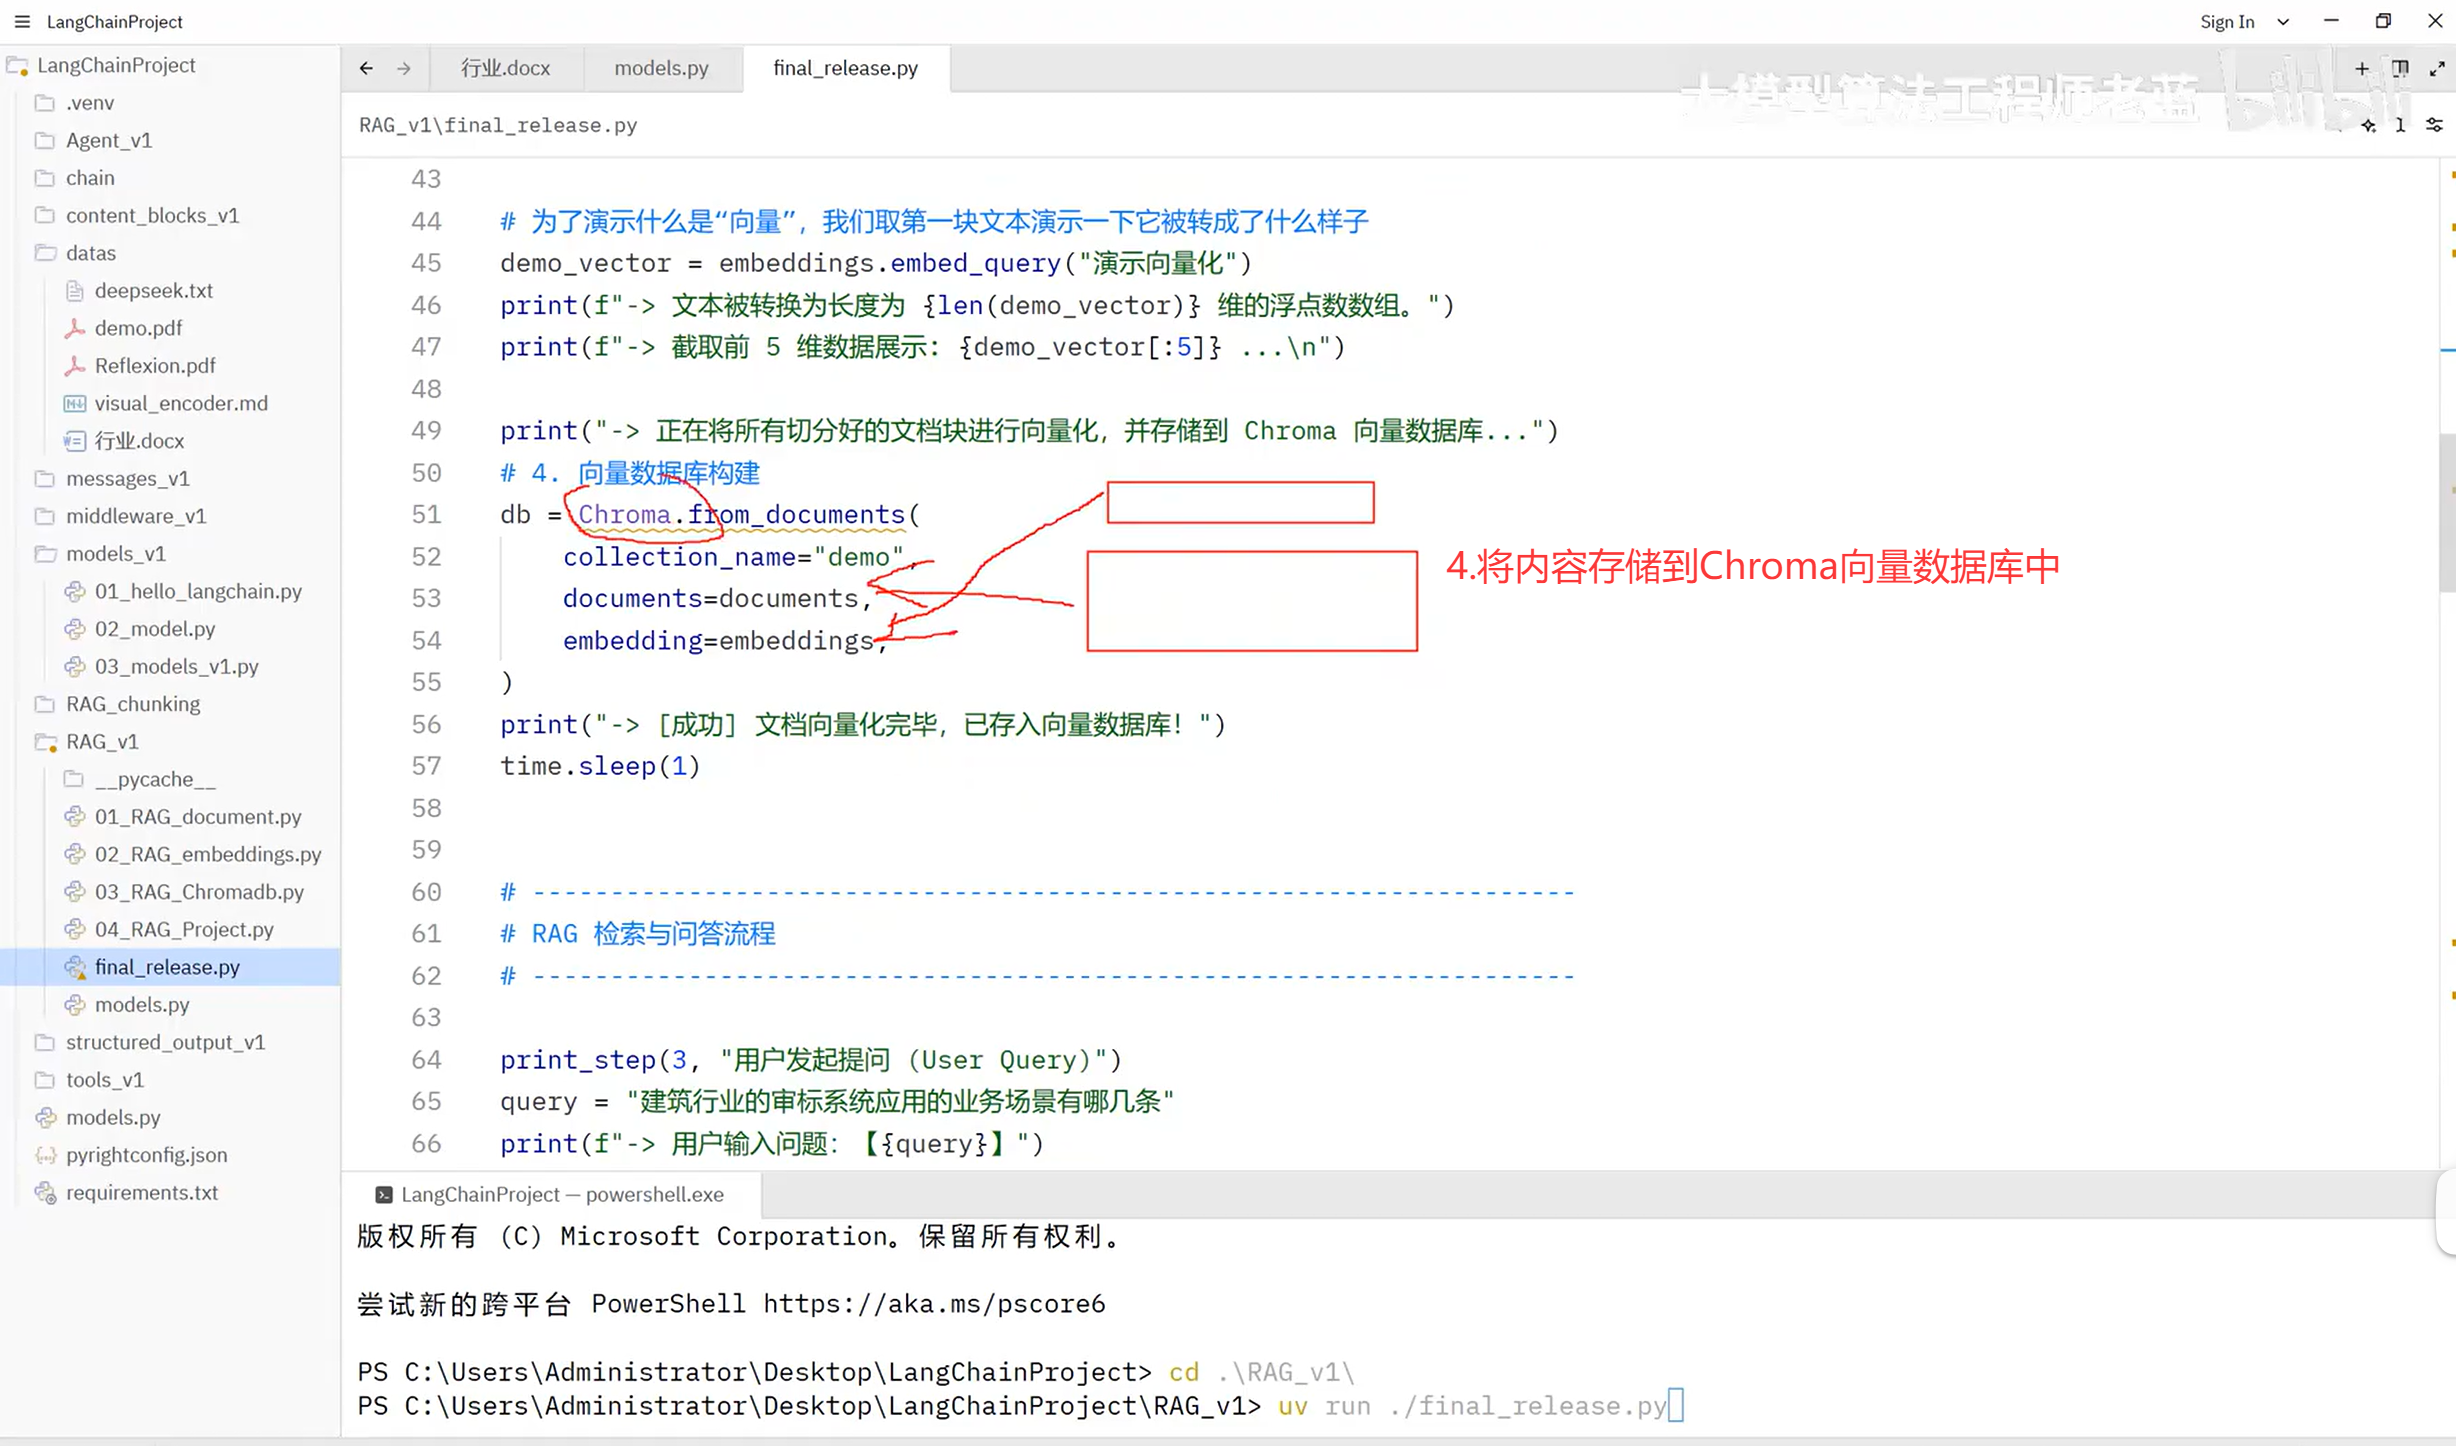
通过嵌入模型将文本片段转化为向量并存储
2.4 总结
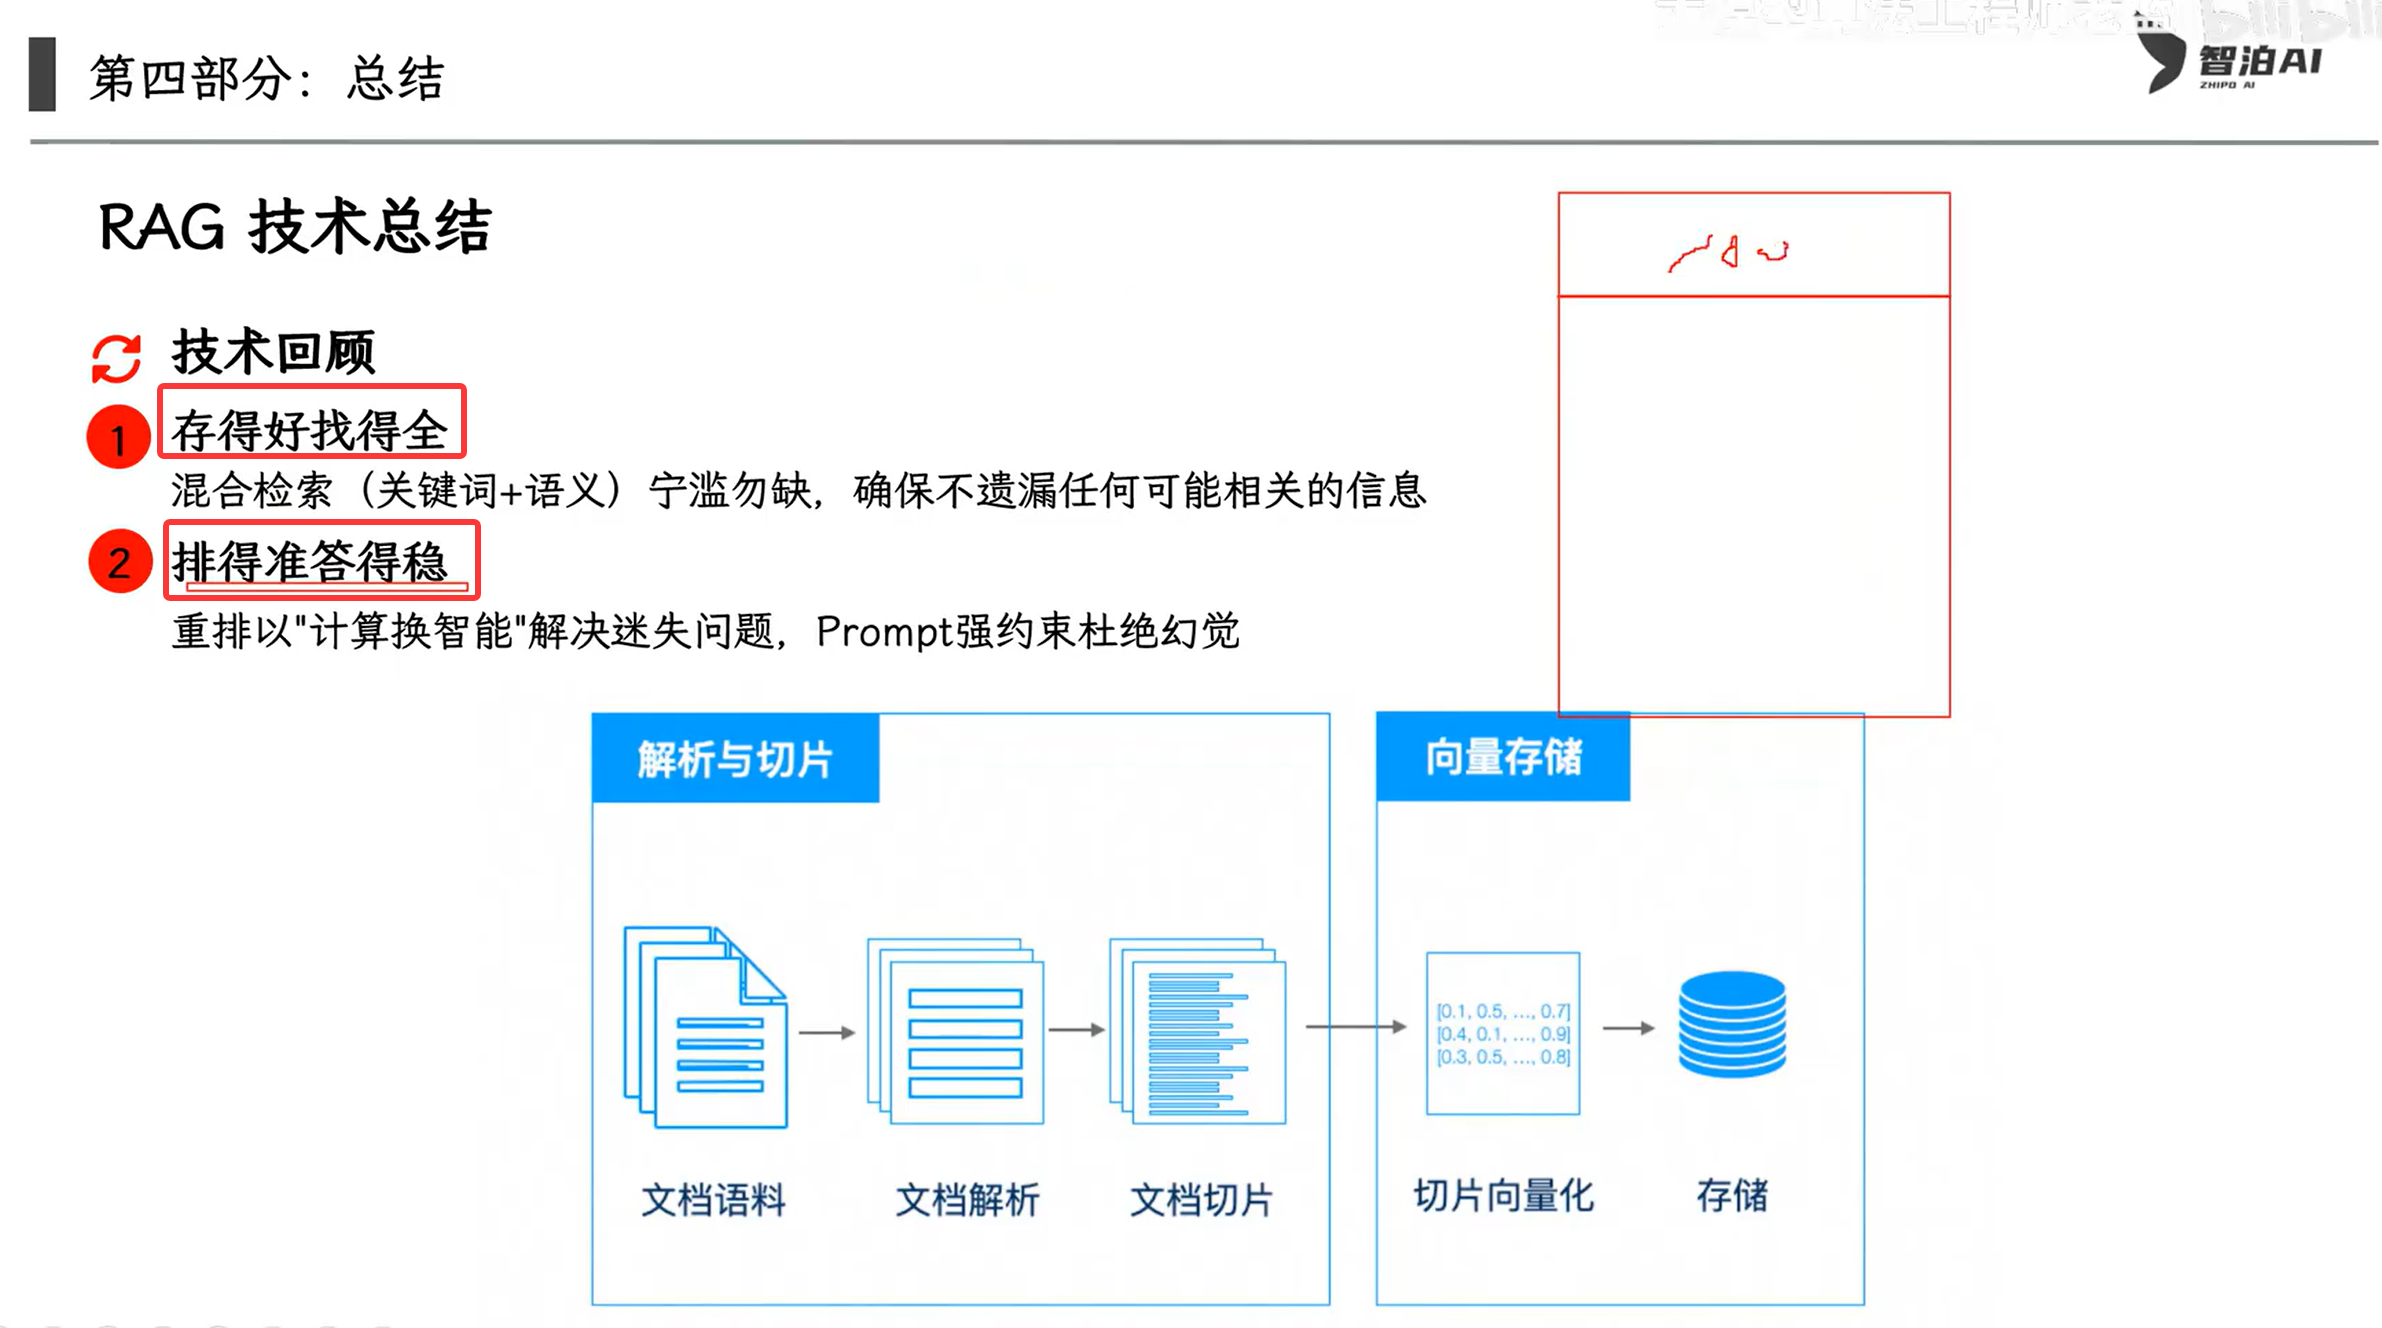
总结RAG技术中的索引流程
三、RAG检索重排
3.1 RAG文档检索
RAG技术如何从文档库中查到文档
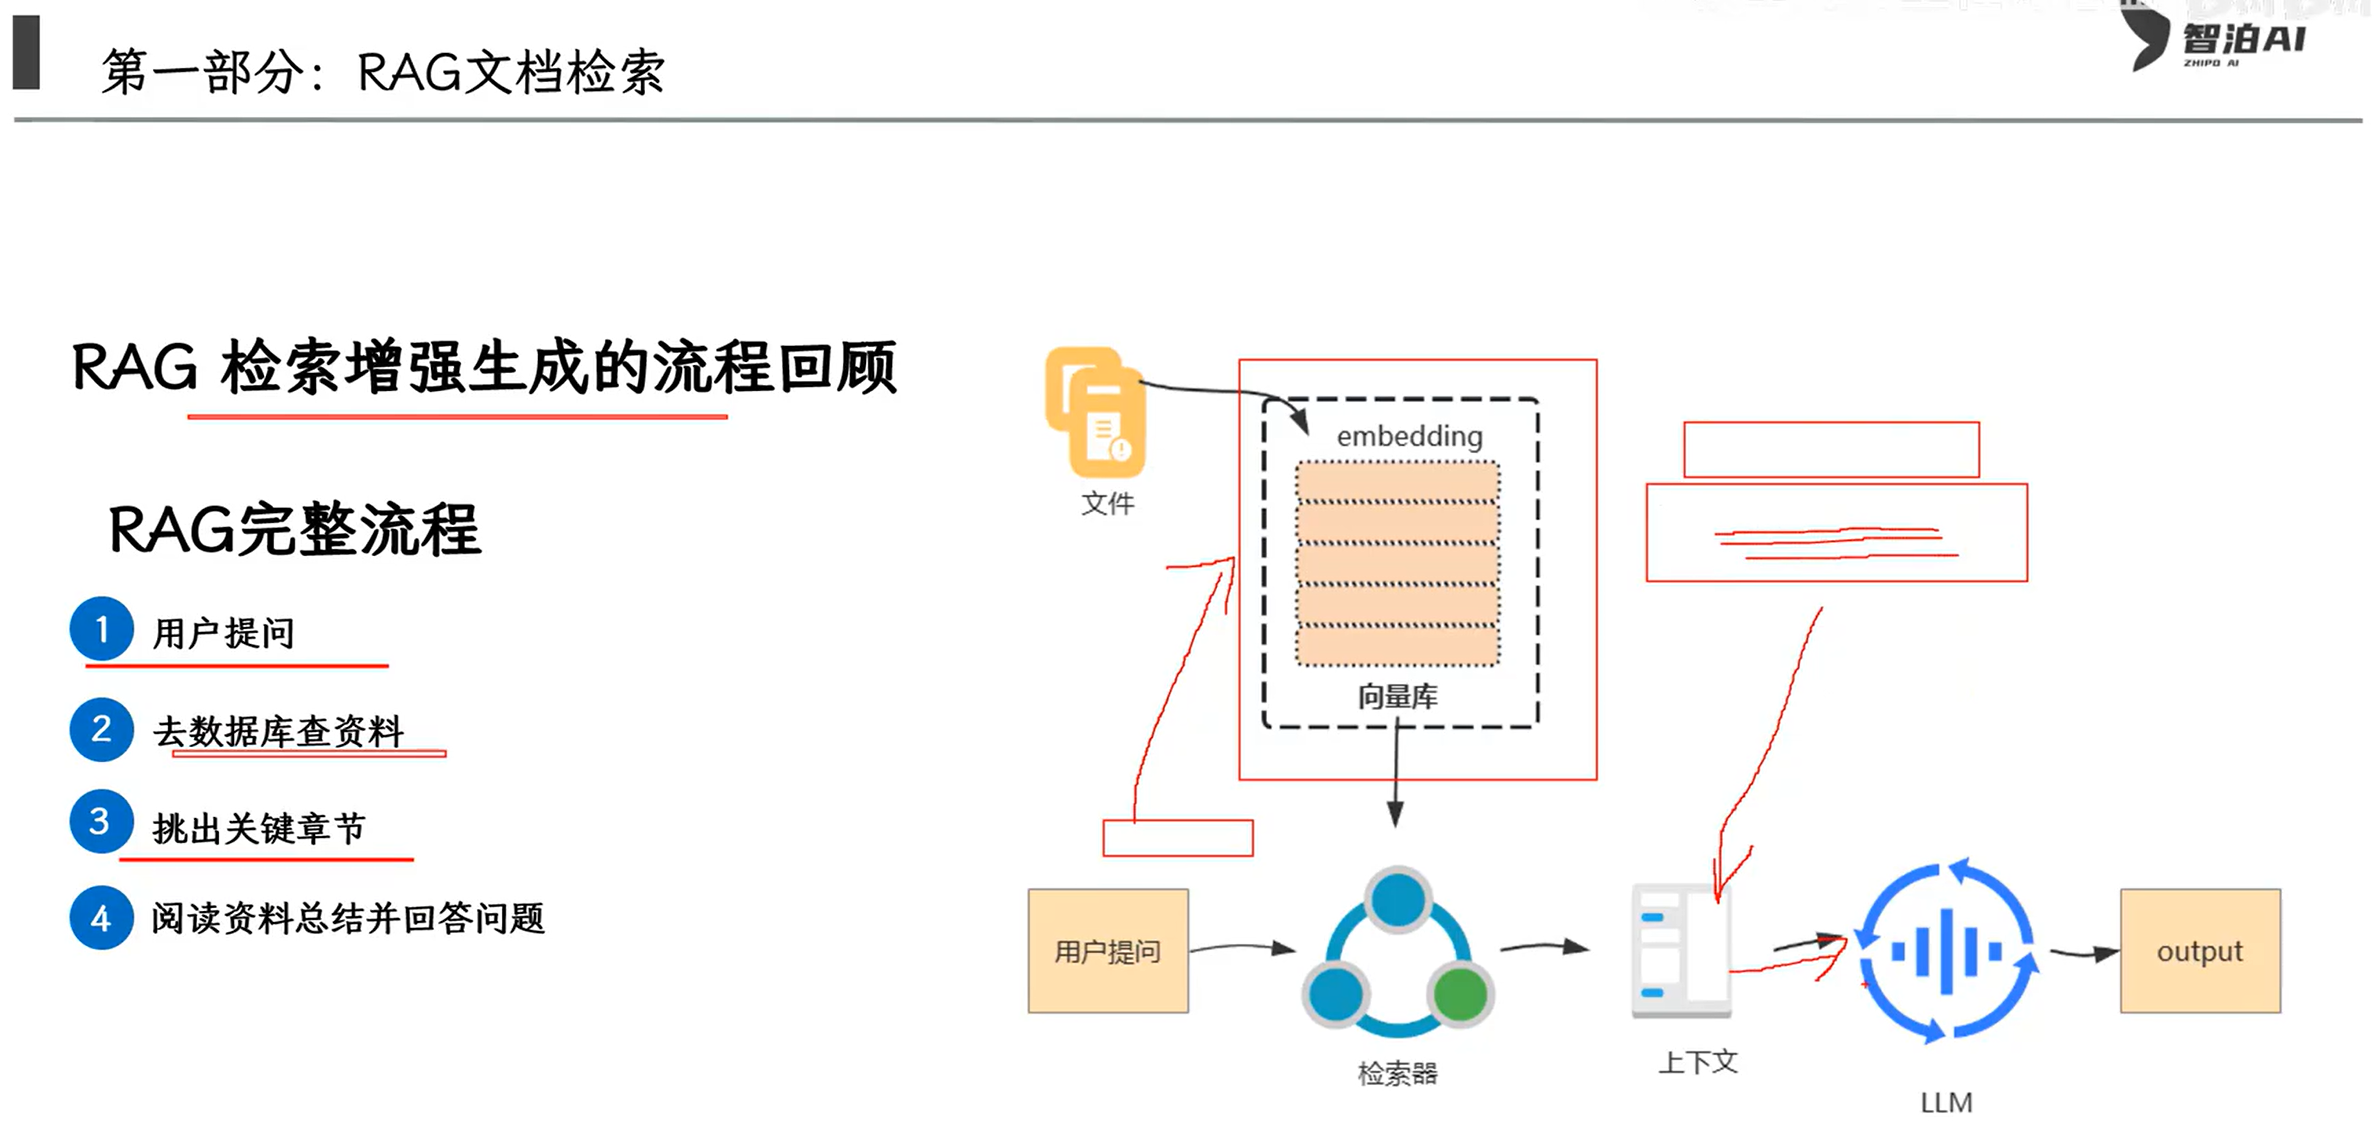
上面使用了上下文检索技术
3.2 召回的局限性有哪些
召回的片段太多且无关怎么办?
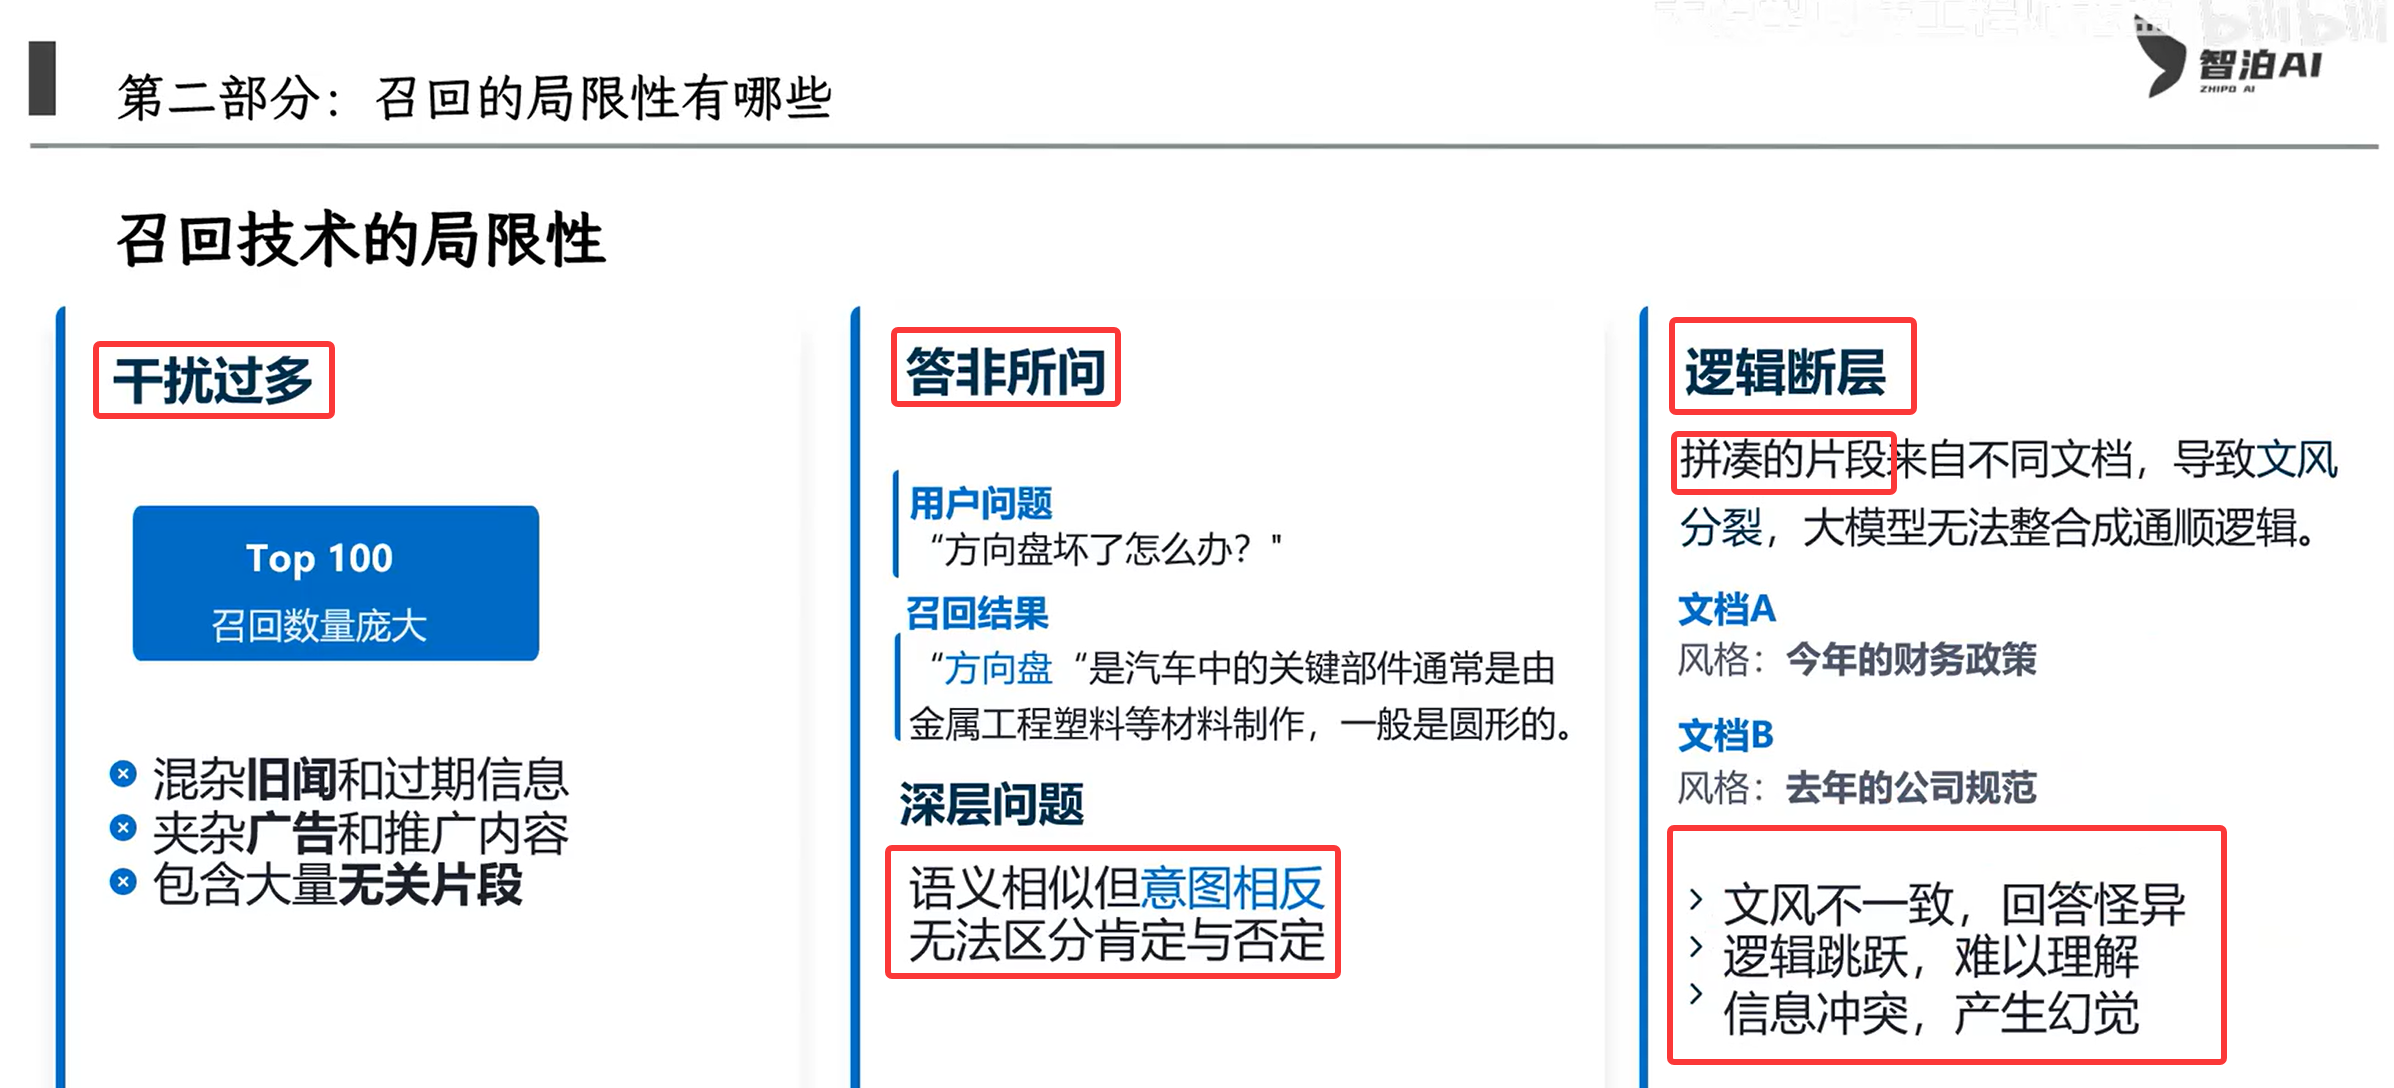
3.3 重排技术如何提高质量
重排技术提升业务效果
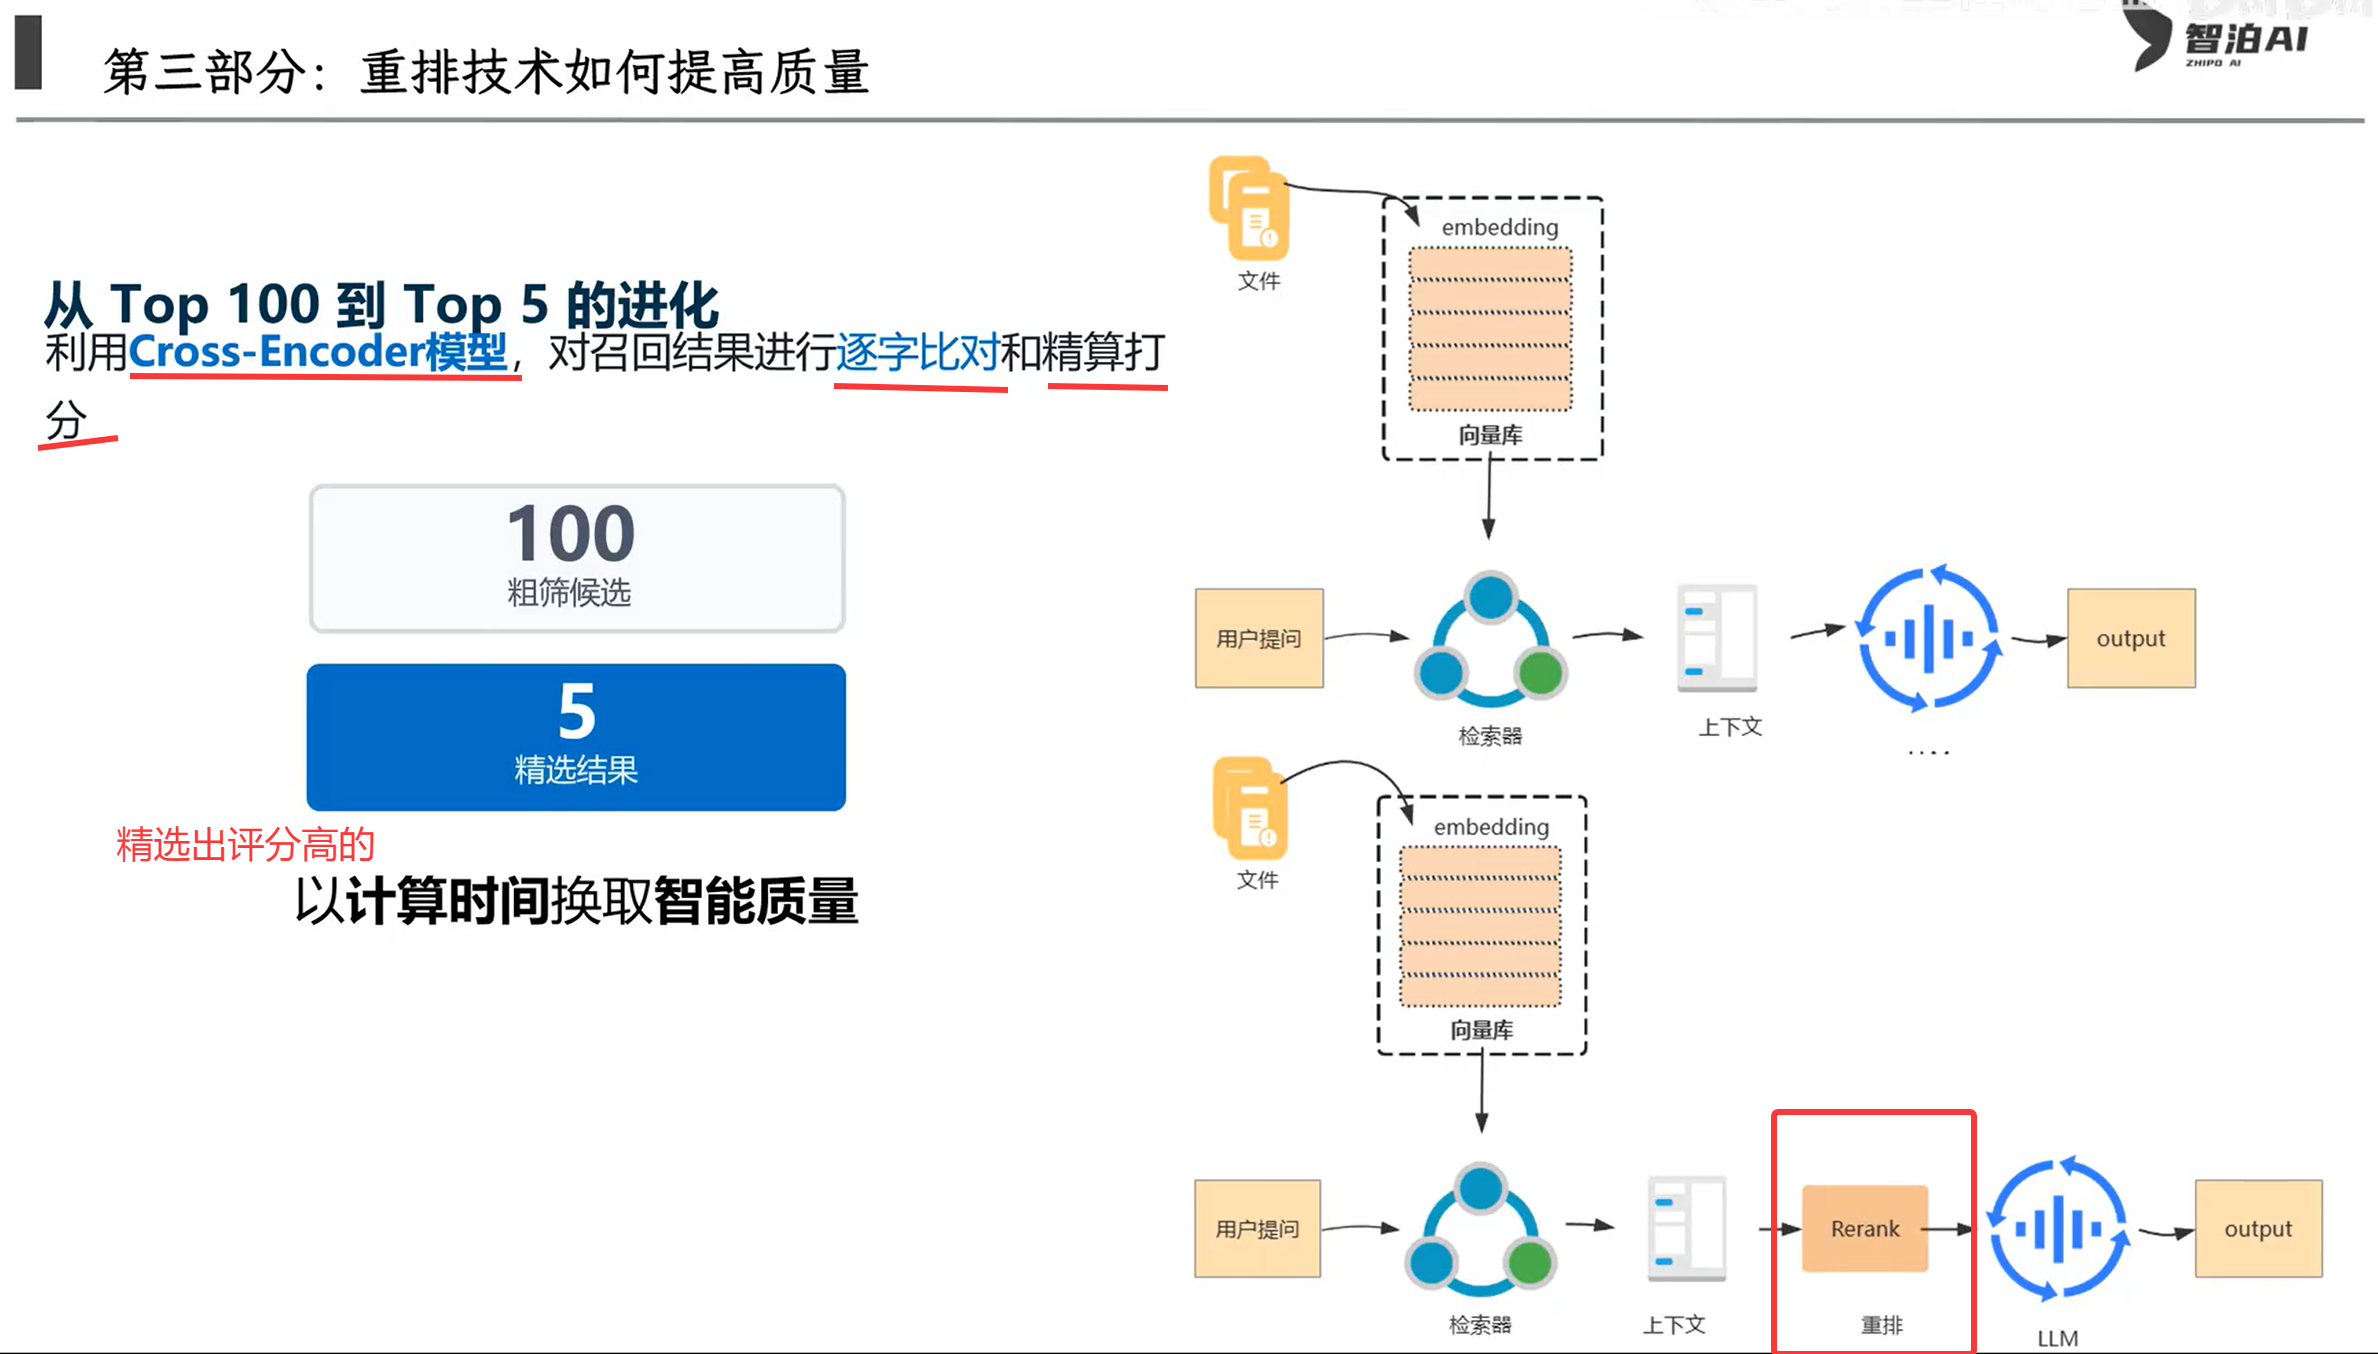
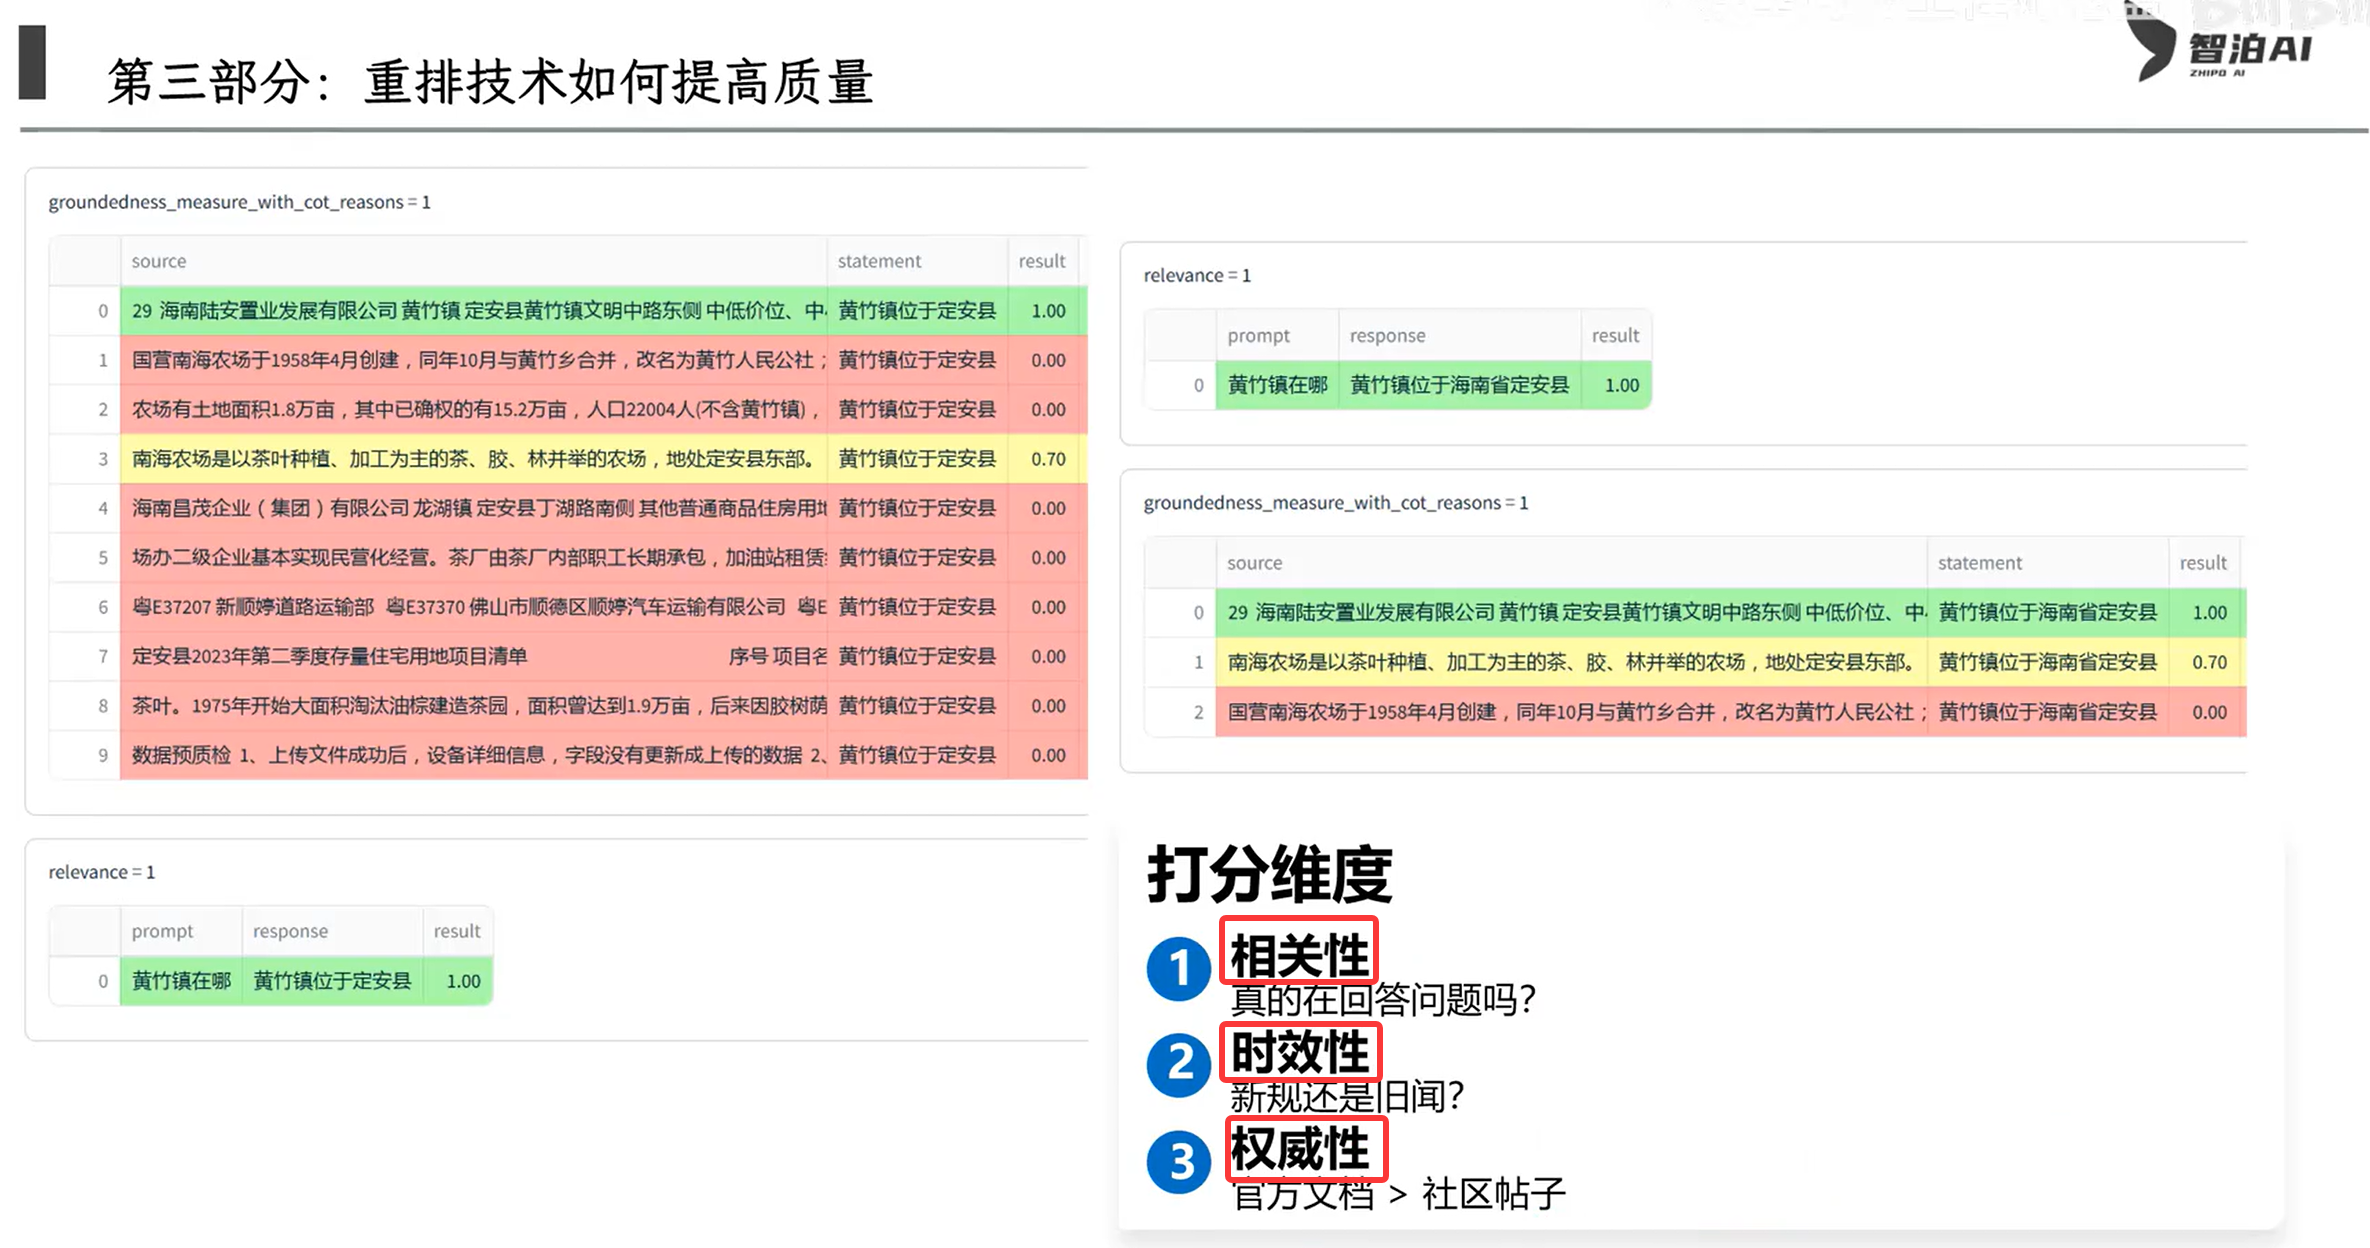
打分维度:相关性、时效性(新规>旧闻)、权威性(官方文档>社区帖子)
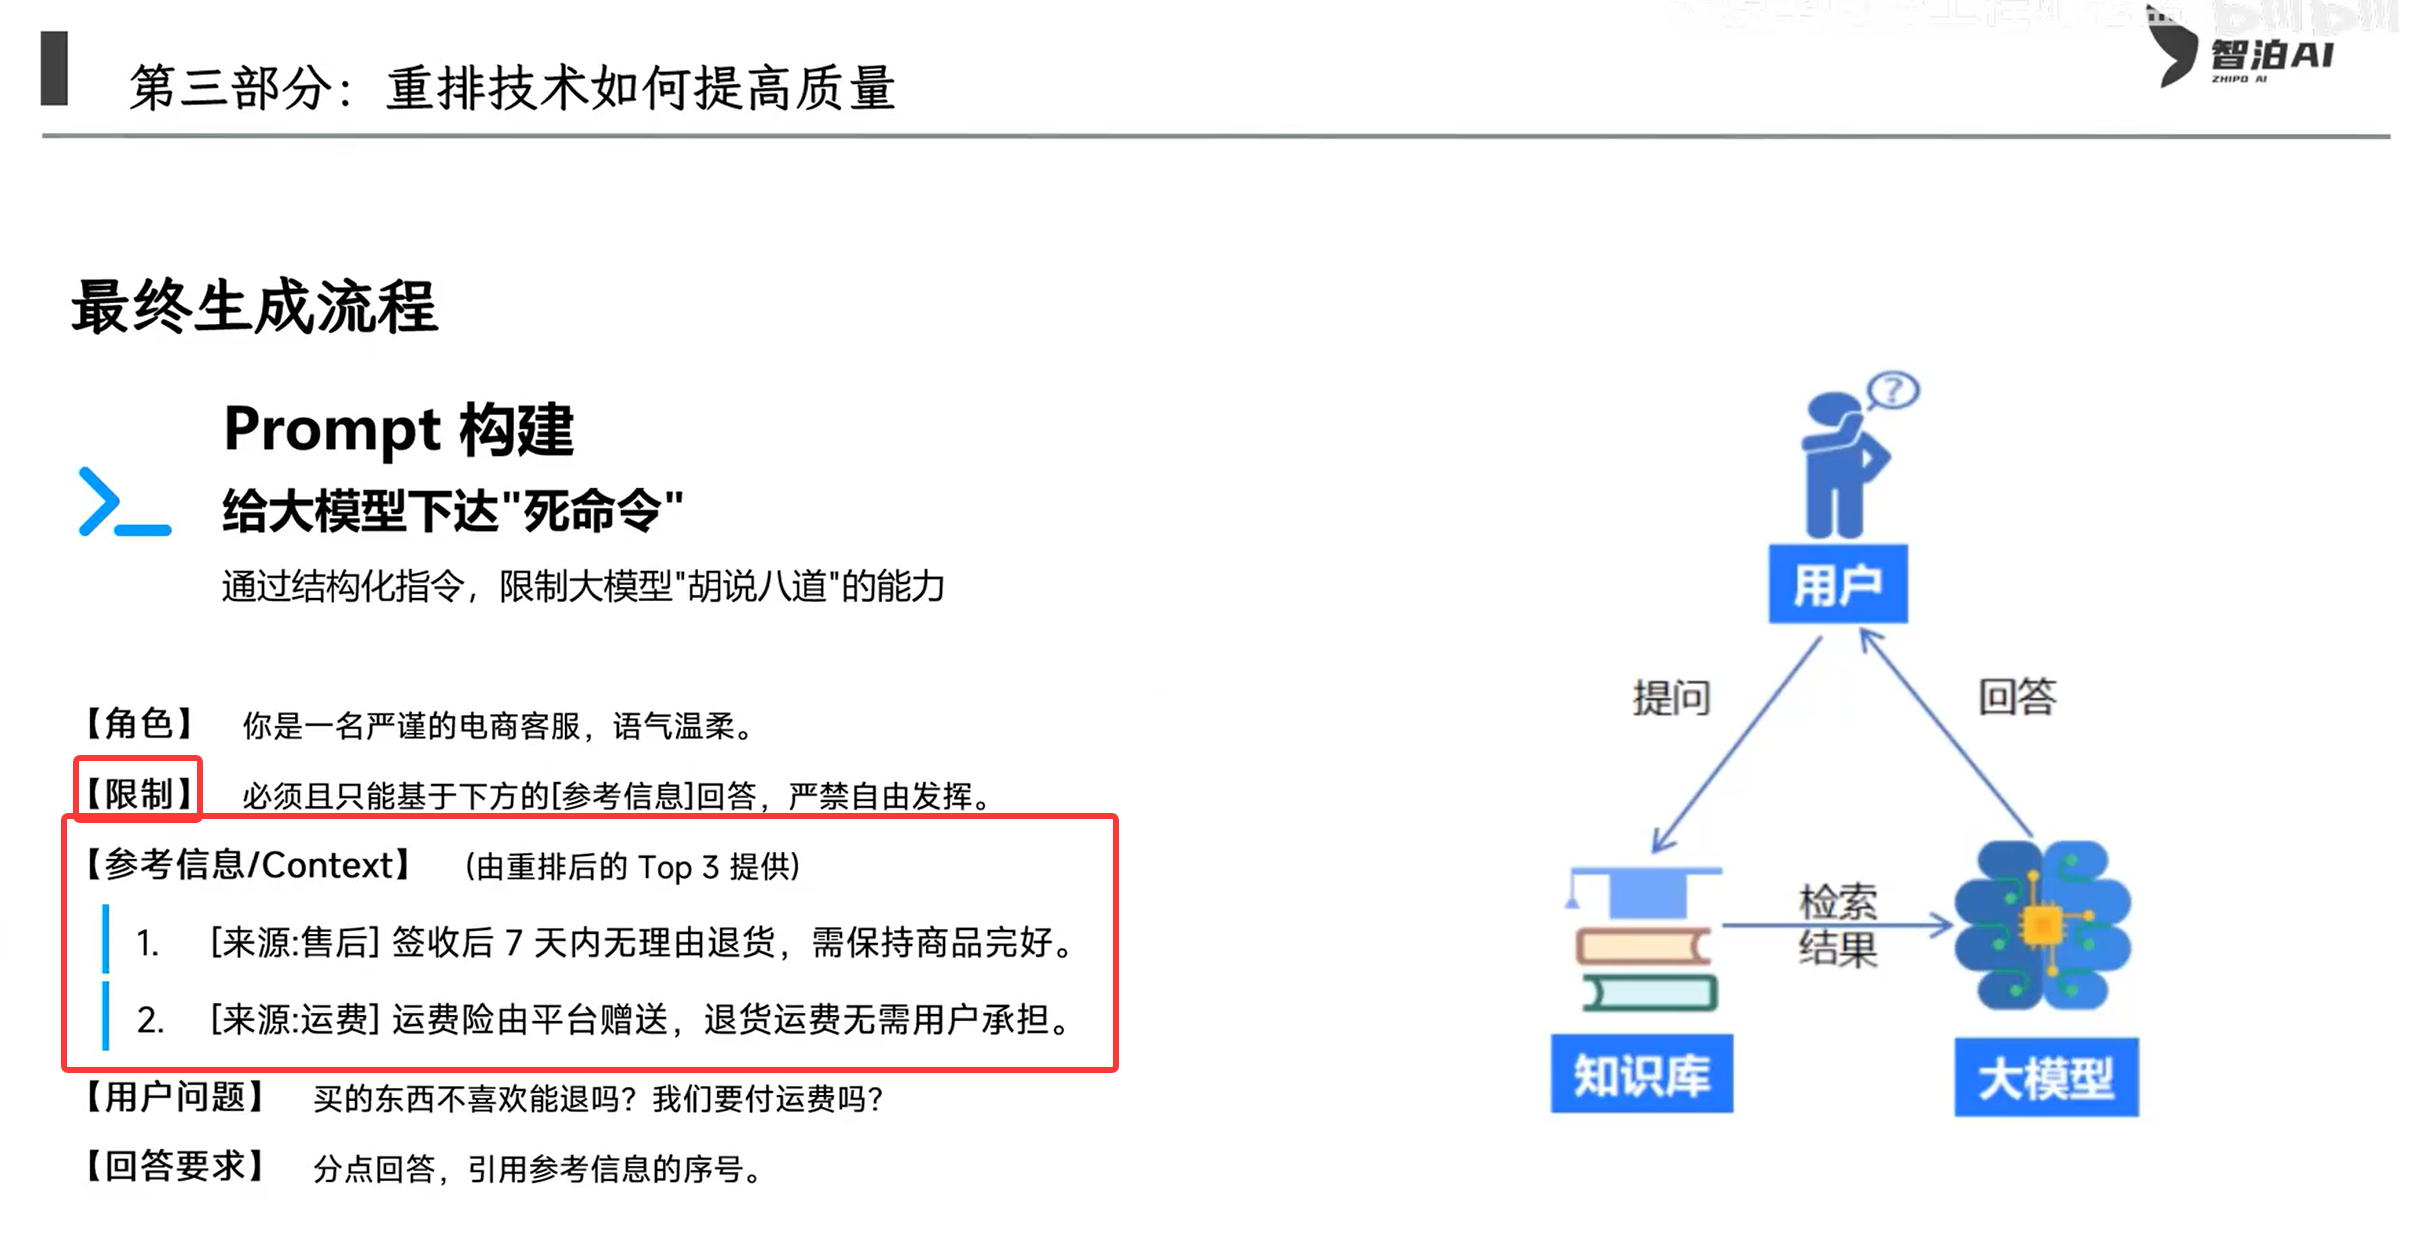
3.4 总结
总结RAG技术中的增强效果如何提升
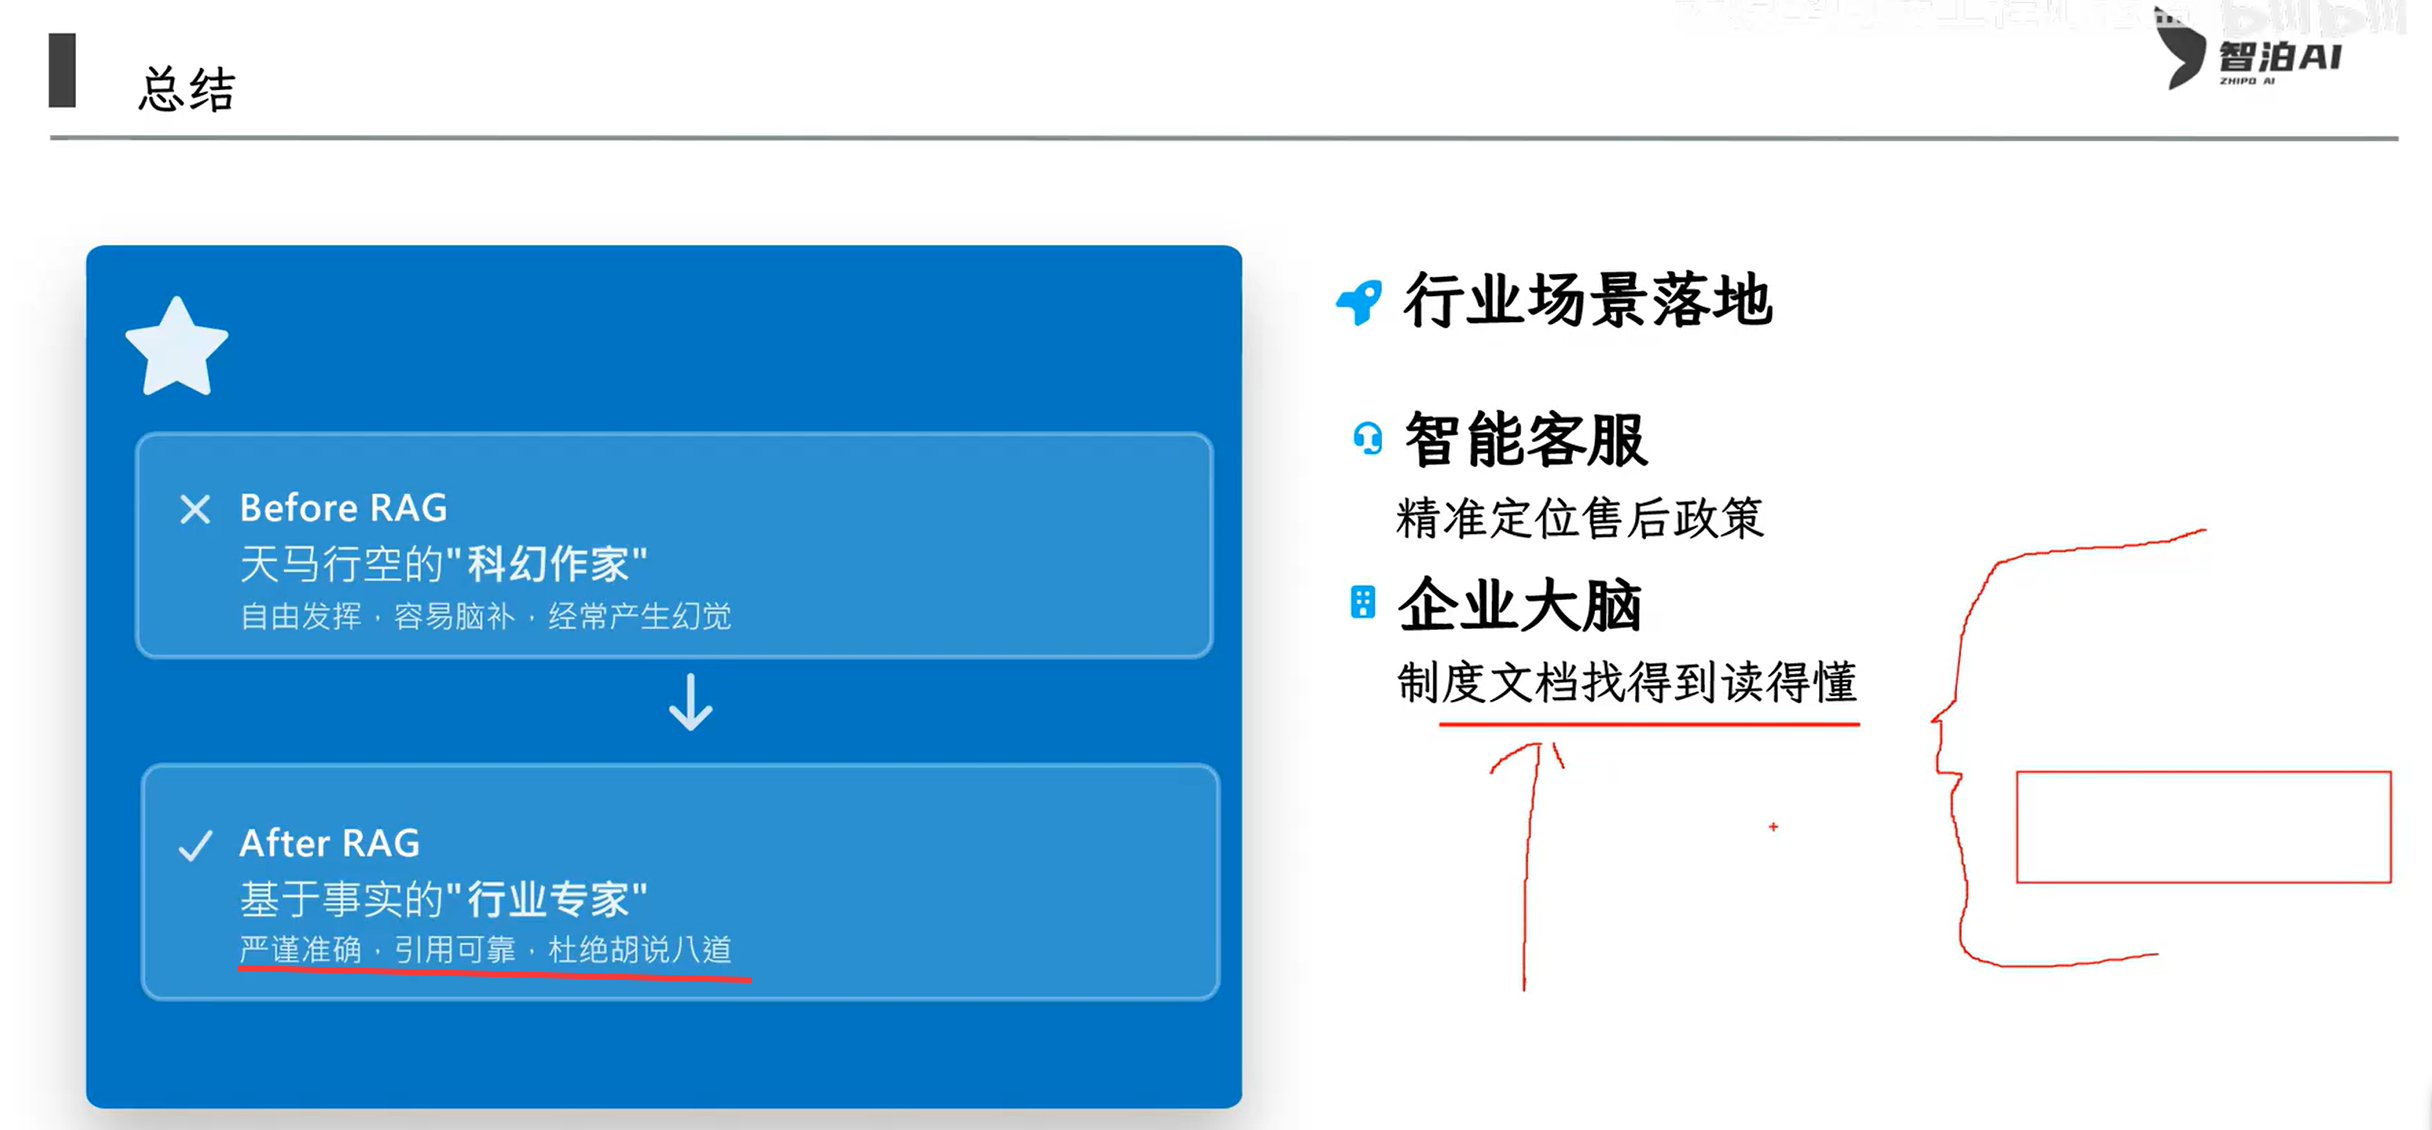
四、RAG文本分块
从文档中提取有用的信息
4.1 RAG文本分块作用
RAG技术中文本分块的作用
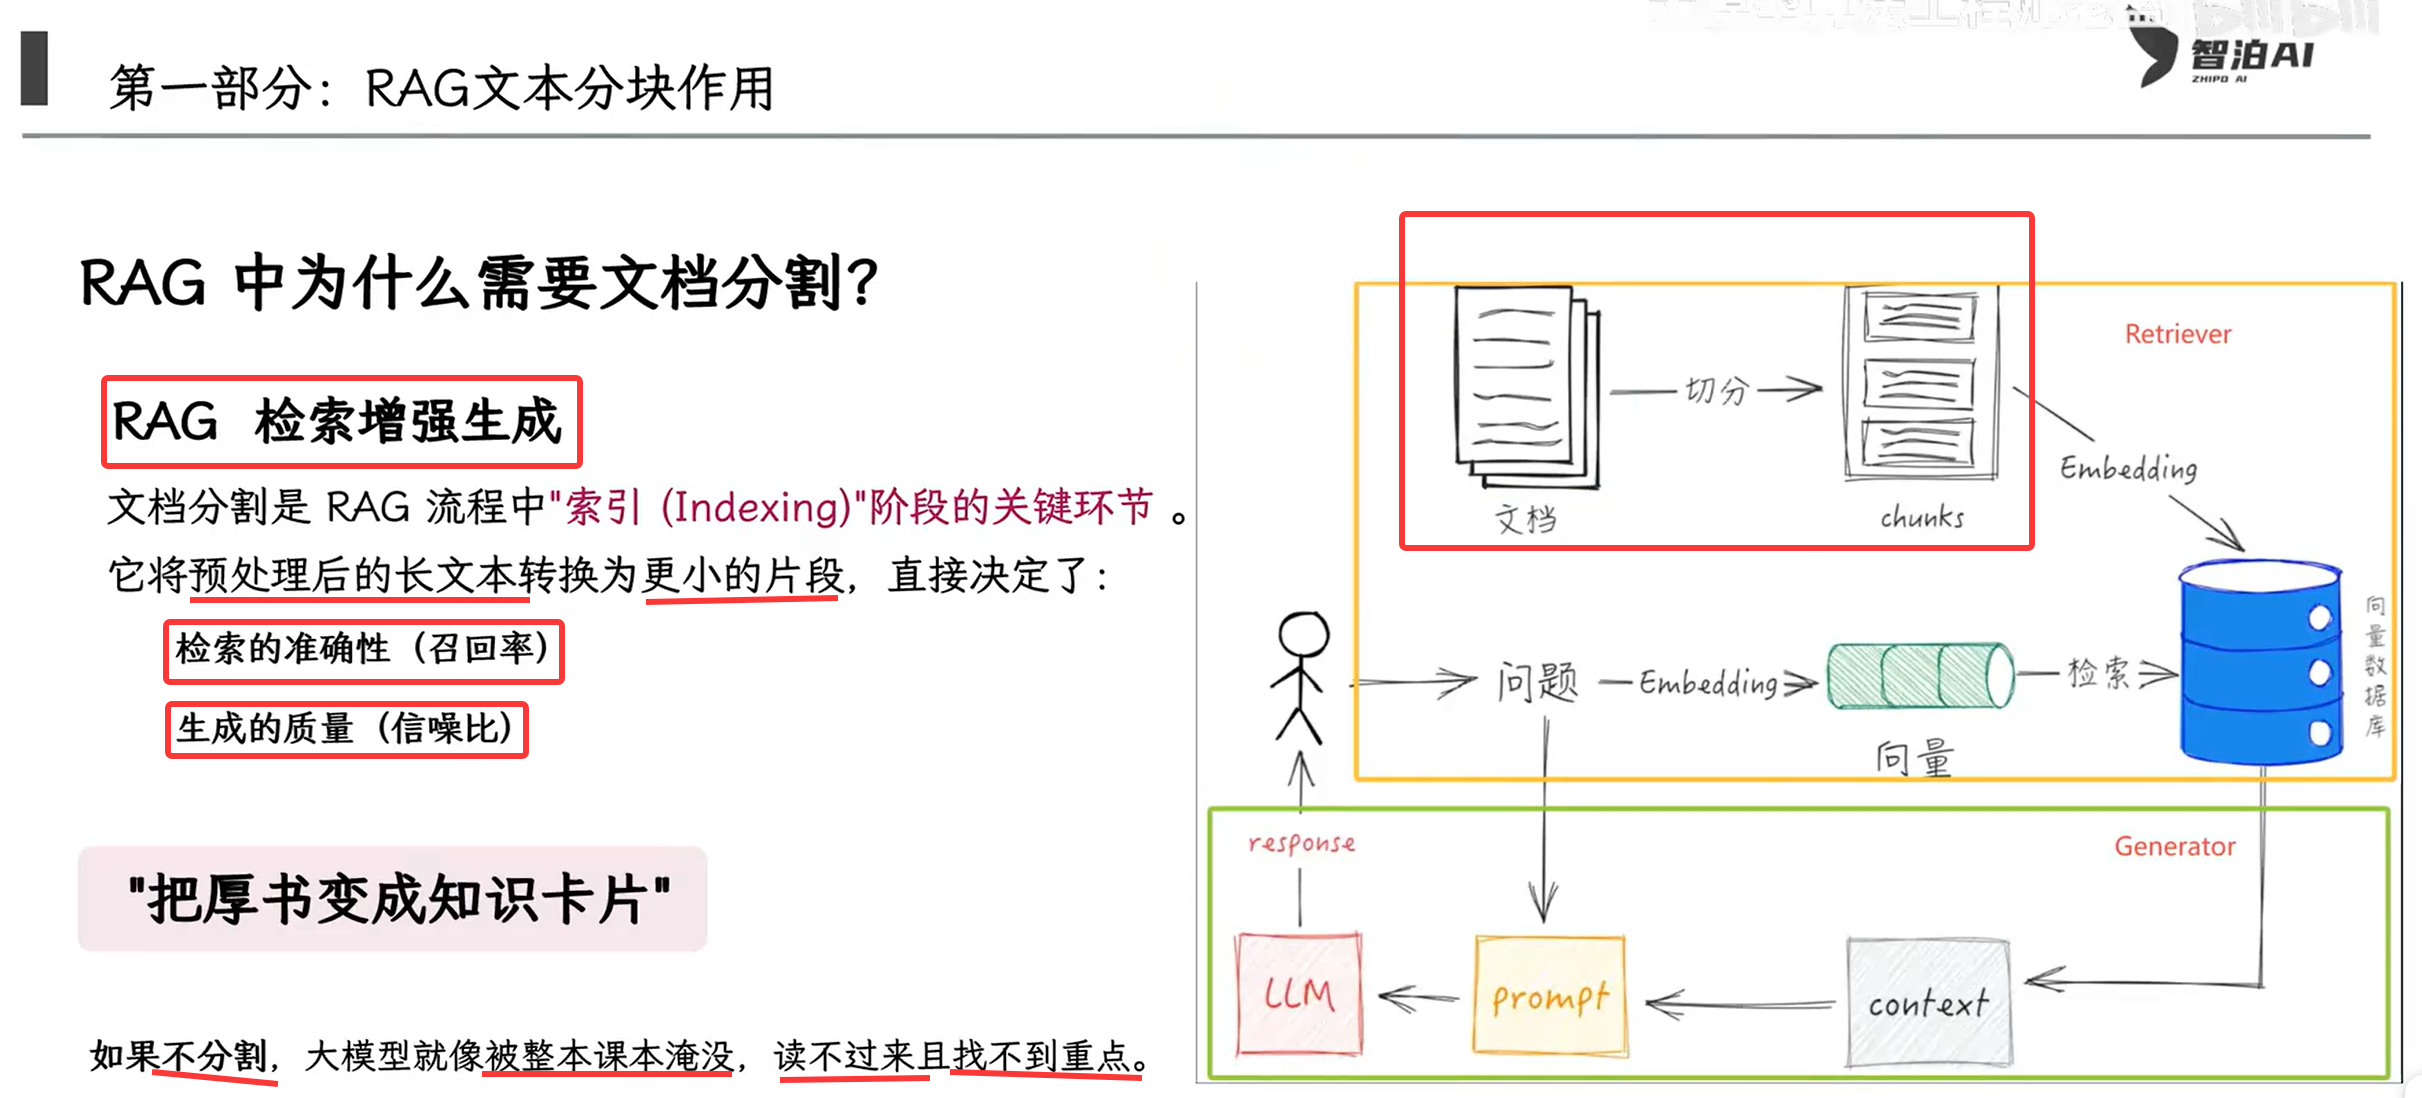
4.2 文本分块的方式
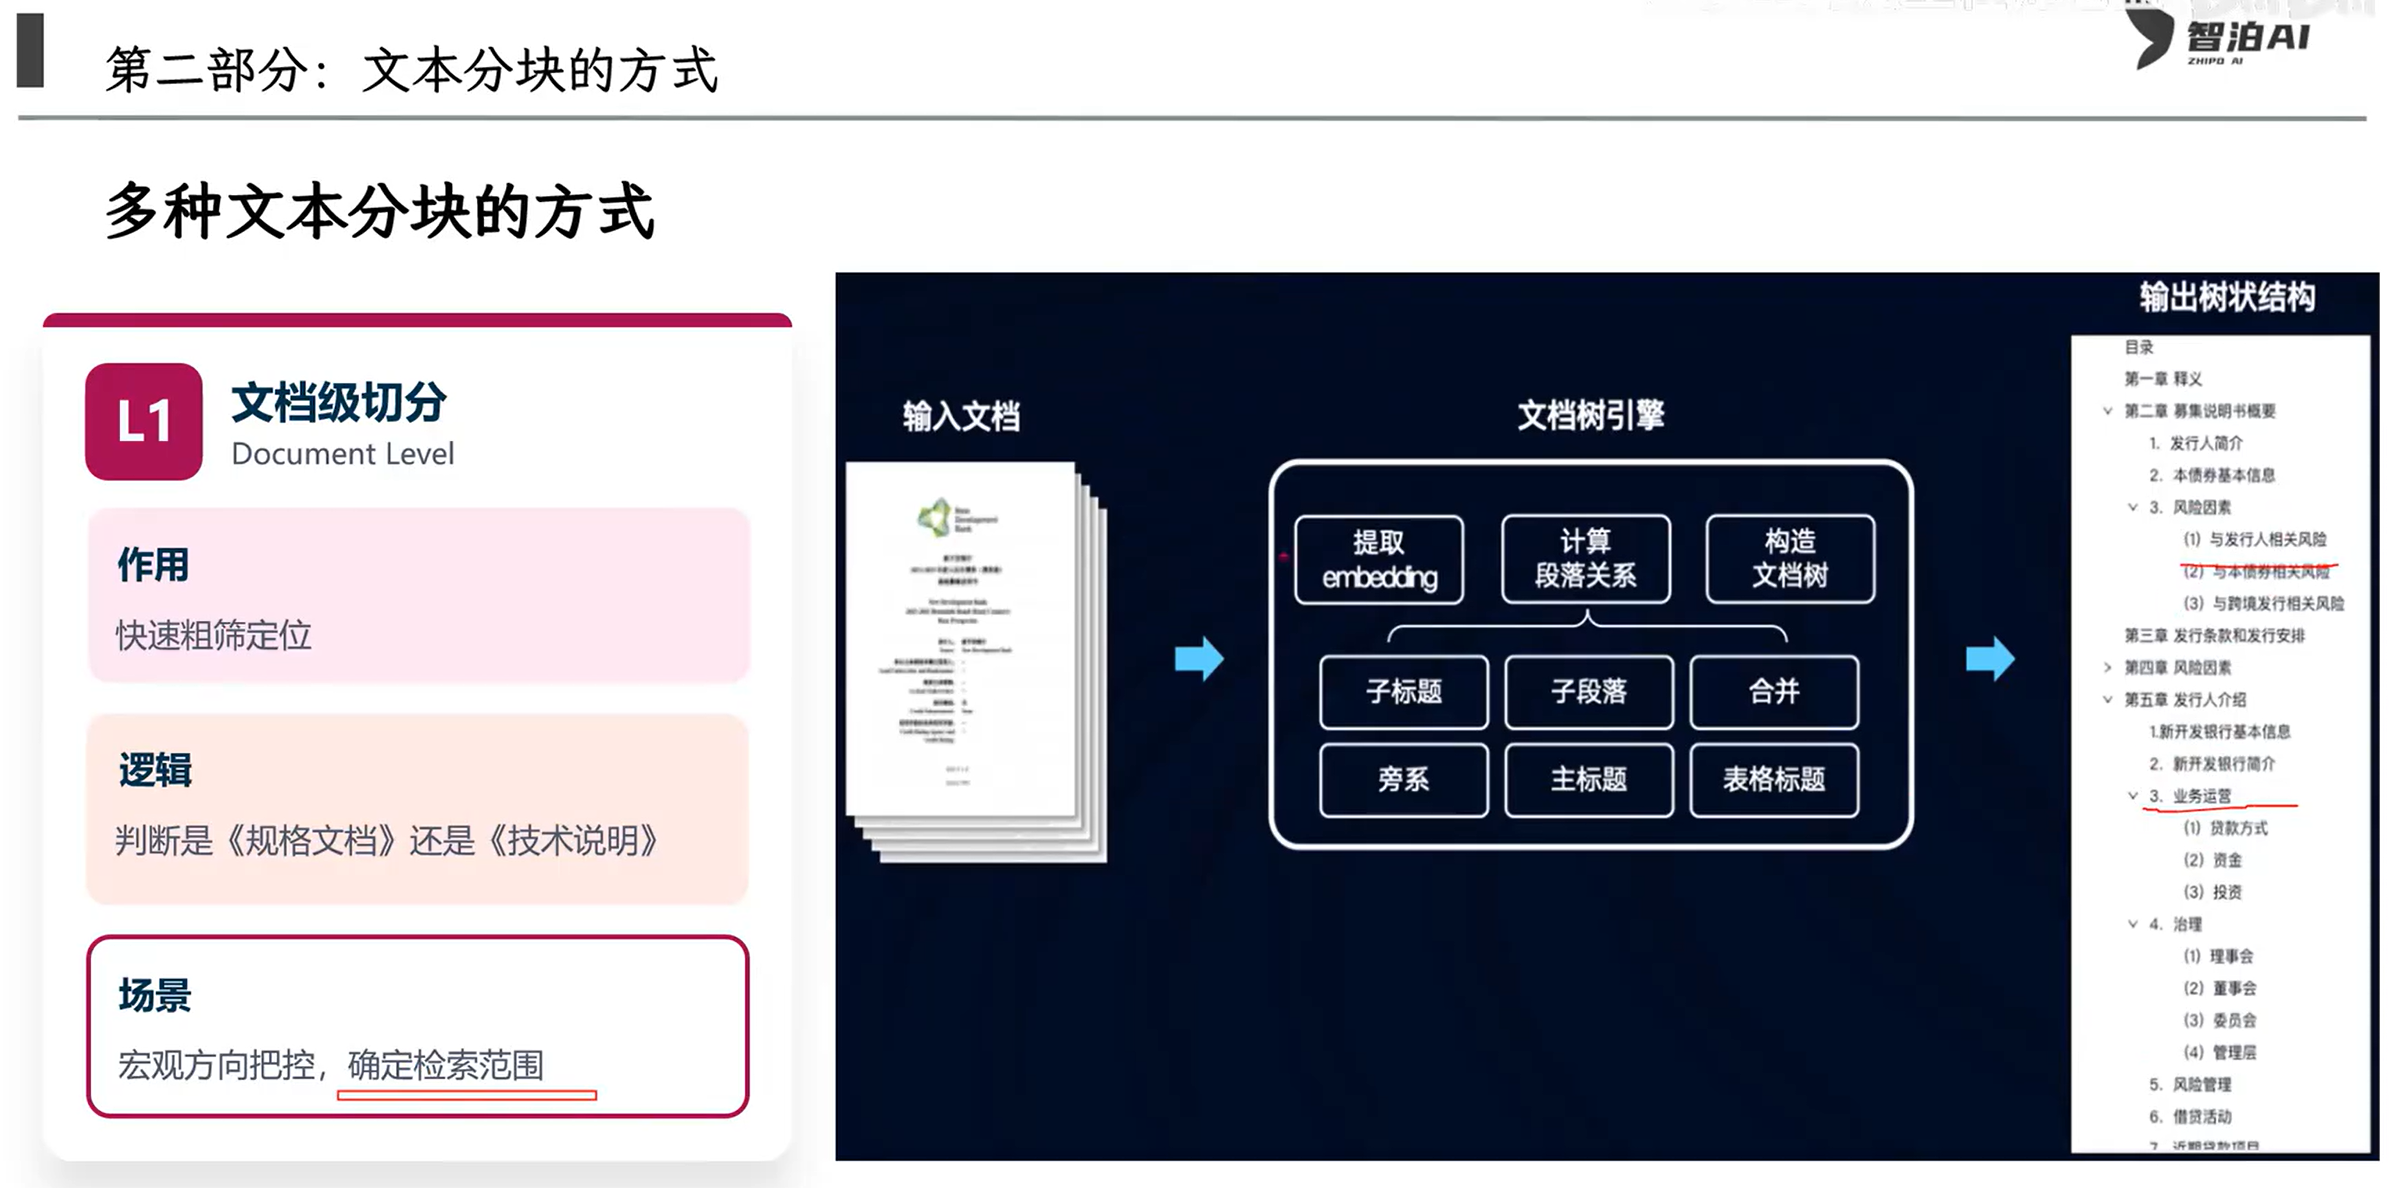
多粒度索引与递归字符分割
方法一:文档级切分
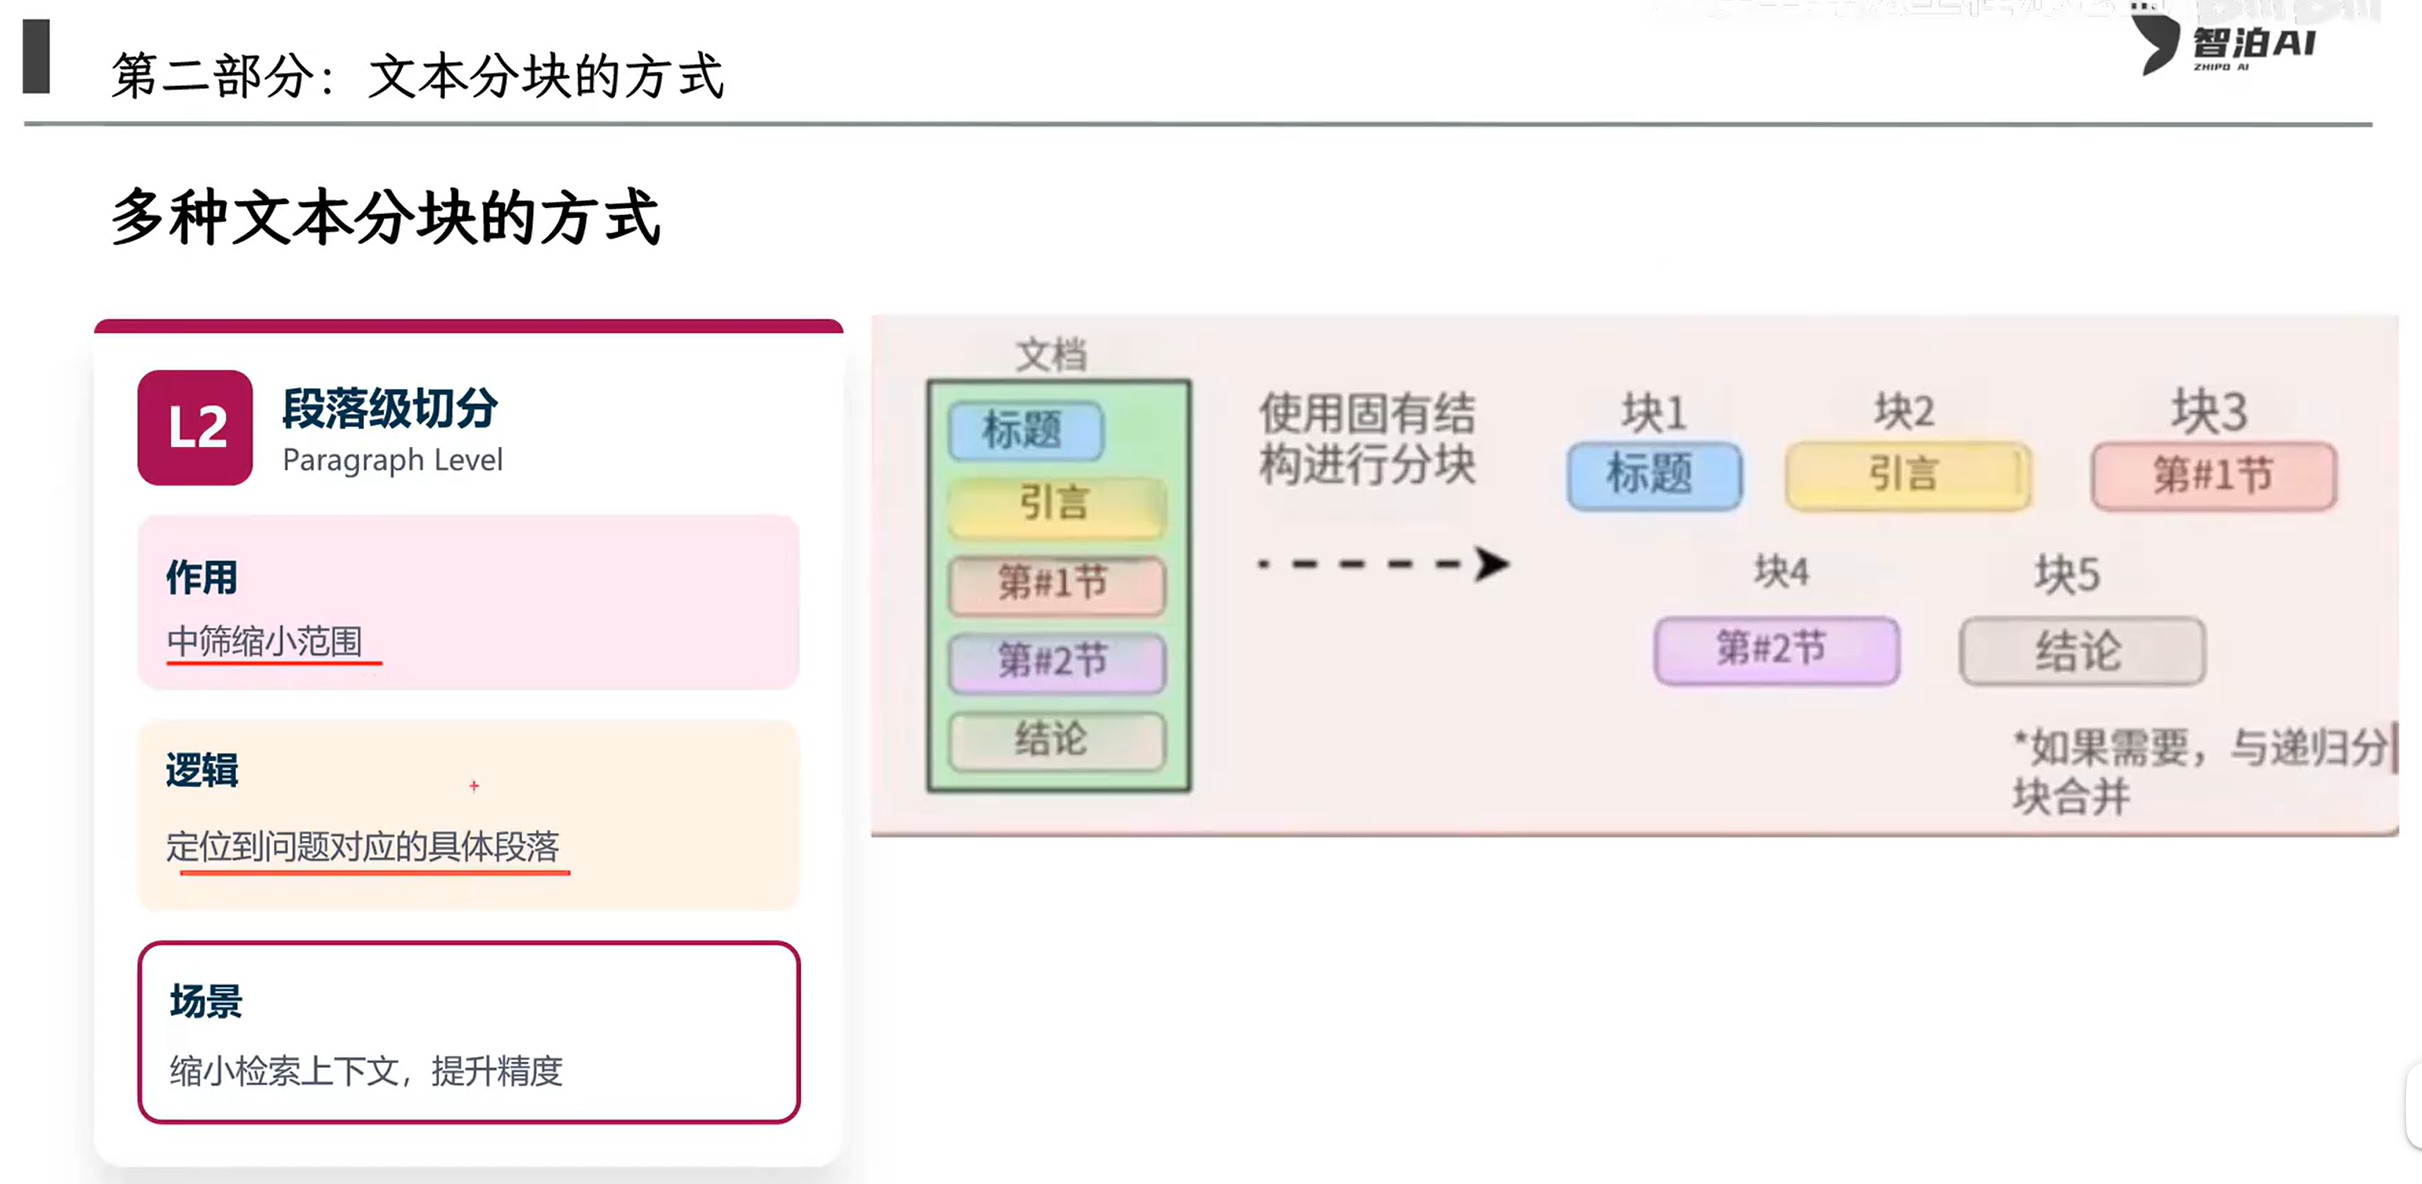
方法二:段落级切分 缩小检索字数,提高精度
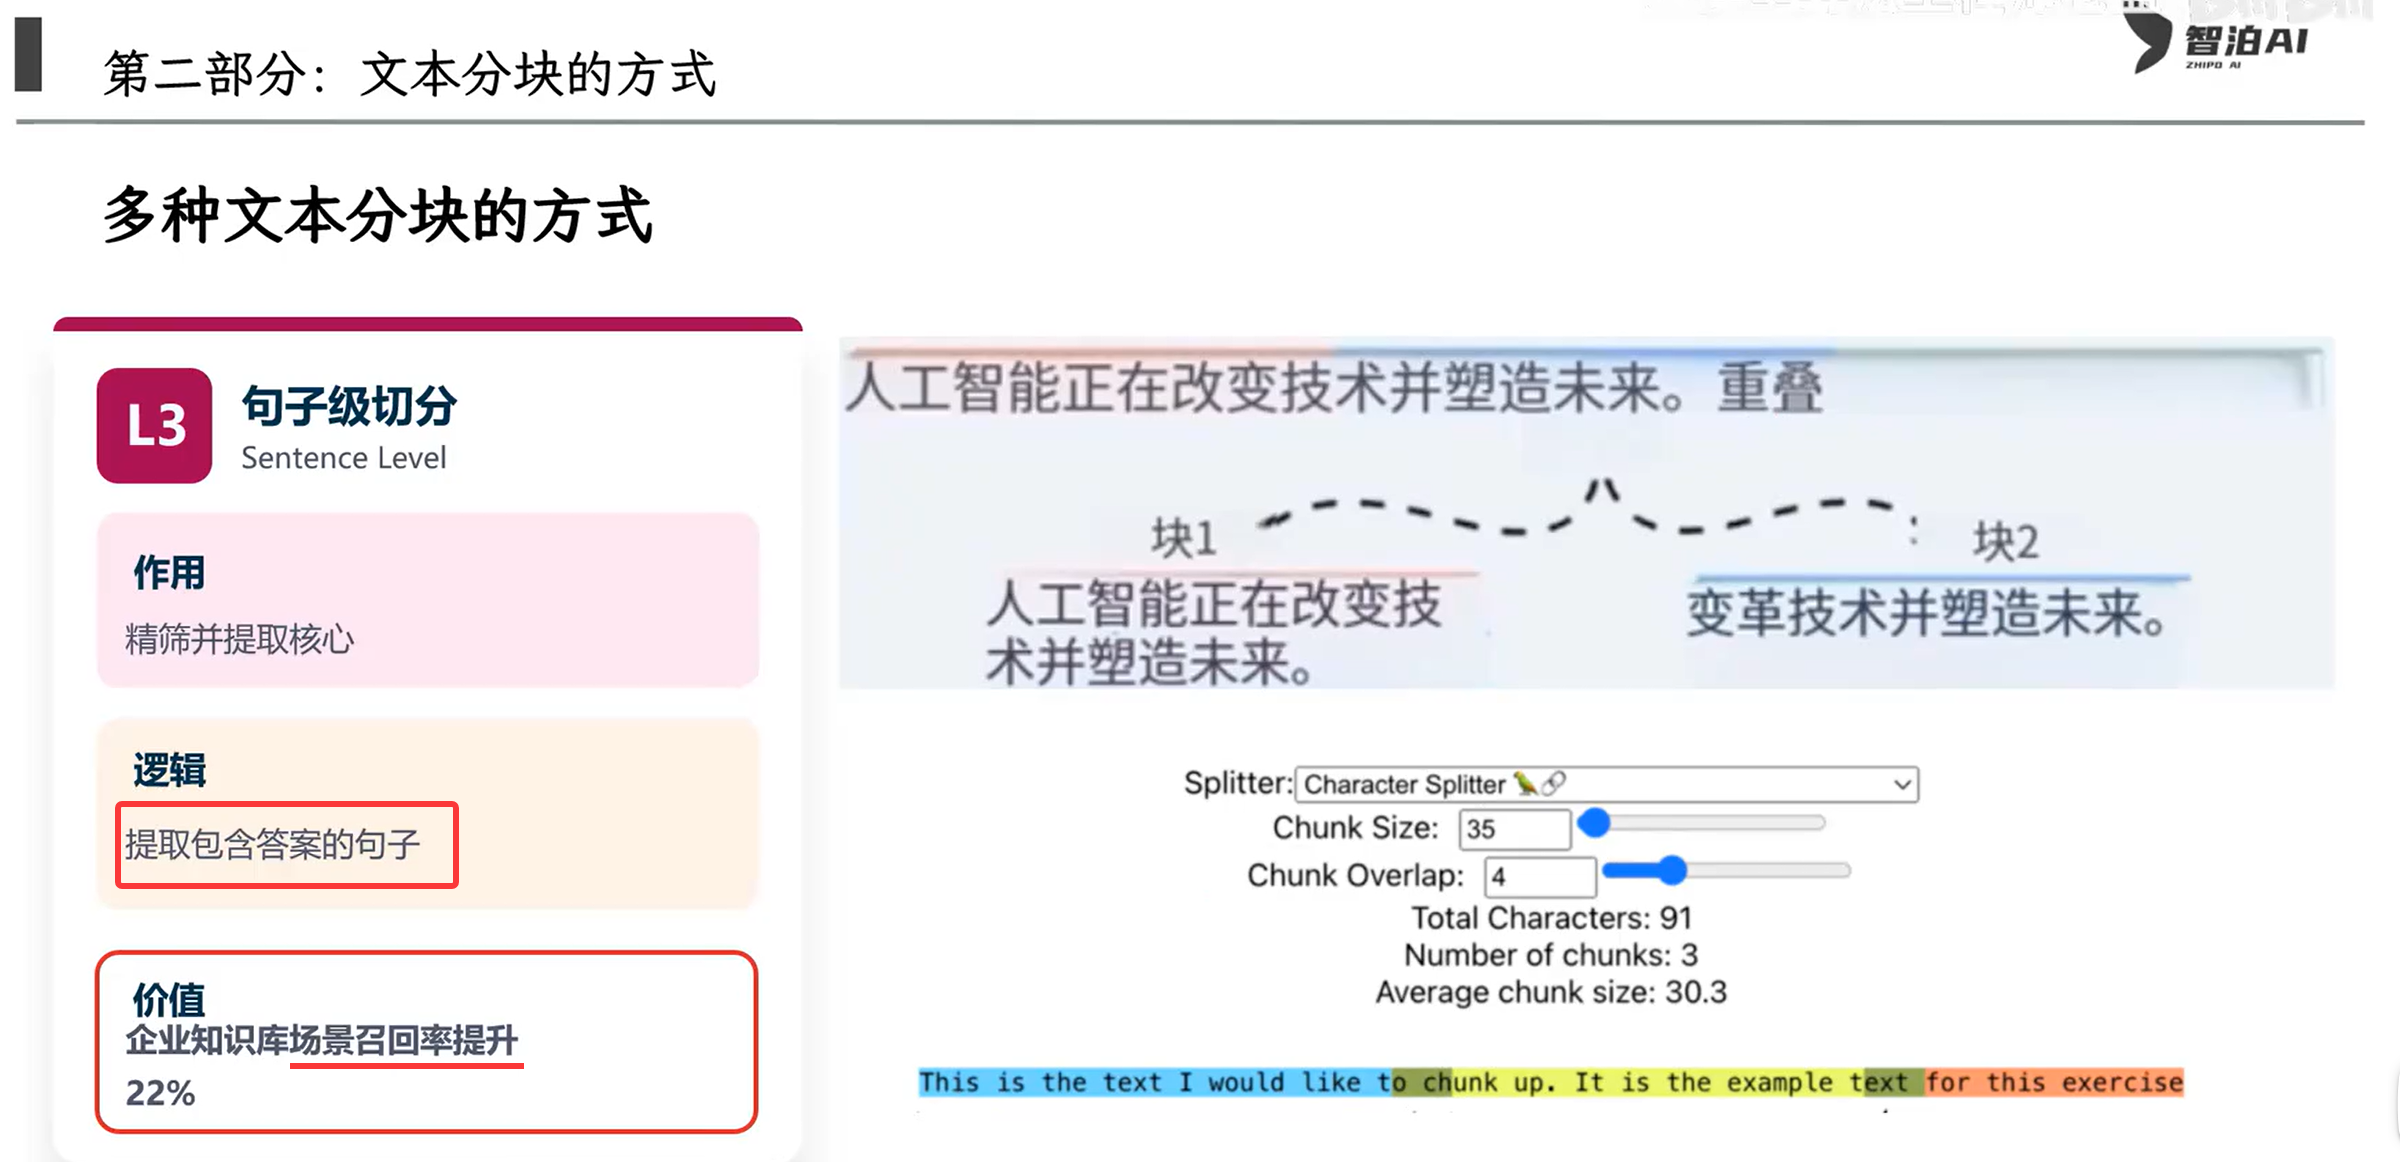
方法三:多种文本分块的方式 提取包含答案的句子
4.3 高级分割策略
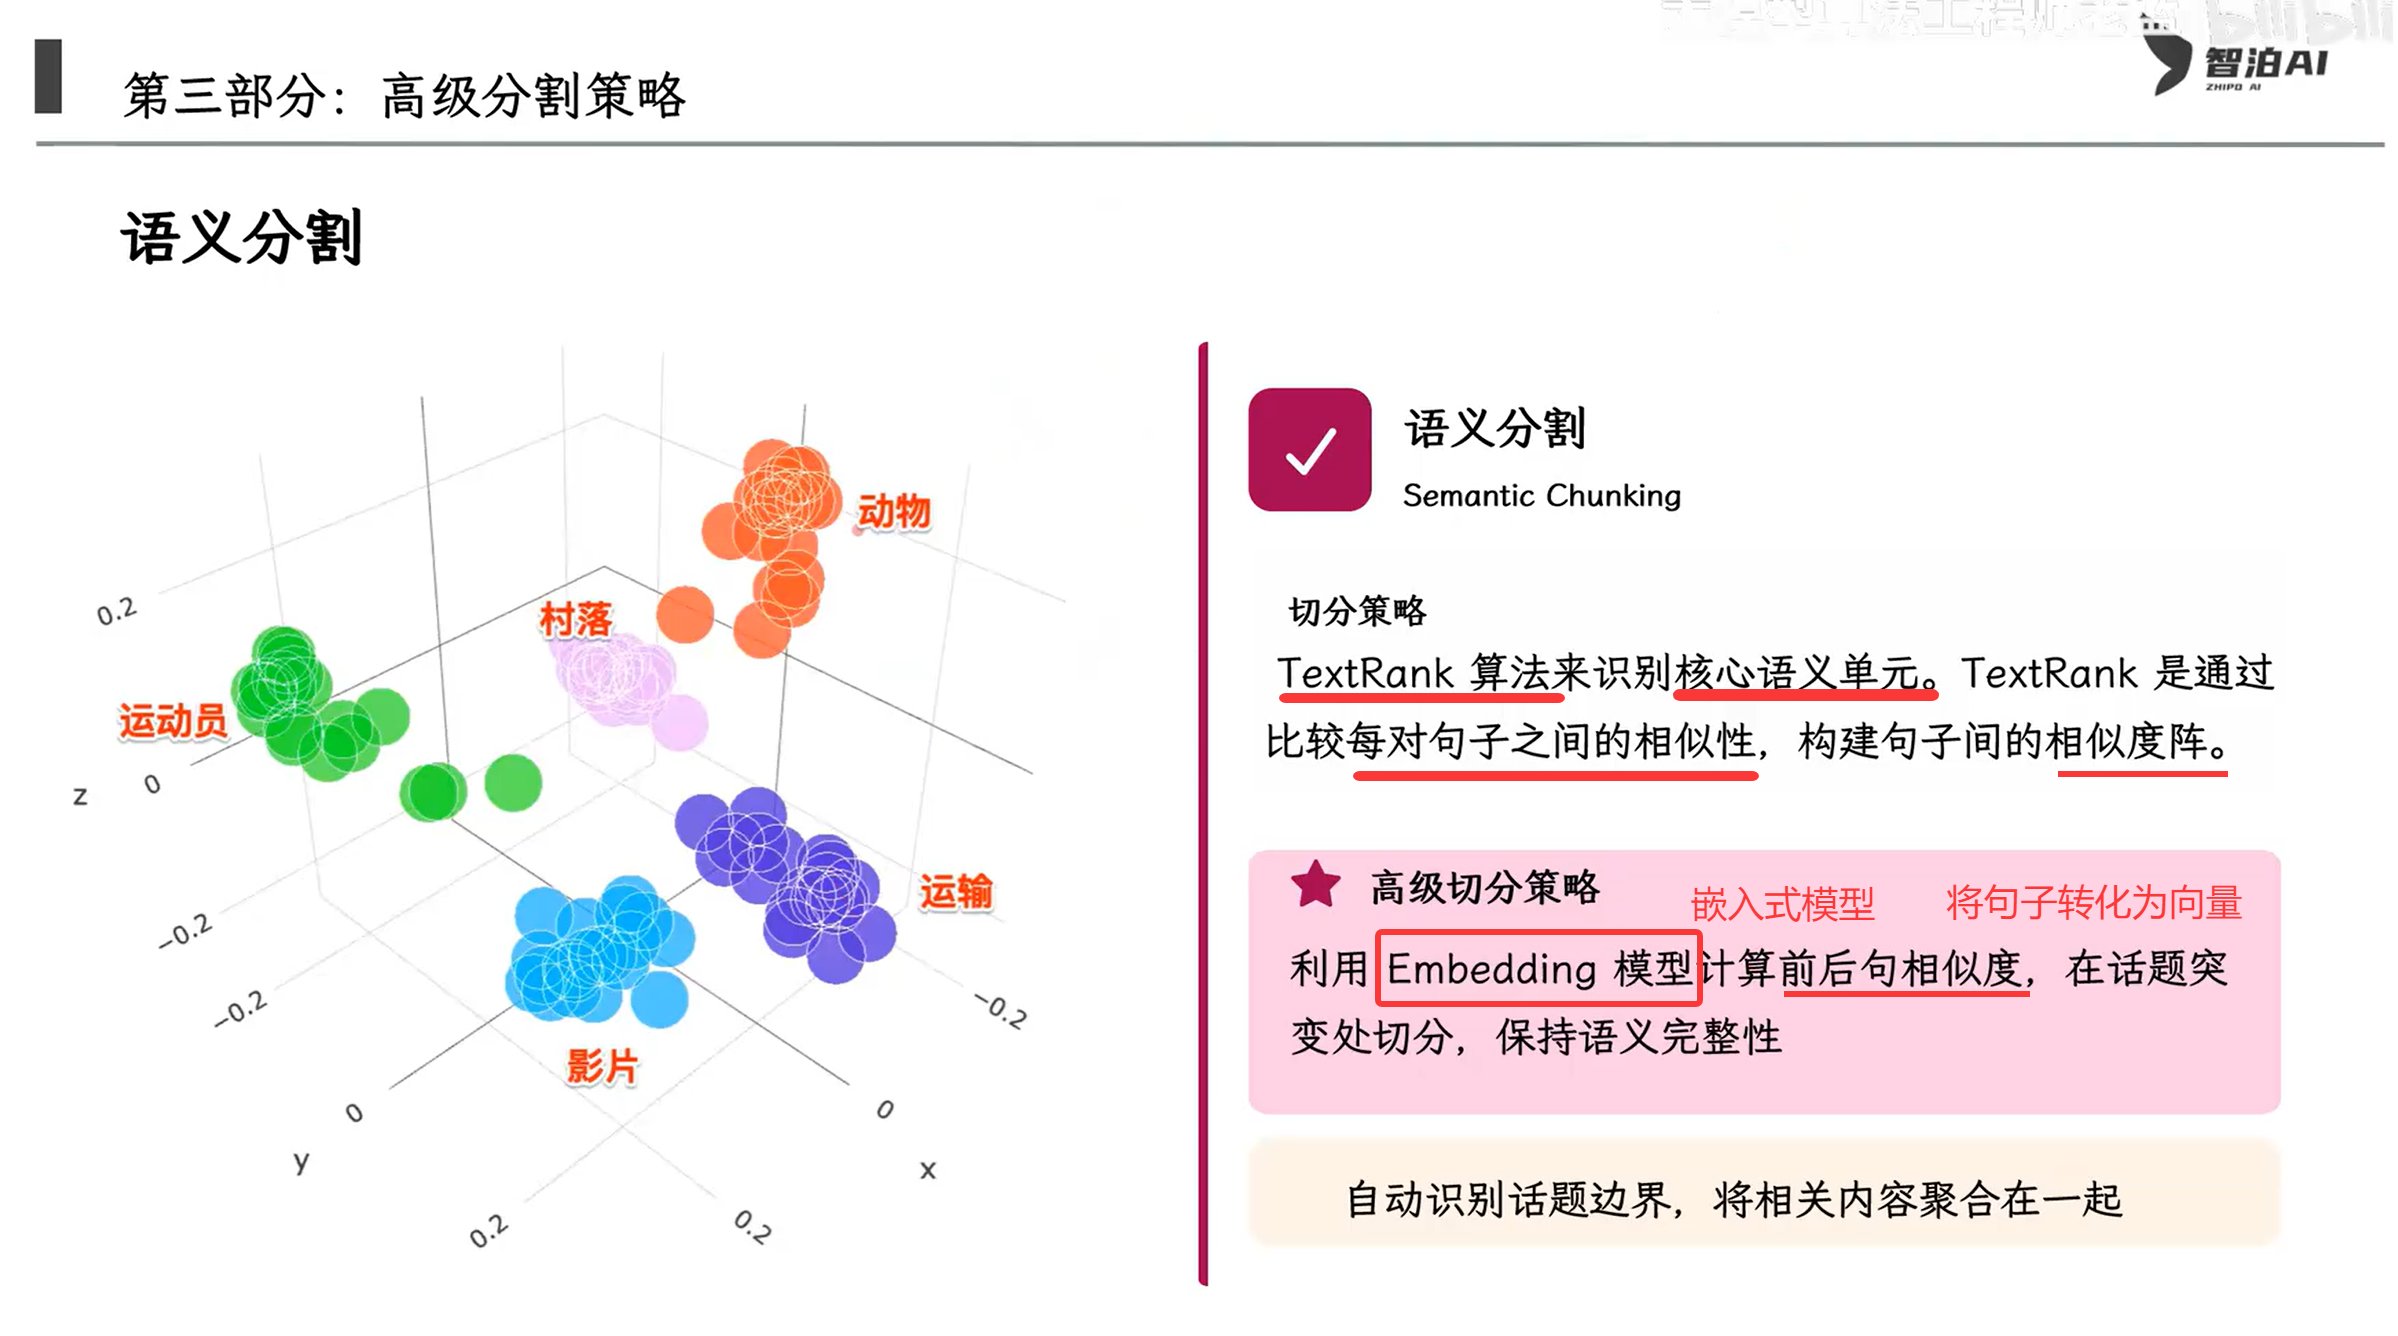
语义分割算法与表格处理
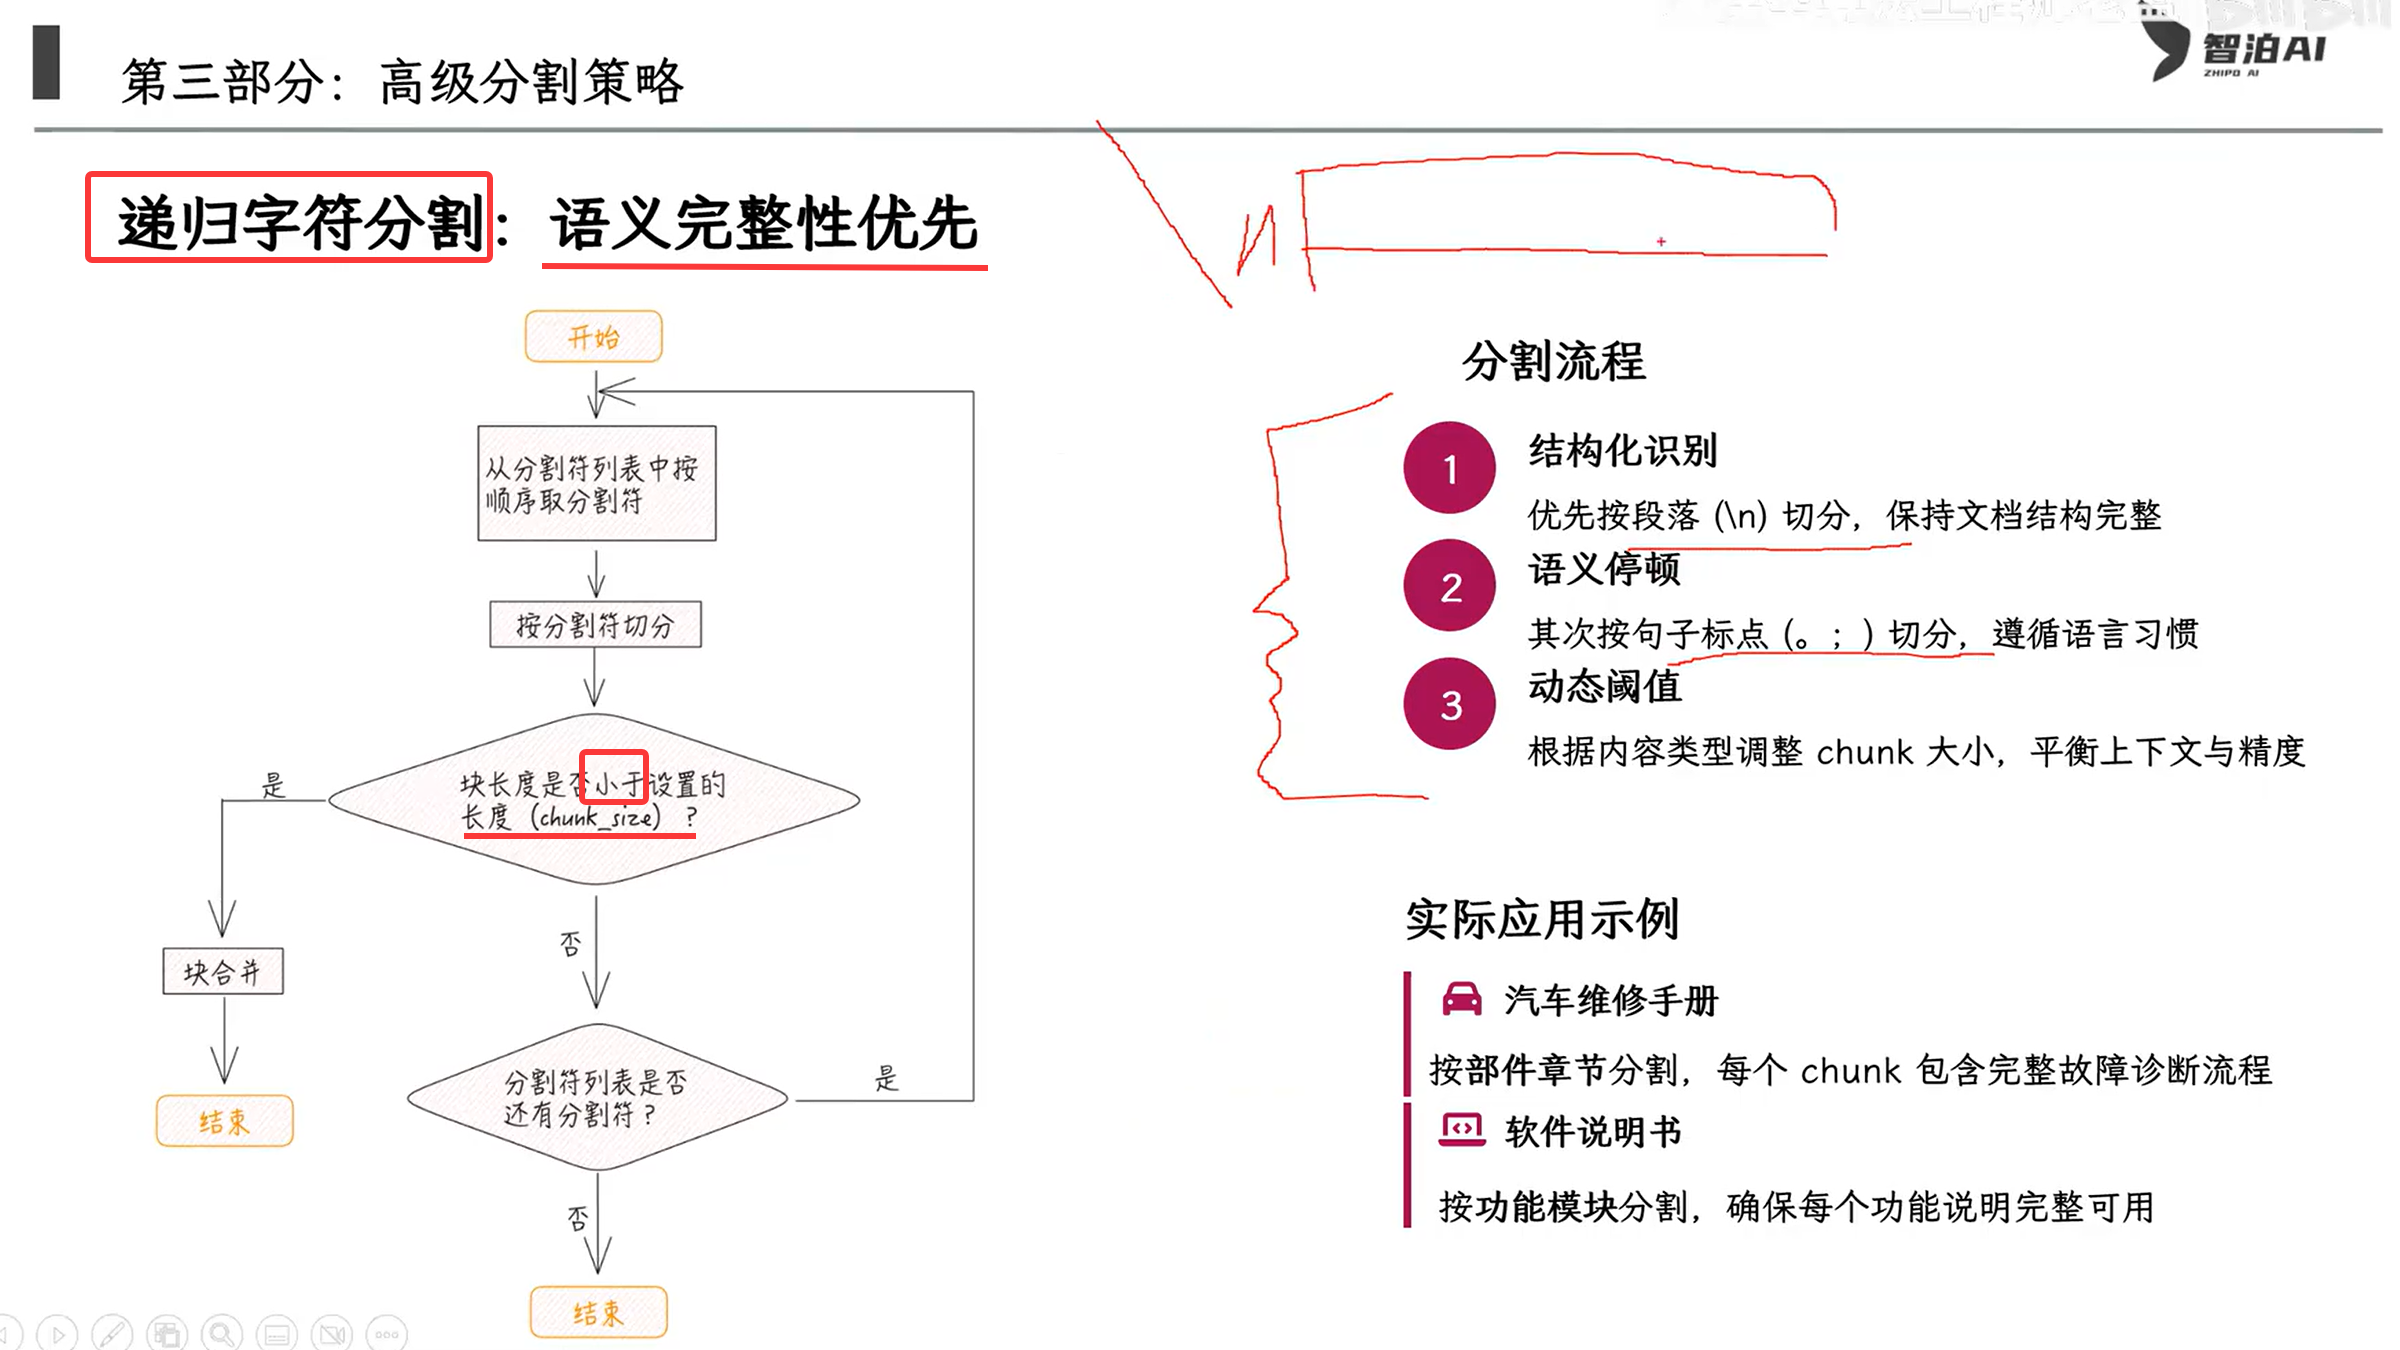
递归字符分割
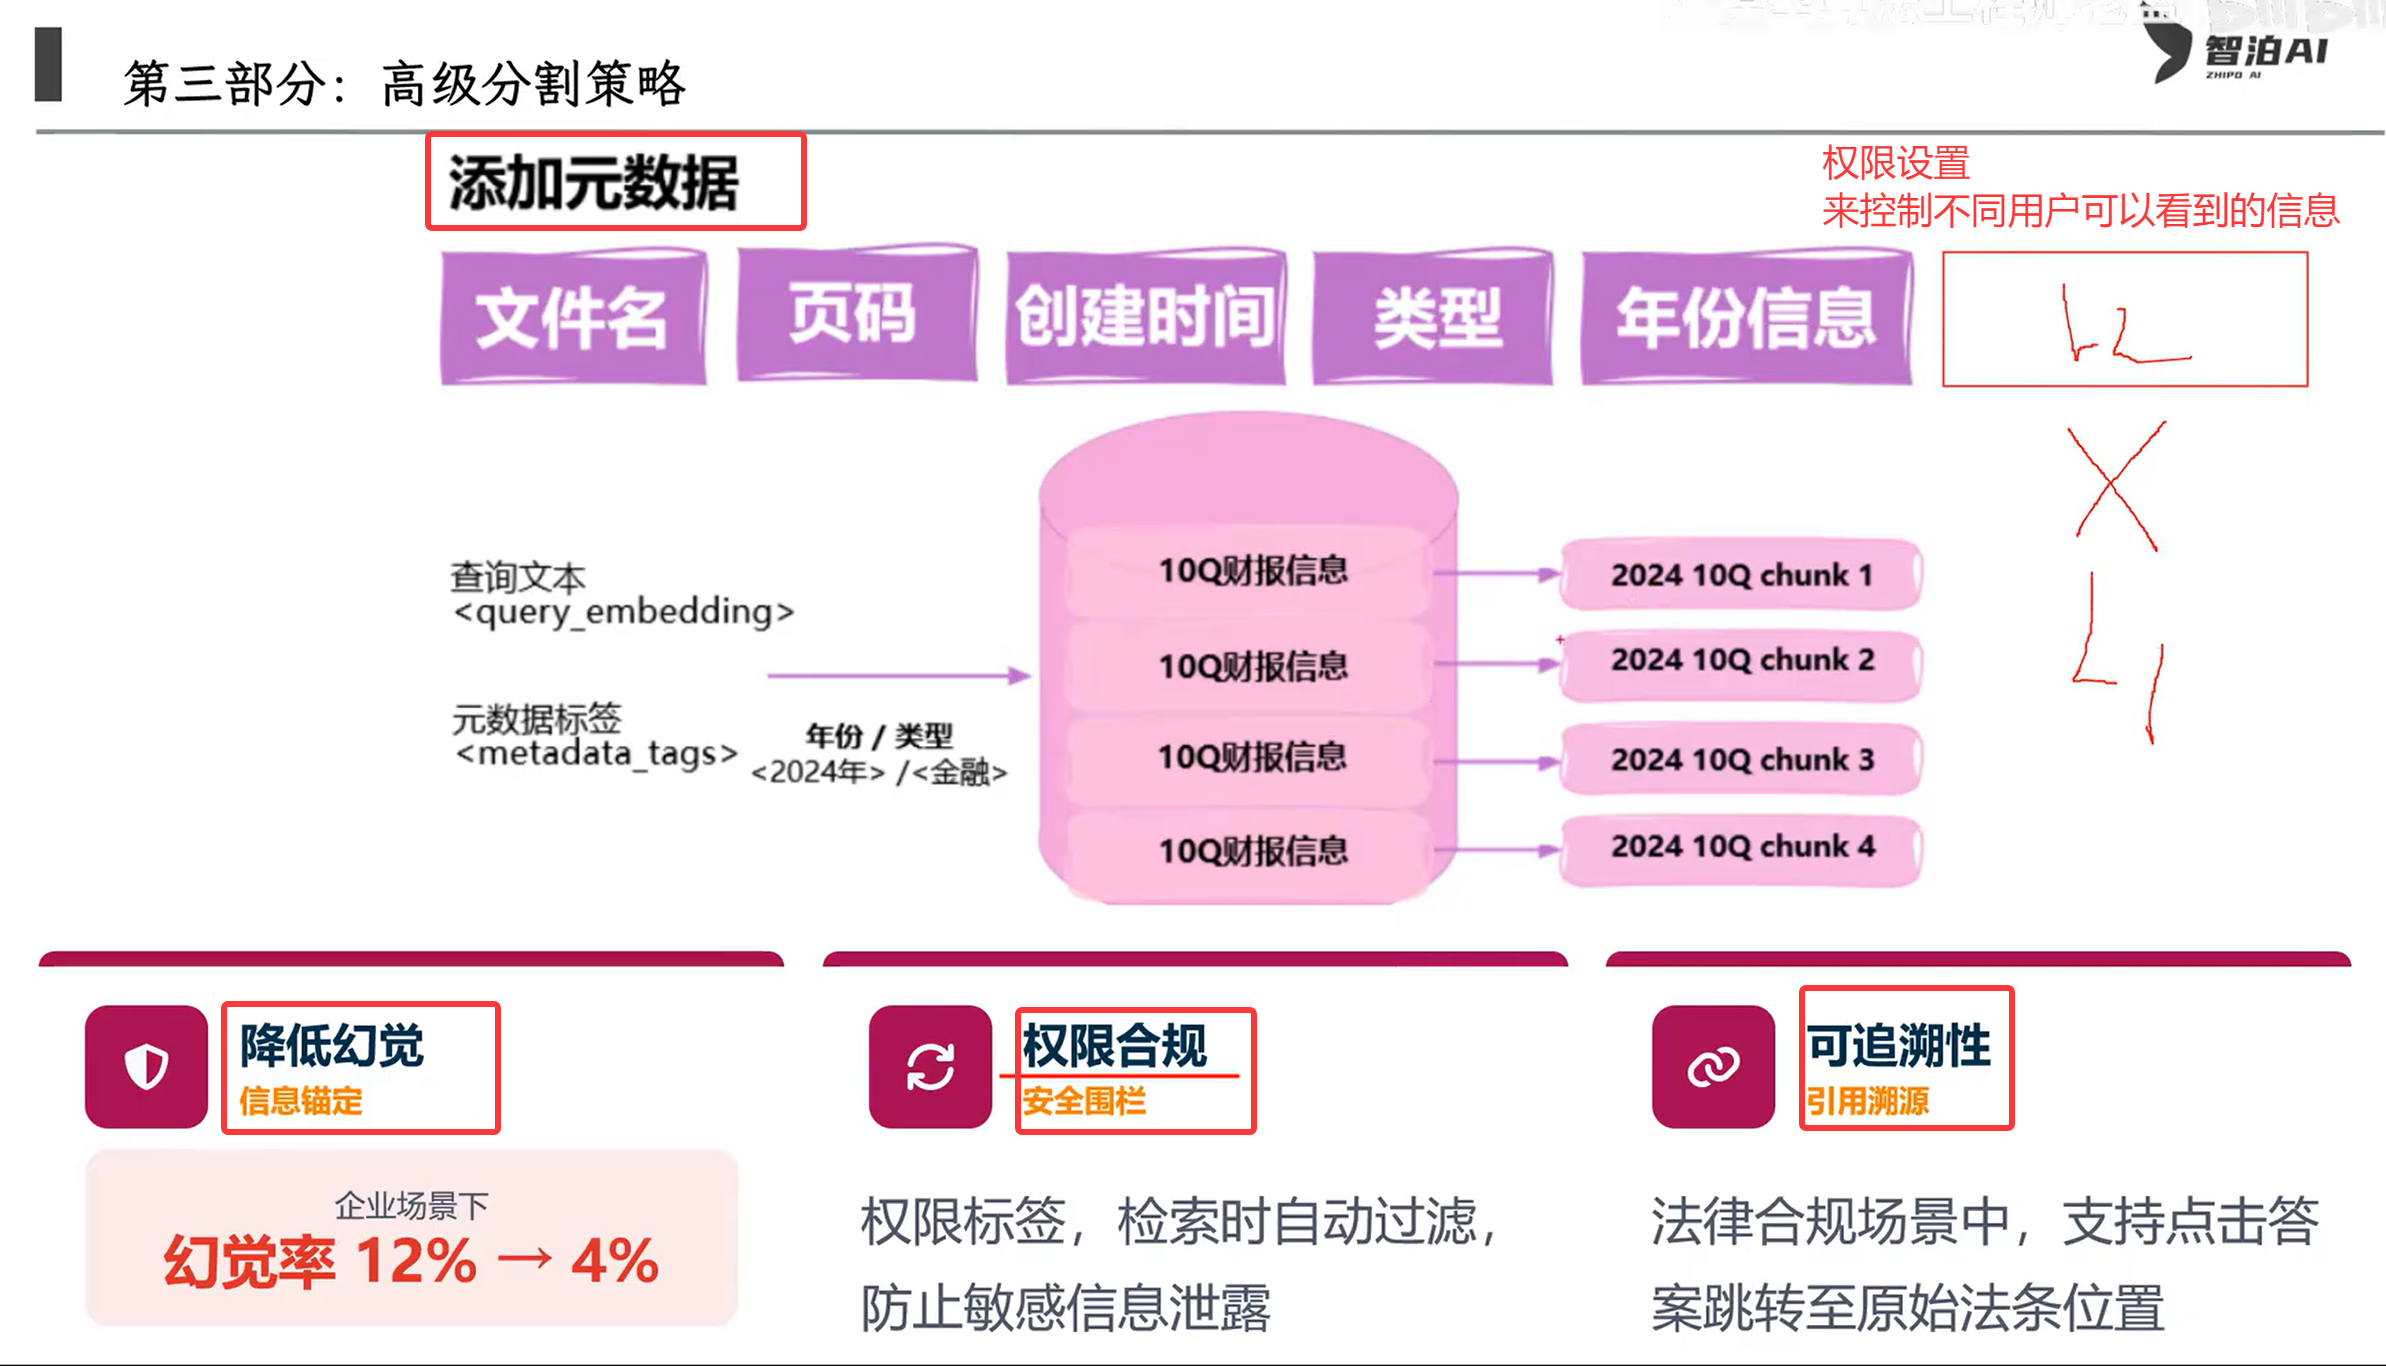
添加元数据
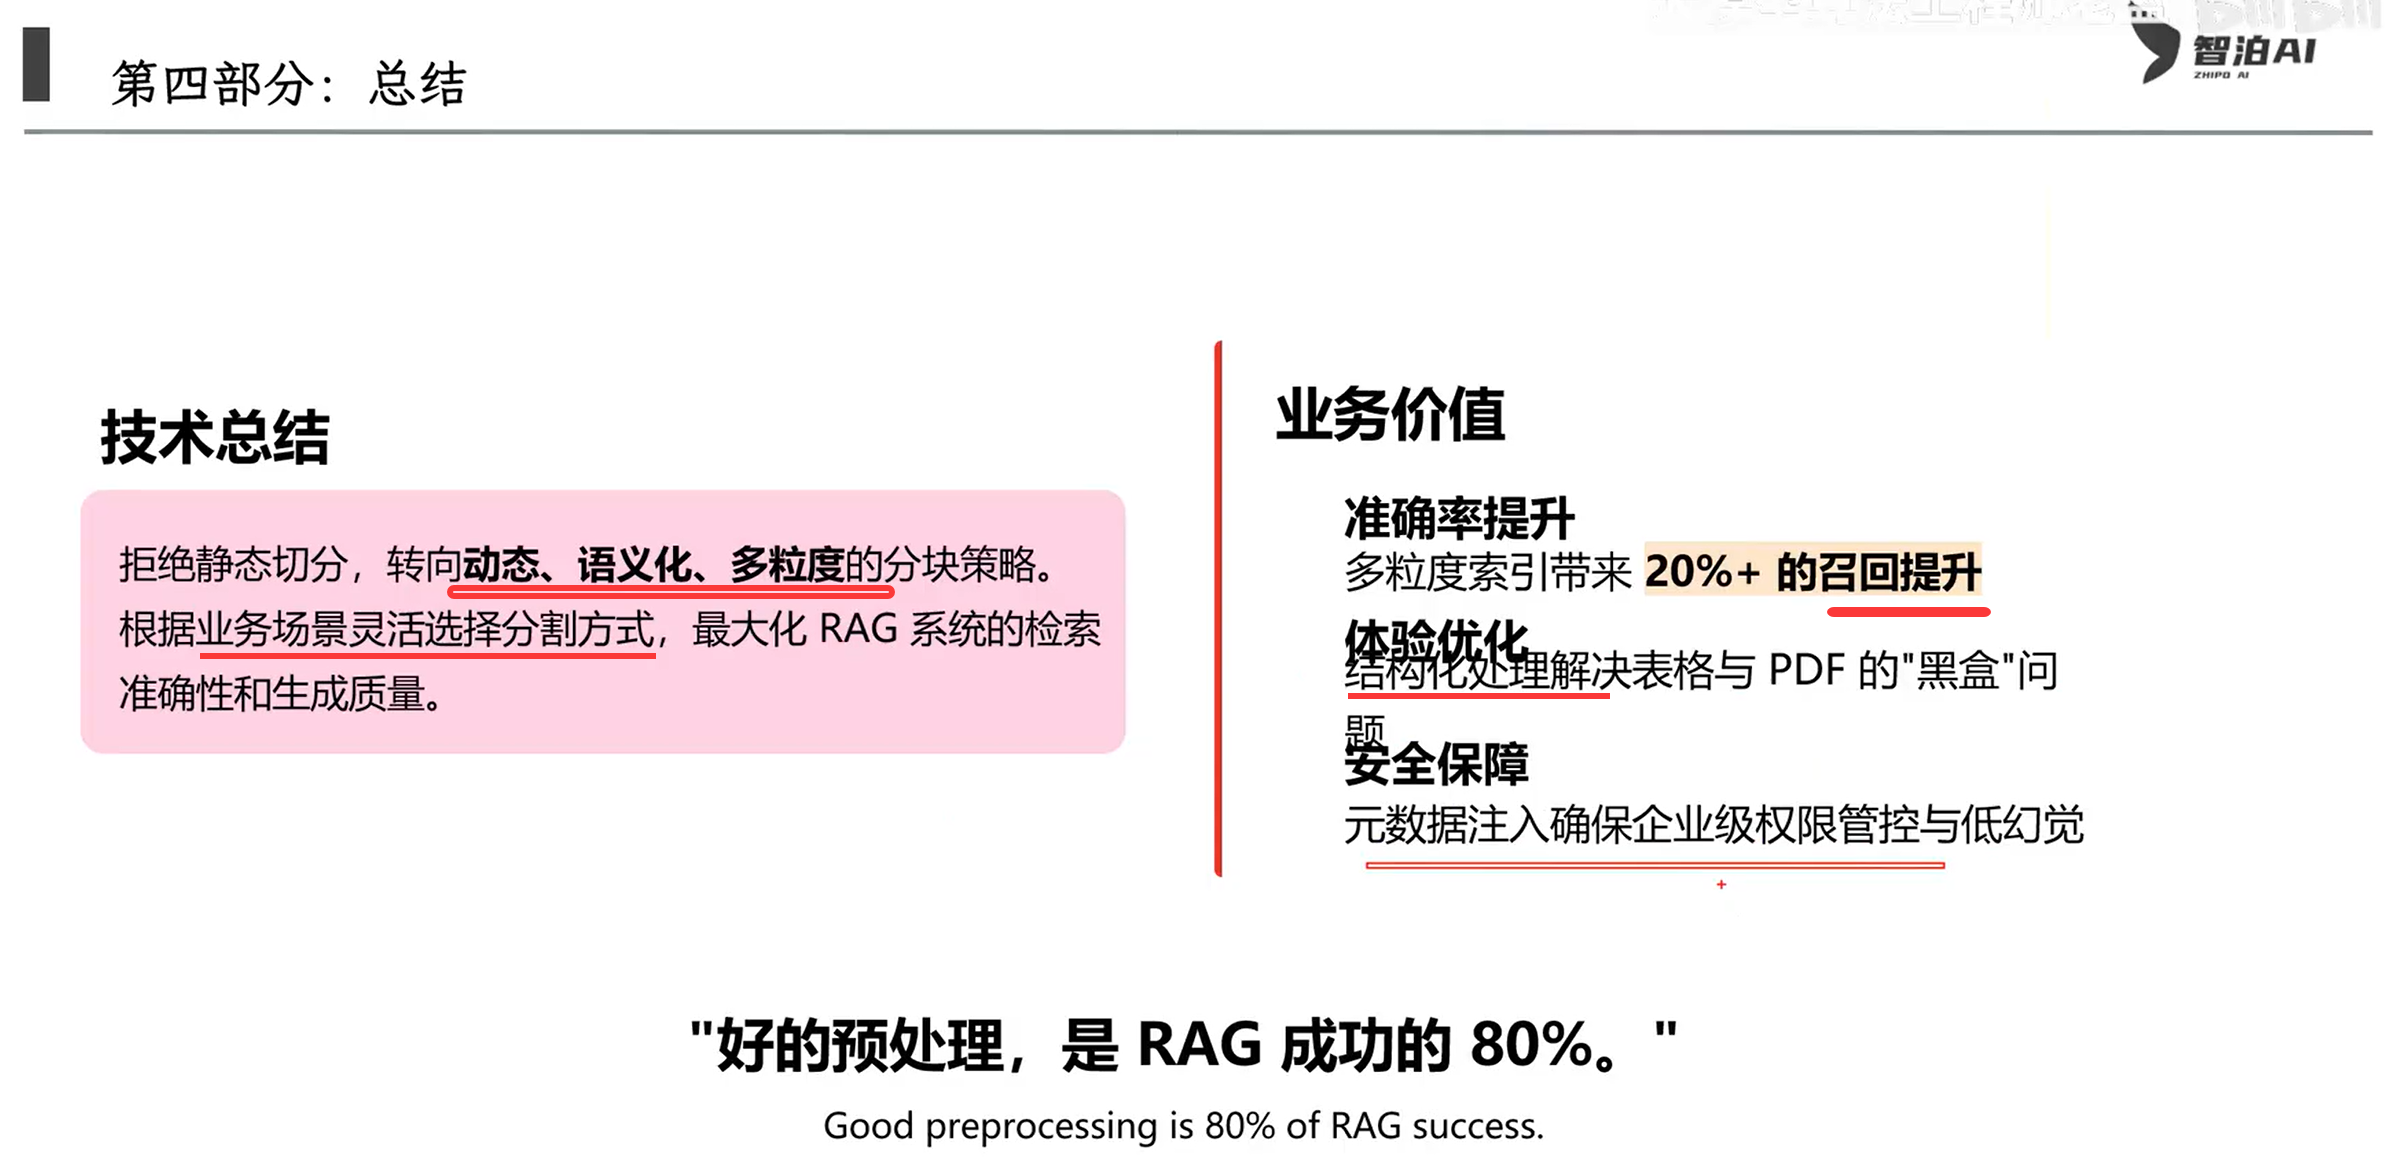
4.4 总结
元数据注入与商业防幻觉策略
五、RAG文本向量化
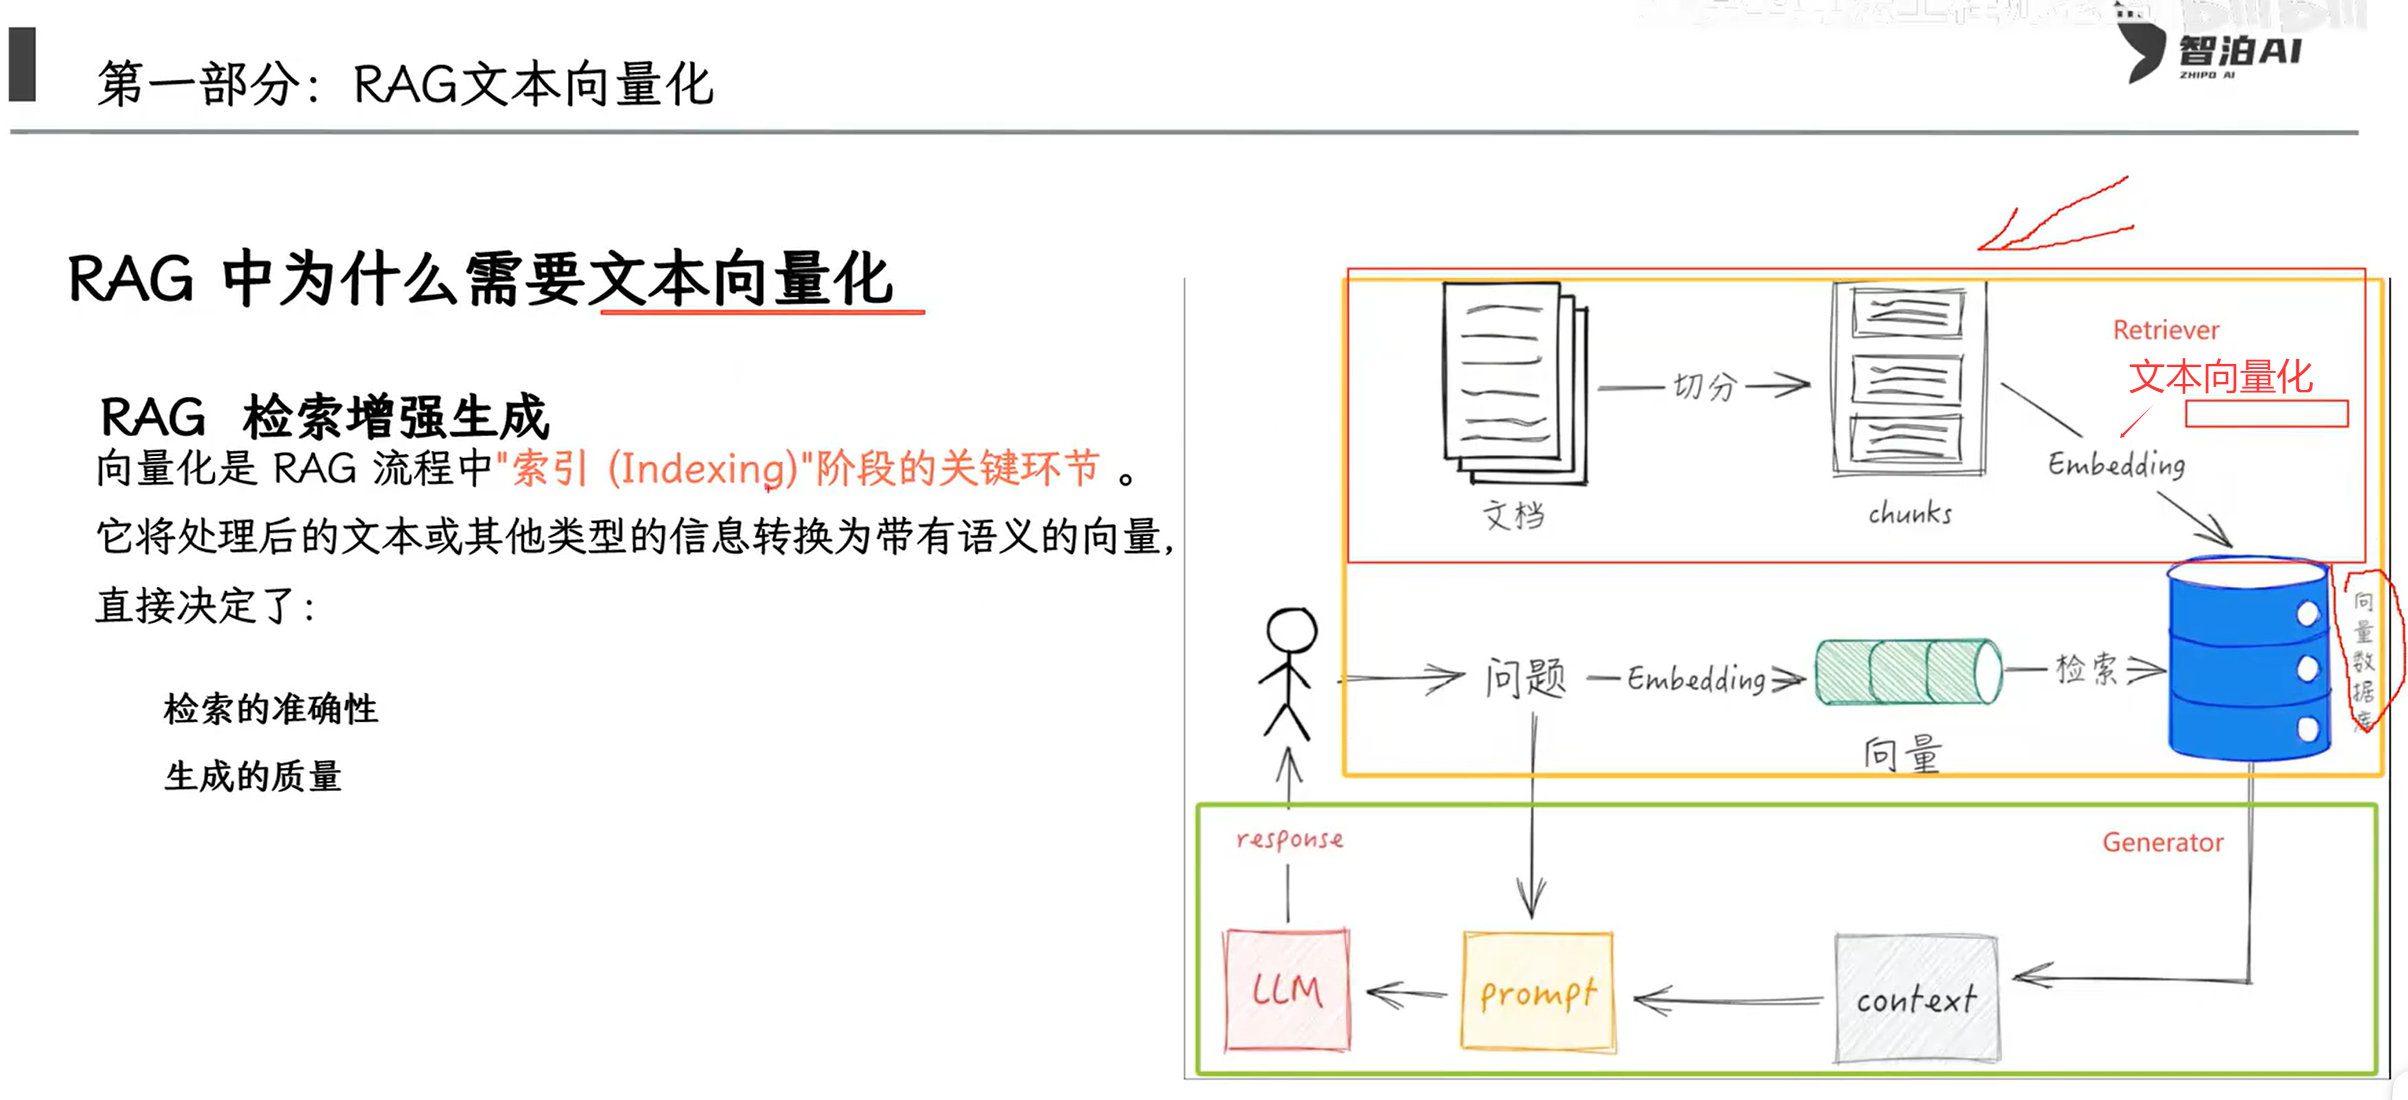
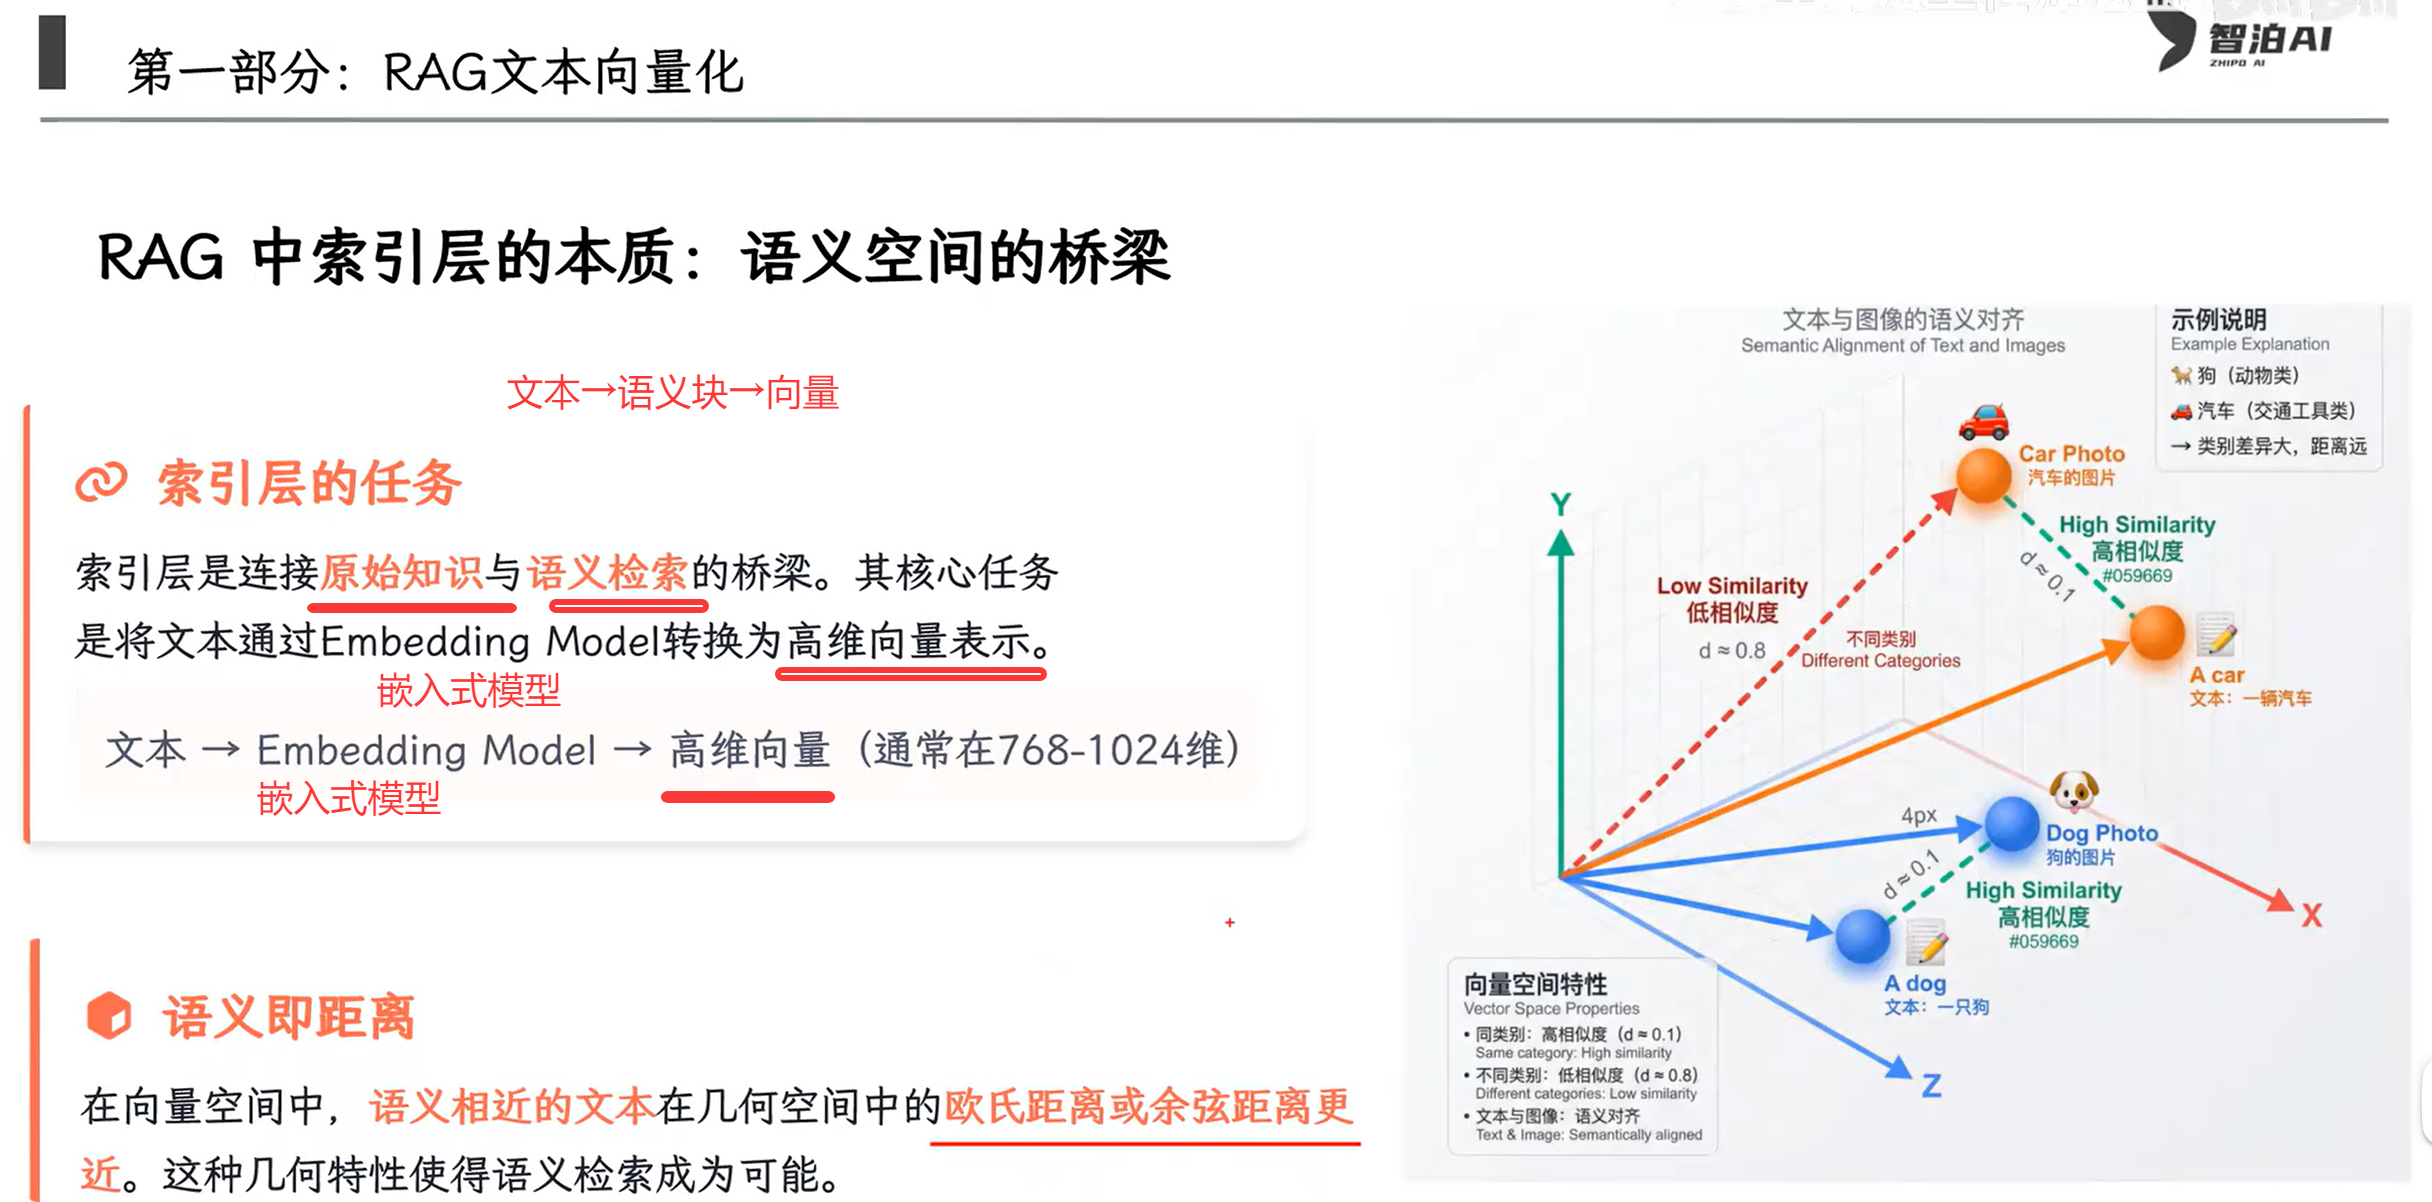
5.1 RAG文本向量化定义
RAG技术与文本向量化的作用
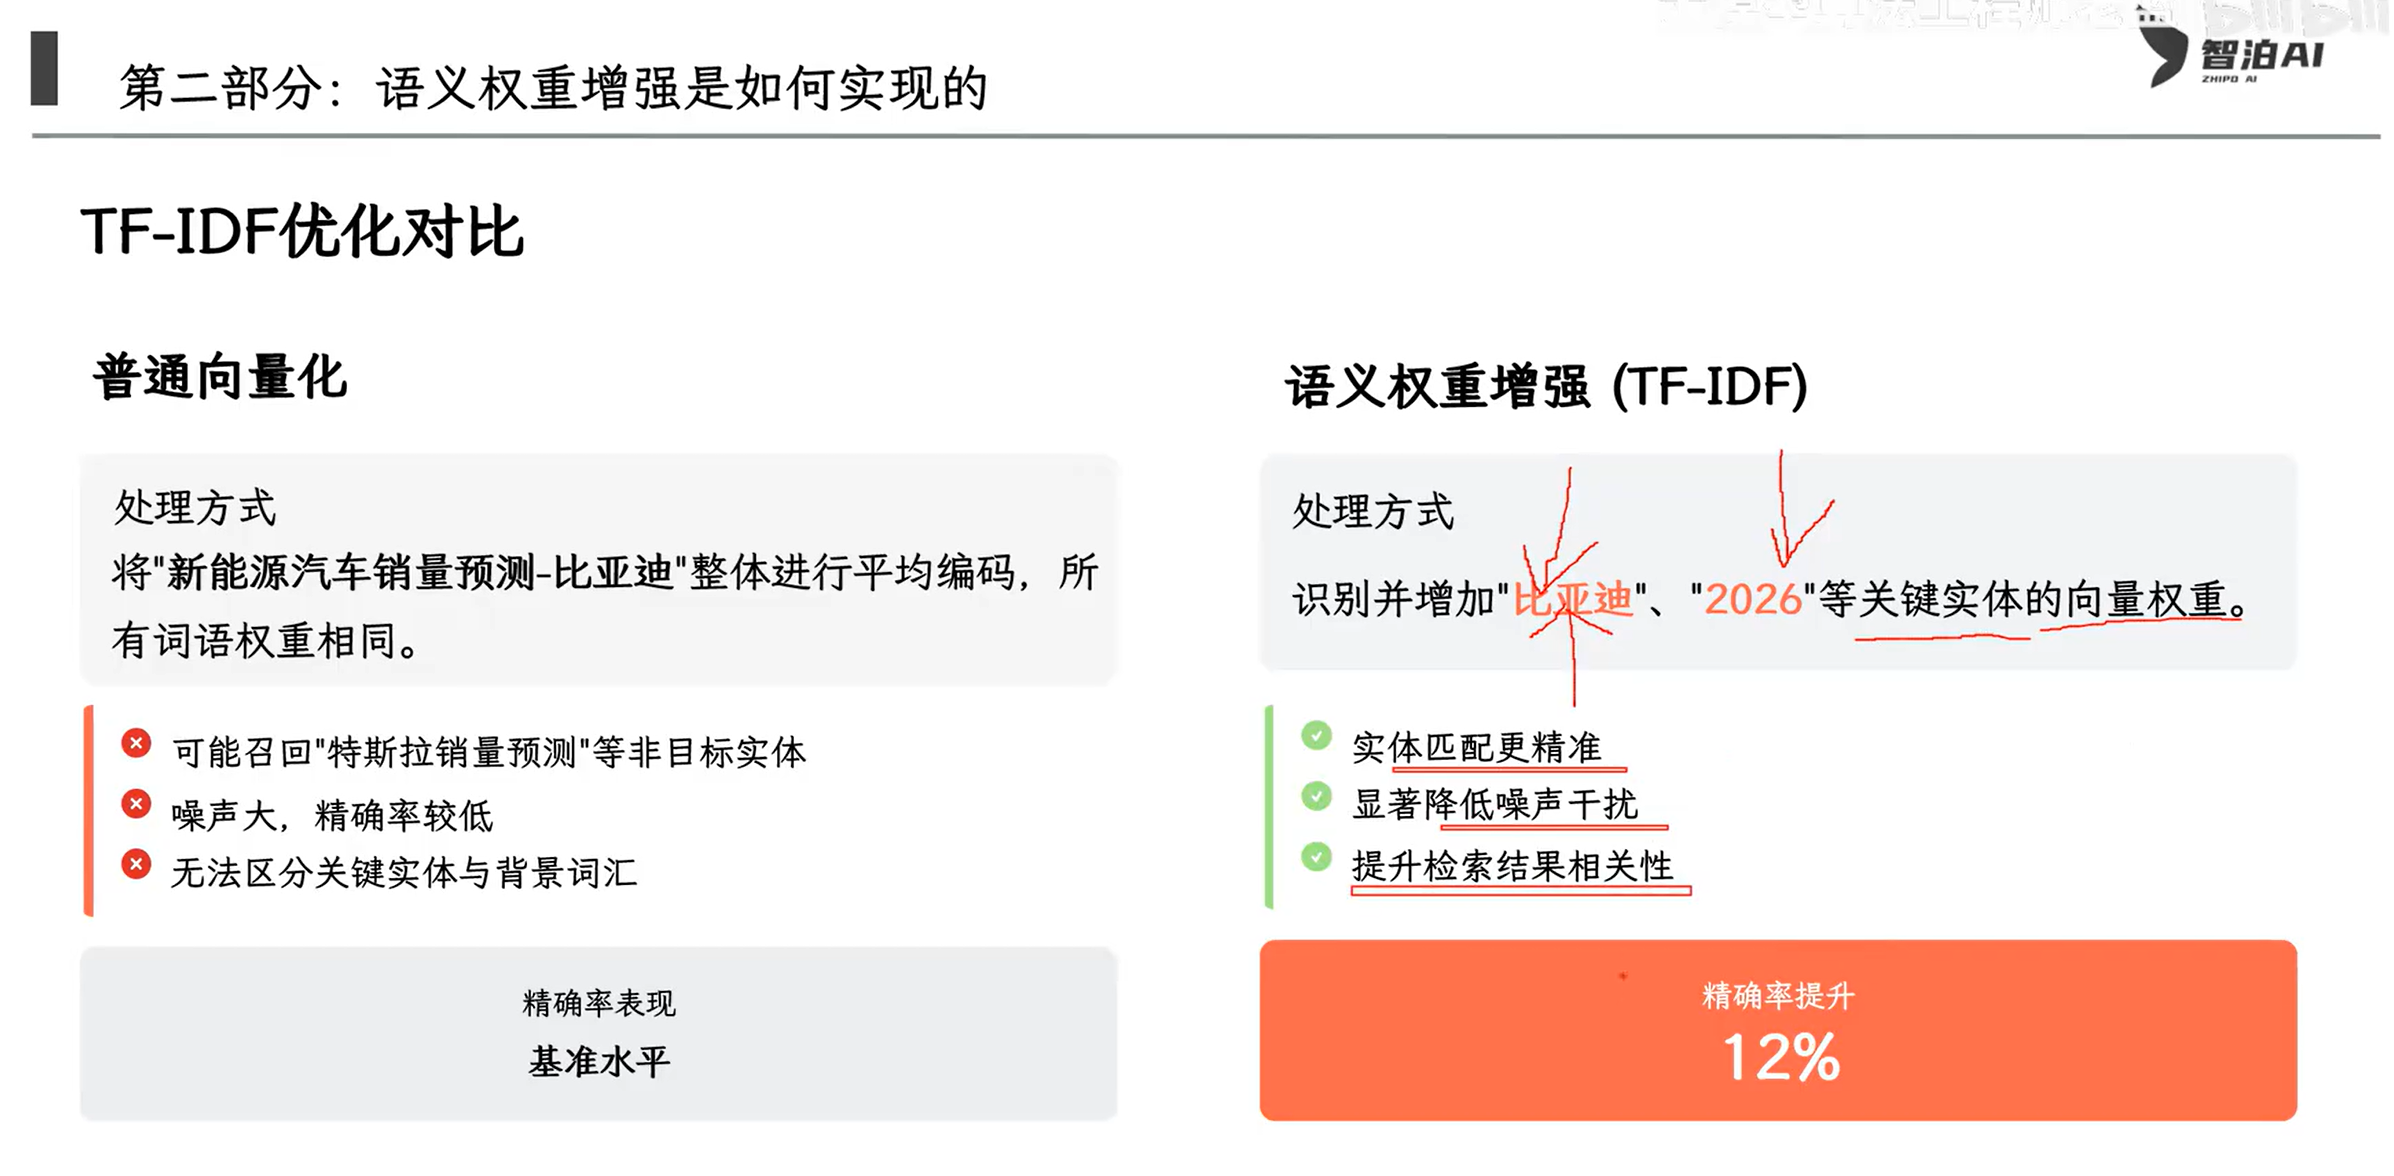
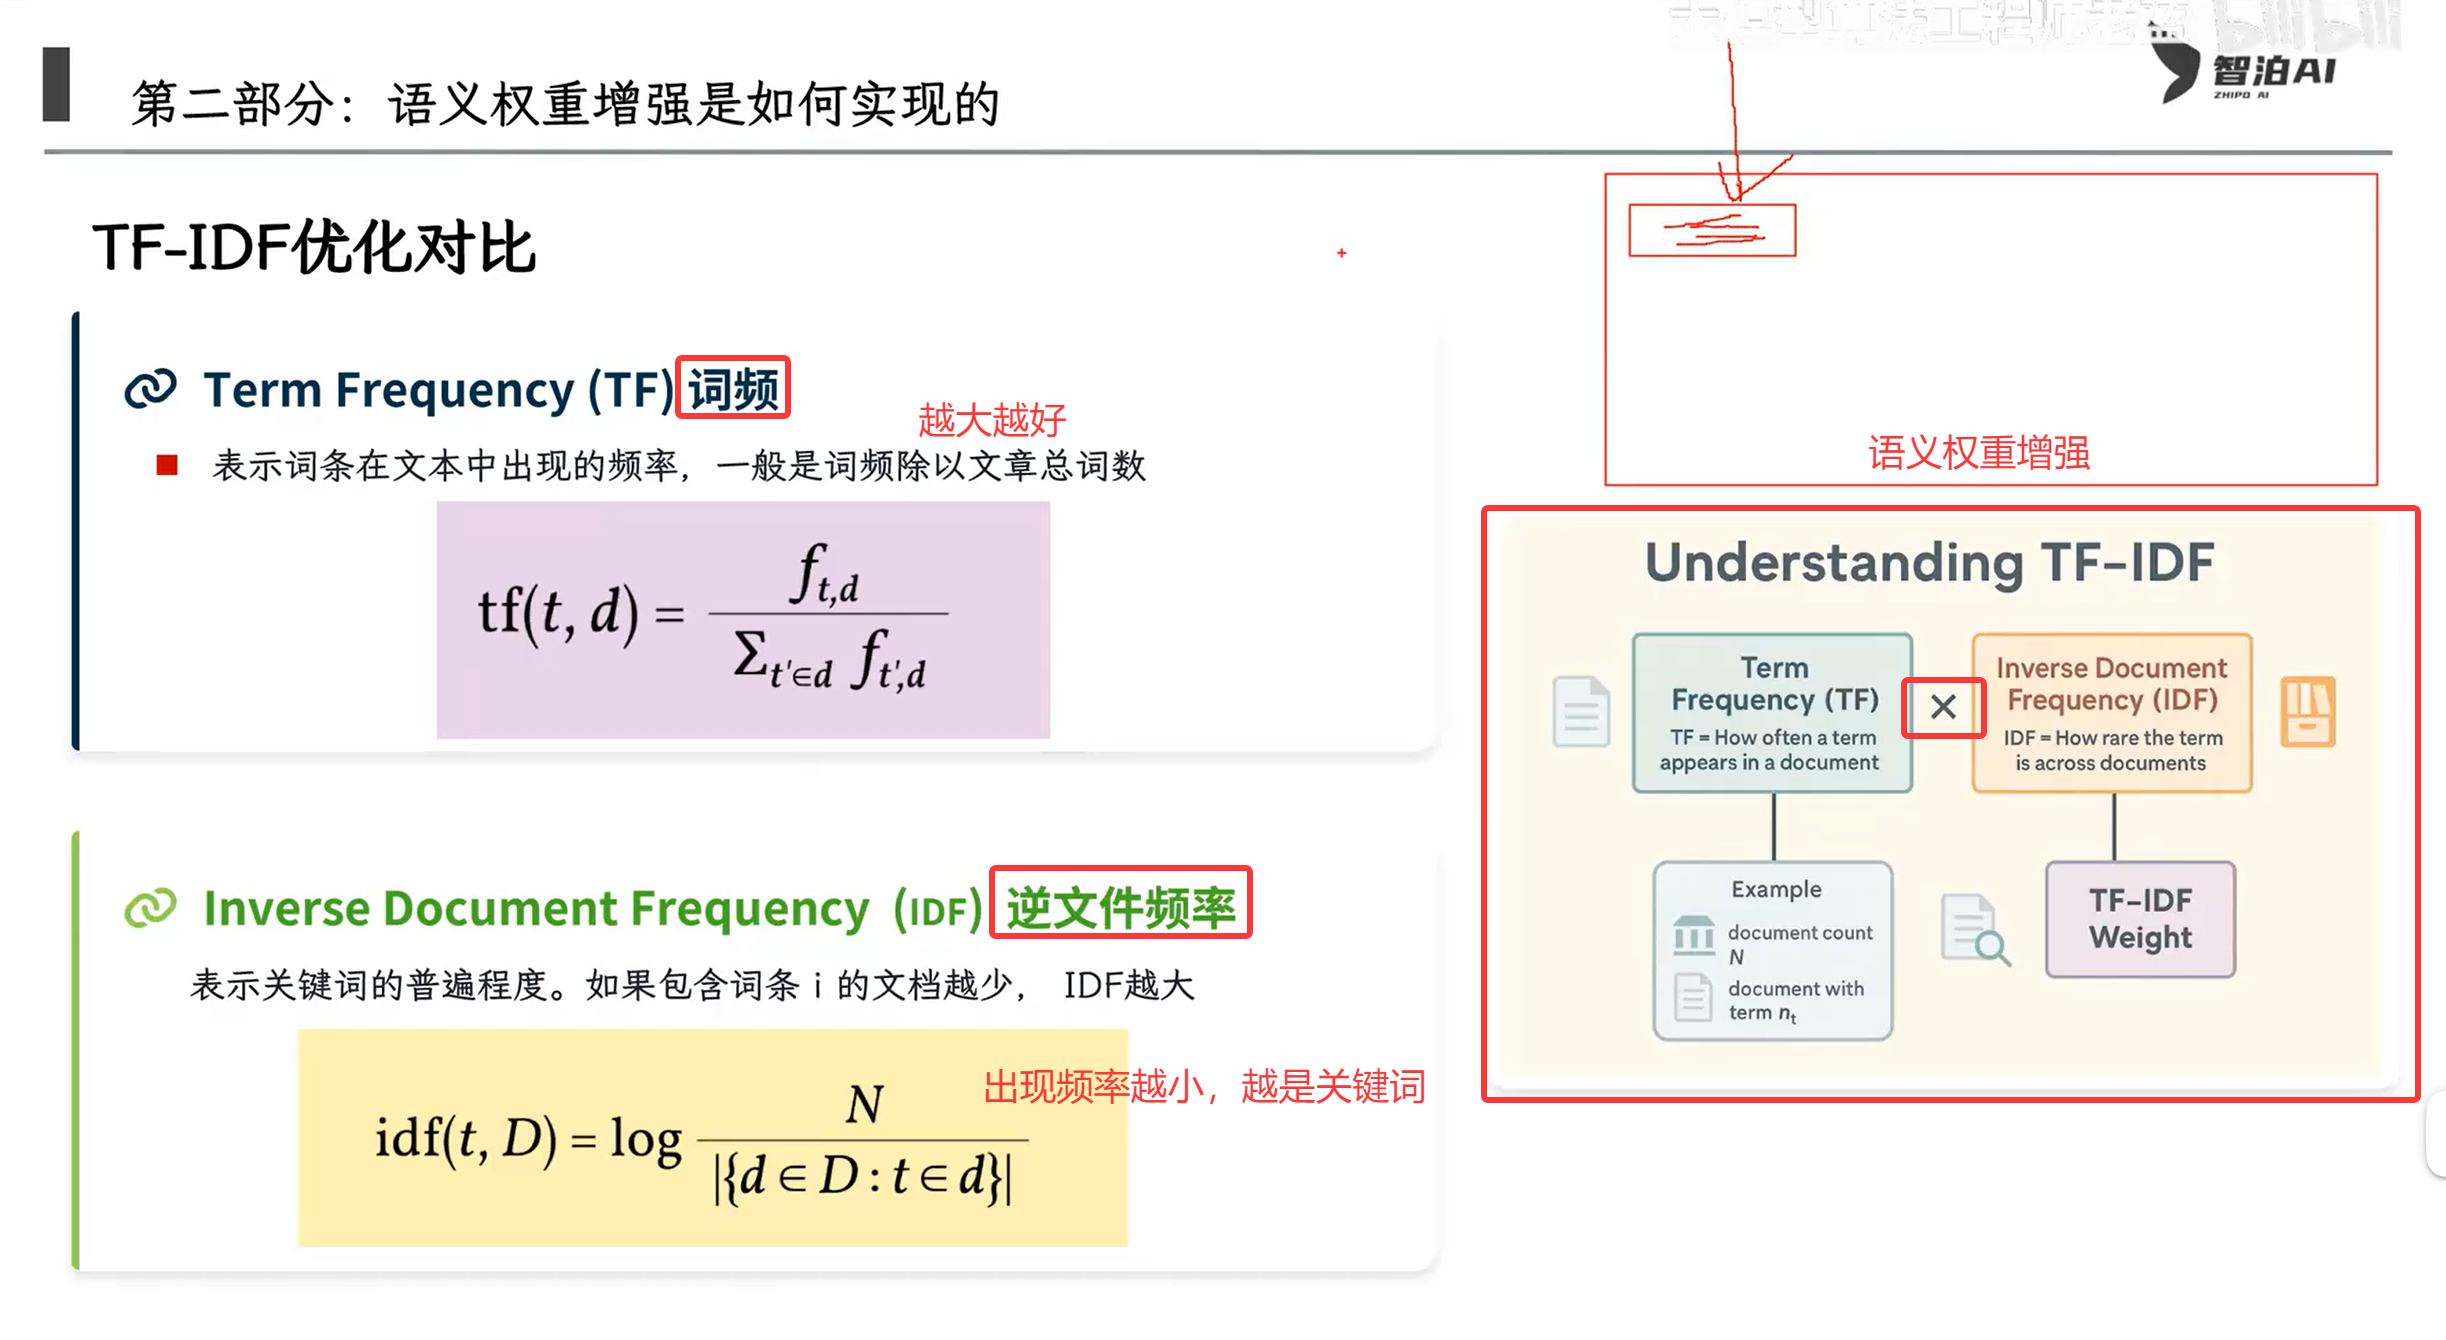
5.2 语义权重增强的实现
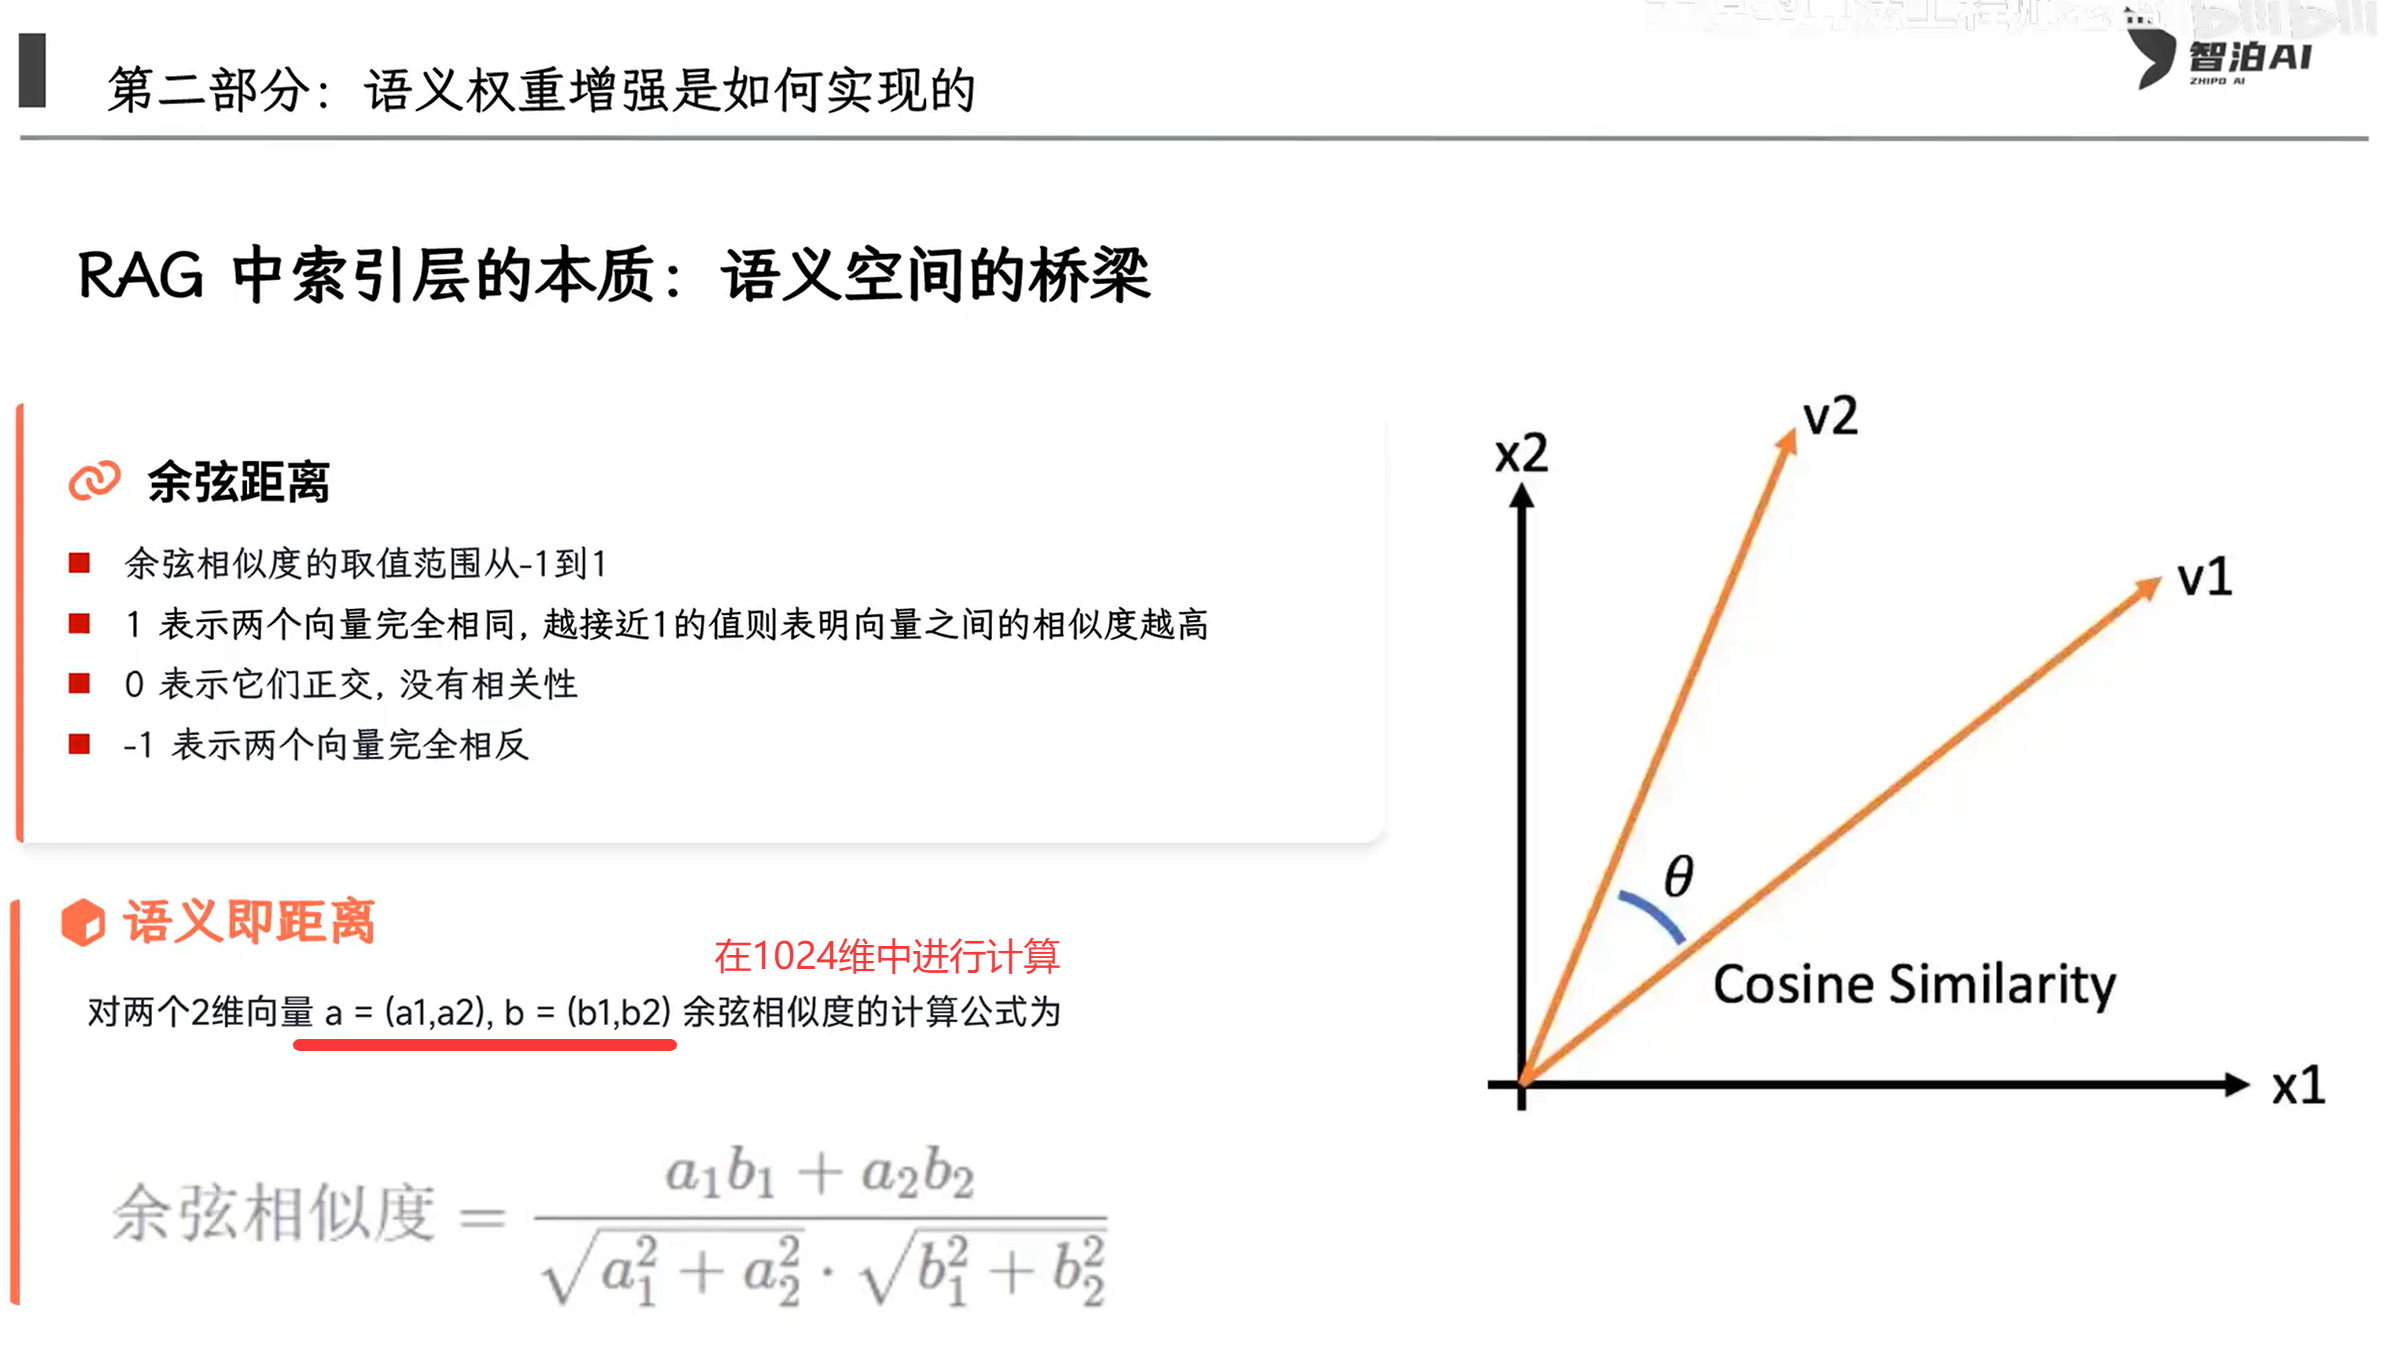
语义权重增强如何提升检索能力
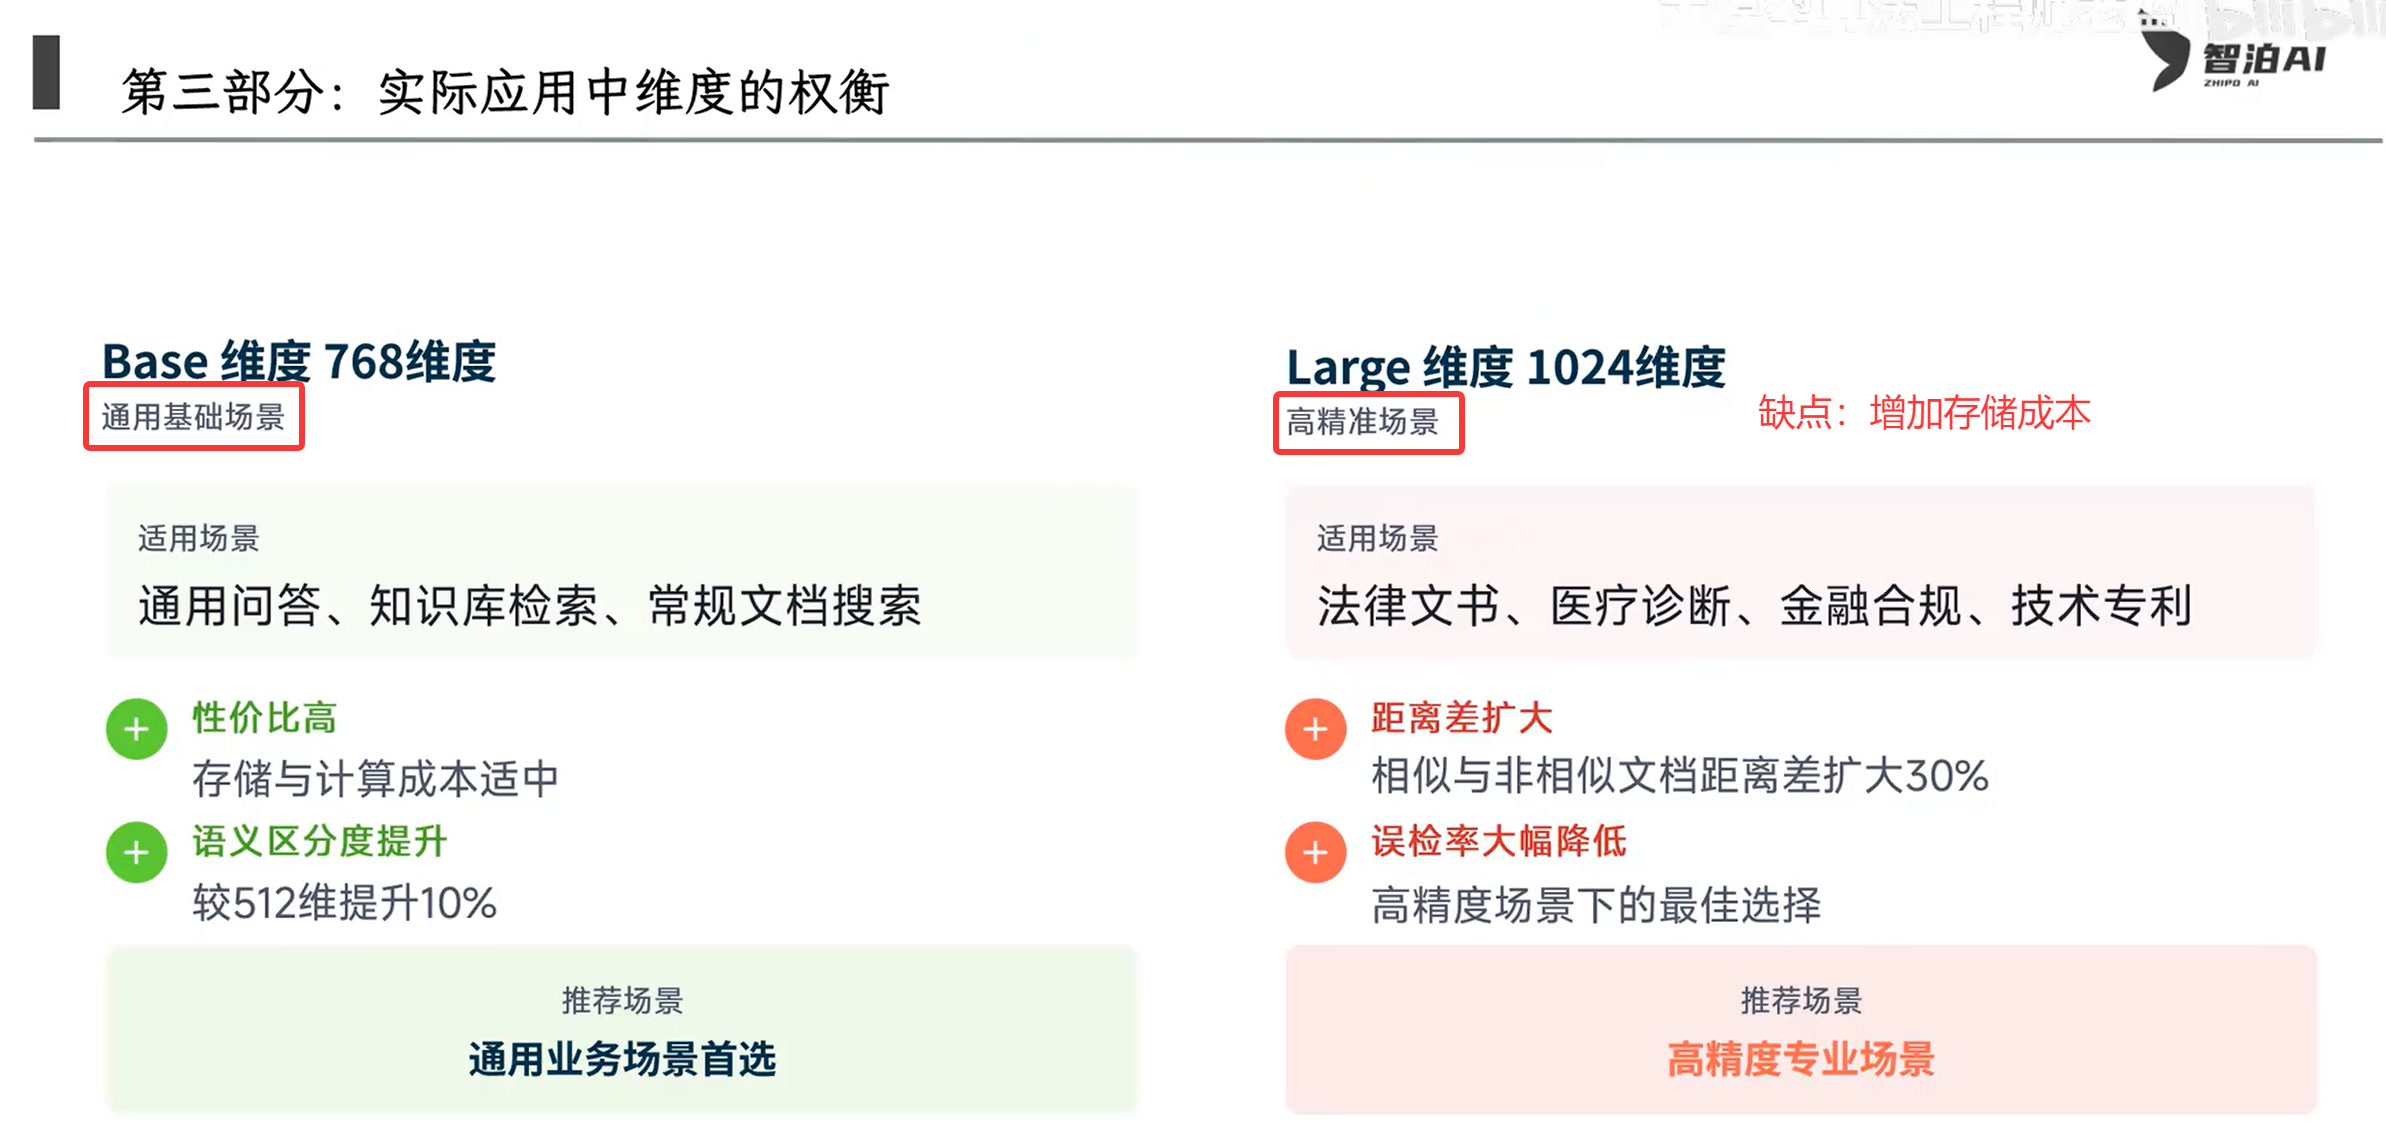
5.3 维度的最优平衡
根据业务场景精准度要求选择维度
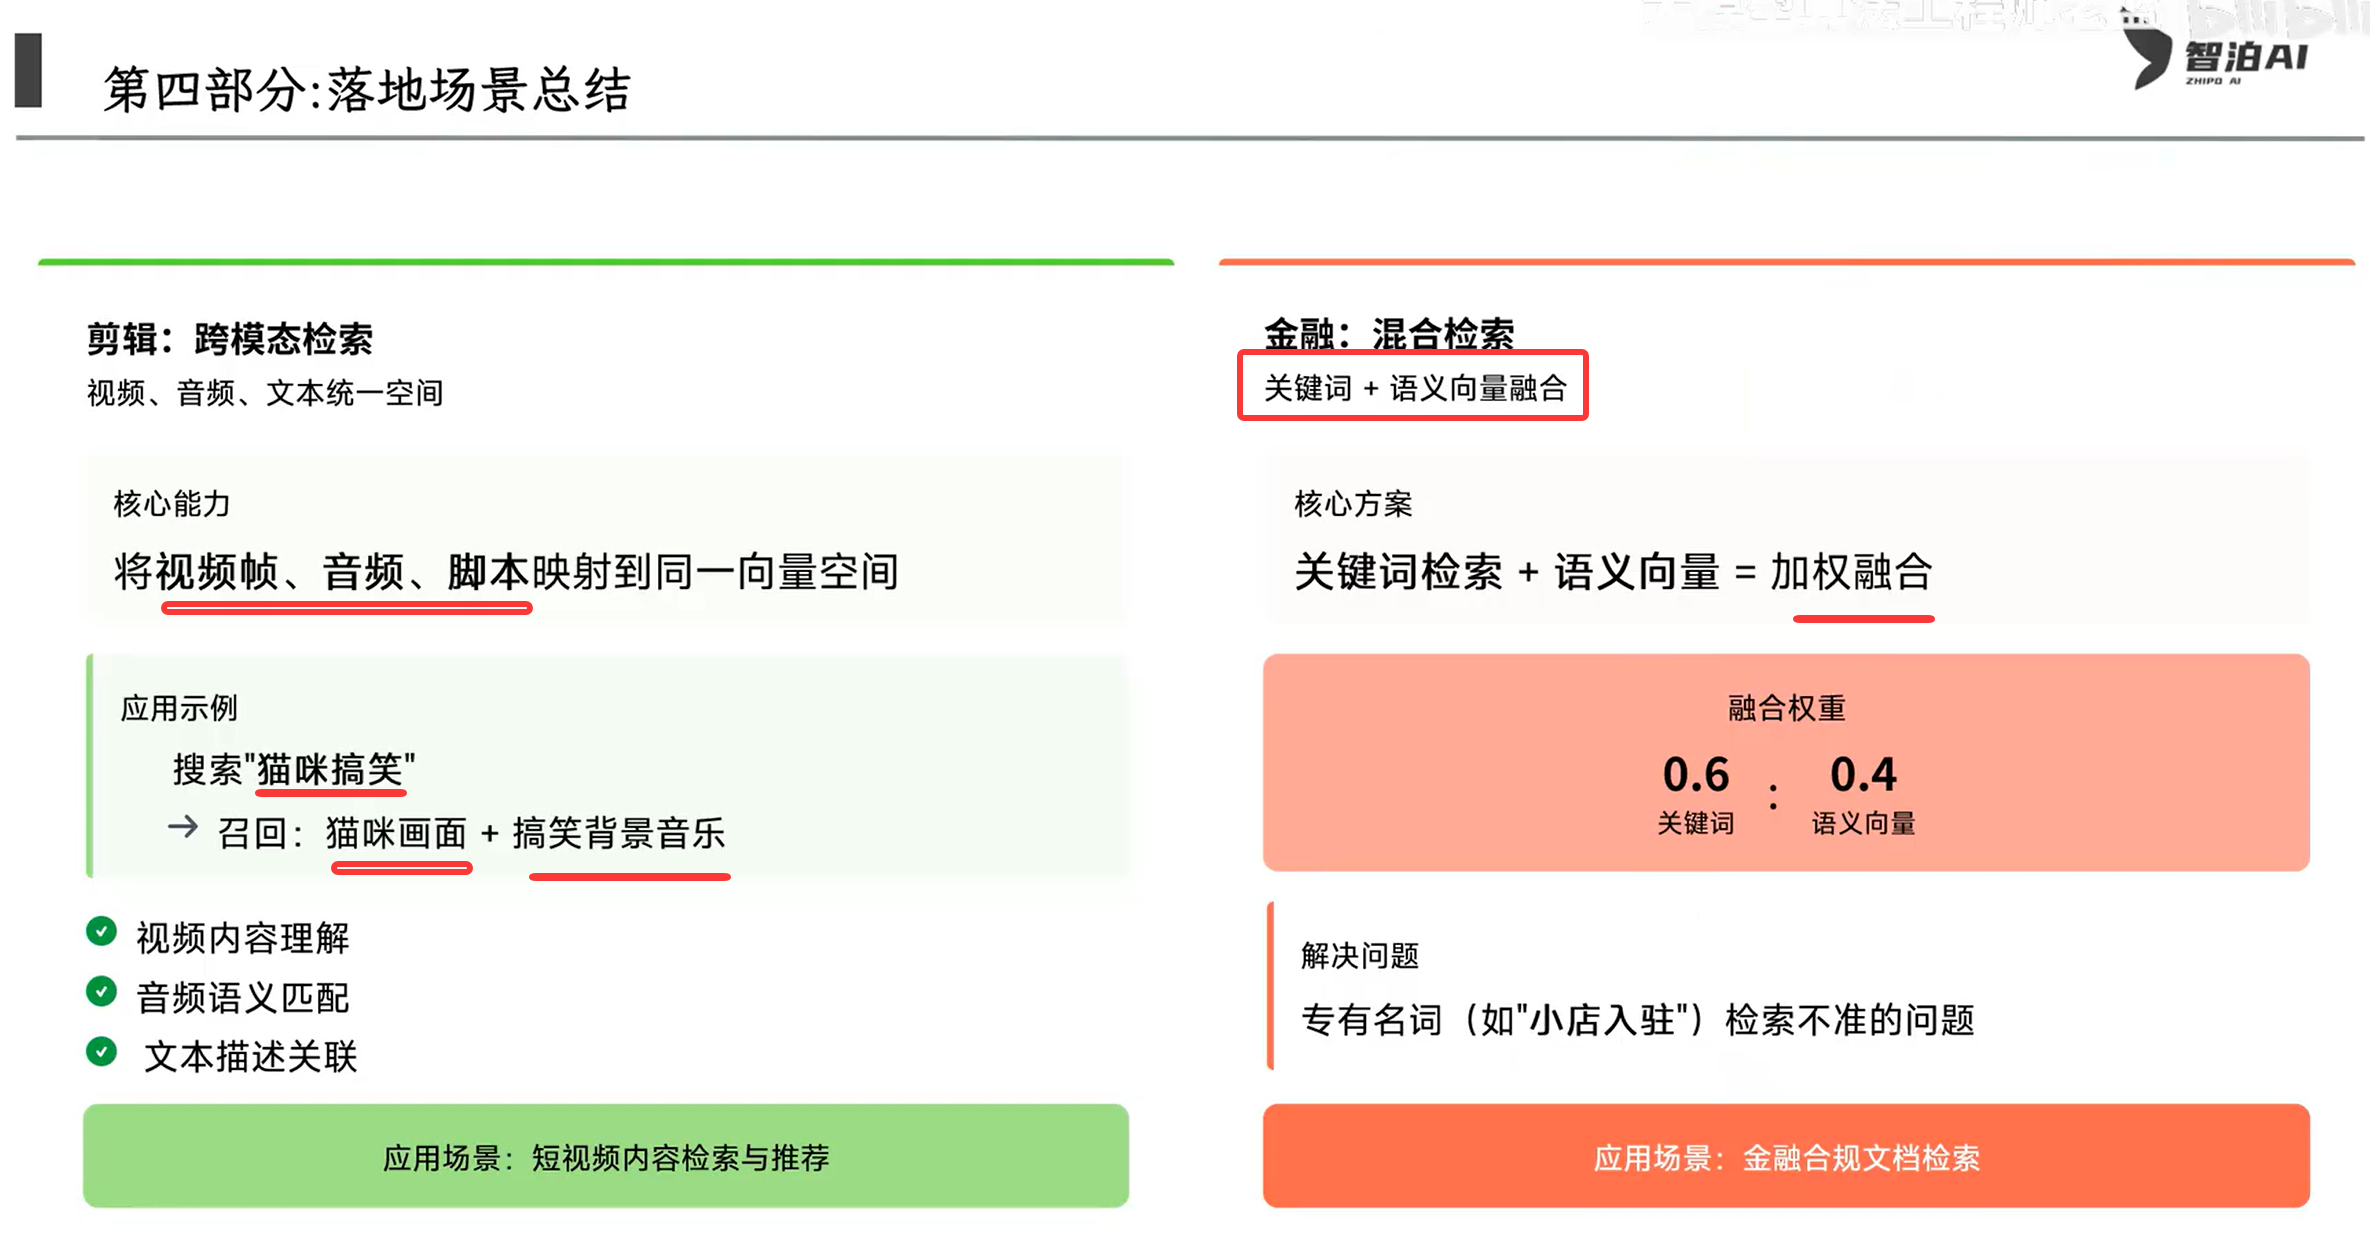
5.4 实战应用与展望
跨模态与混合检索的业务落地场景
六、GraphRAG 原理
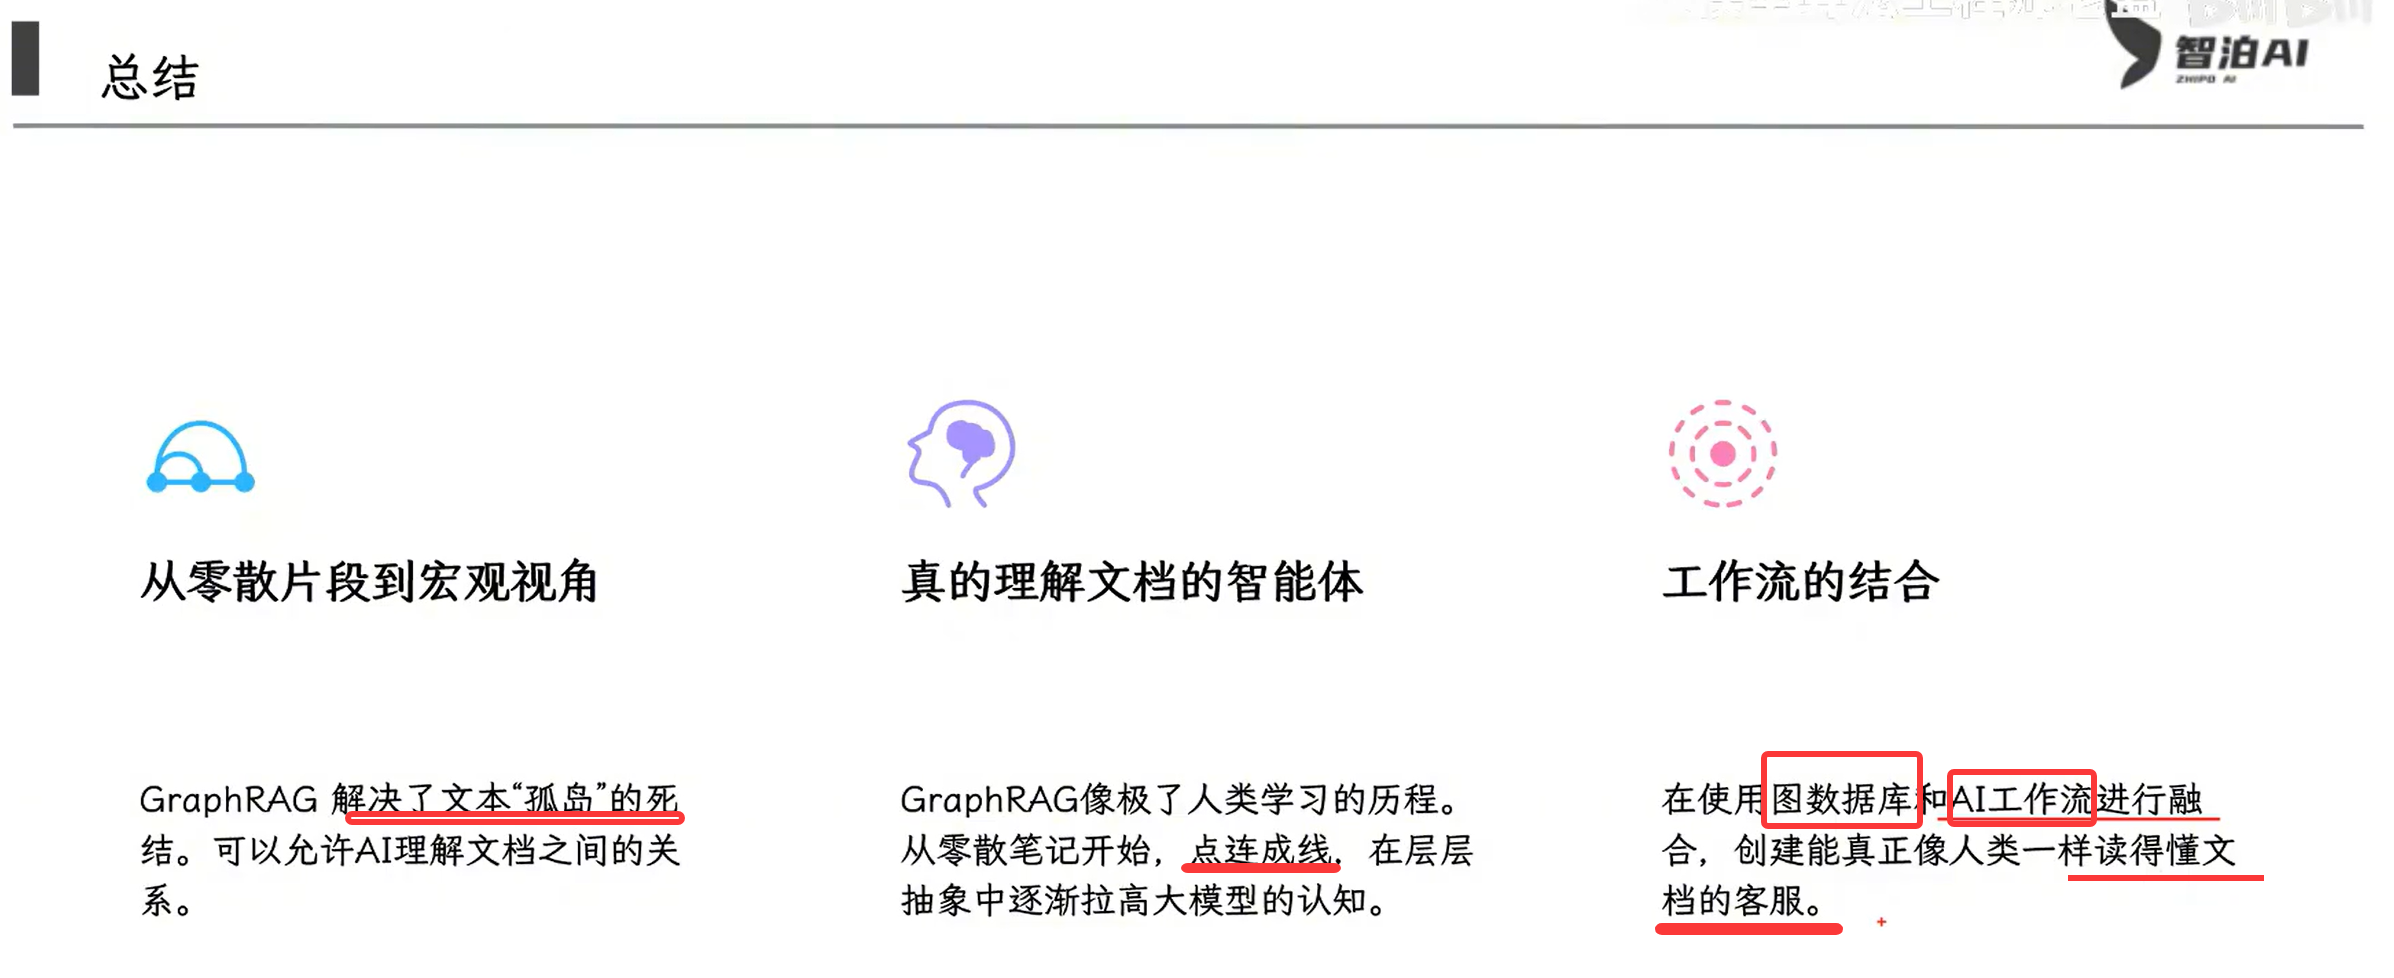
让AI像人类一样理解文档
6.1 传统痛点
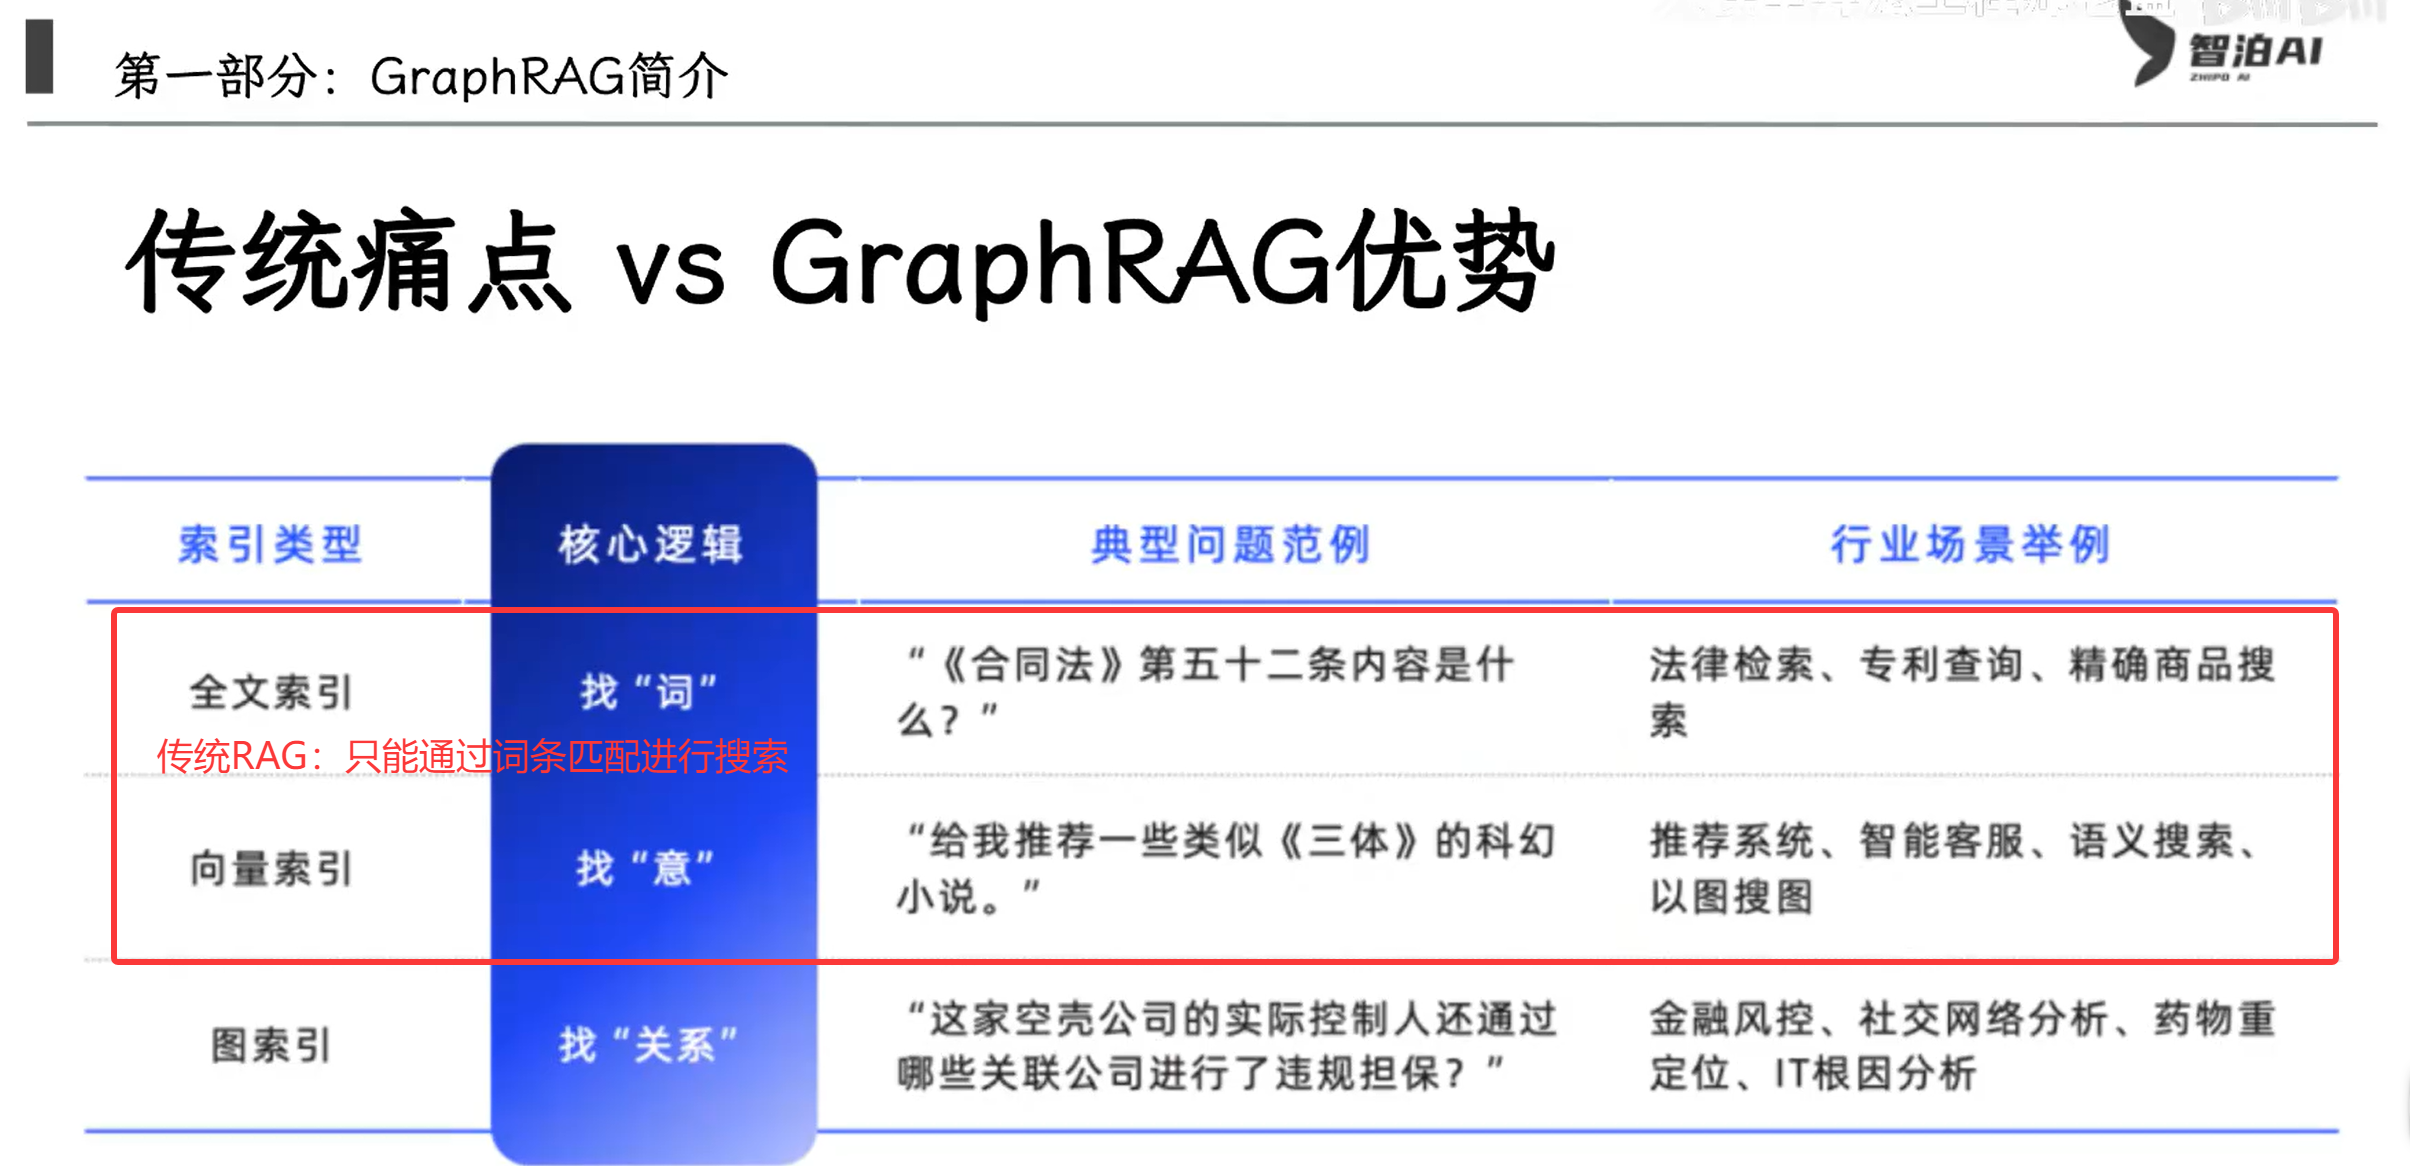
传统RAG的工作方式与局限性
6.2 GraphRAG原理
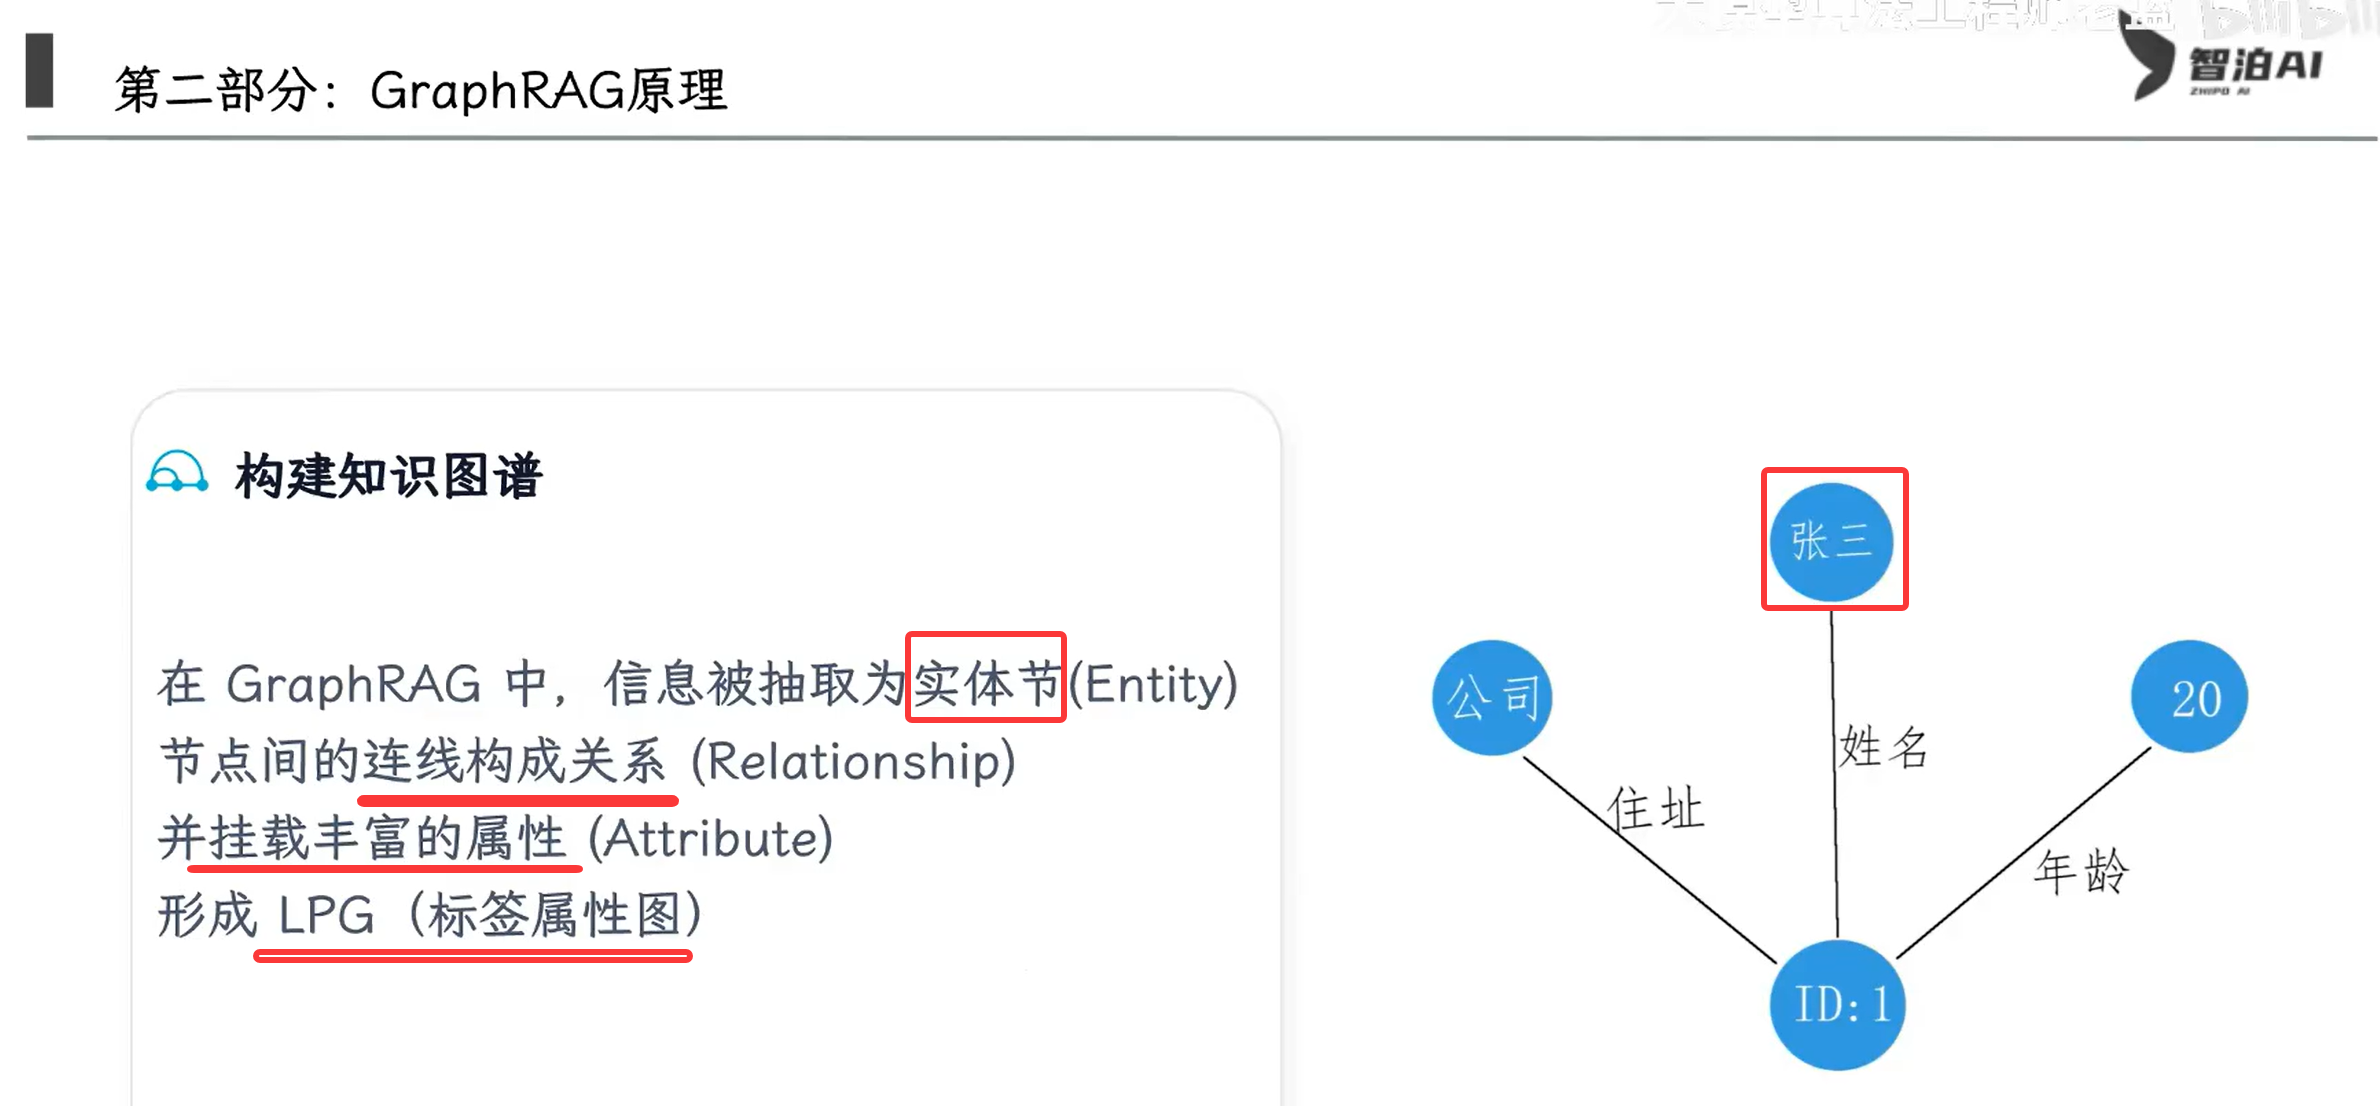
实体、关系与LPG(标签属性图)
6.3 构建RAG
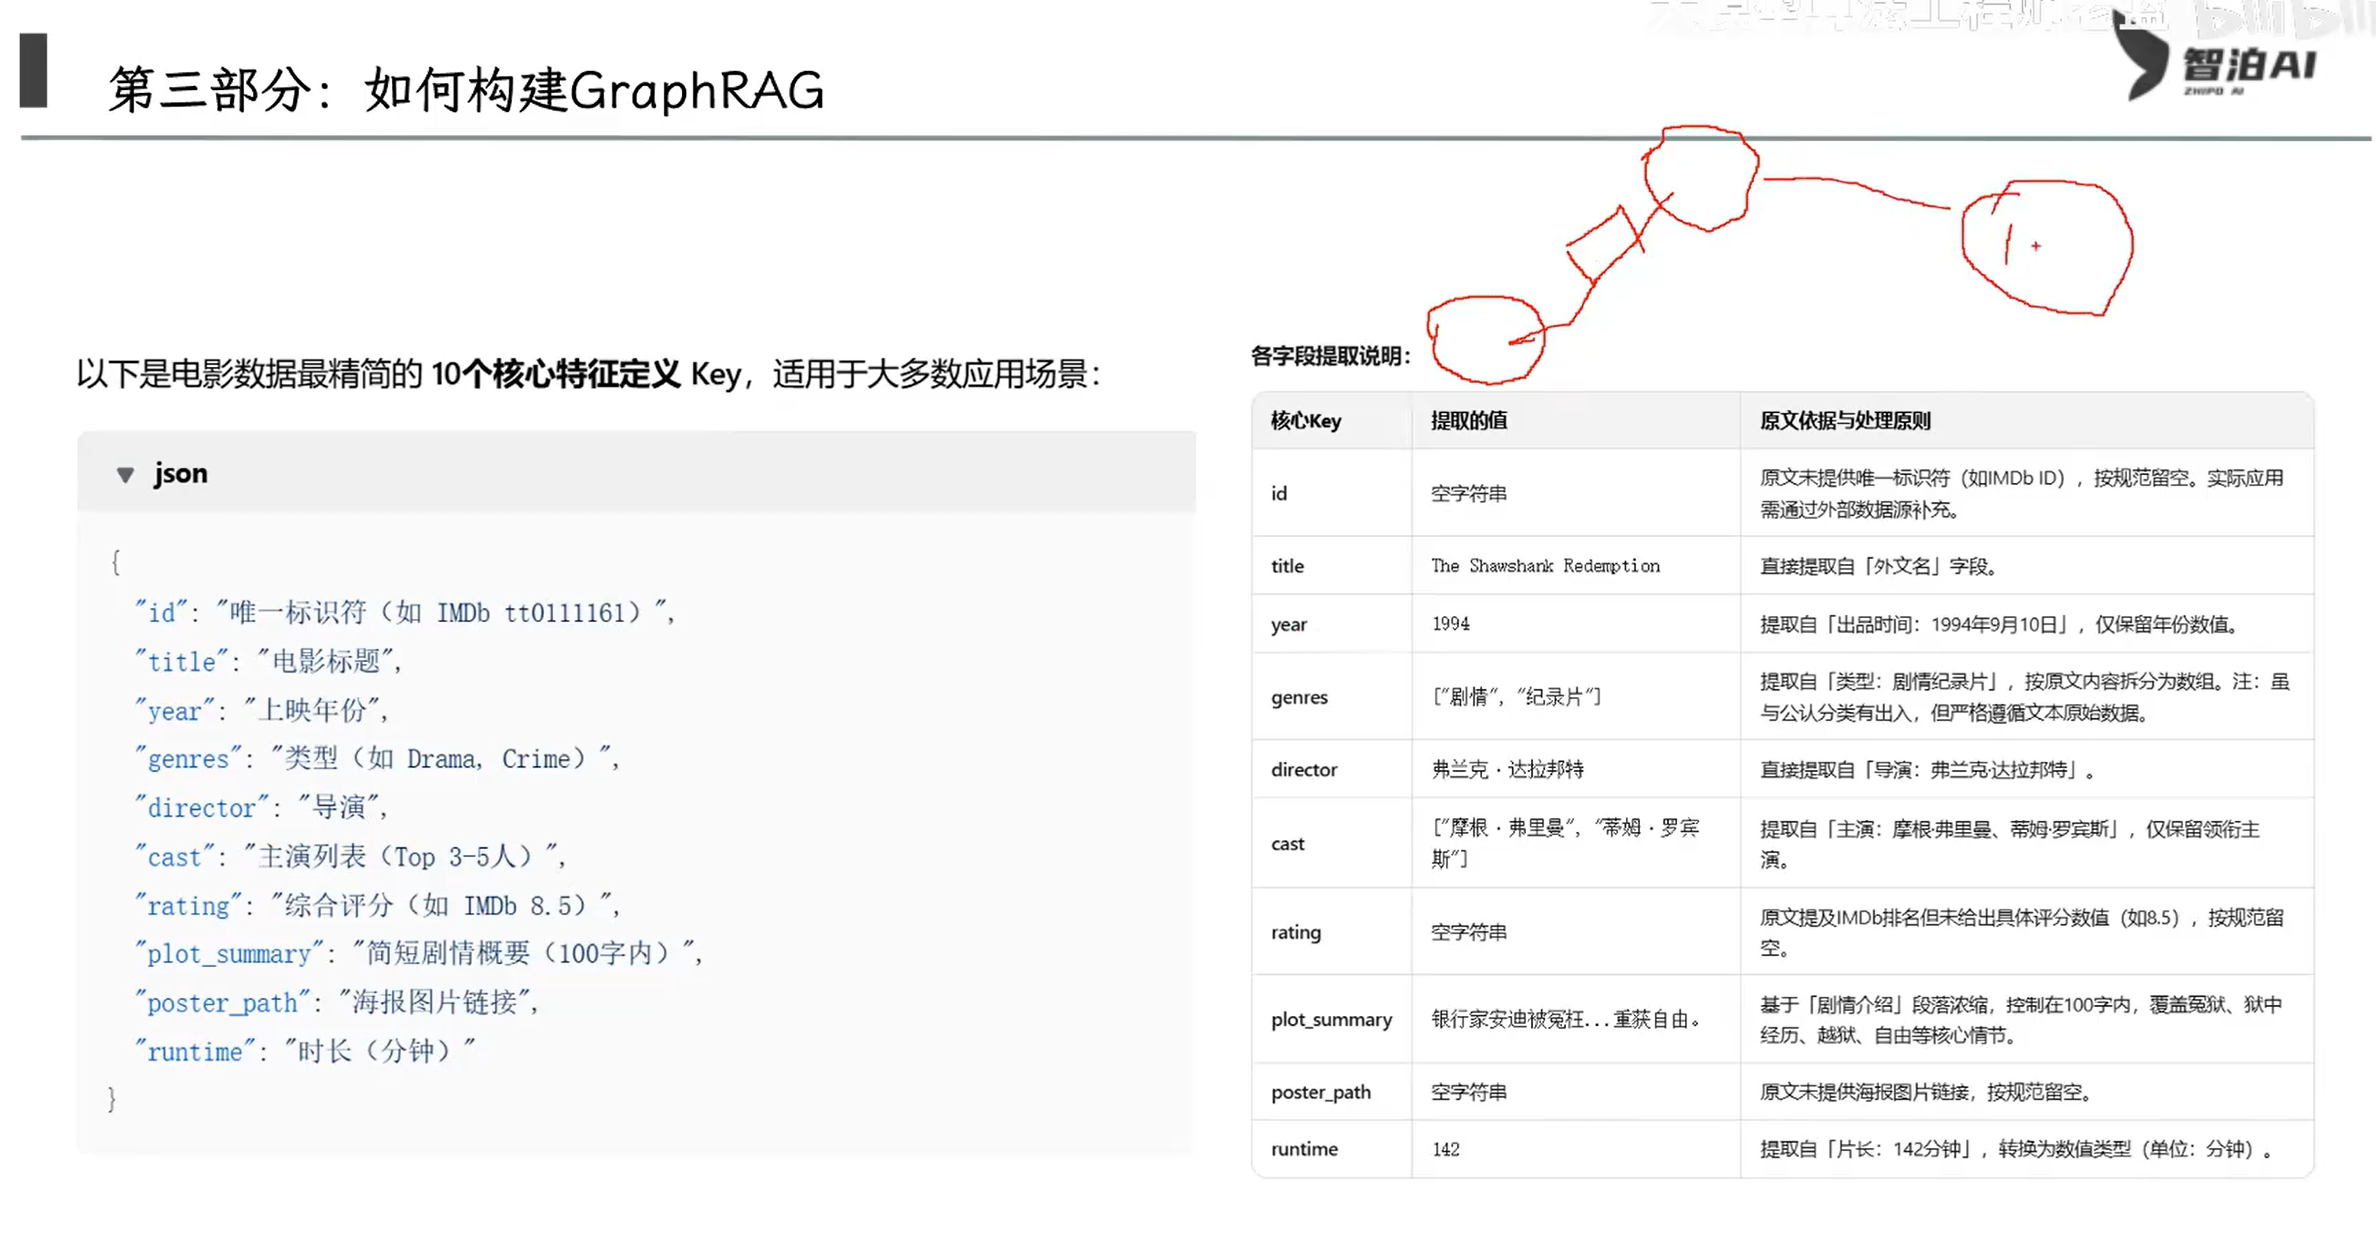
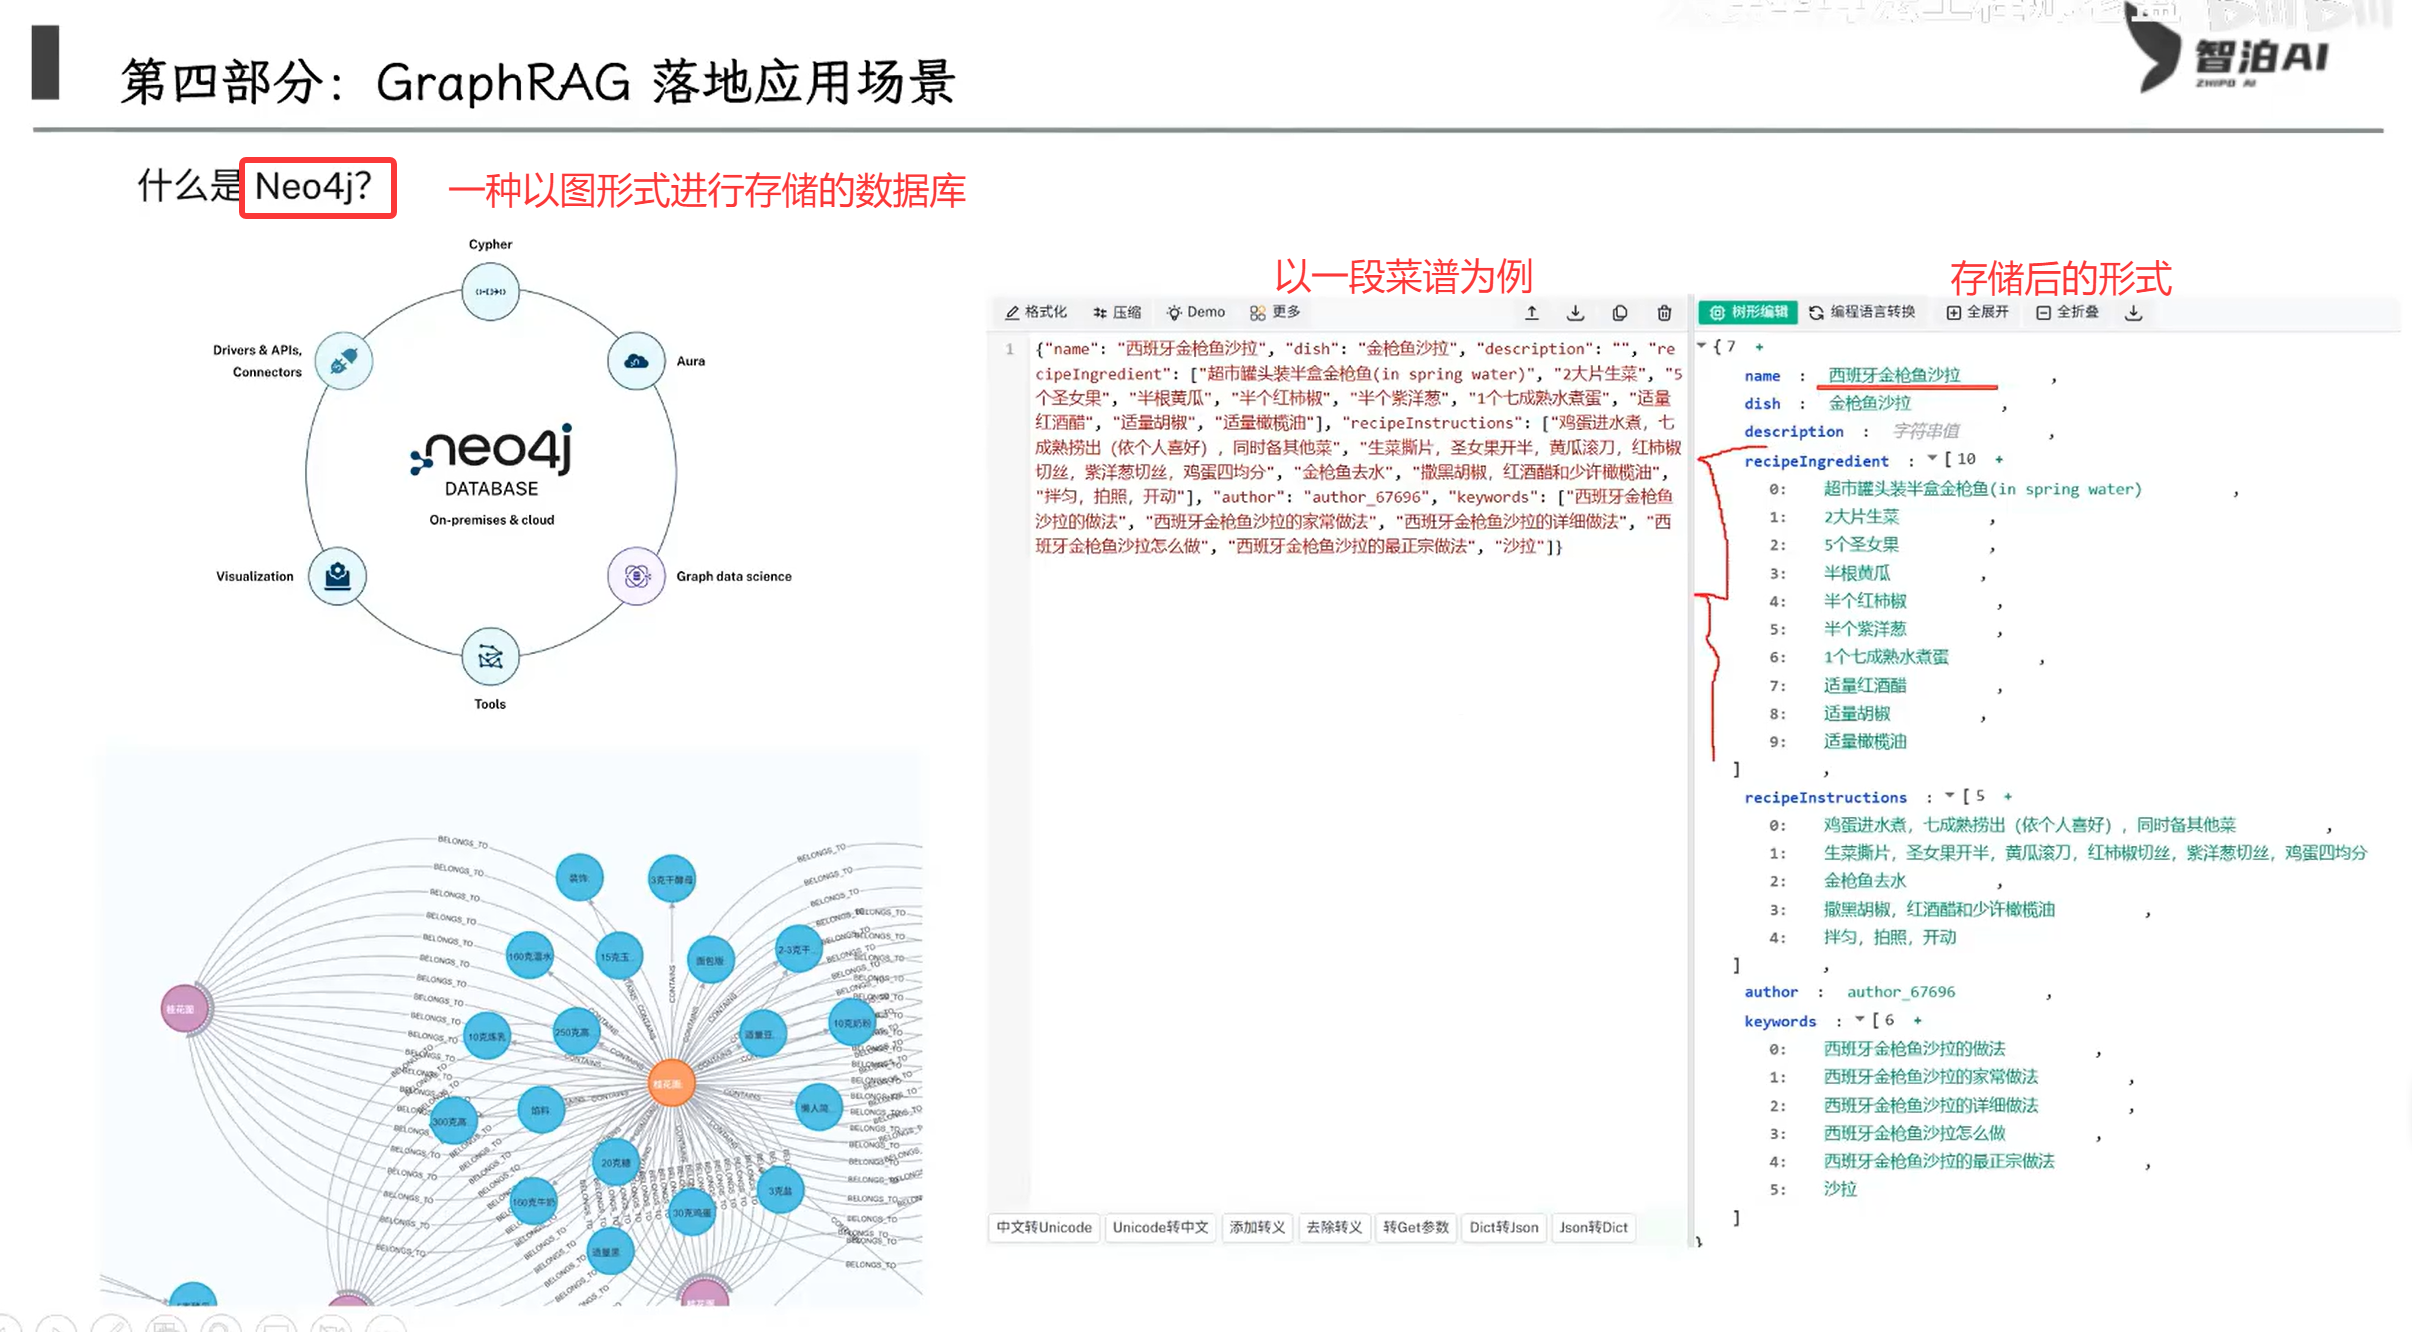
基于图数据库由AI抽取实体关系
以电影数据为例:
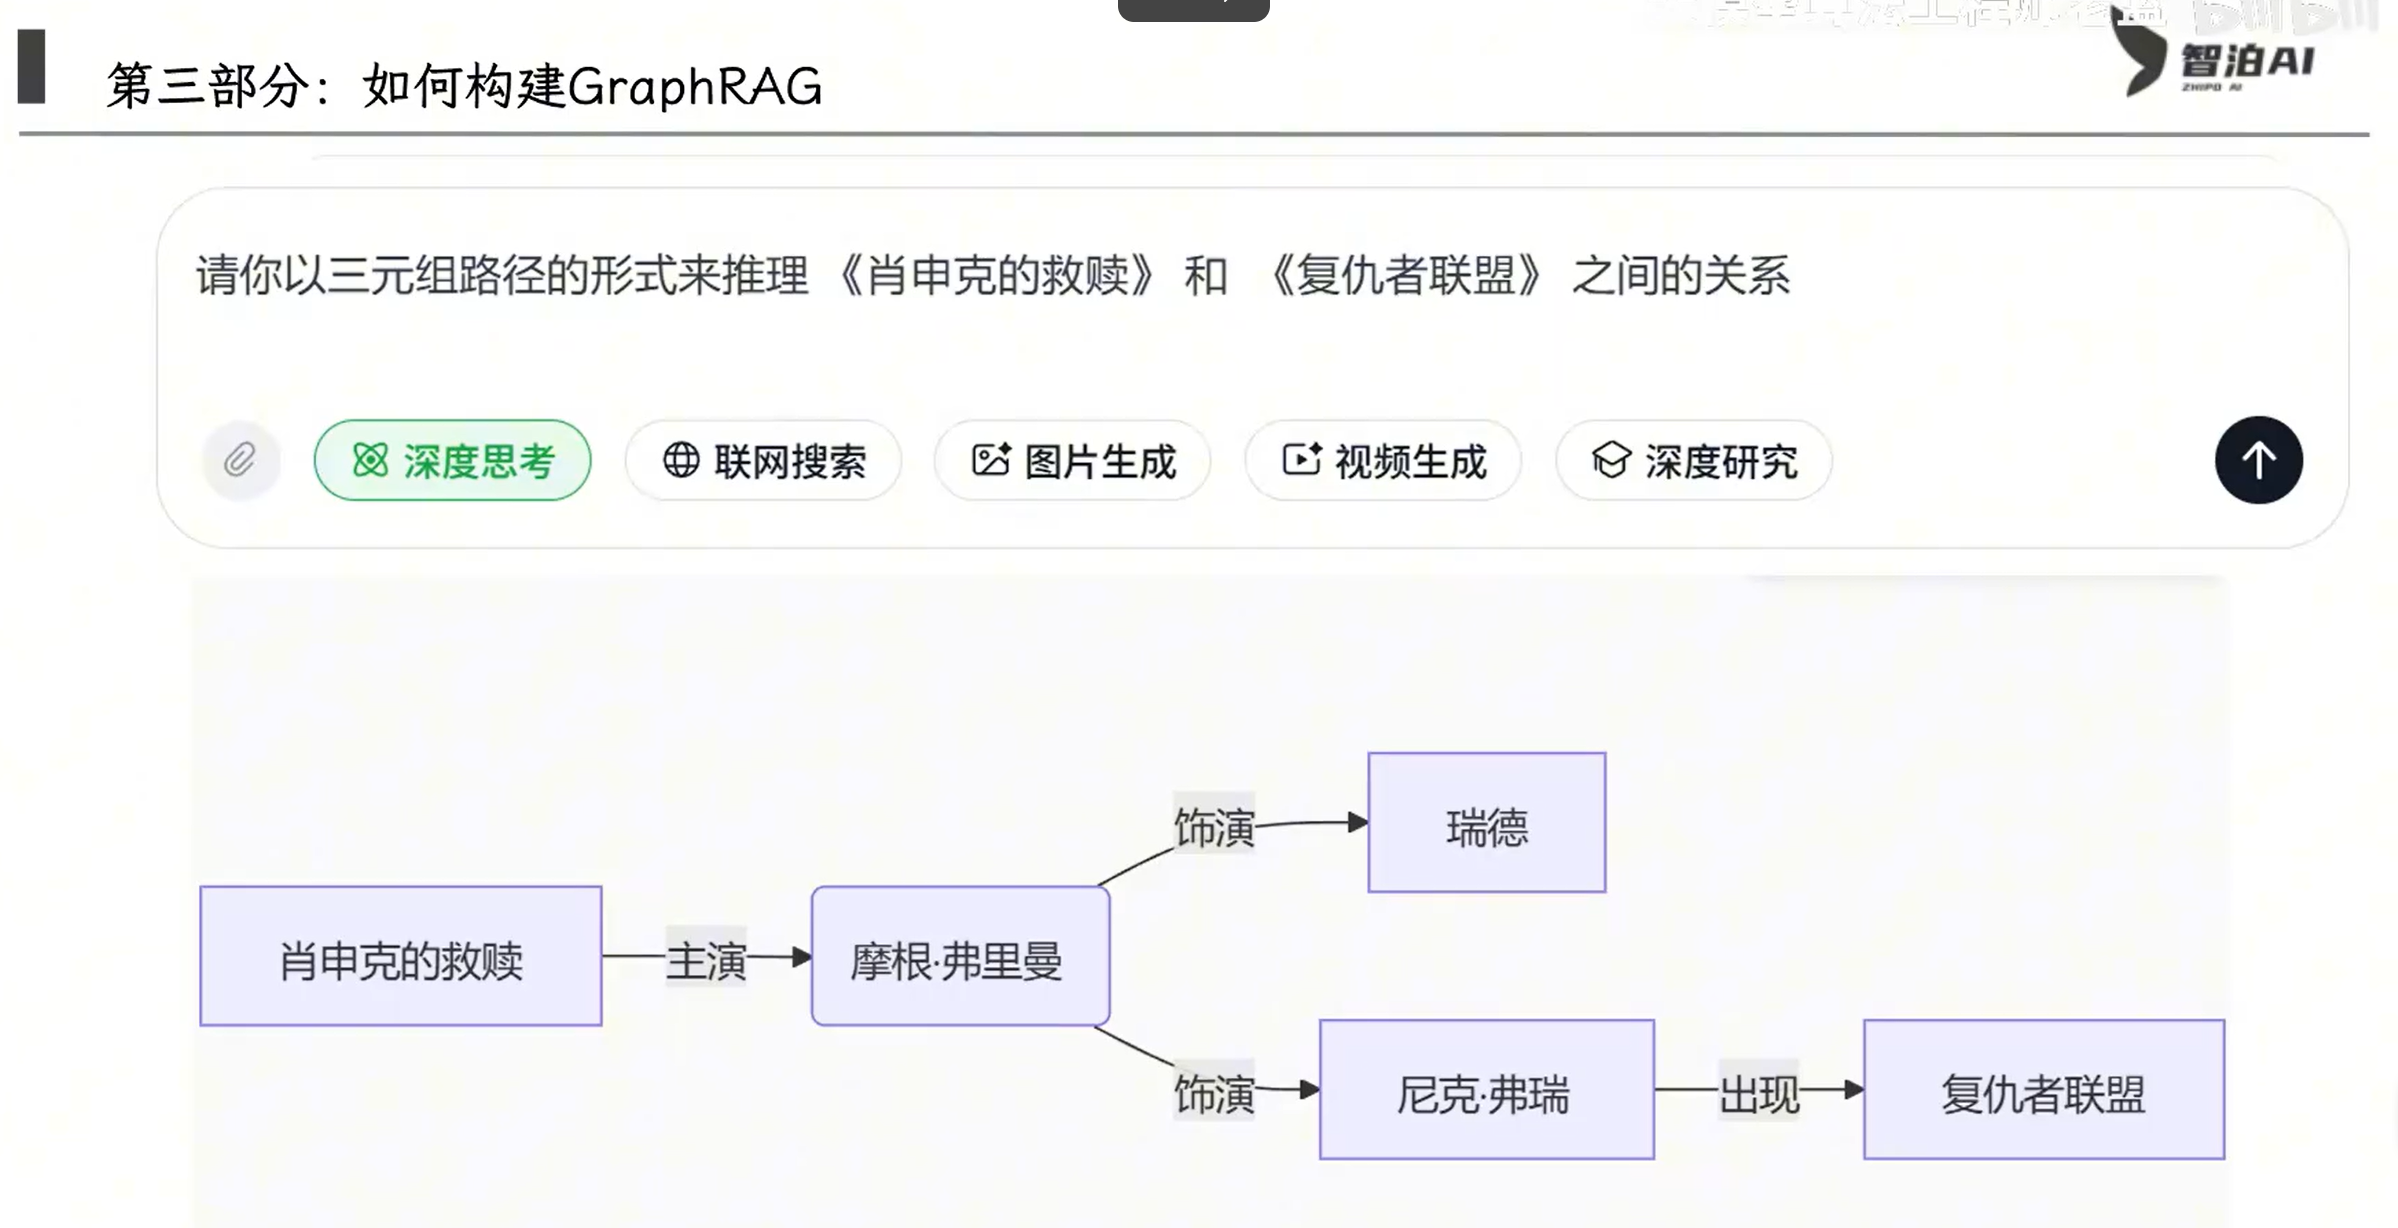
6.4 实战与应用效果
在Dify平台构建GraphRAG
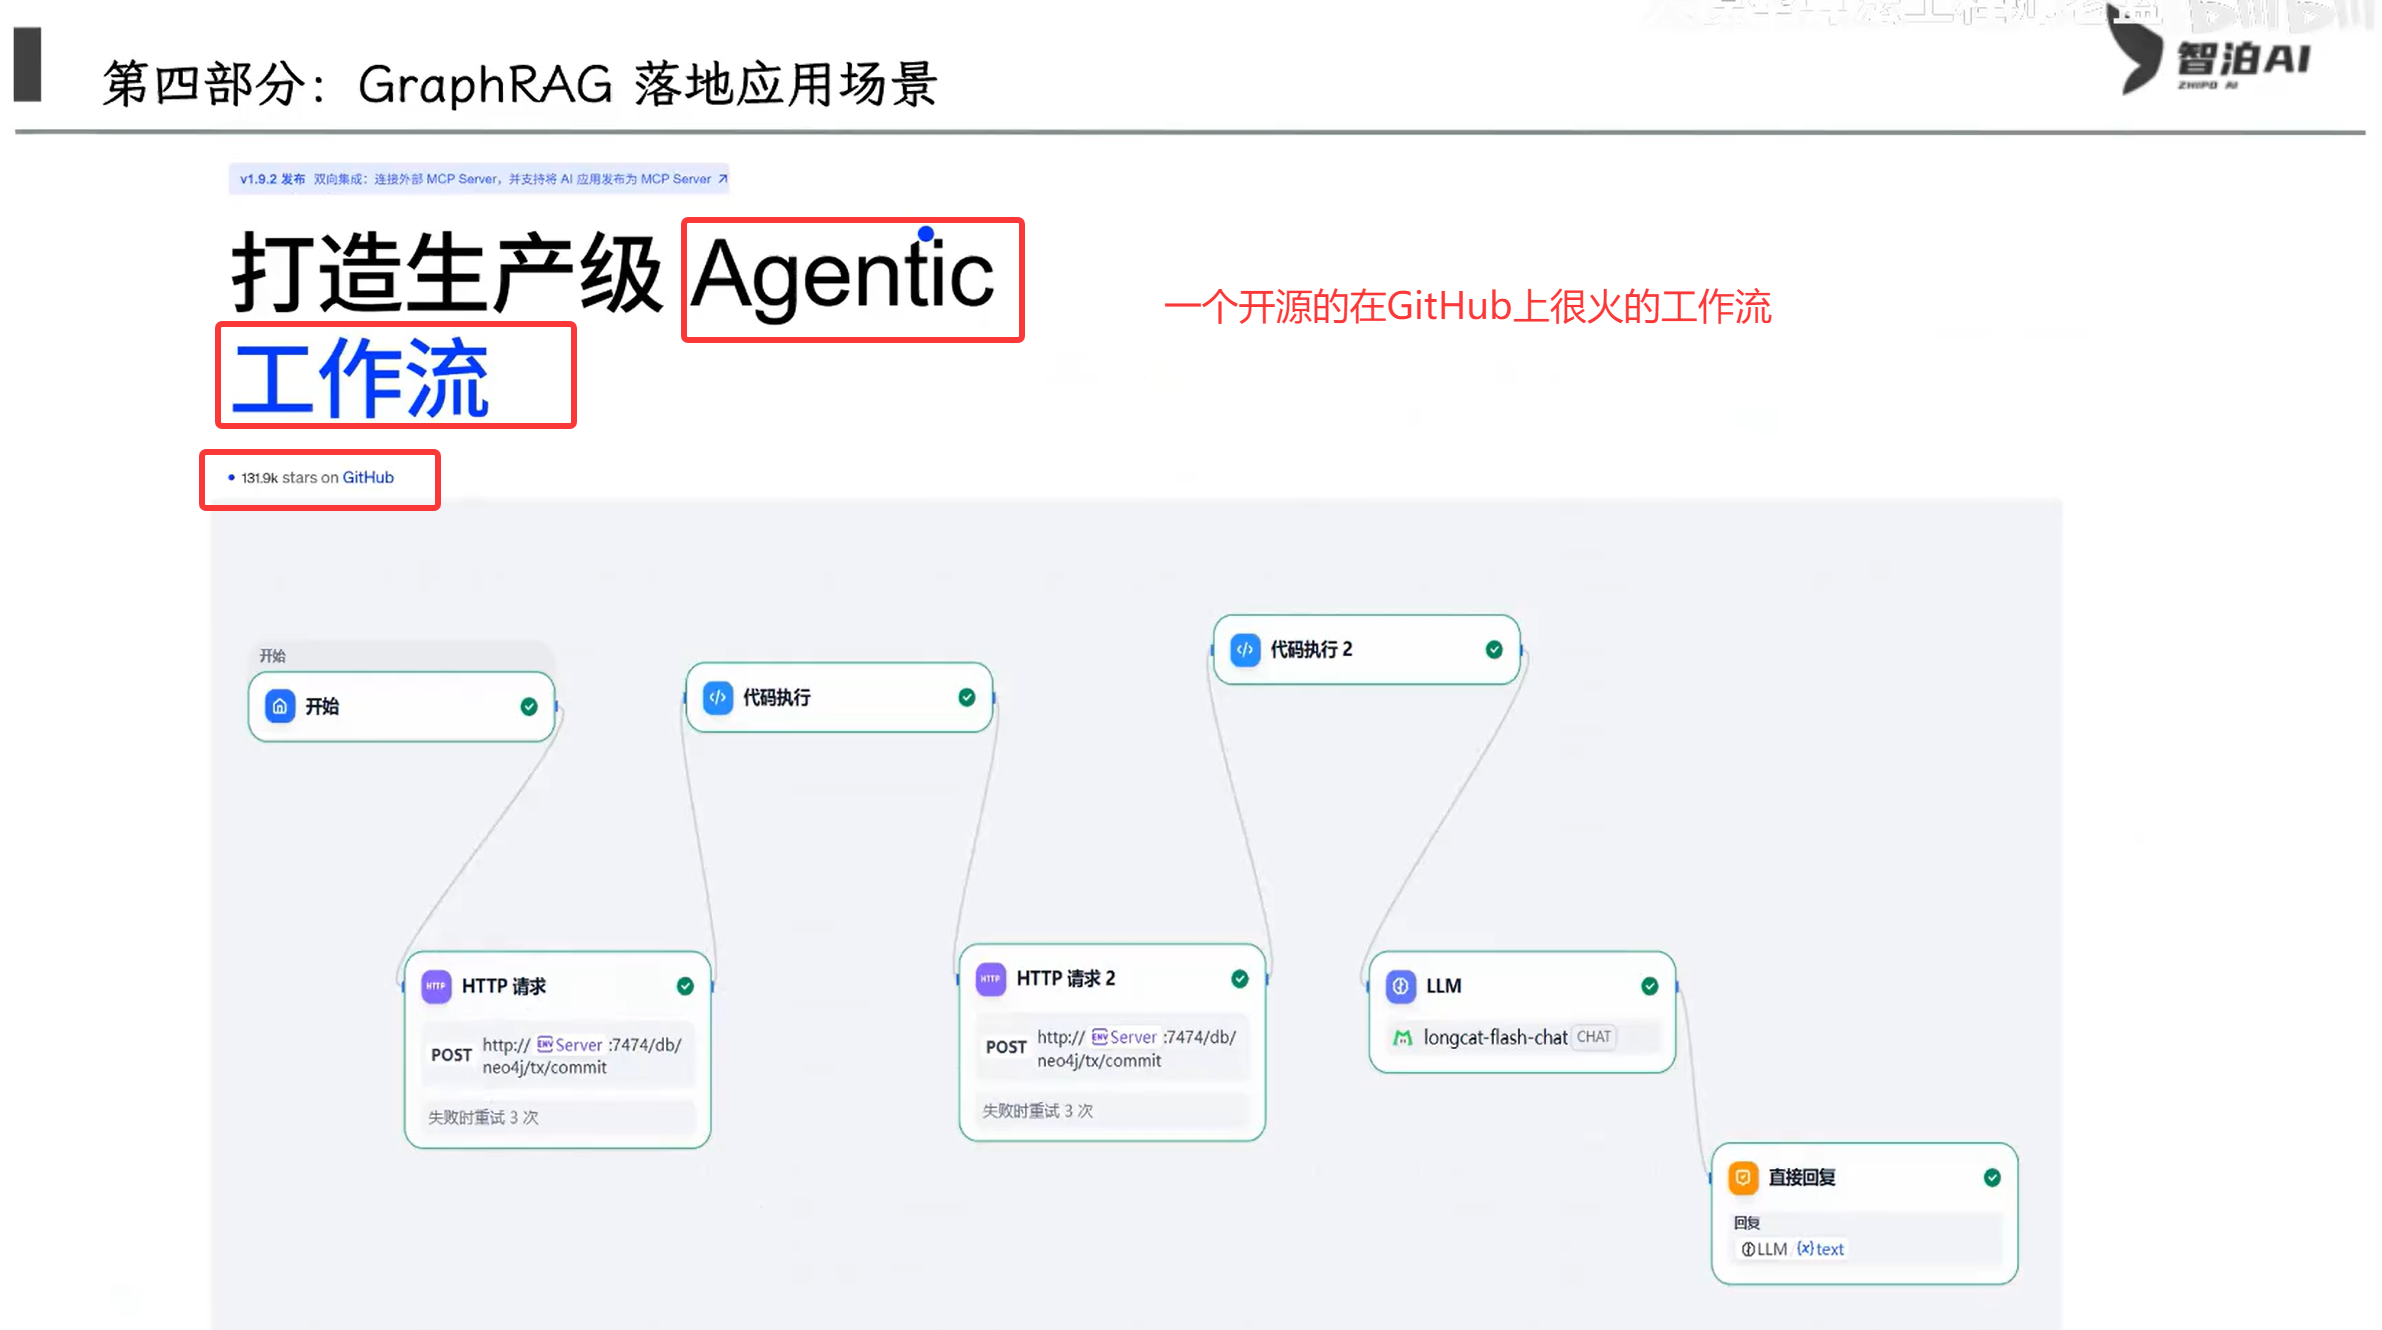
在GitHub上开源的平台:Dify平台。提供了免费的AI工作流搭建。
通过GraphRAG调用美团龙猫模型的回答,具体实用,符合实际应用。
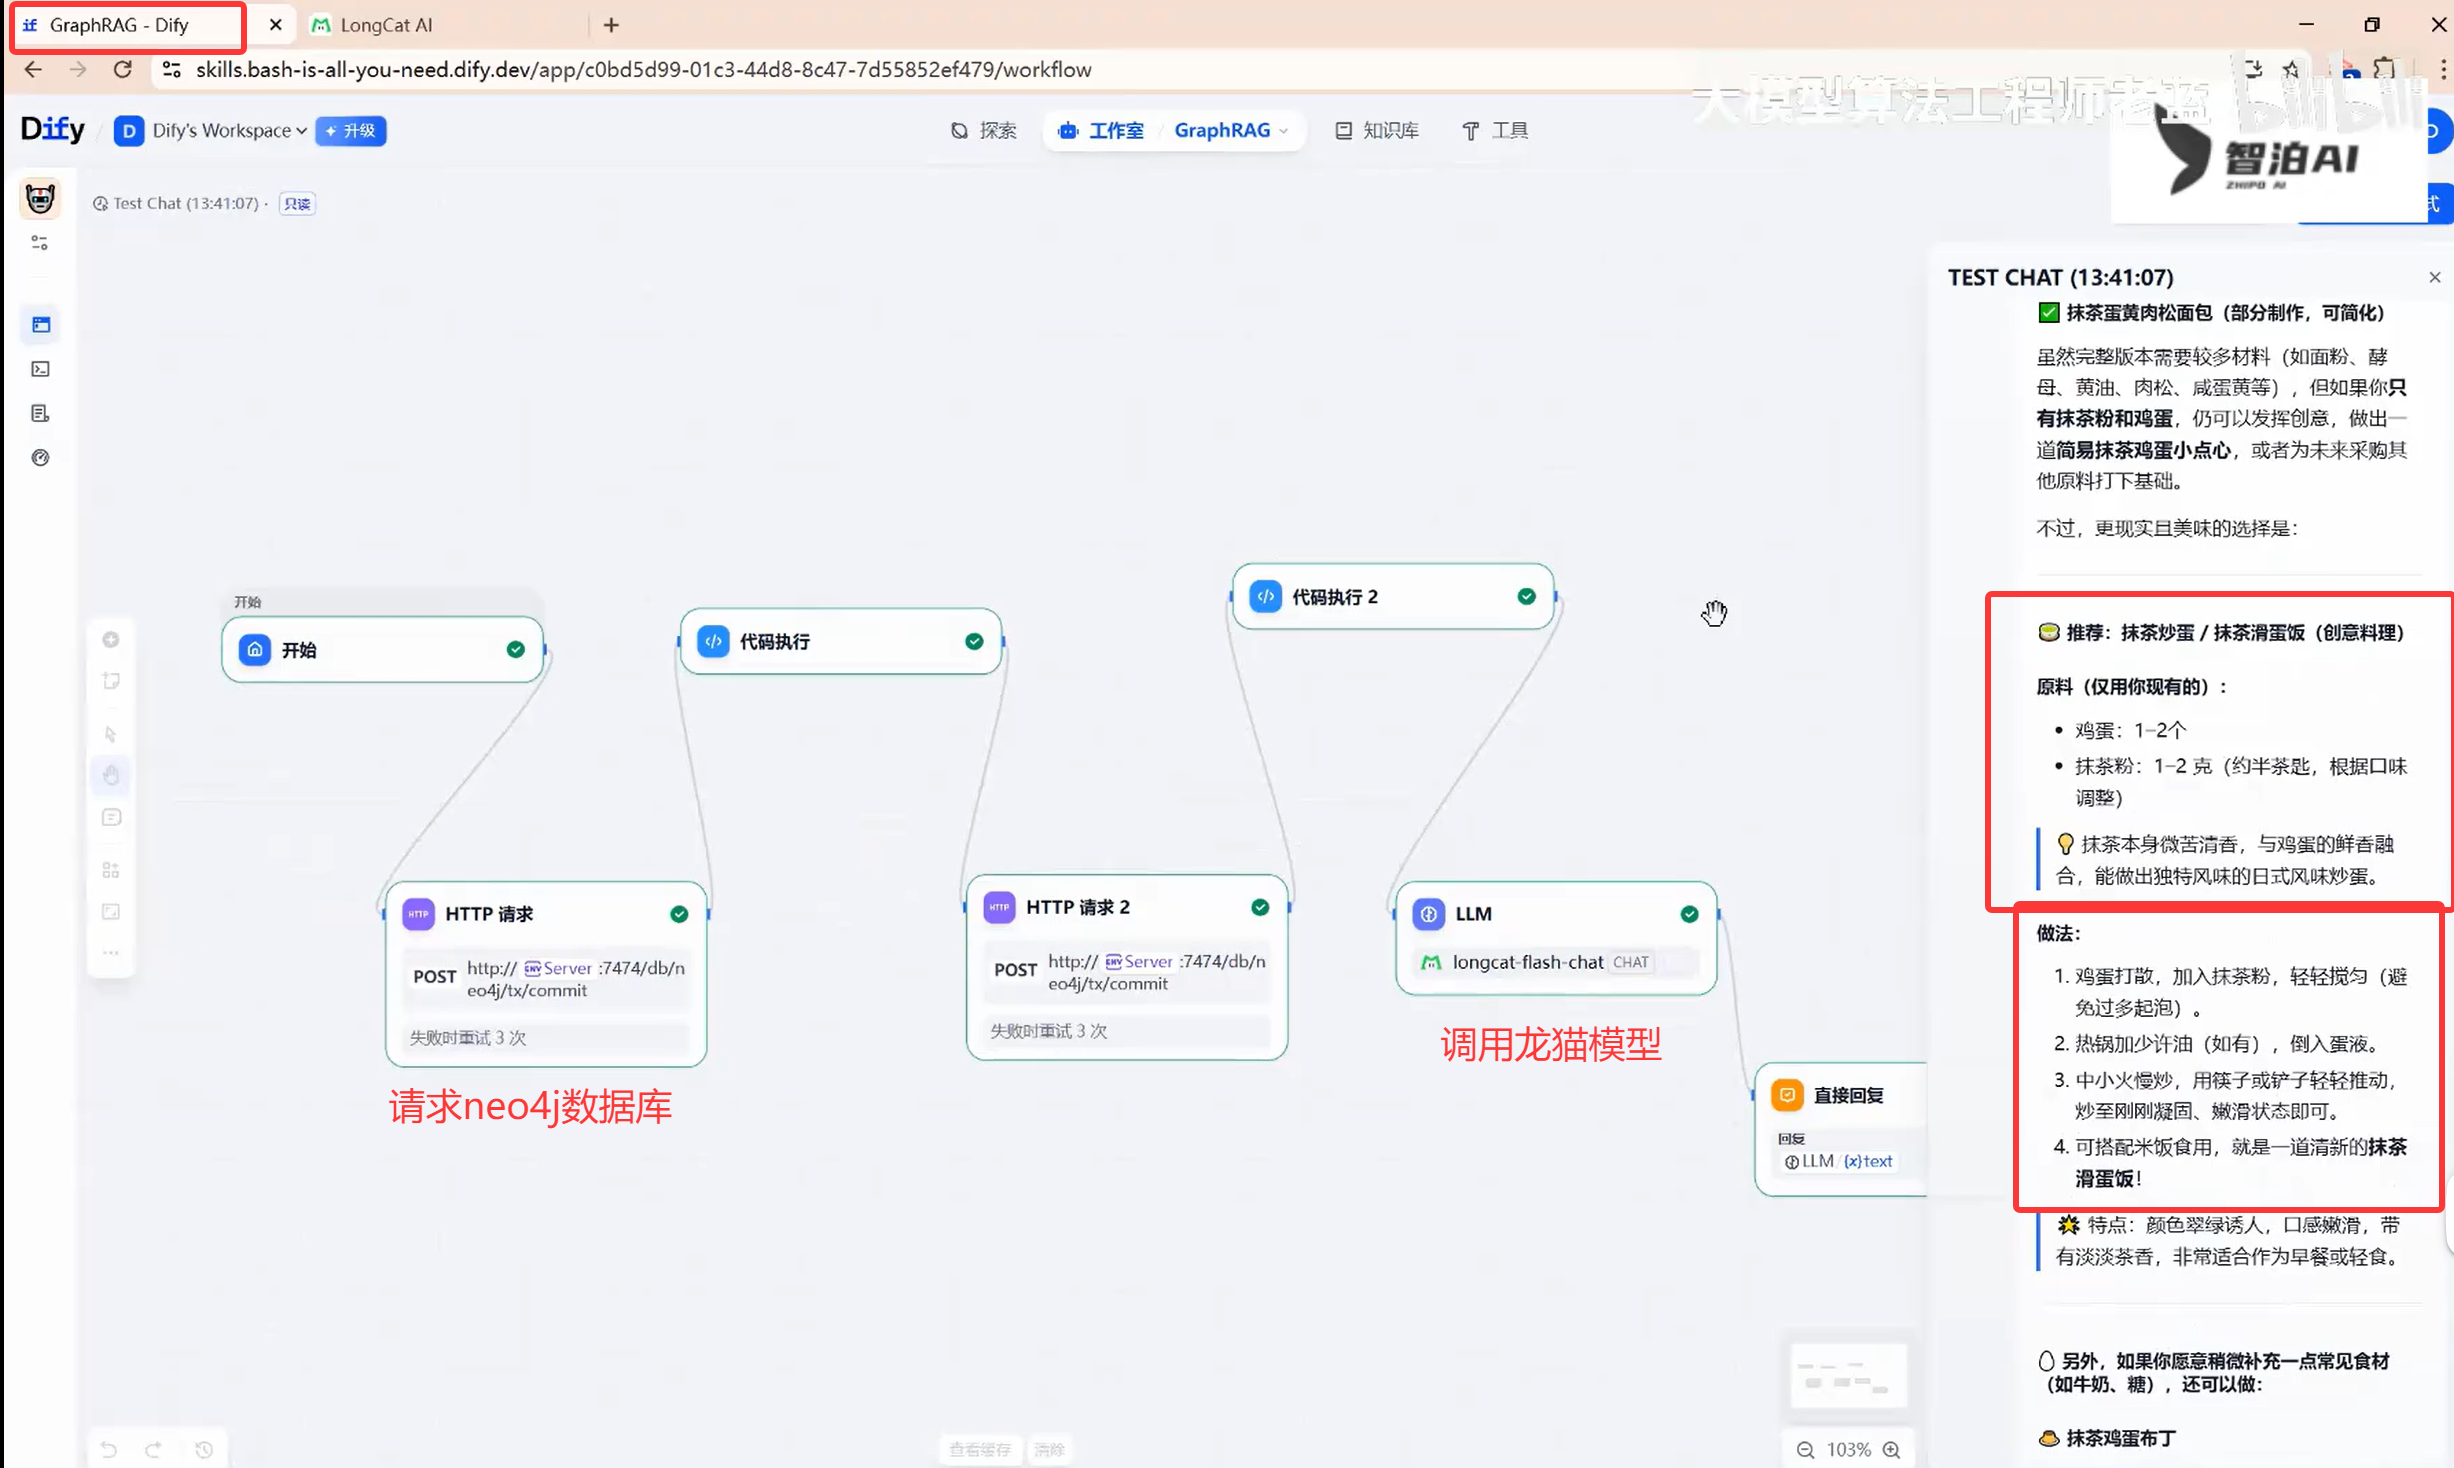
1.进行HTTP请求连接到neo4j数据库
2.查询用户提到的内容
3.第二个HTTP请求:将字段进行整理
4.传给美团龙猫大模型
6.输出答案
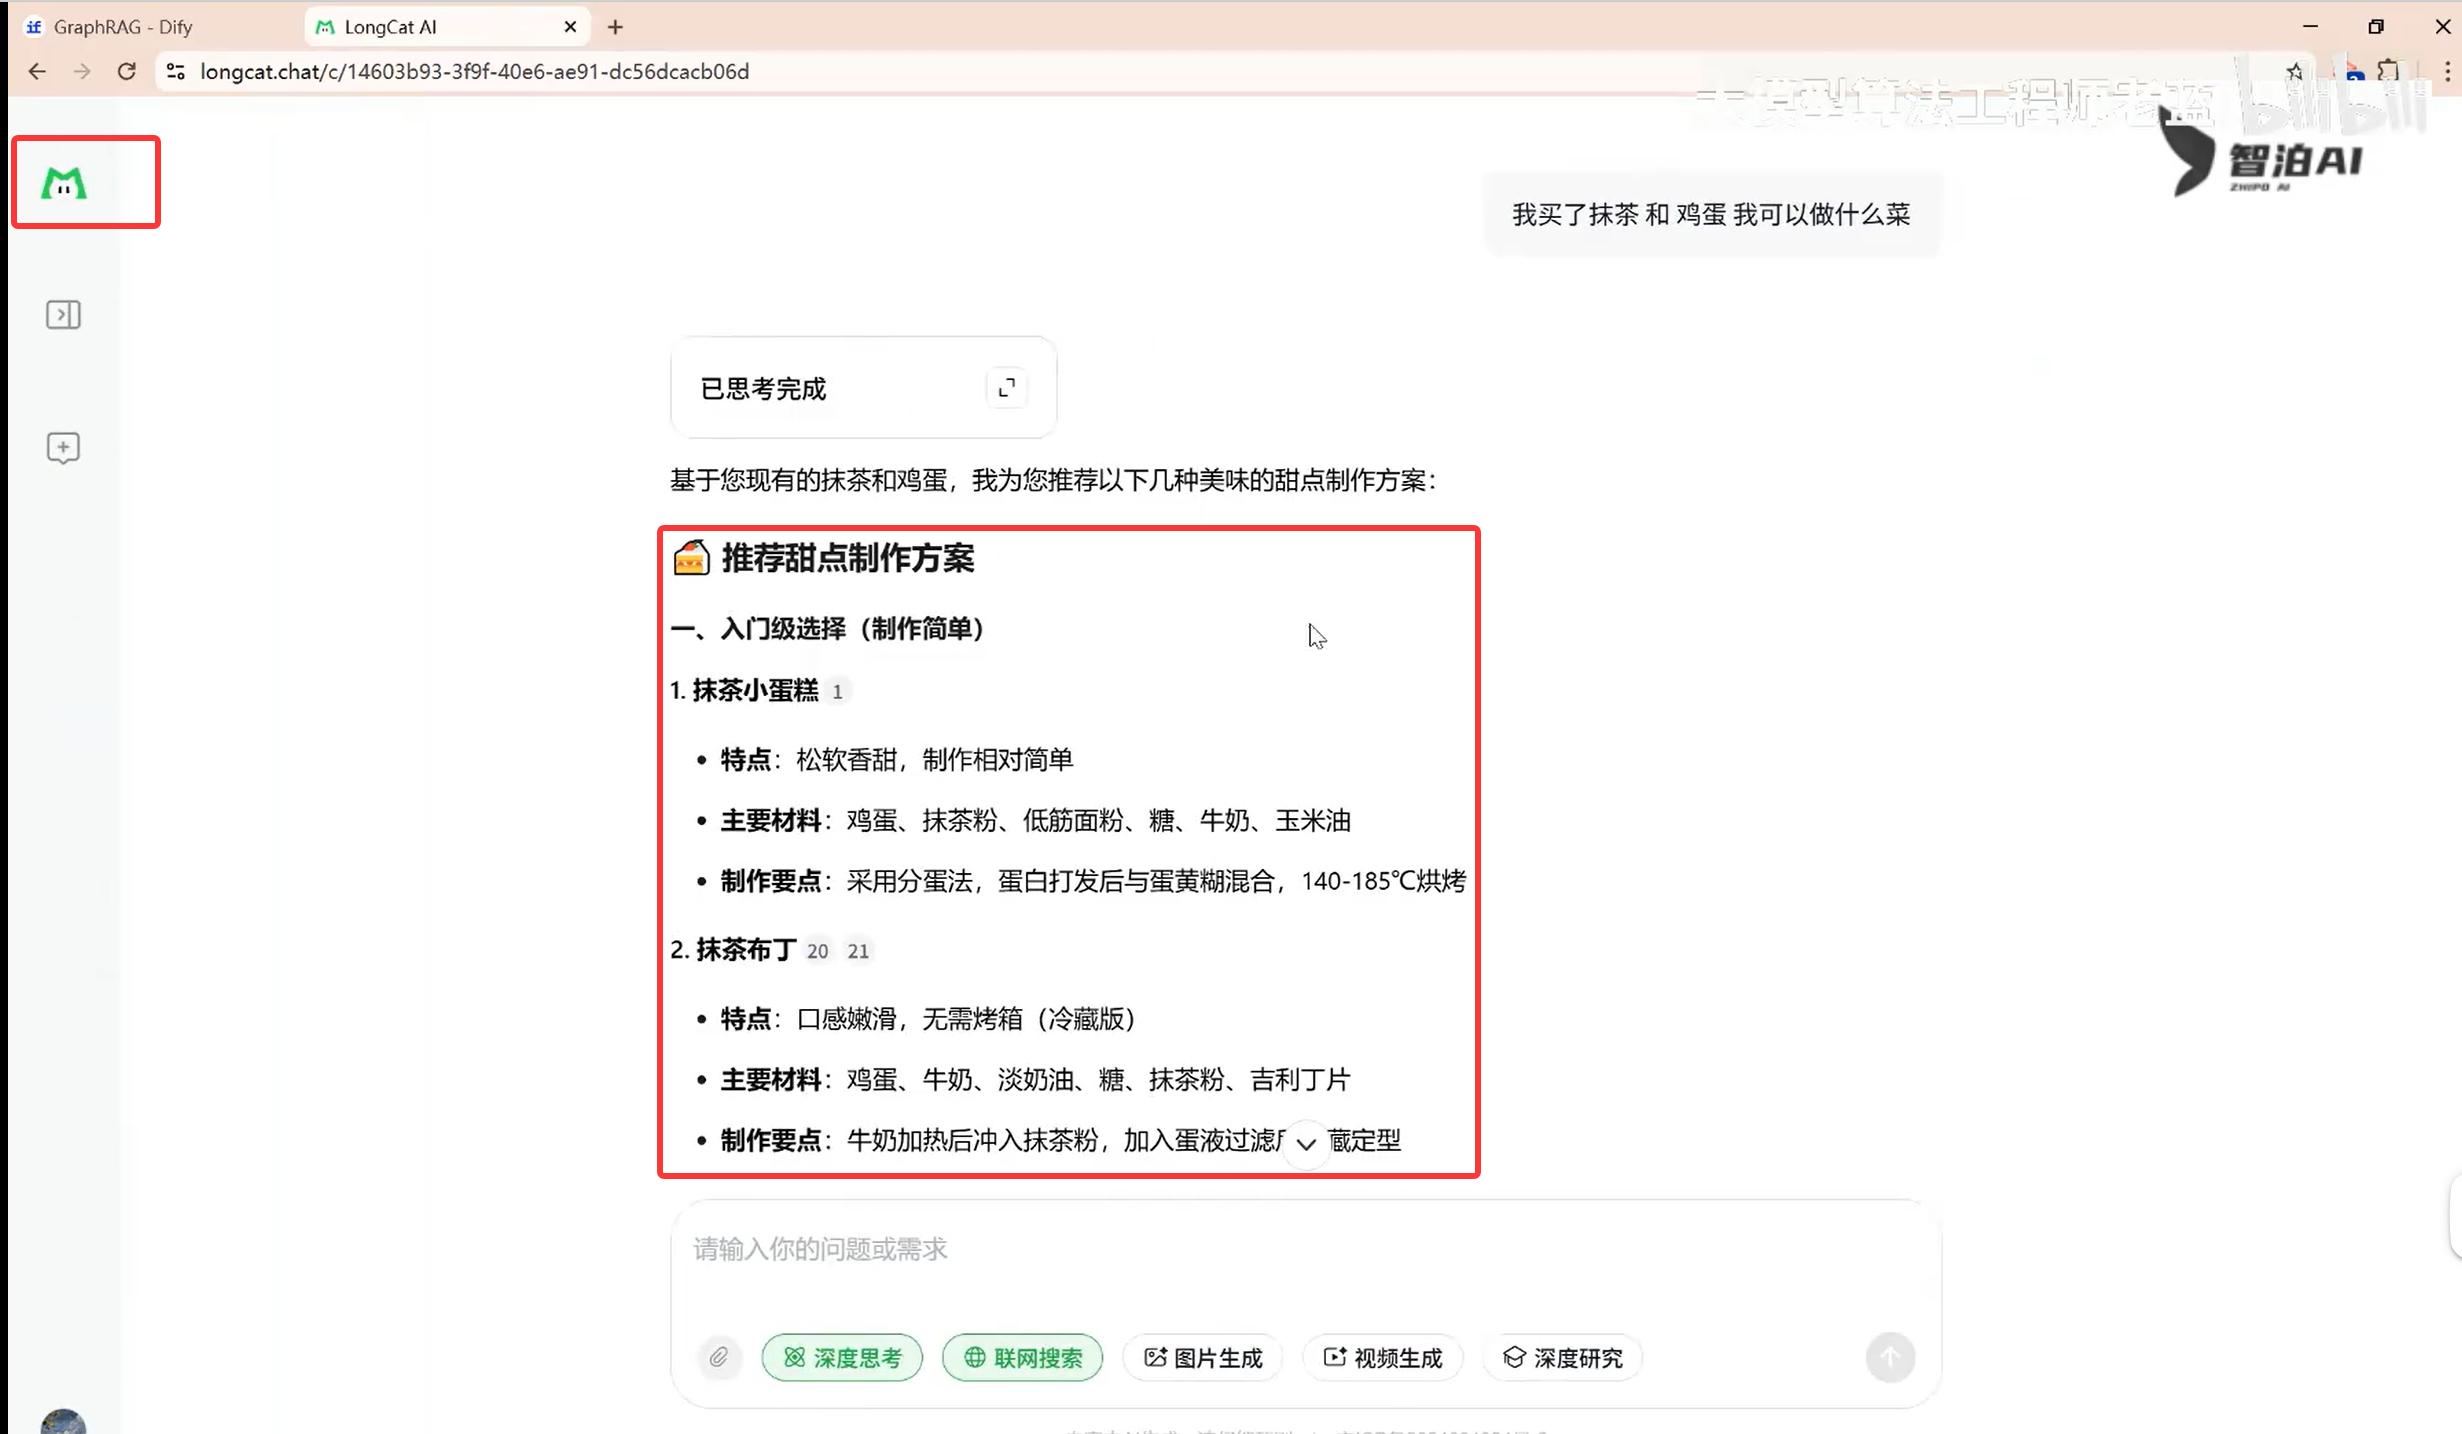
直接调用美团龙猫模型的回答,比较苍白
七、RAG实战-基于LangChain框架构建RAG系统
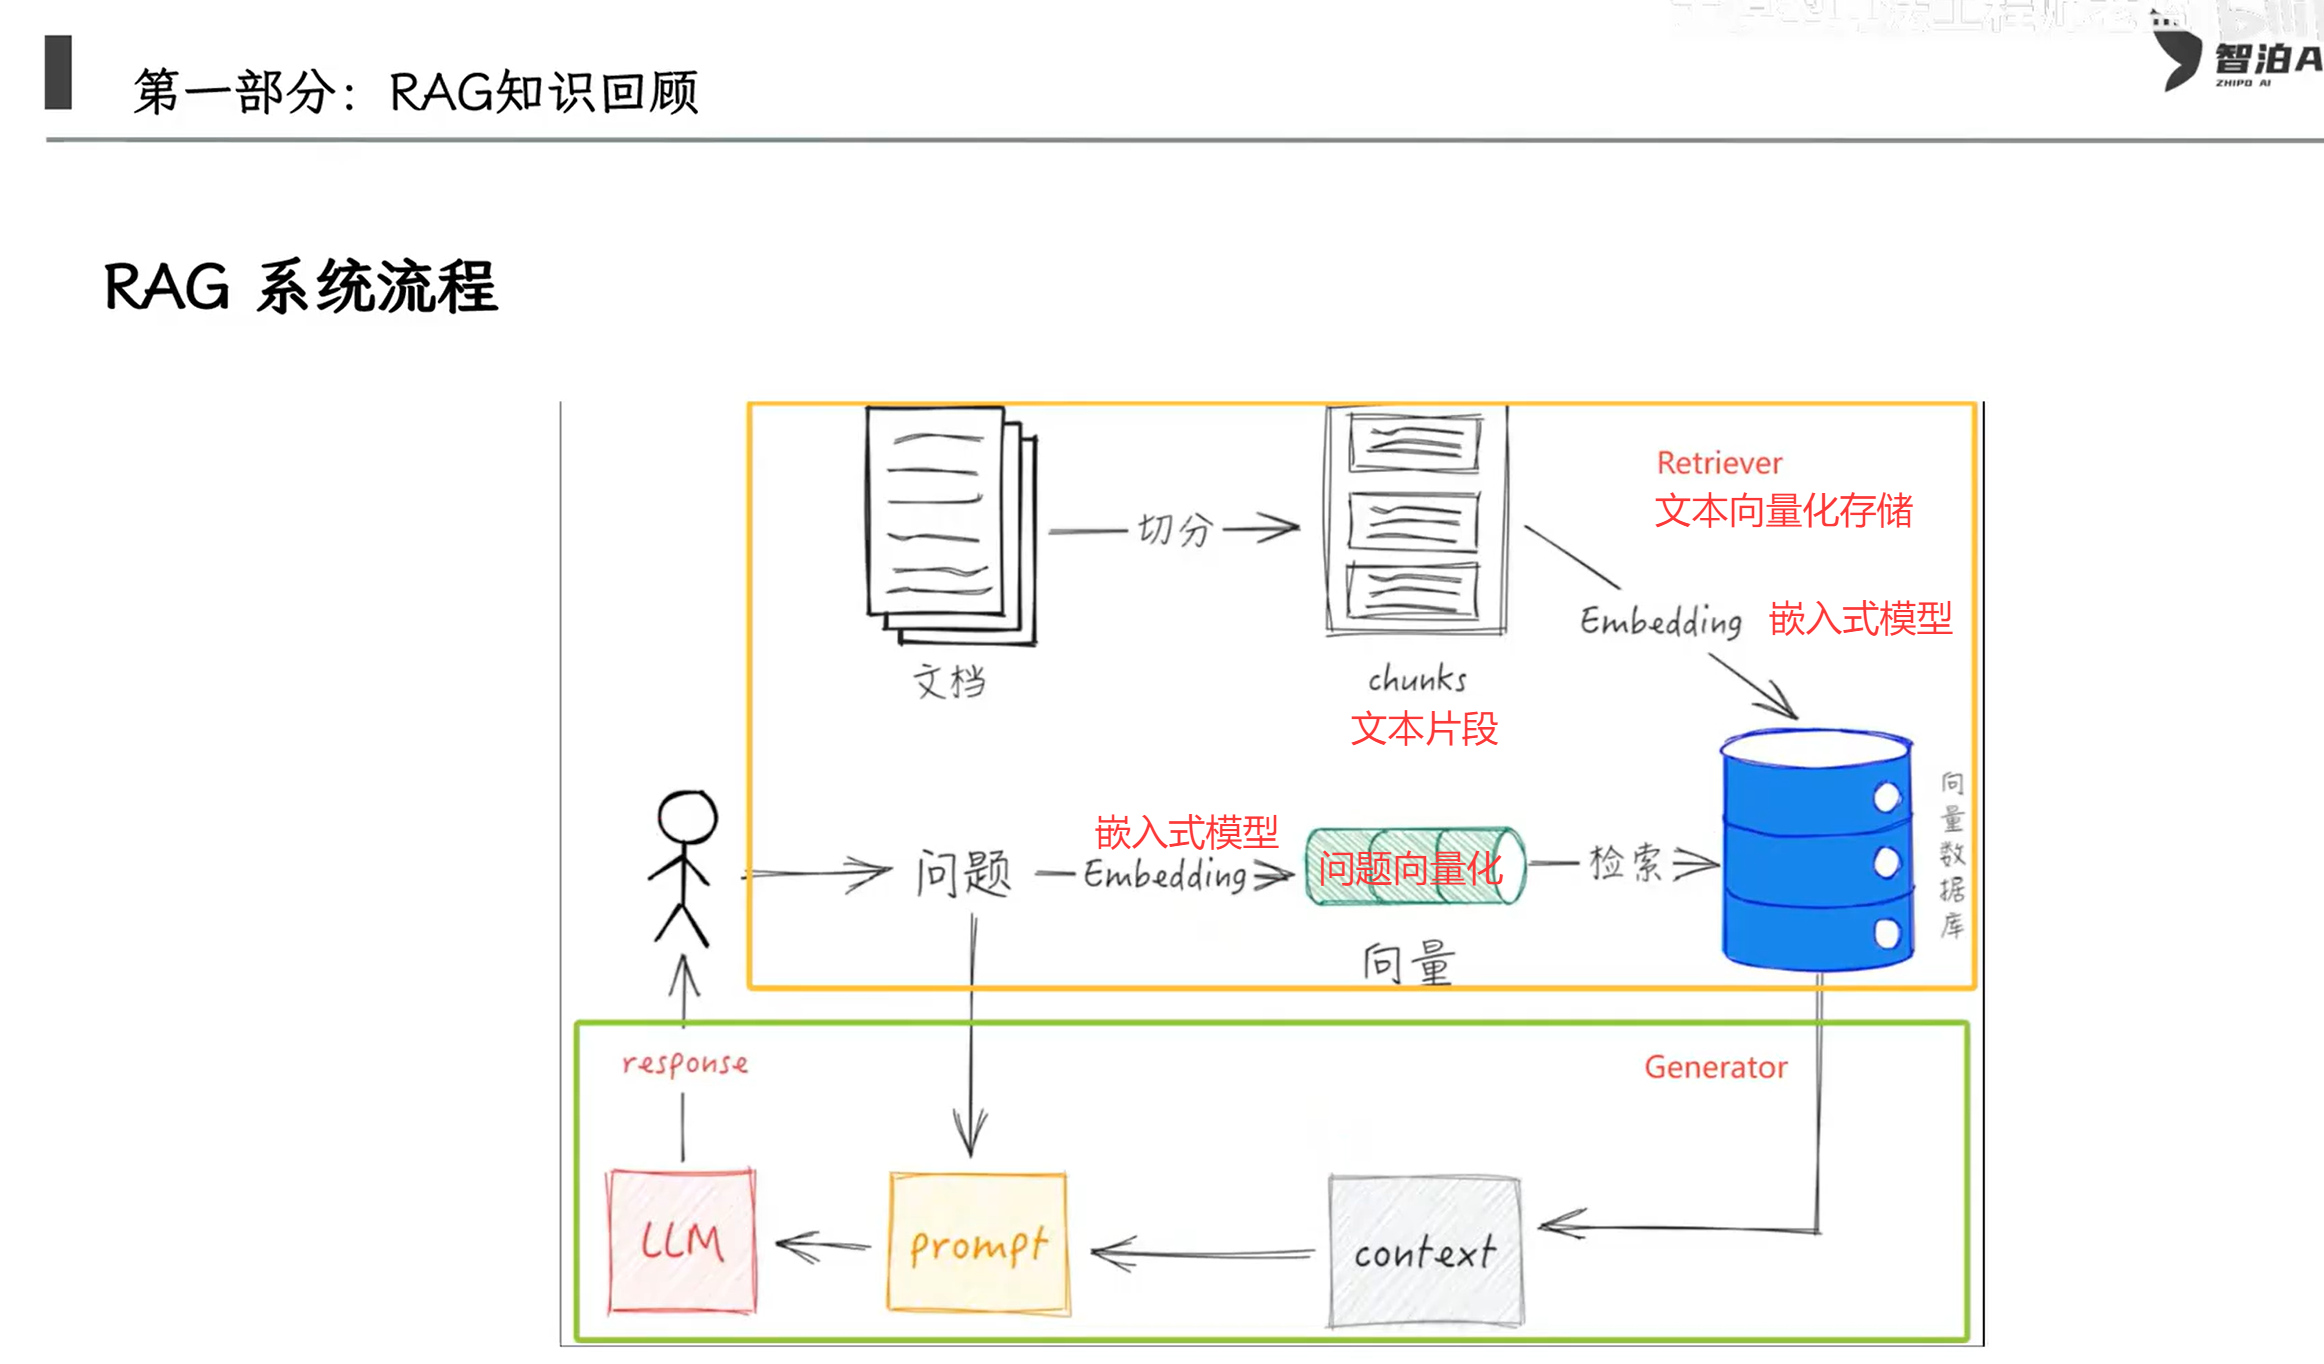
7.1 RAG知识回顾
RAG技术搭建流程
7.2 模型介绍
RAG系统模型接入
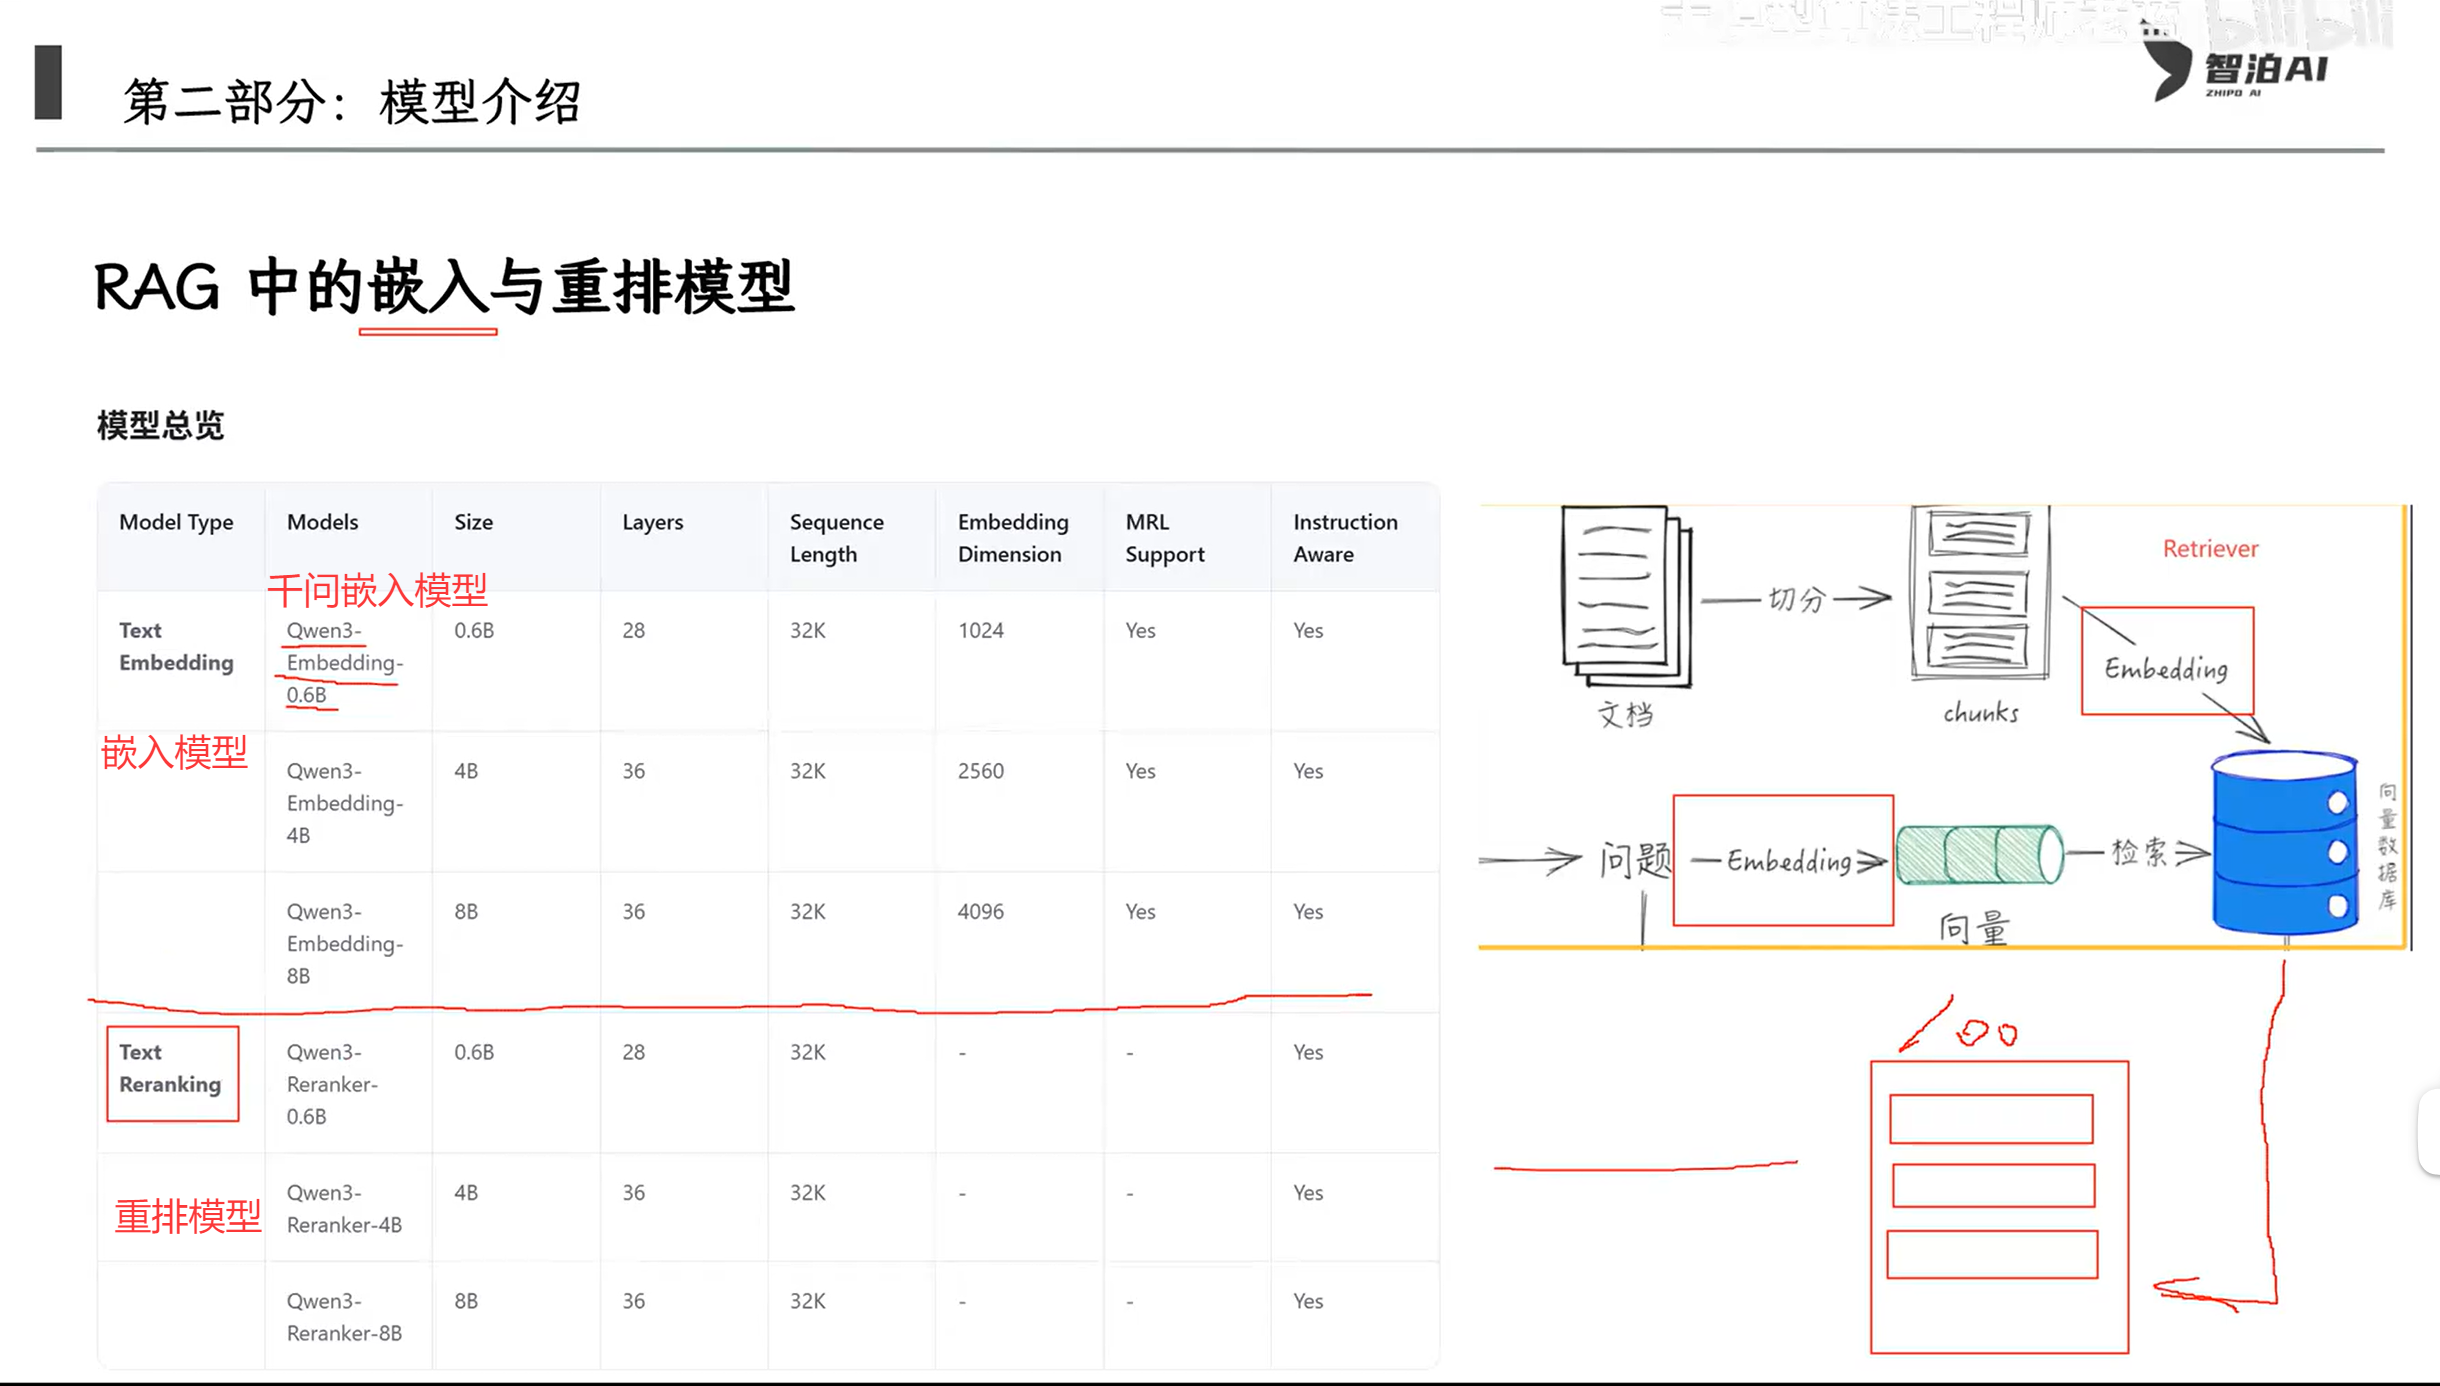
还需要使用大语言模型:选用千问的为例,选择下面四款中,最推荐的那个
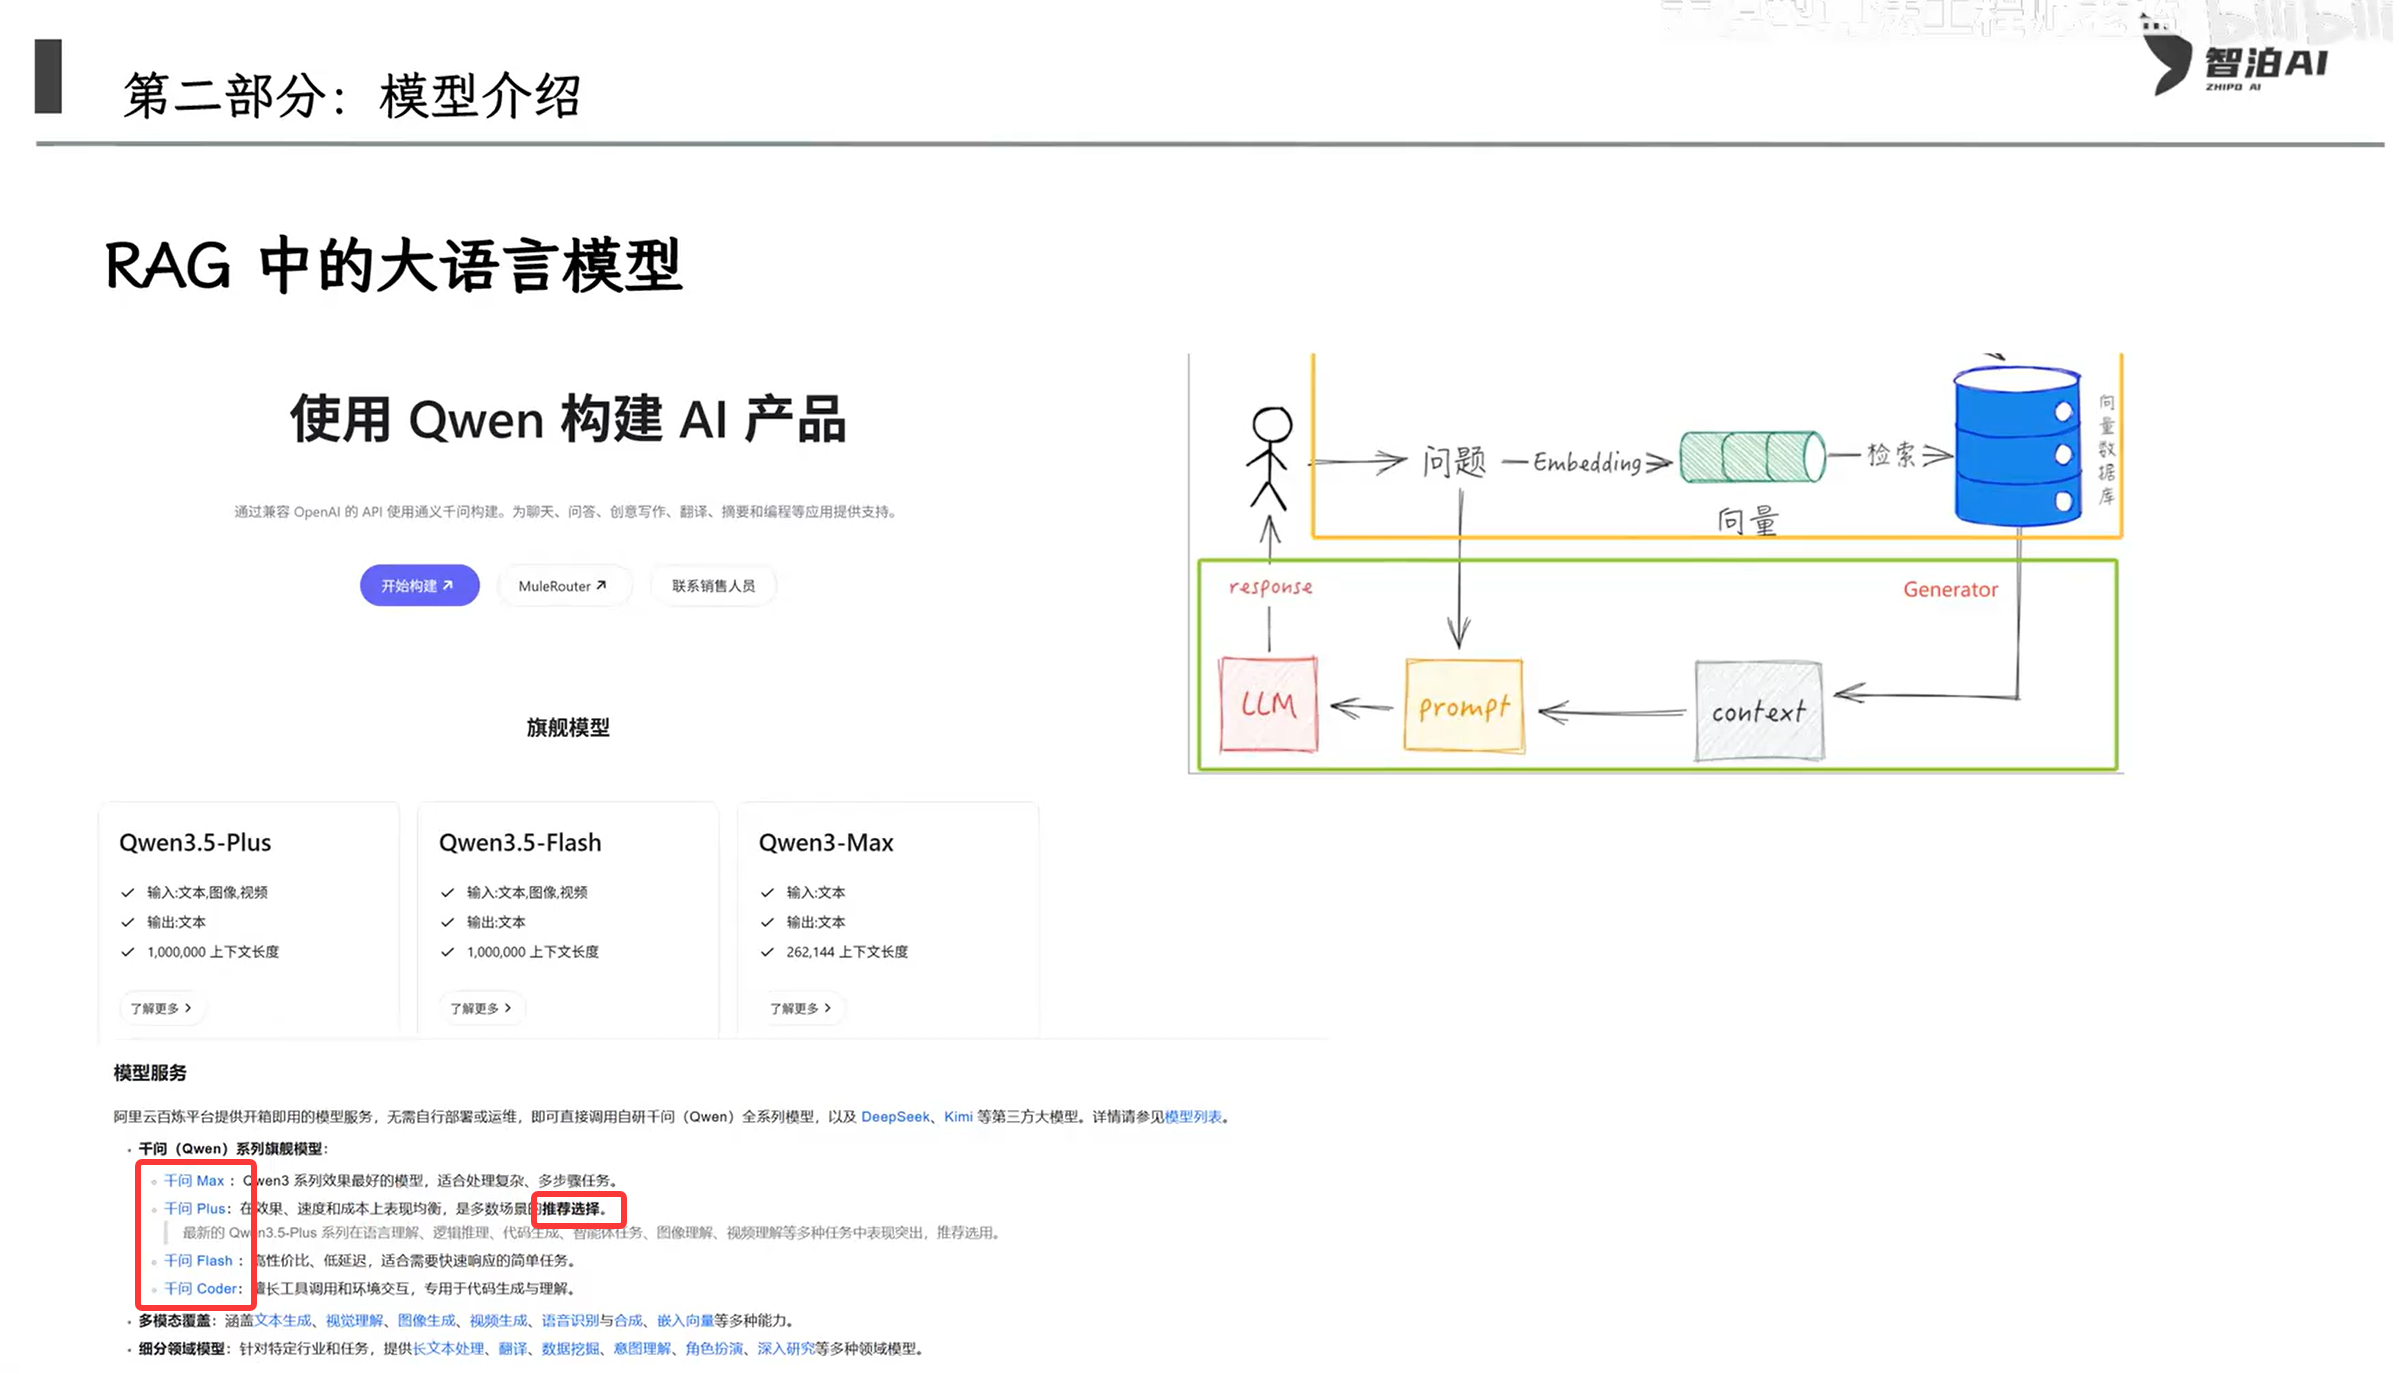
选择合适的框架进行构建
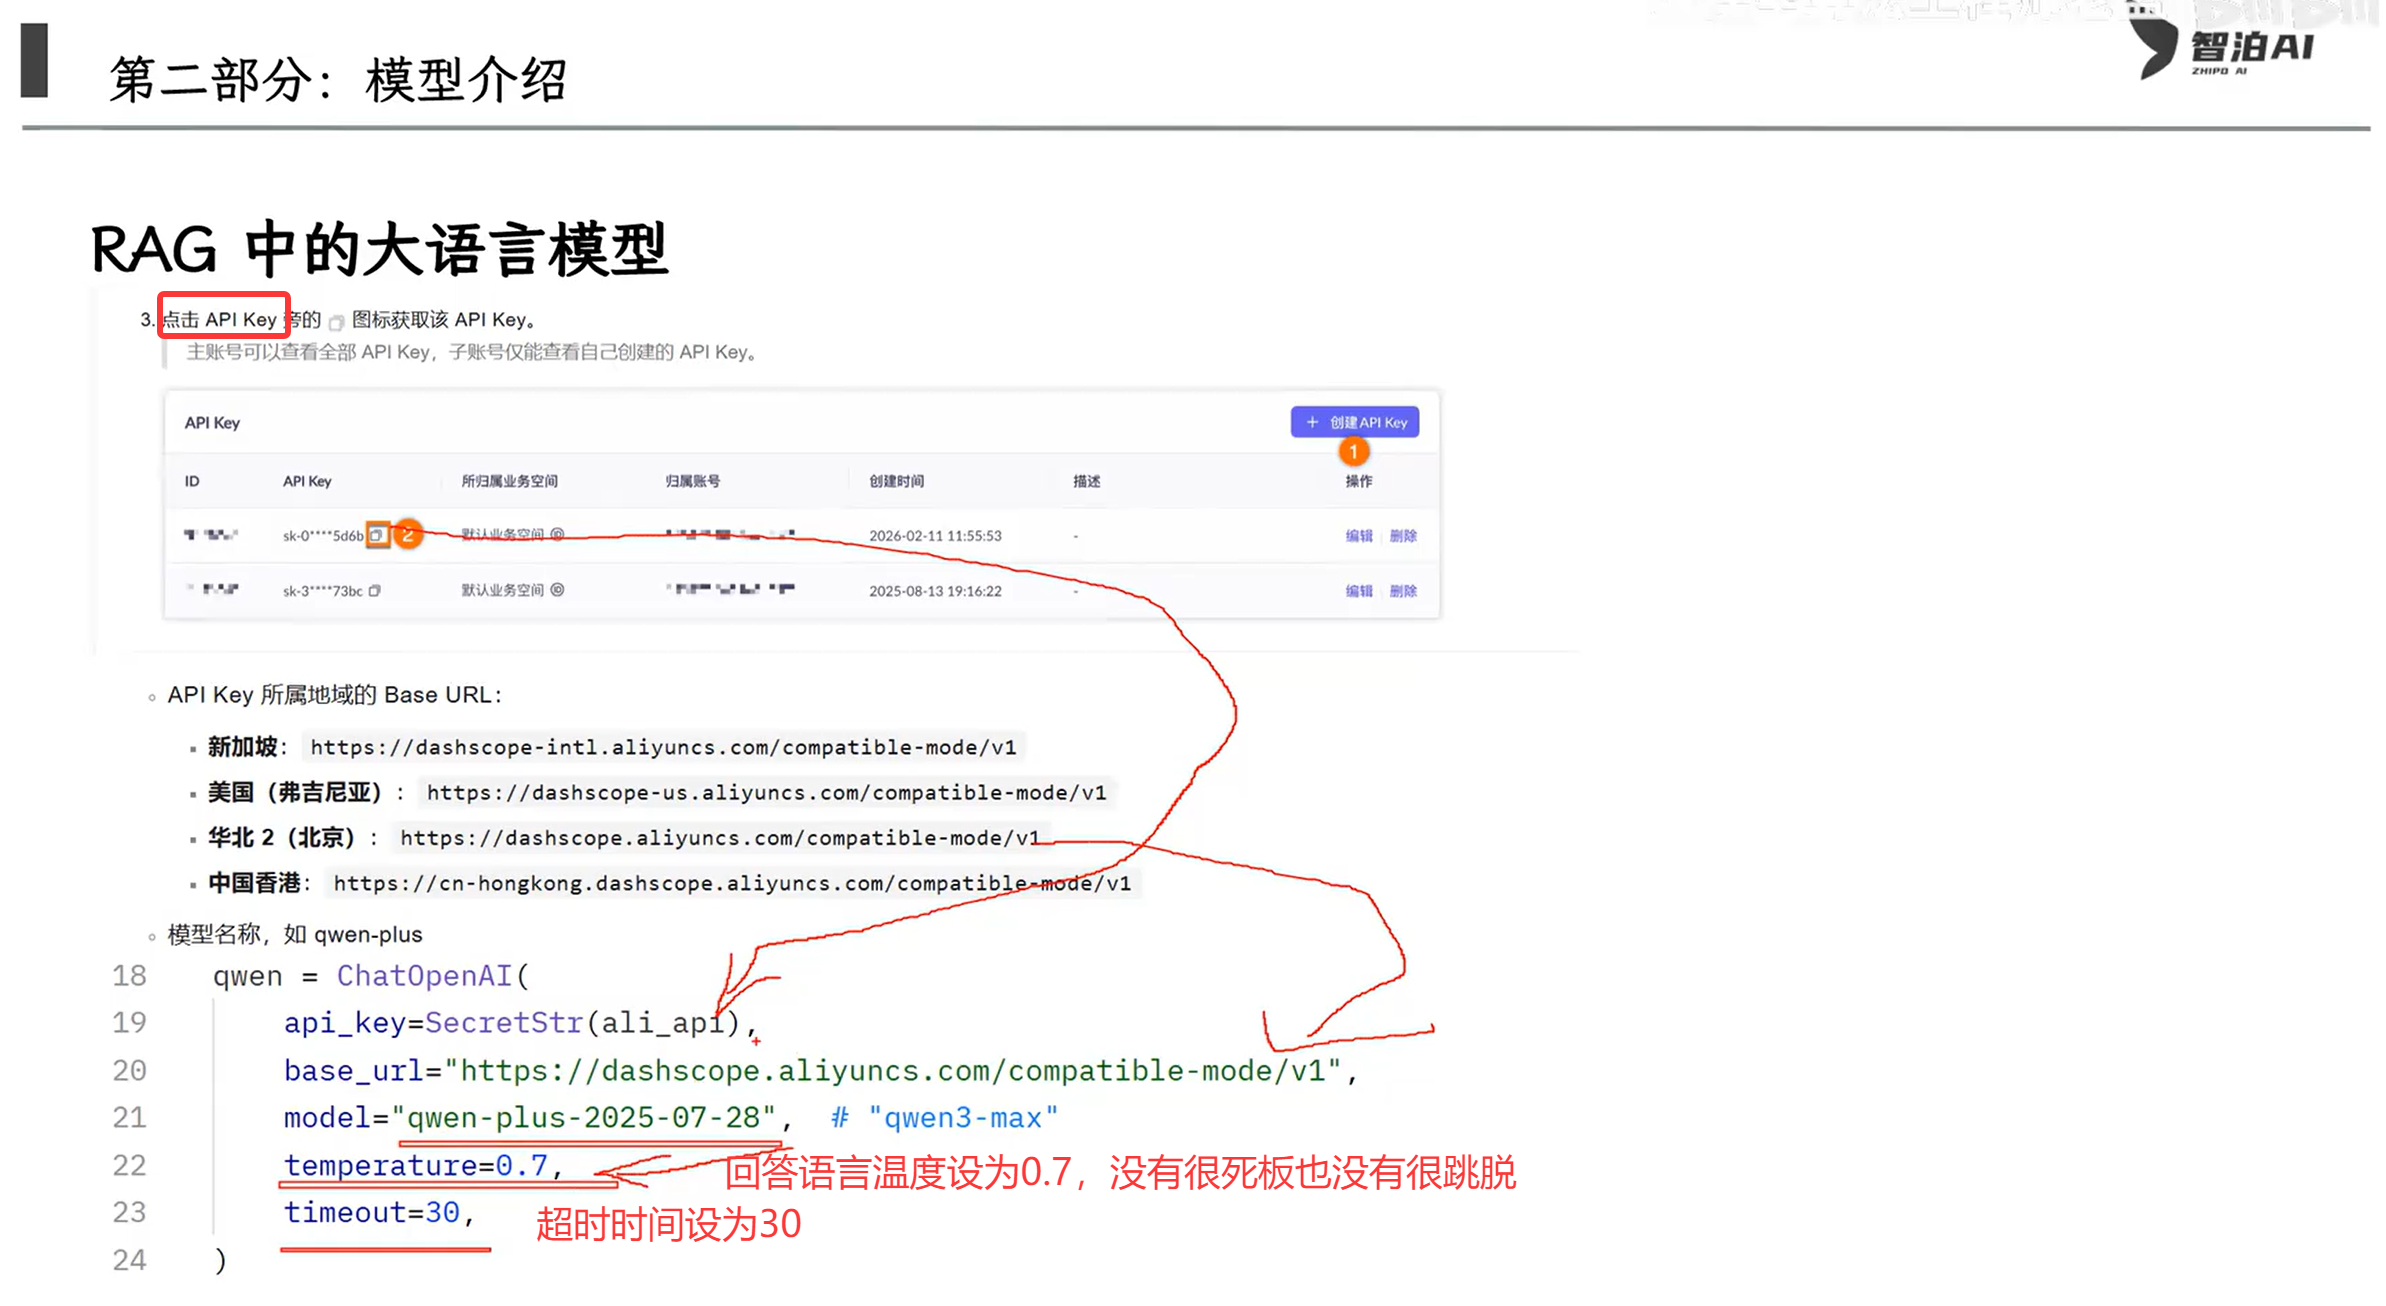
7.3 开发框架
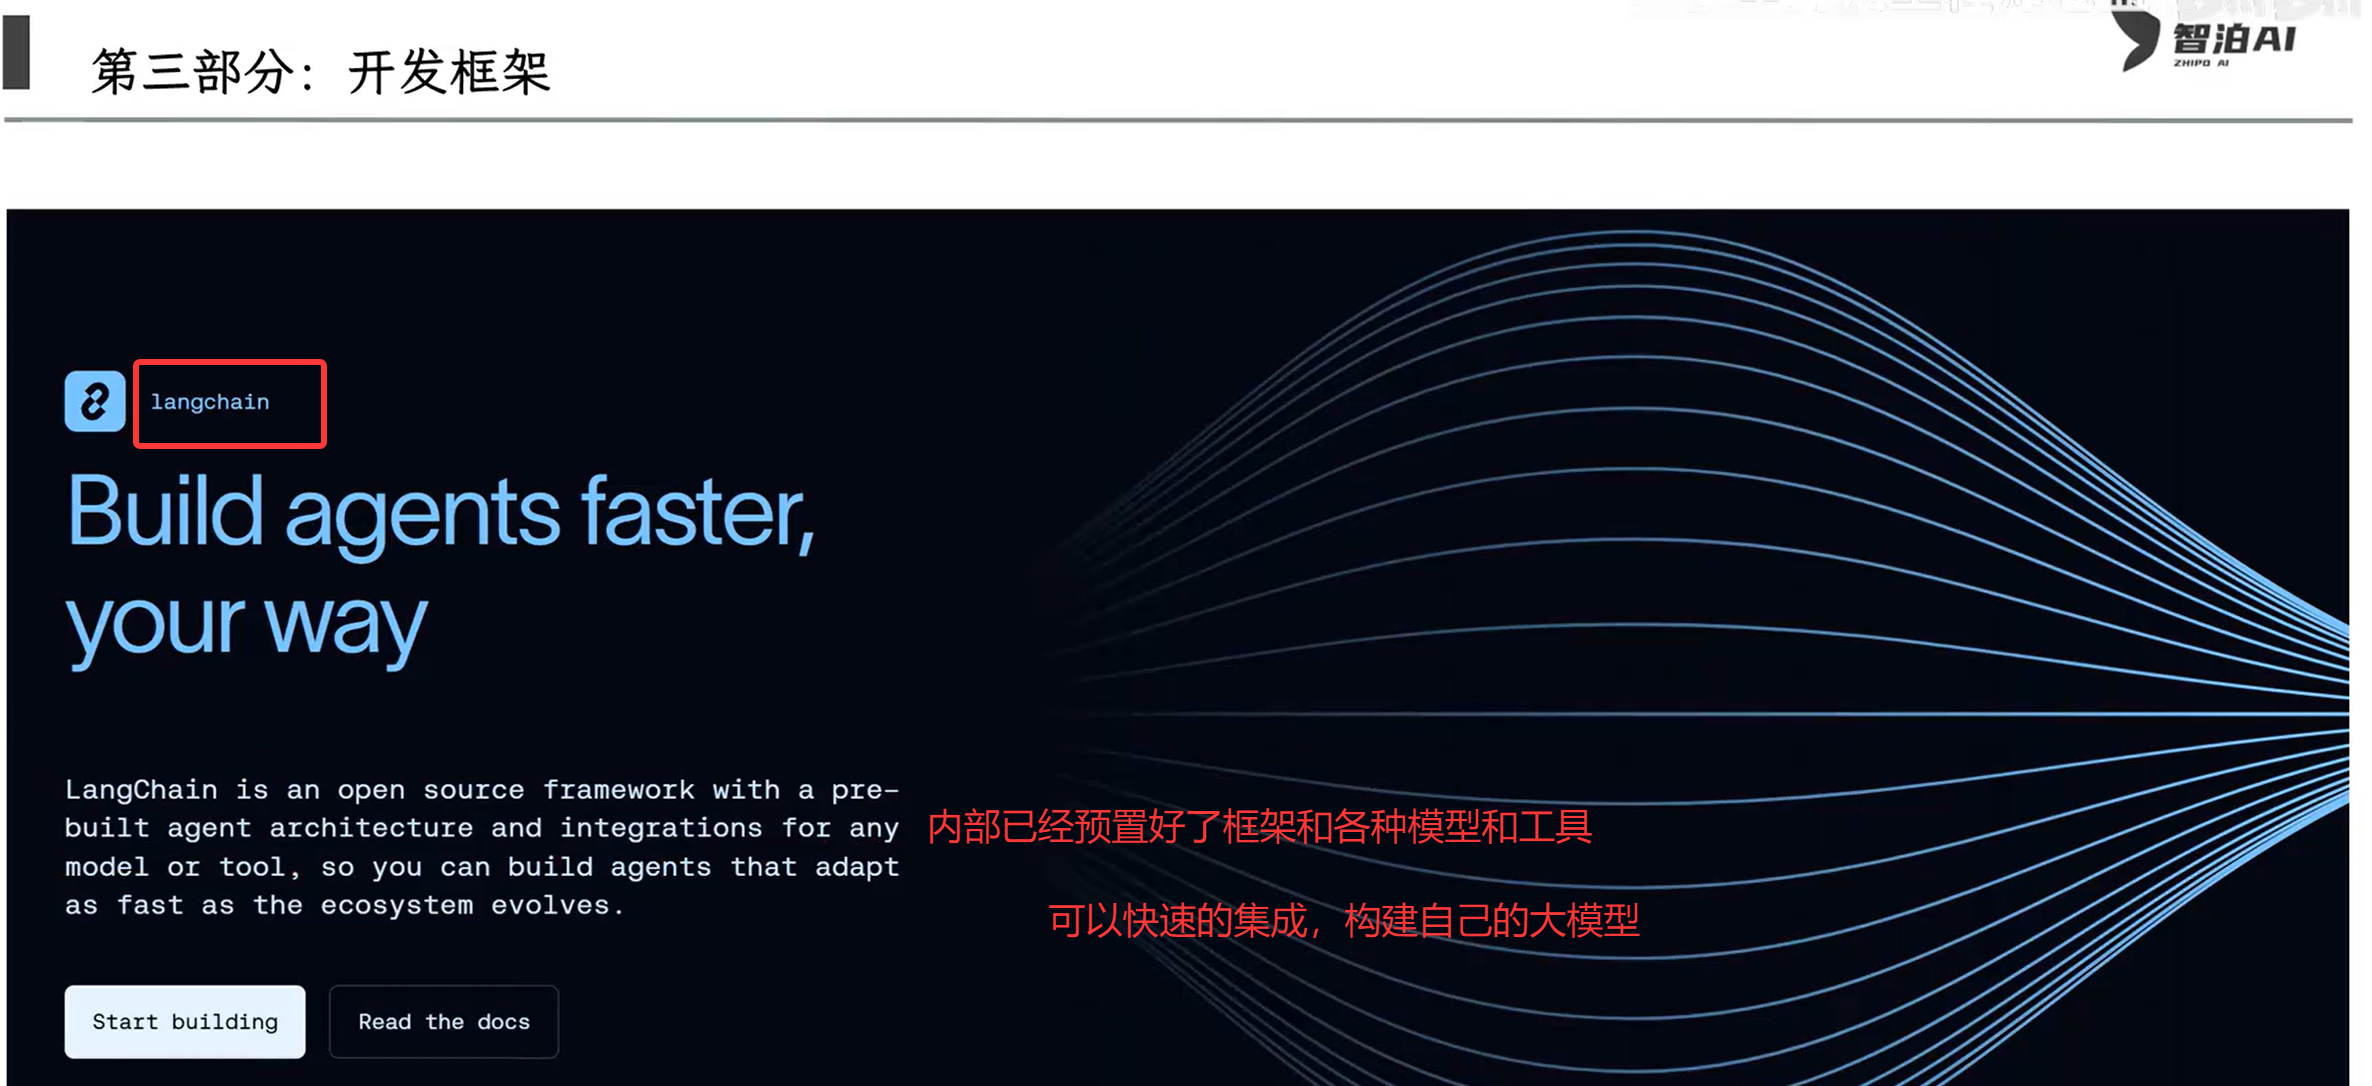
代码演示如何使用Langchain
Langchain框架
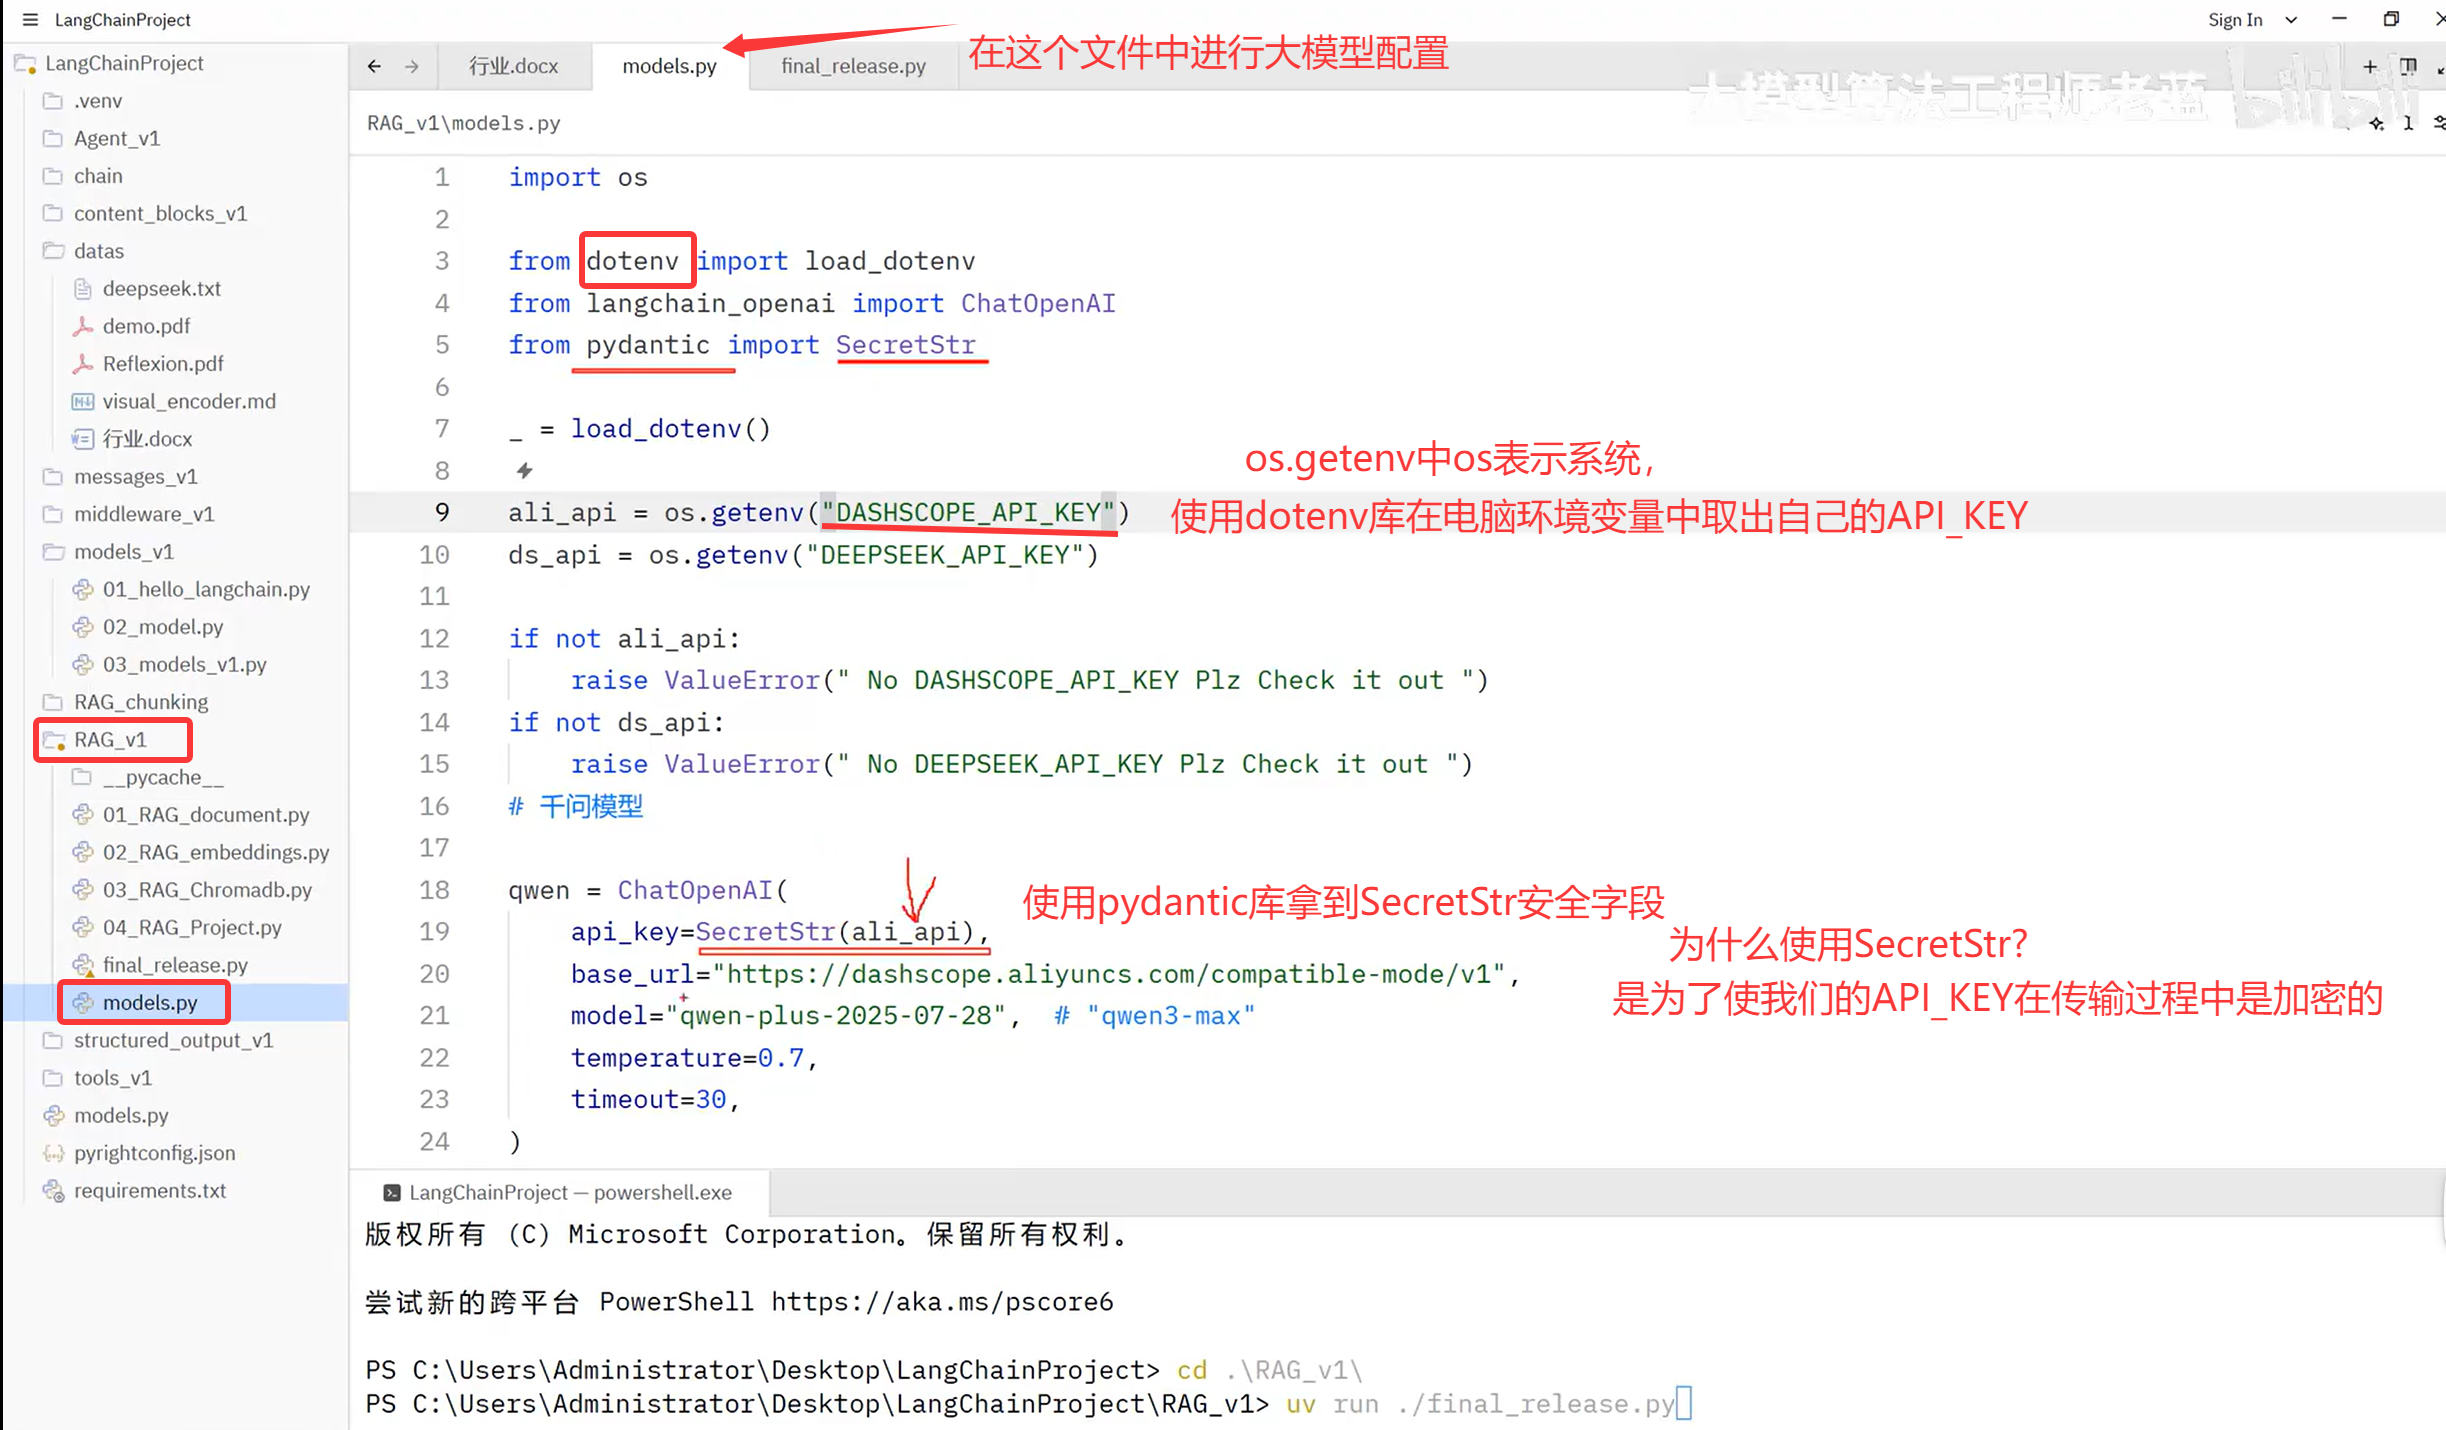
加密传输,防止其他服务获取到API_KEY
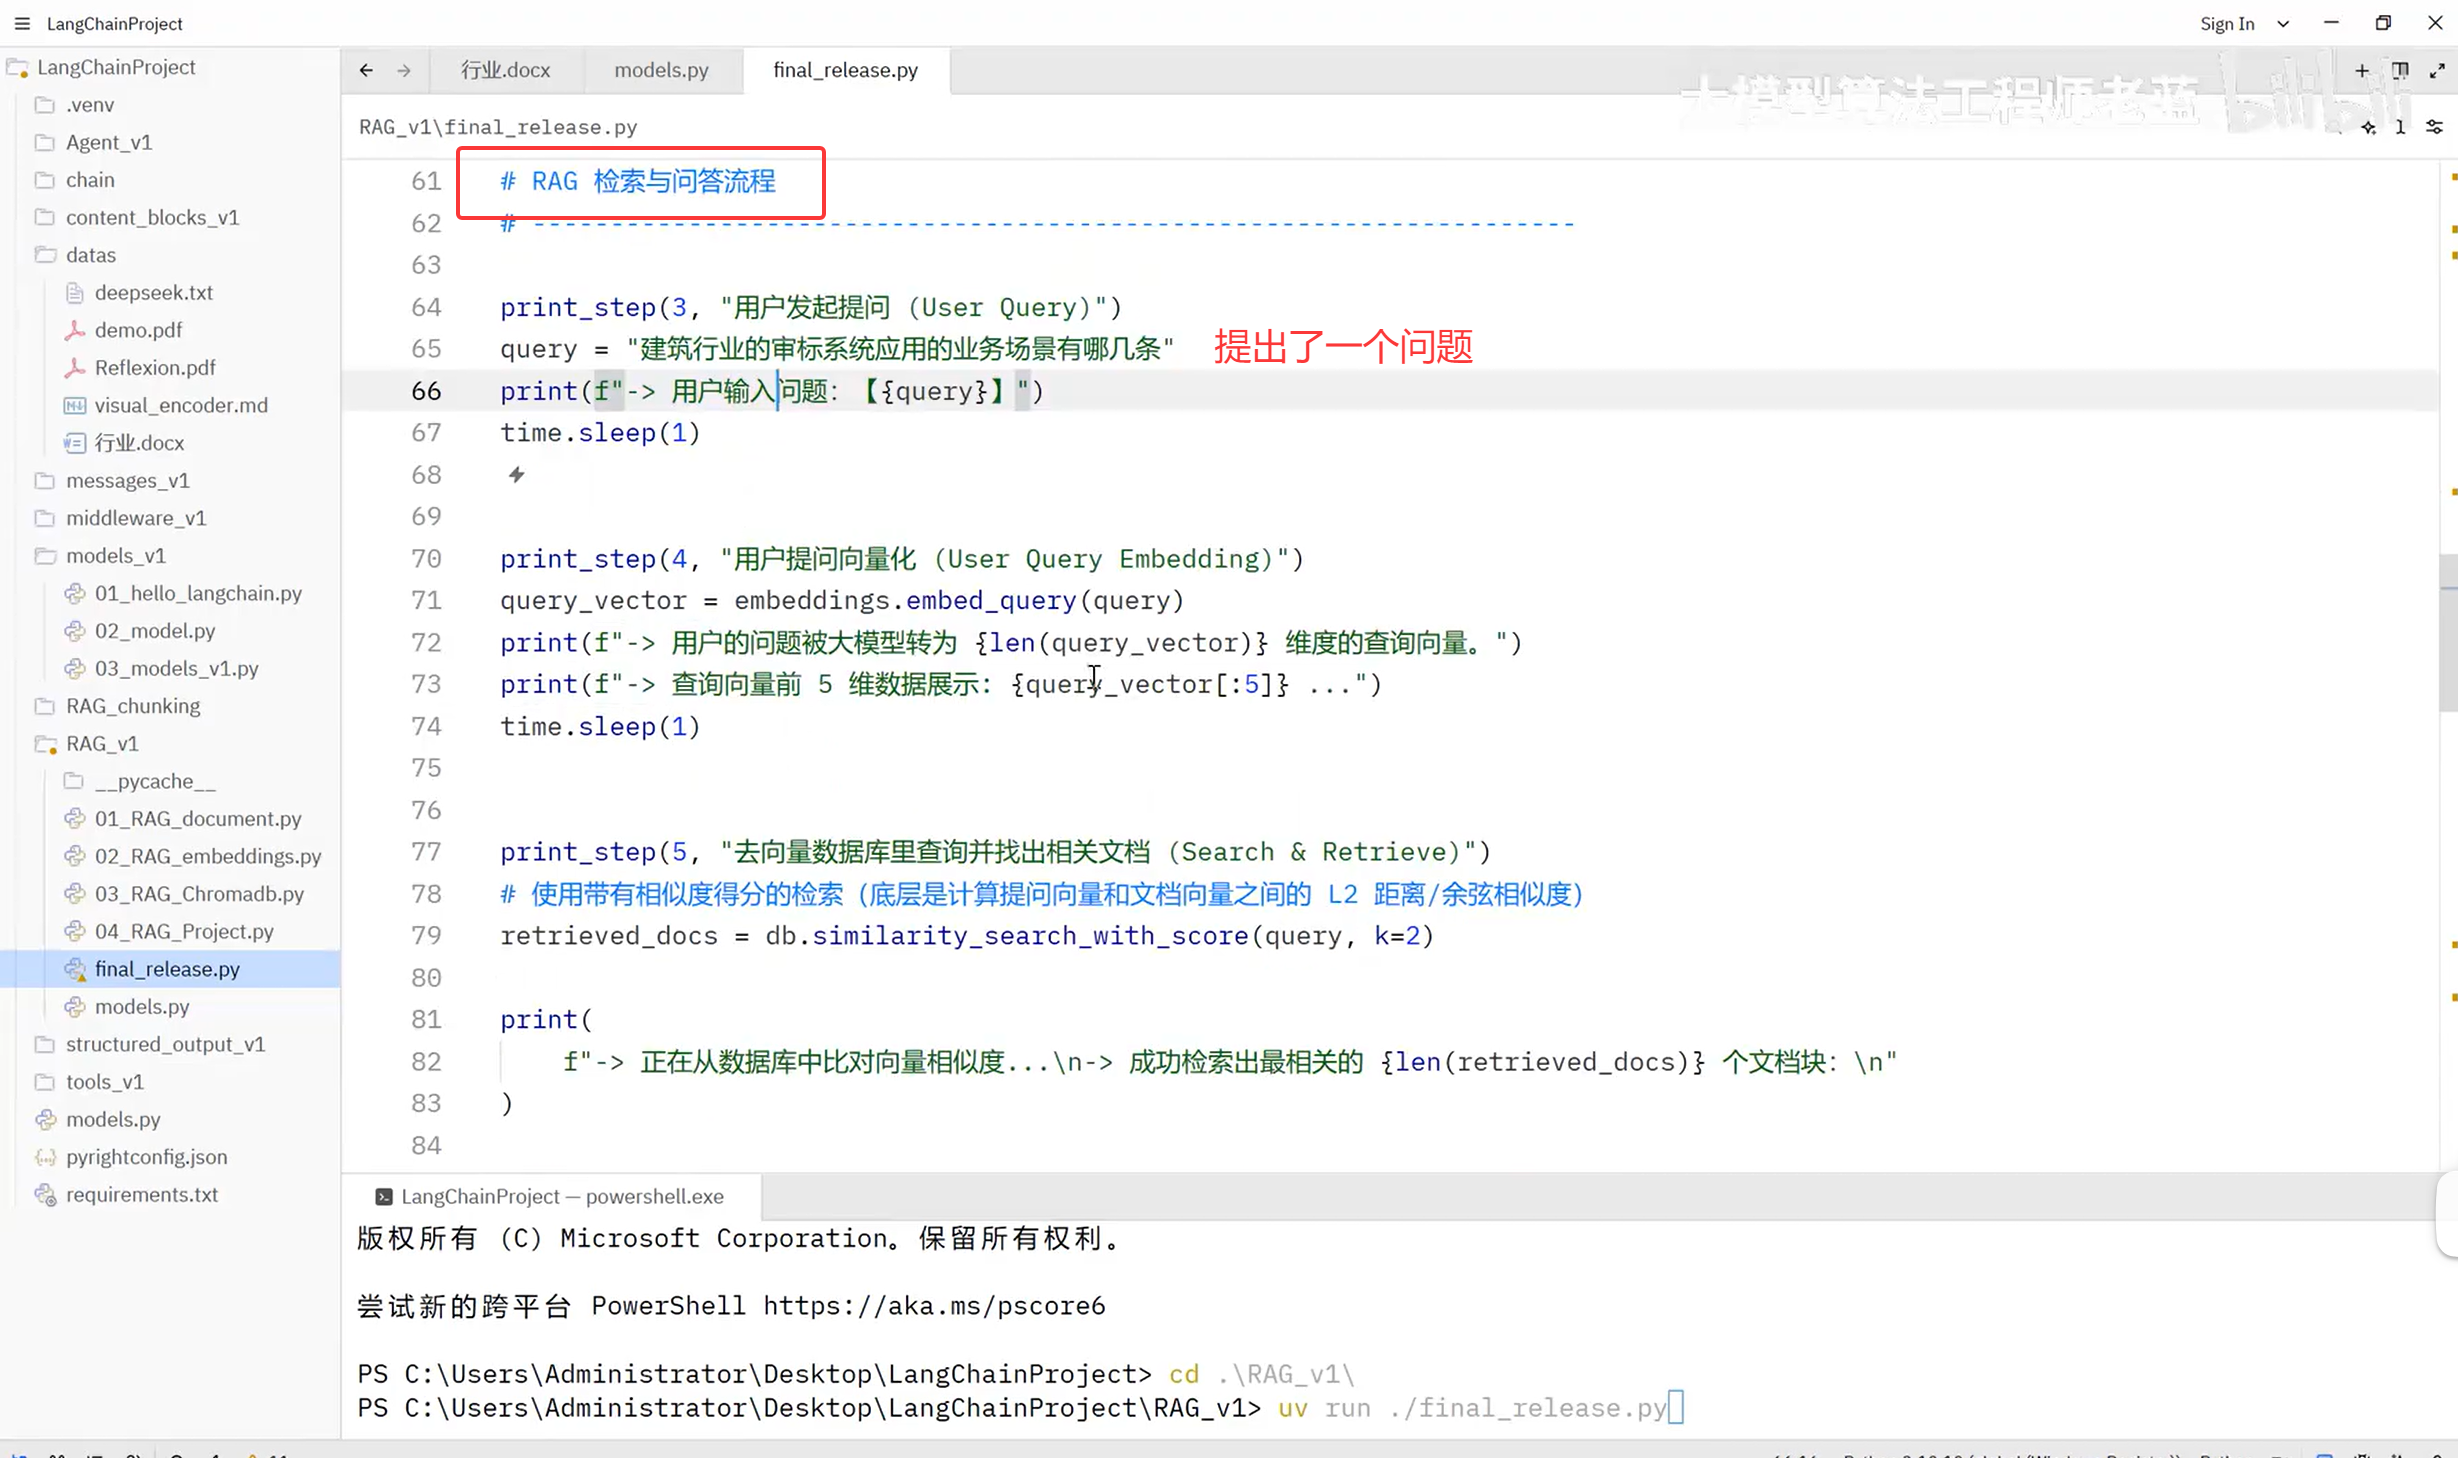
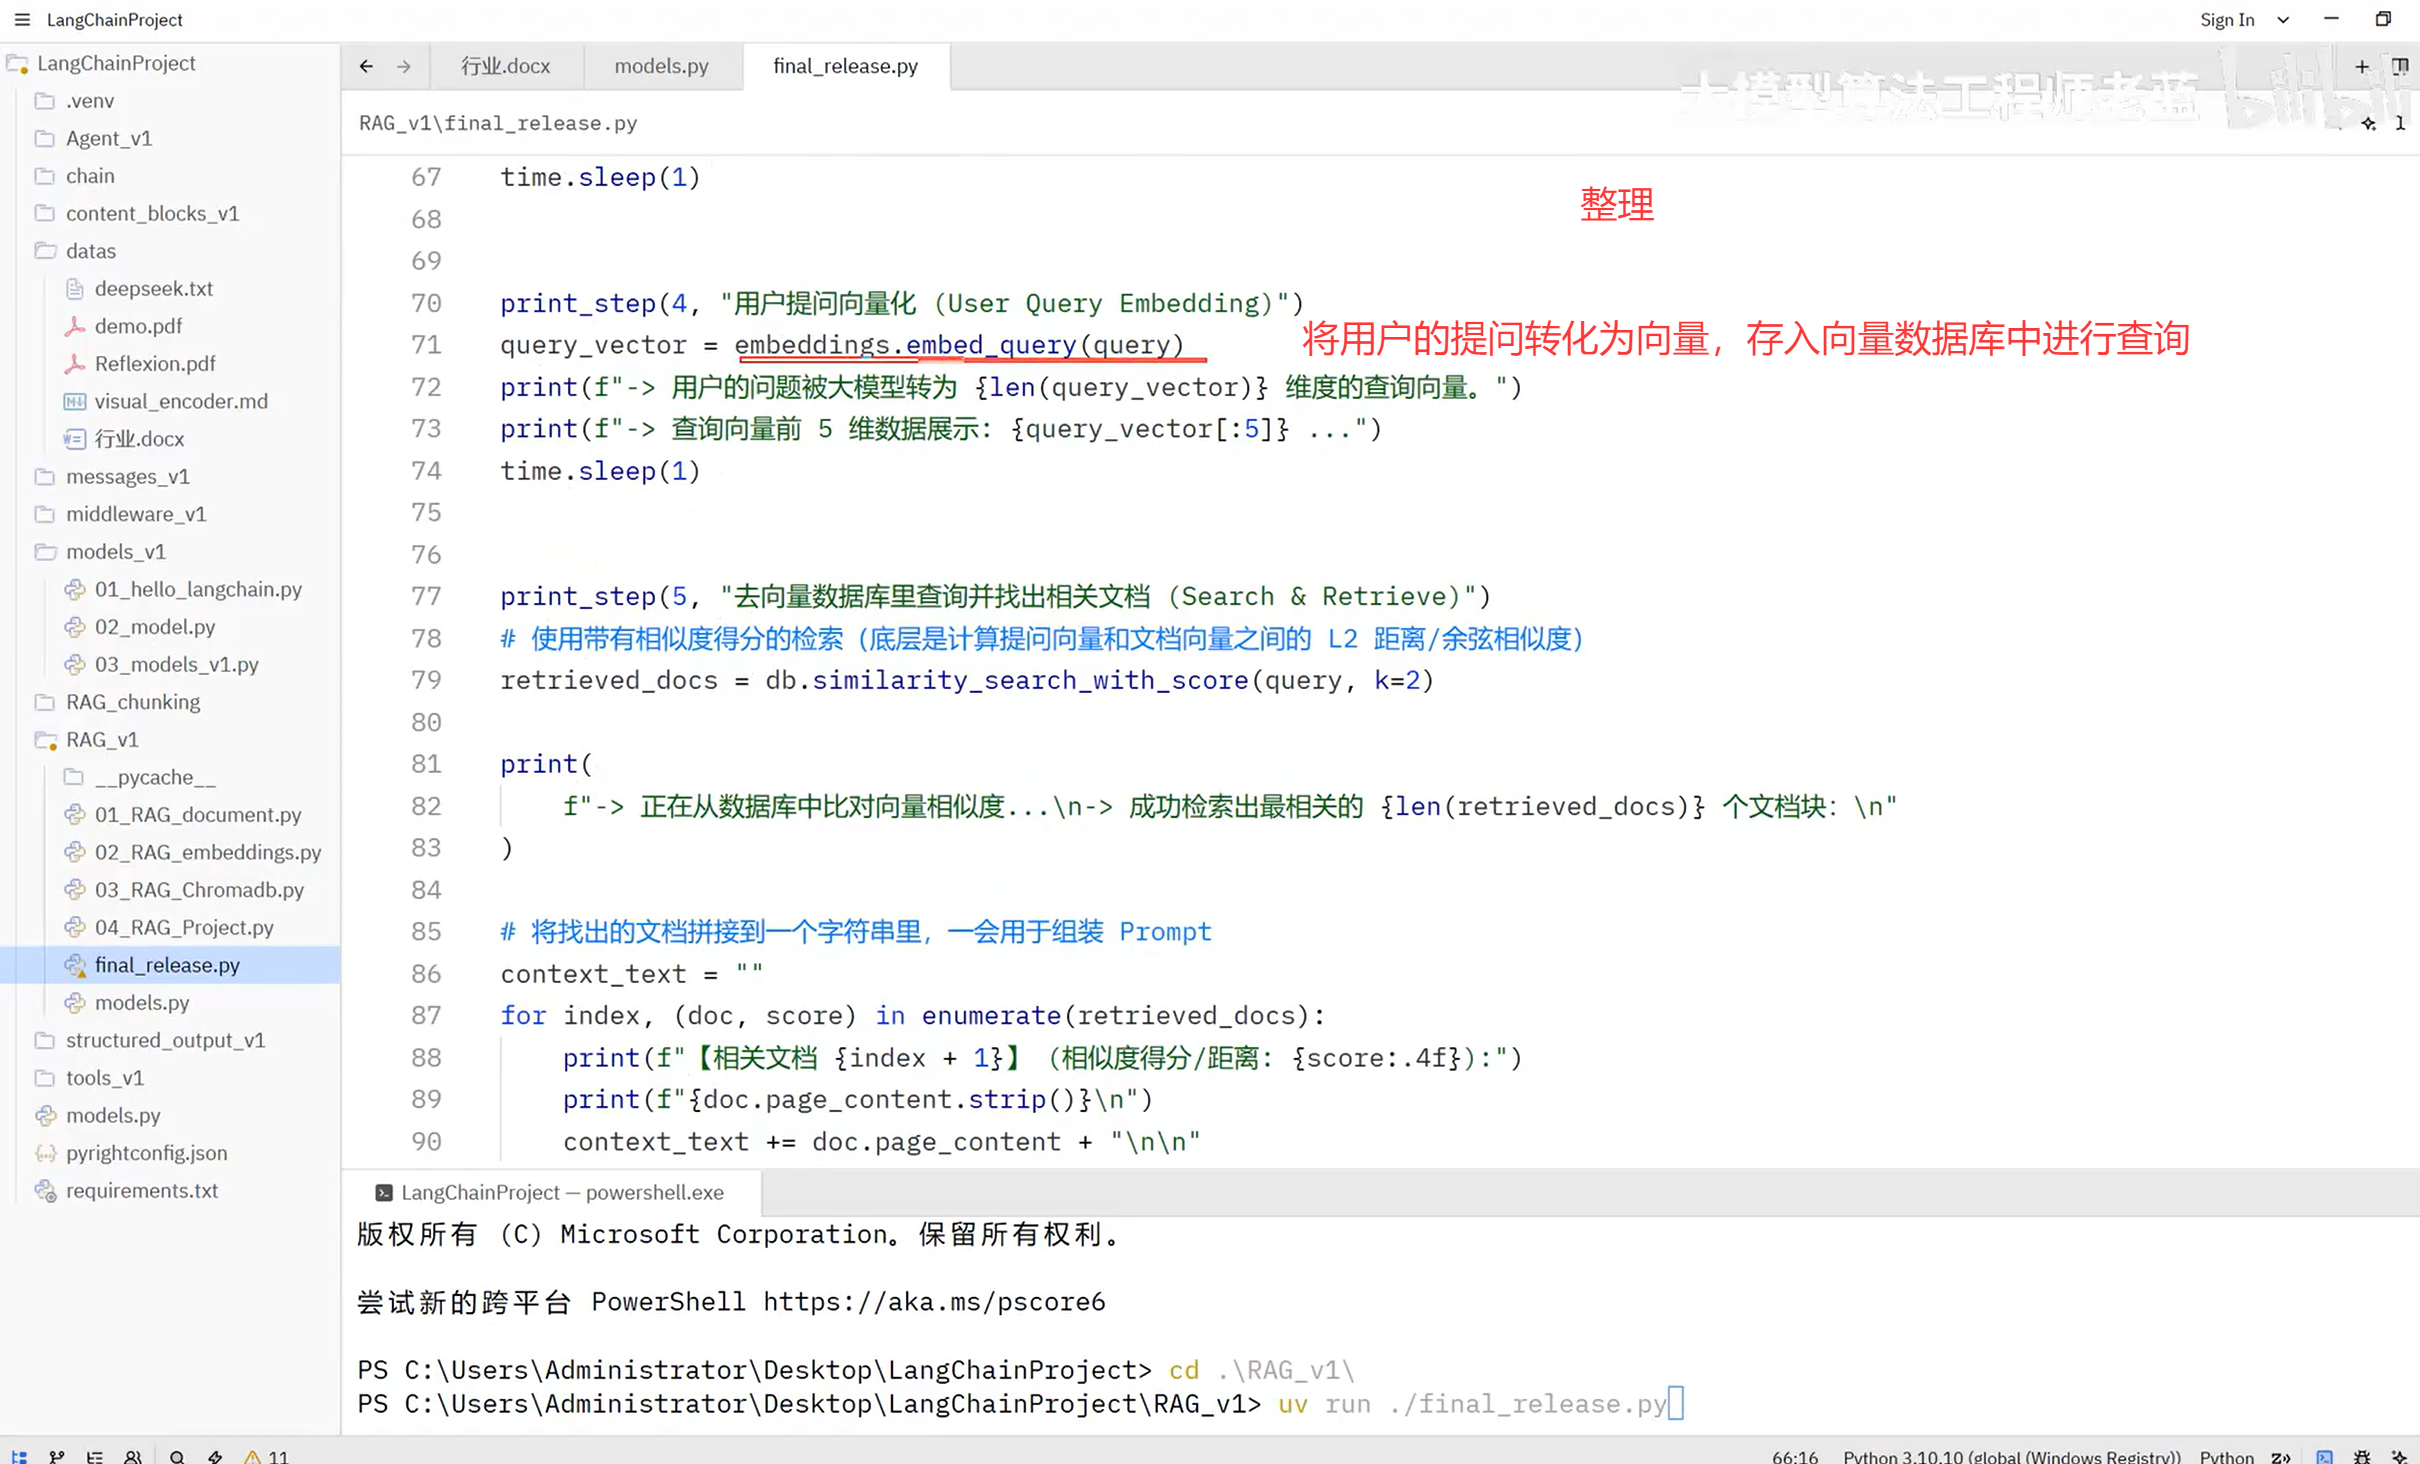
了解模型之后,现在开始构建系统
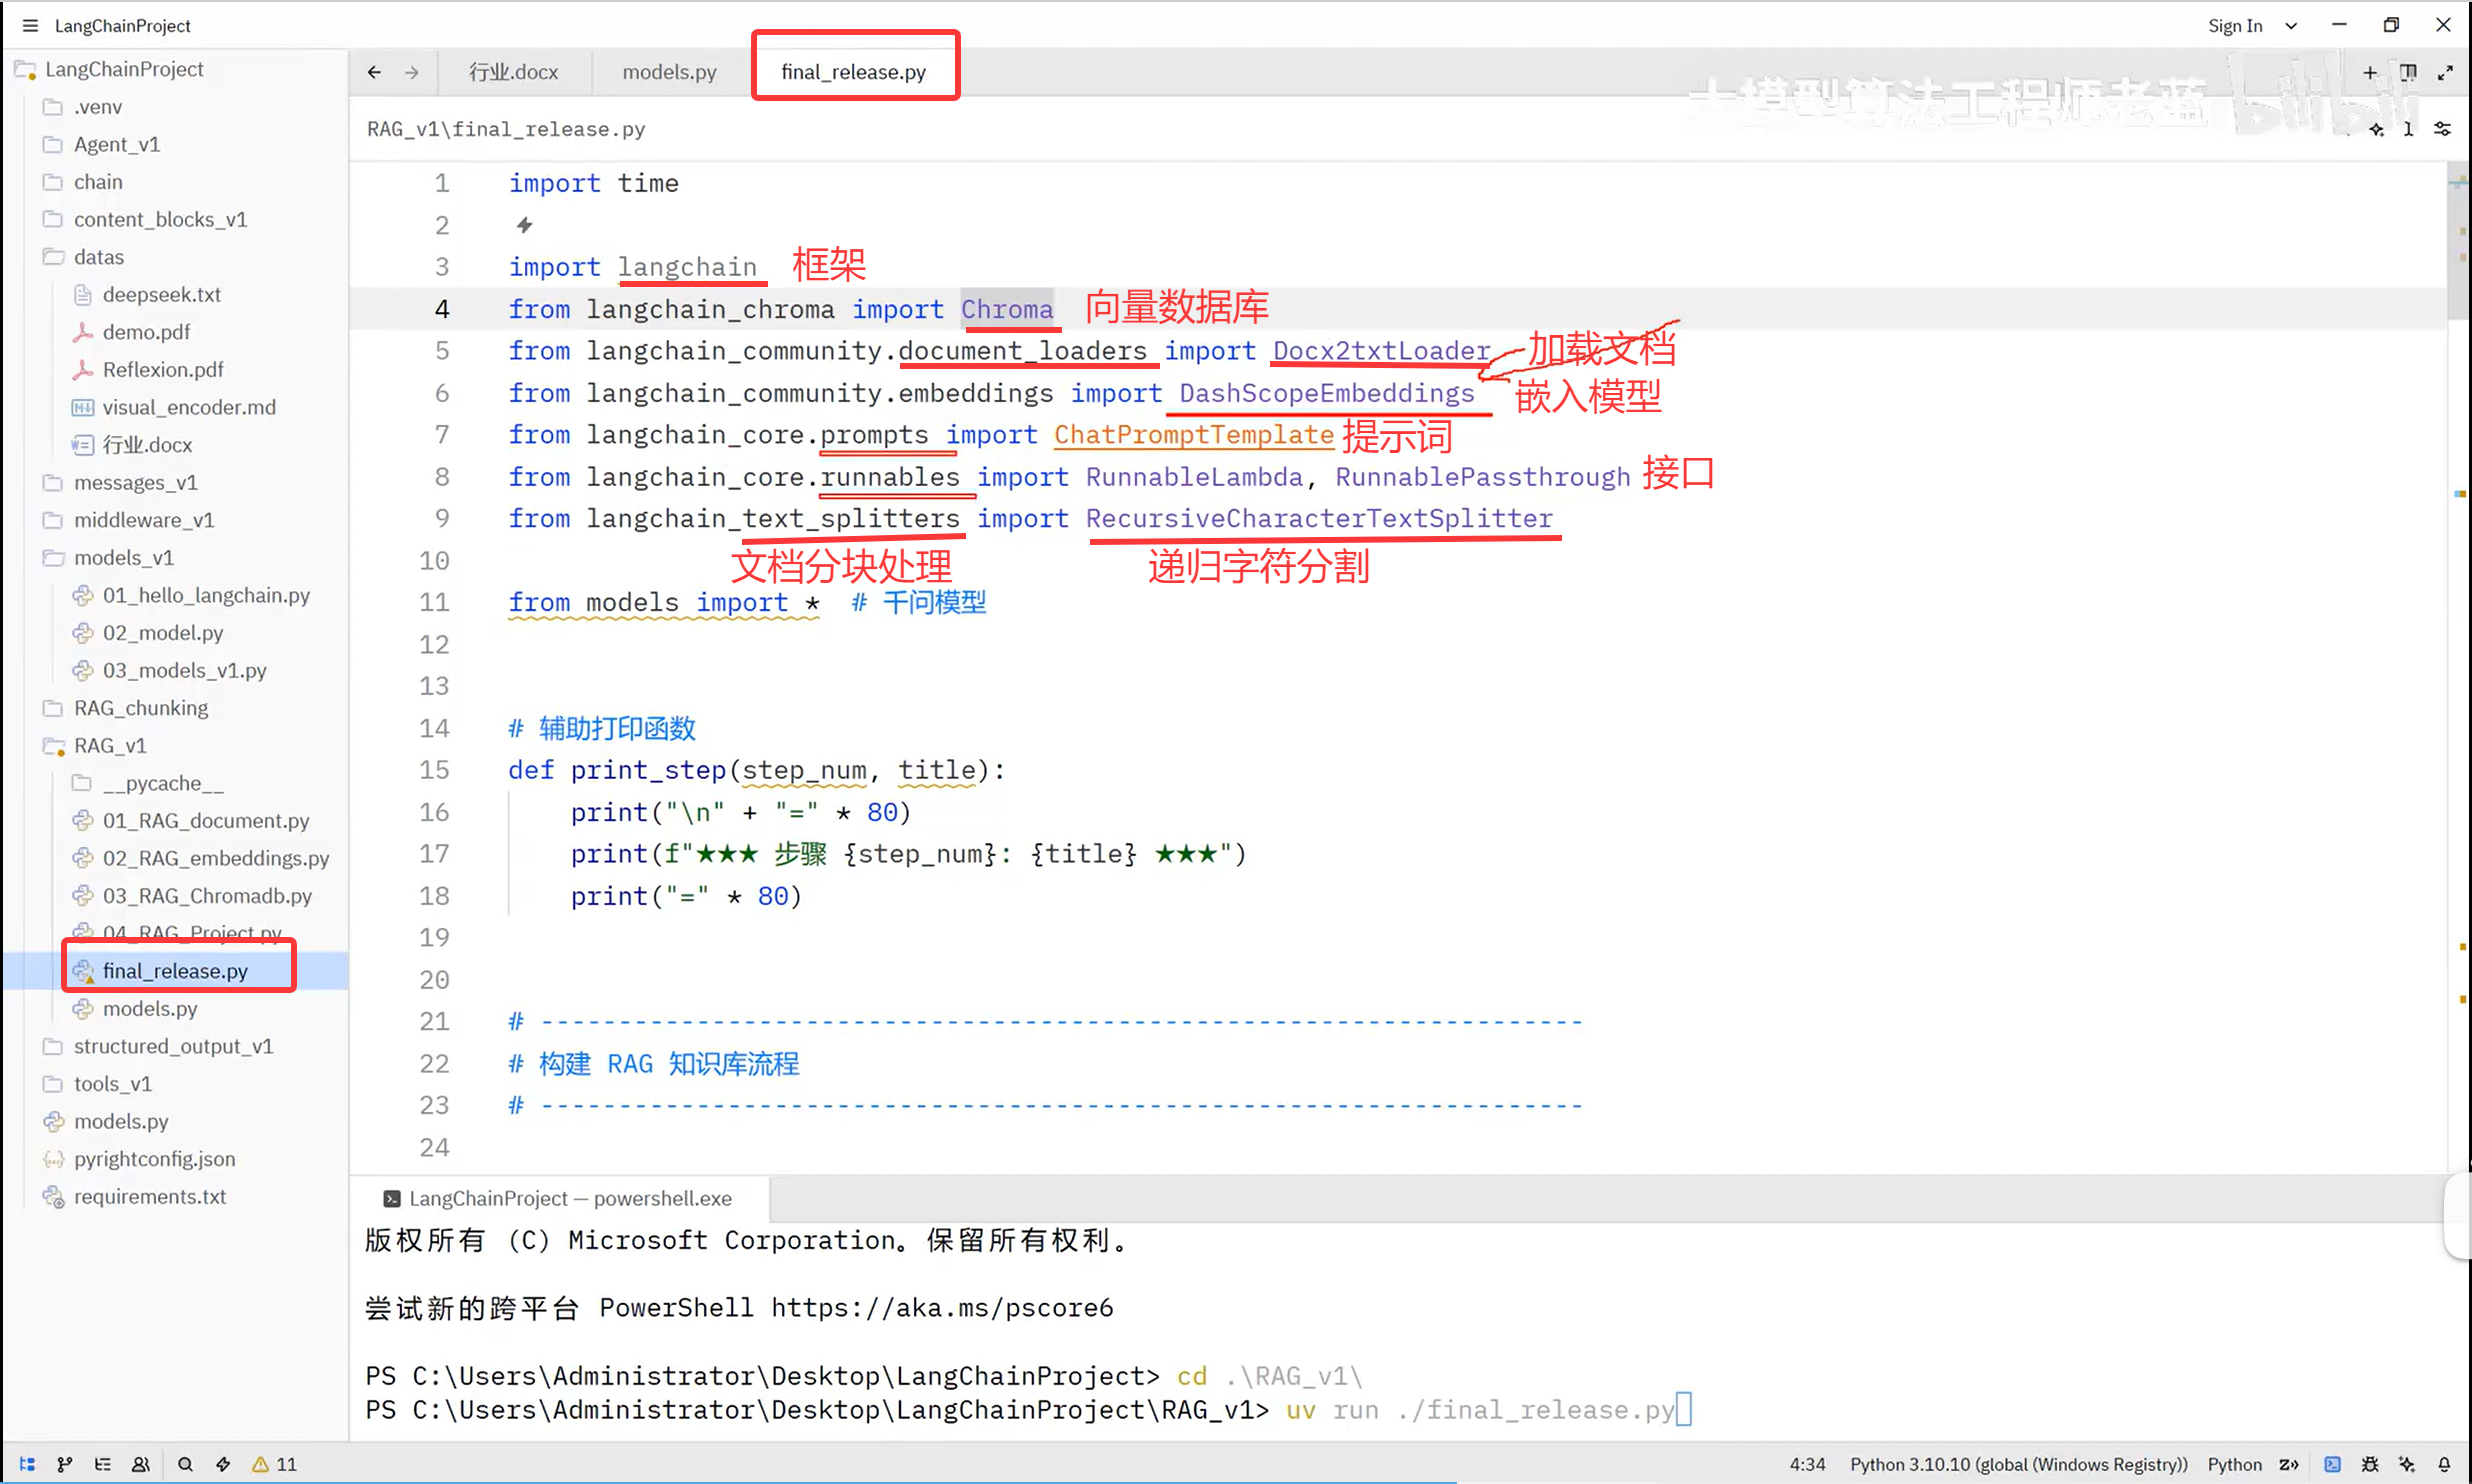
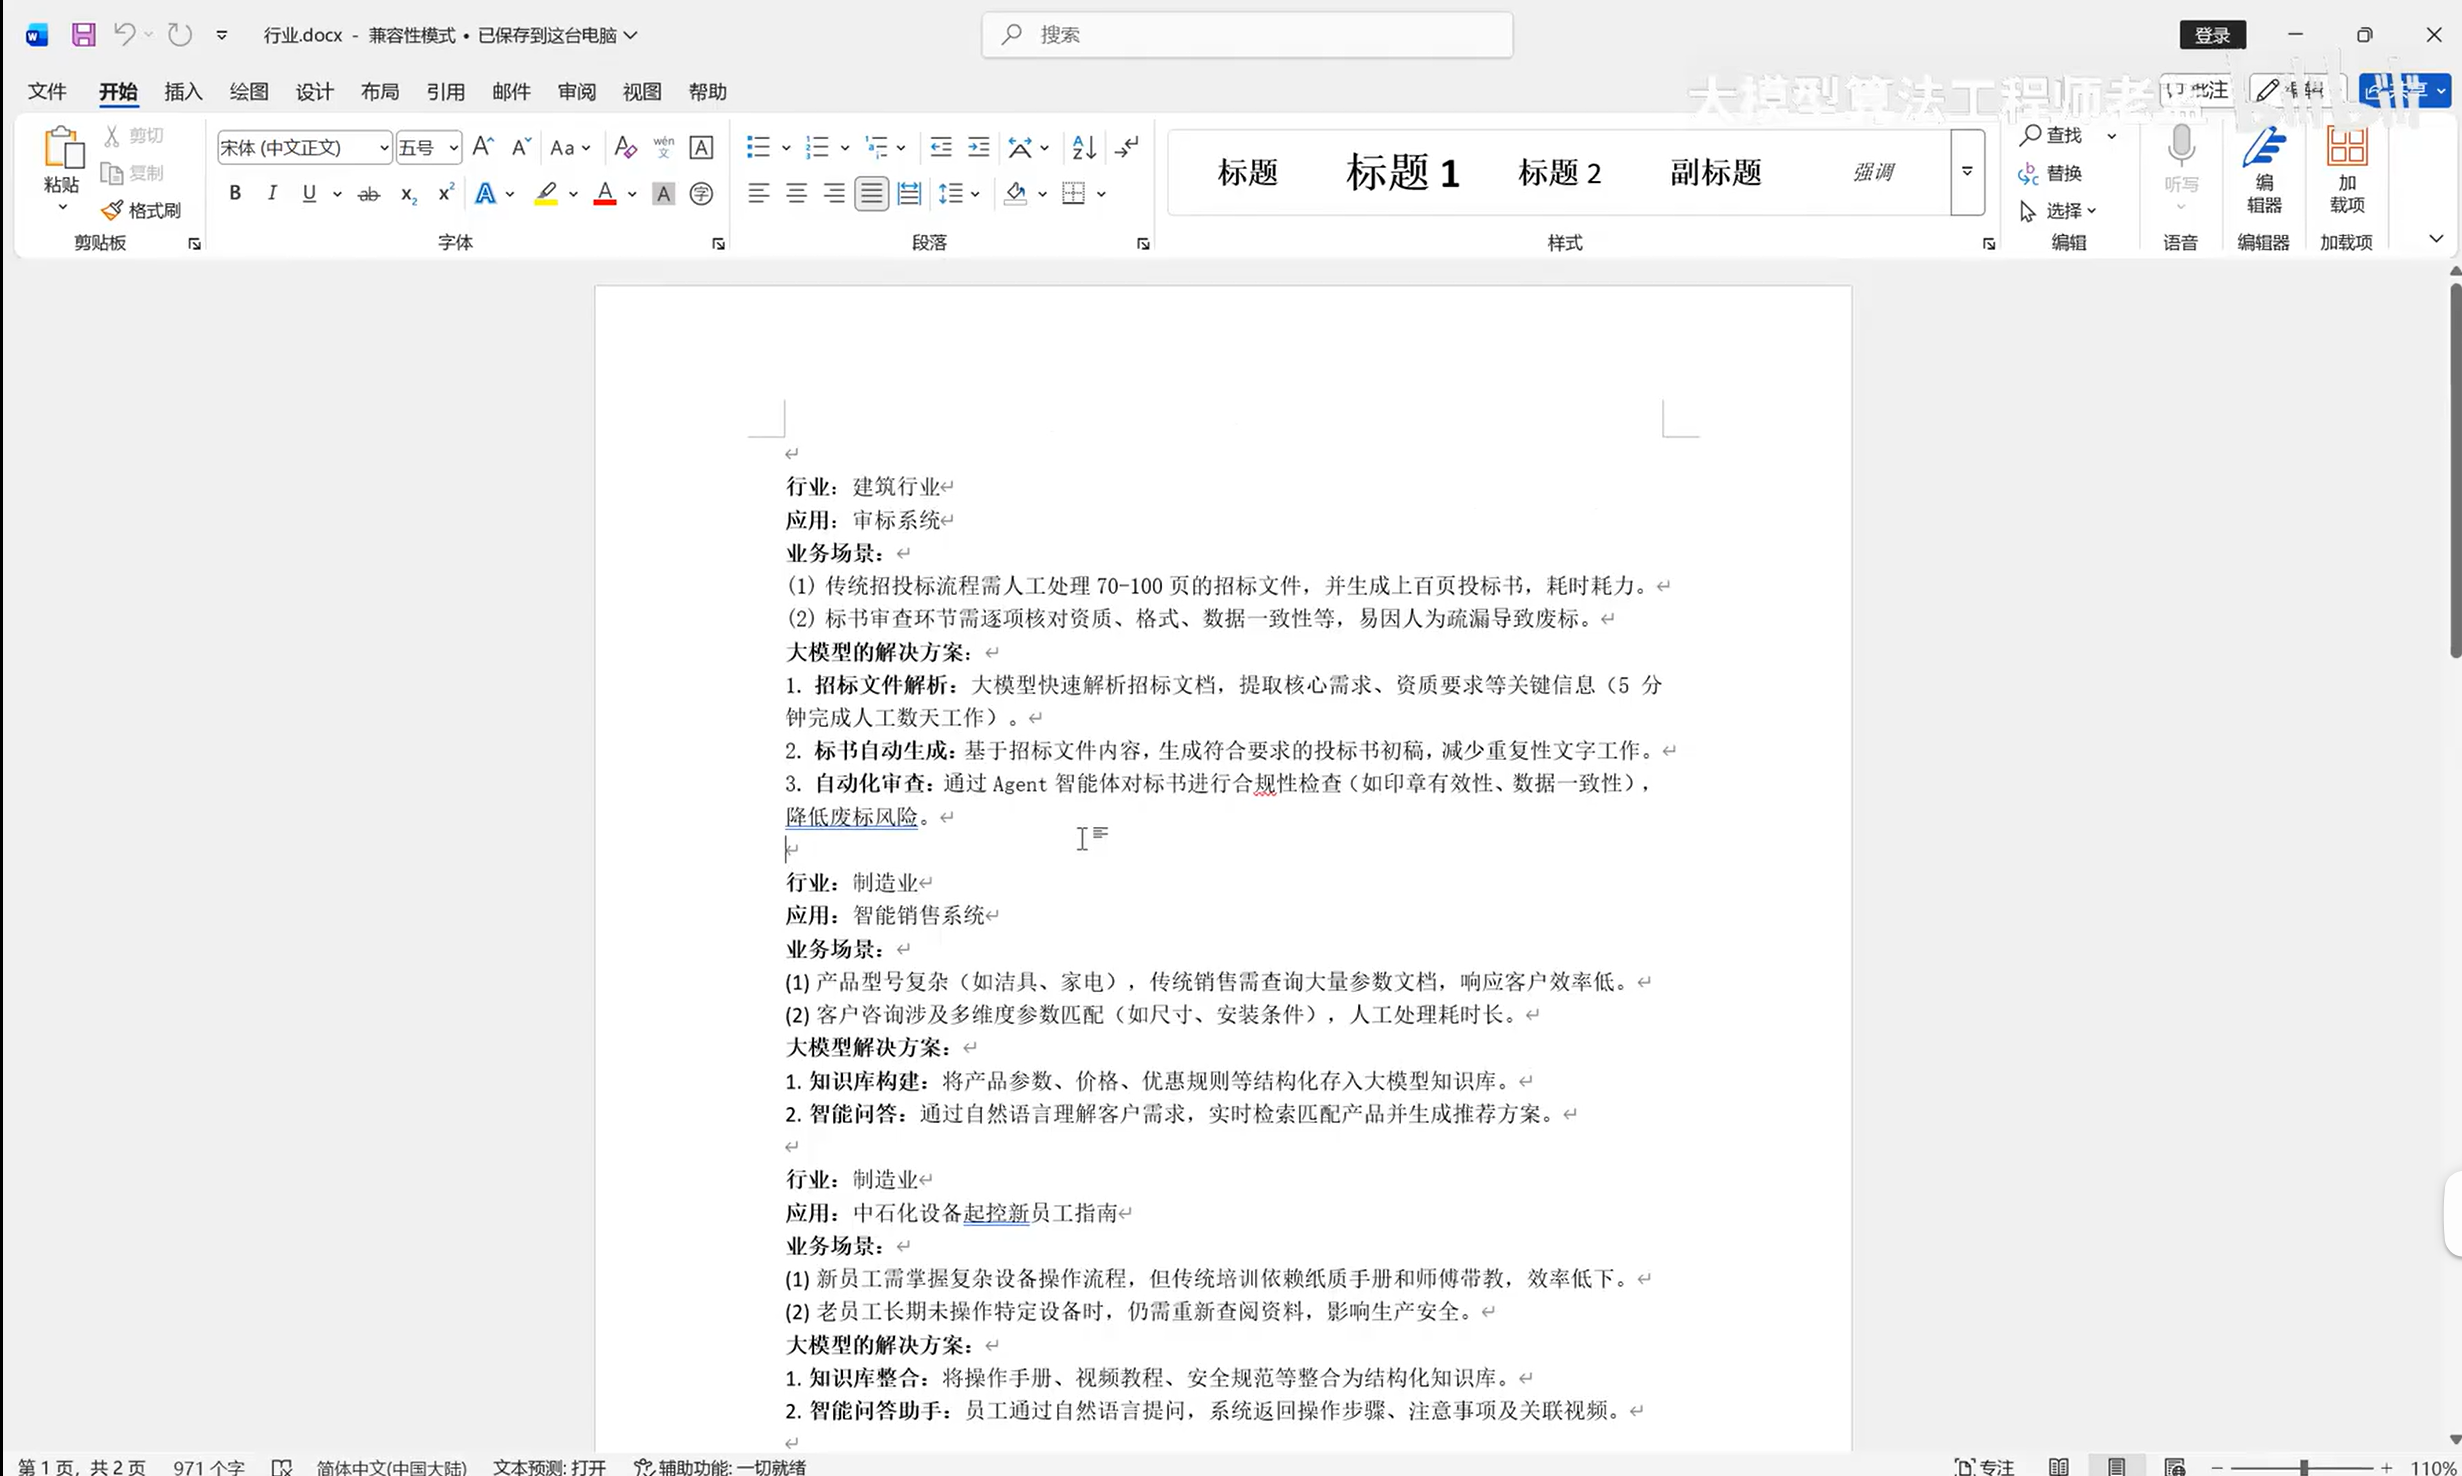
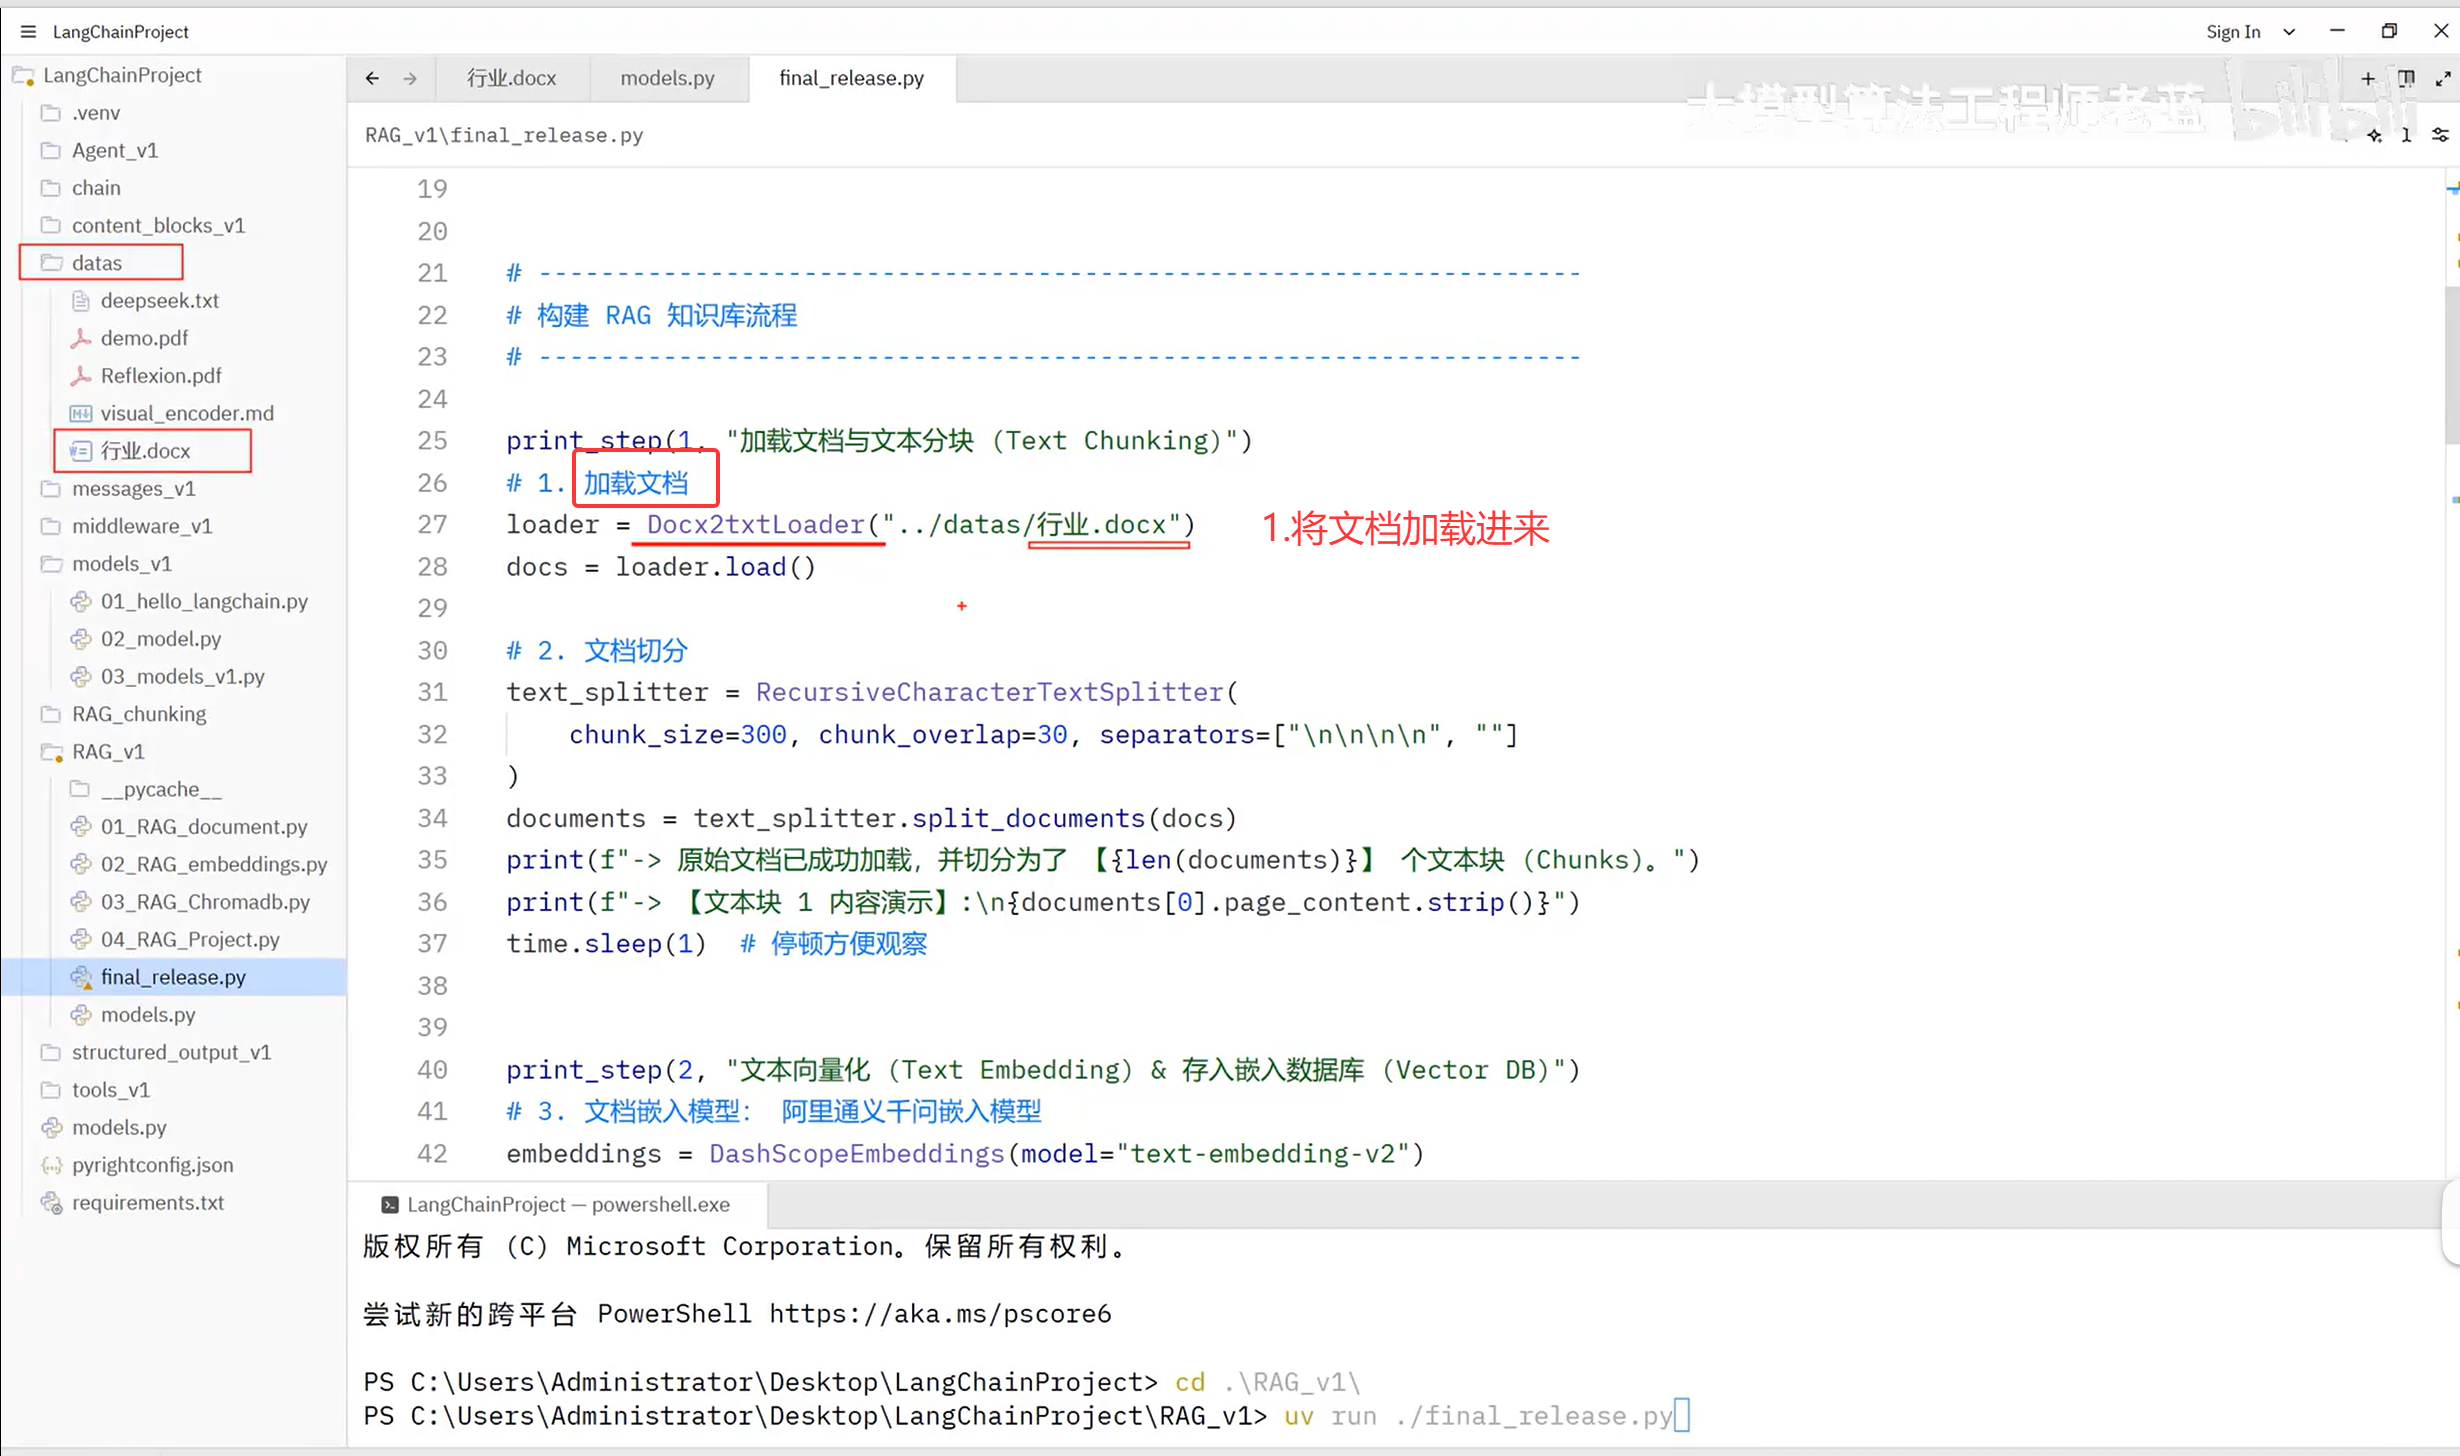
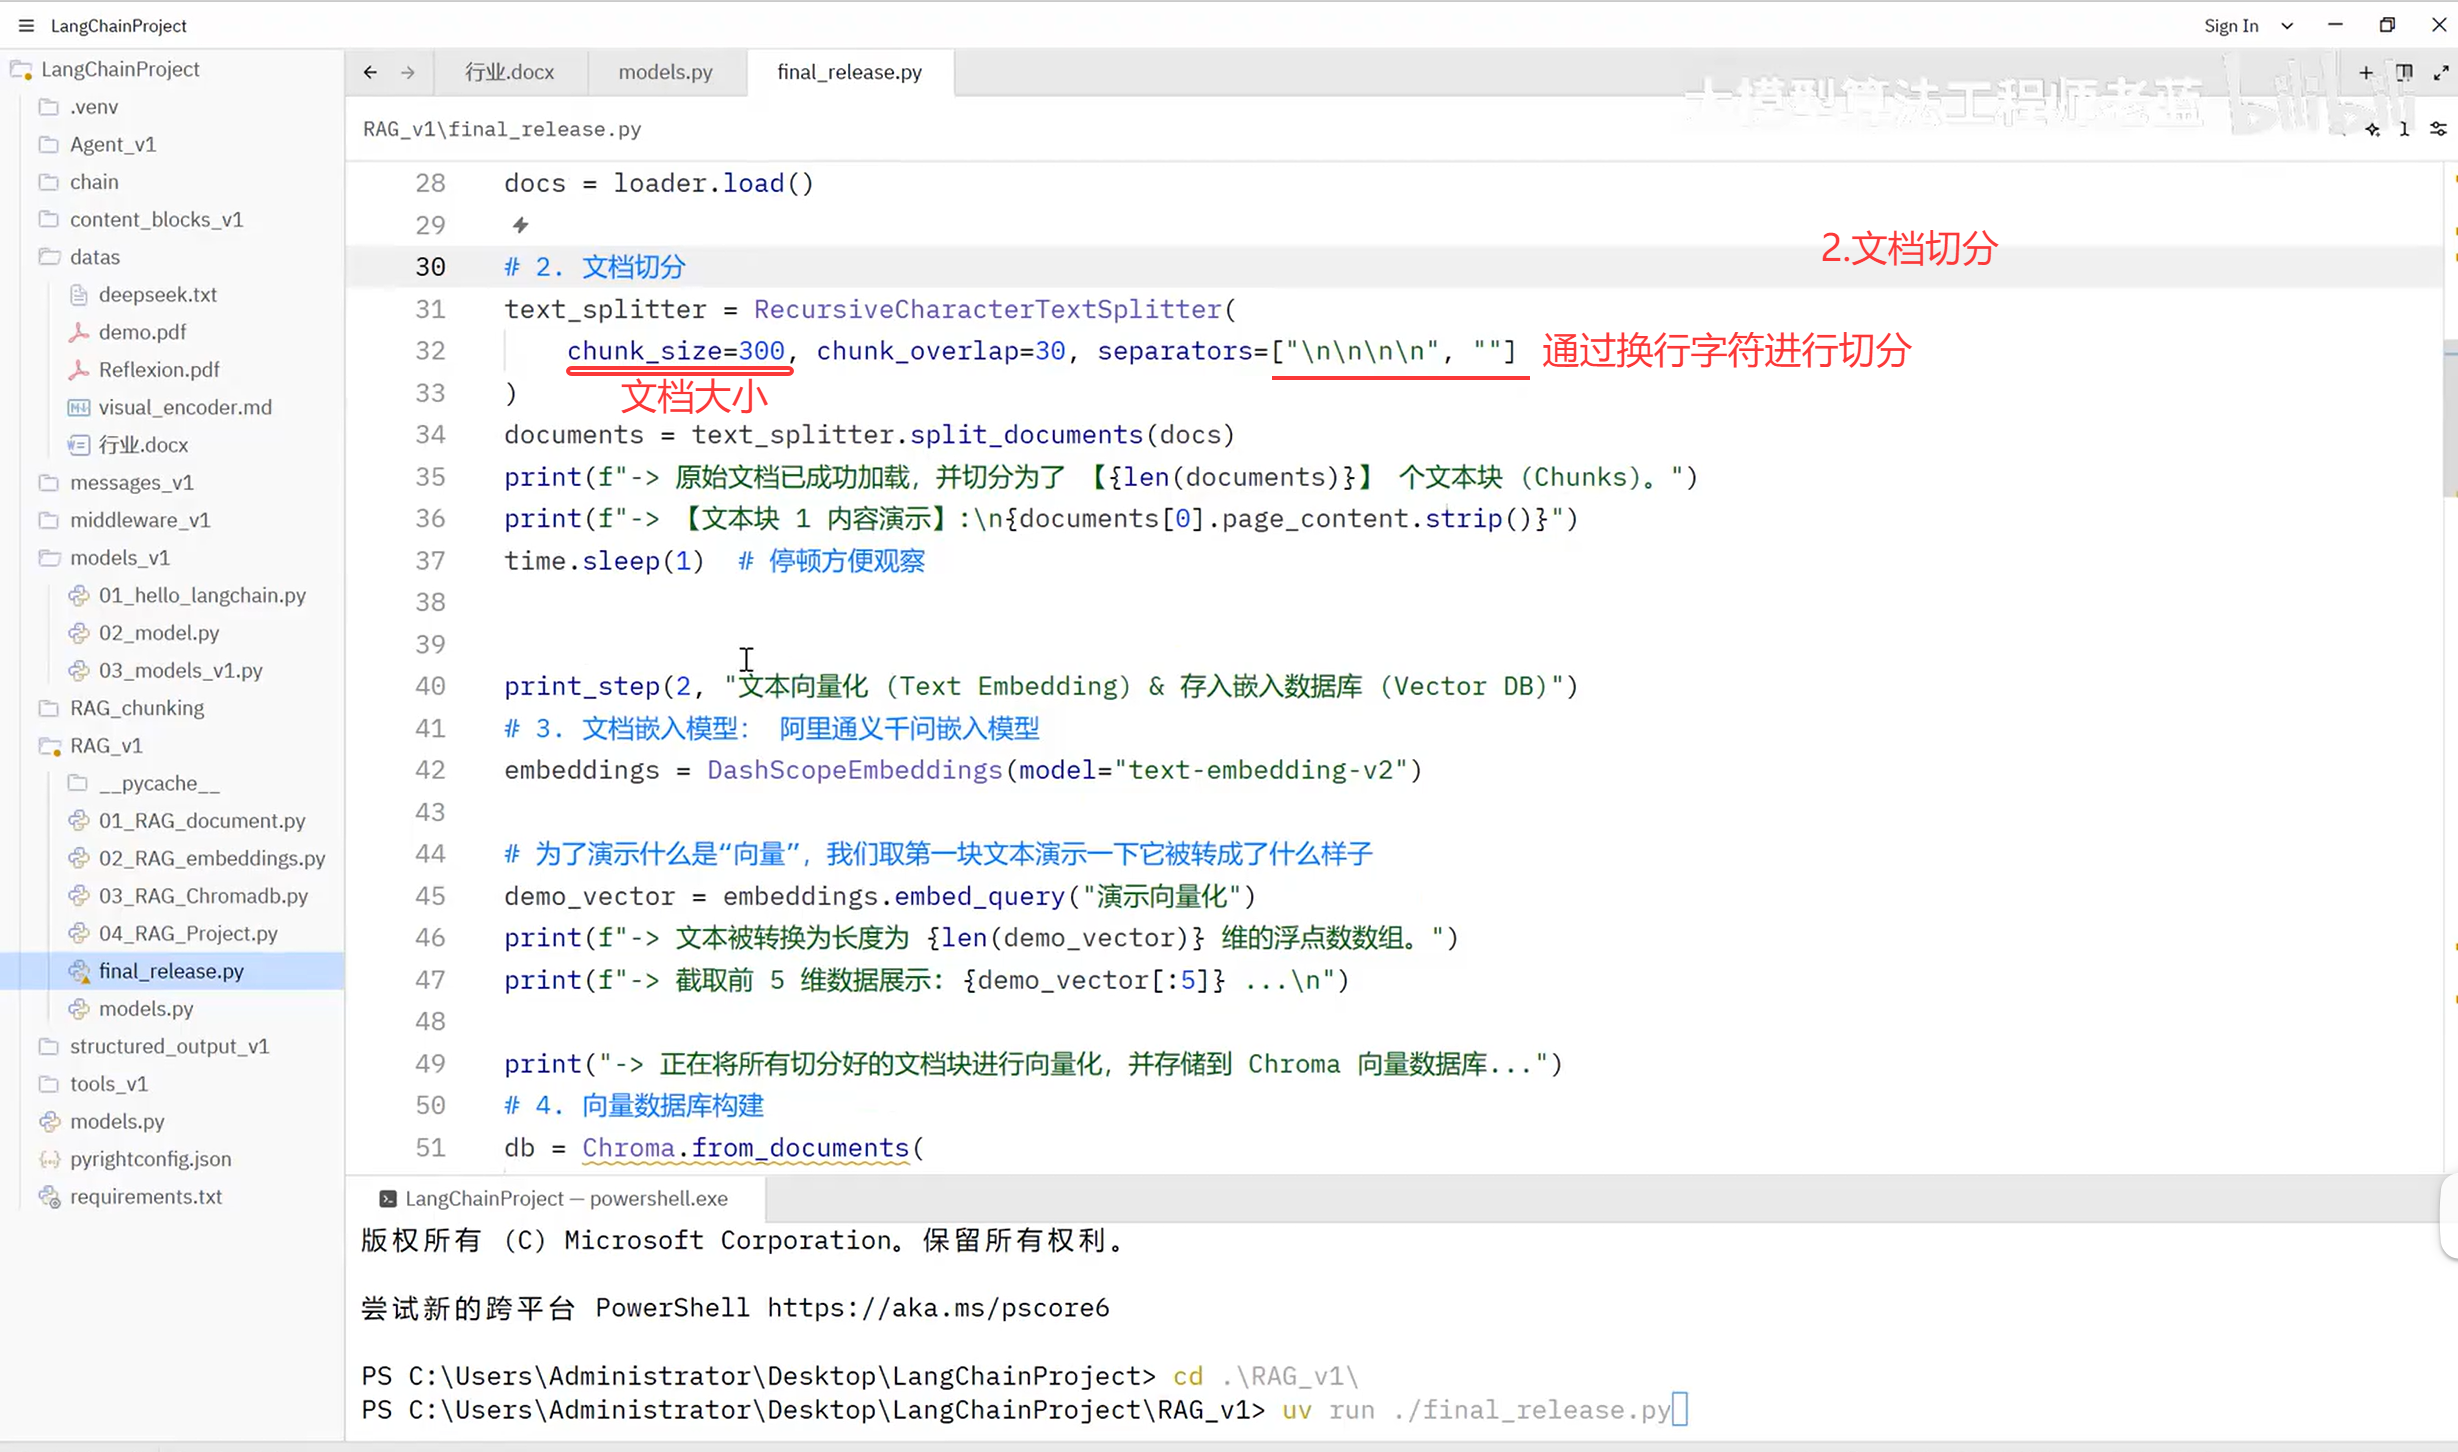
经过处理后的文档
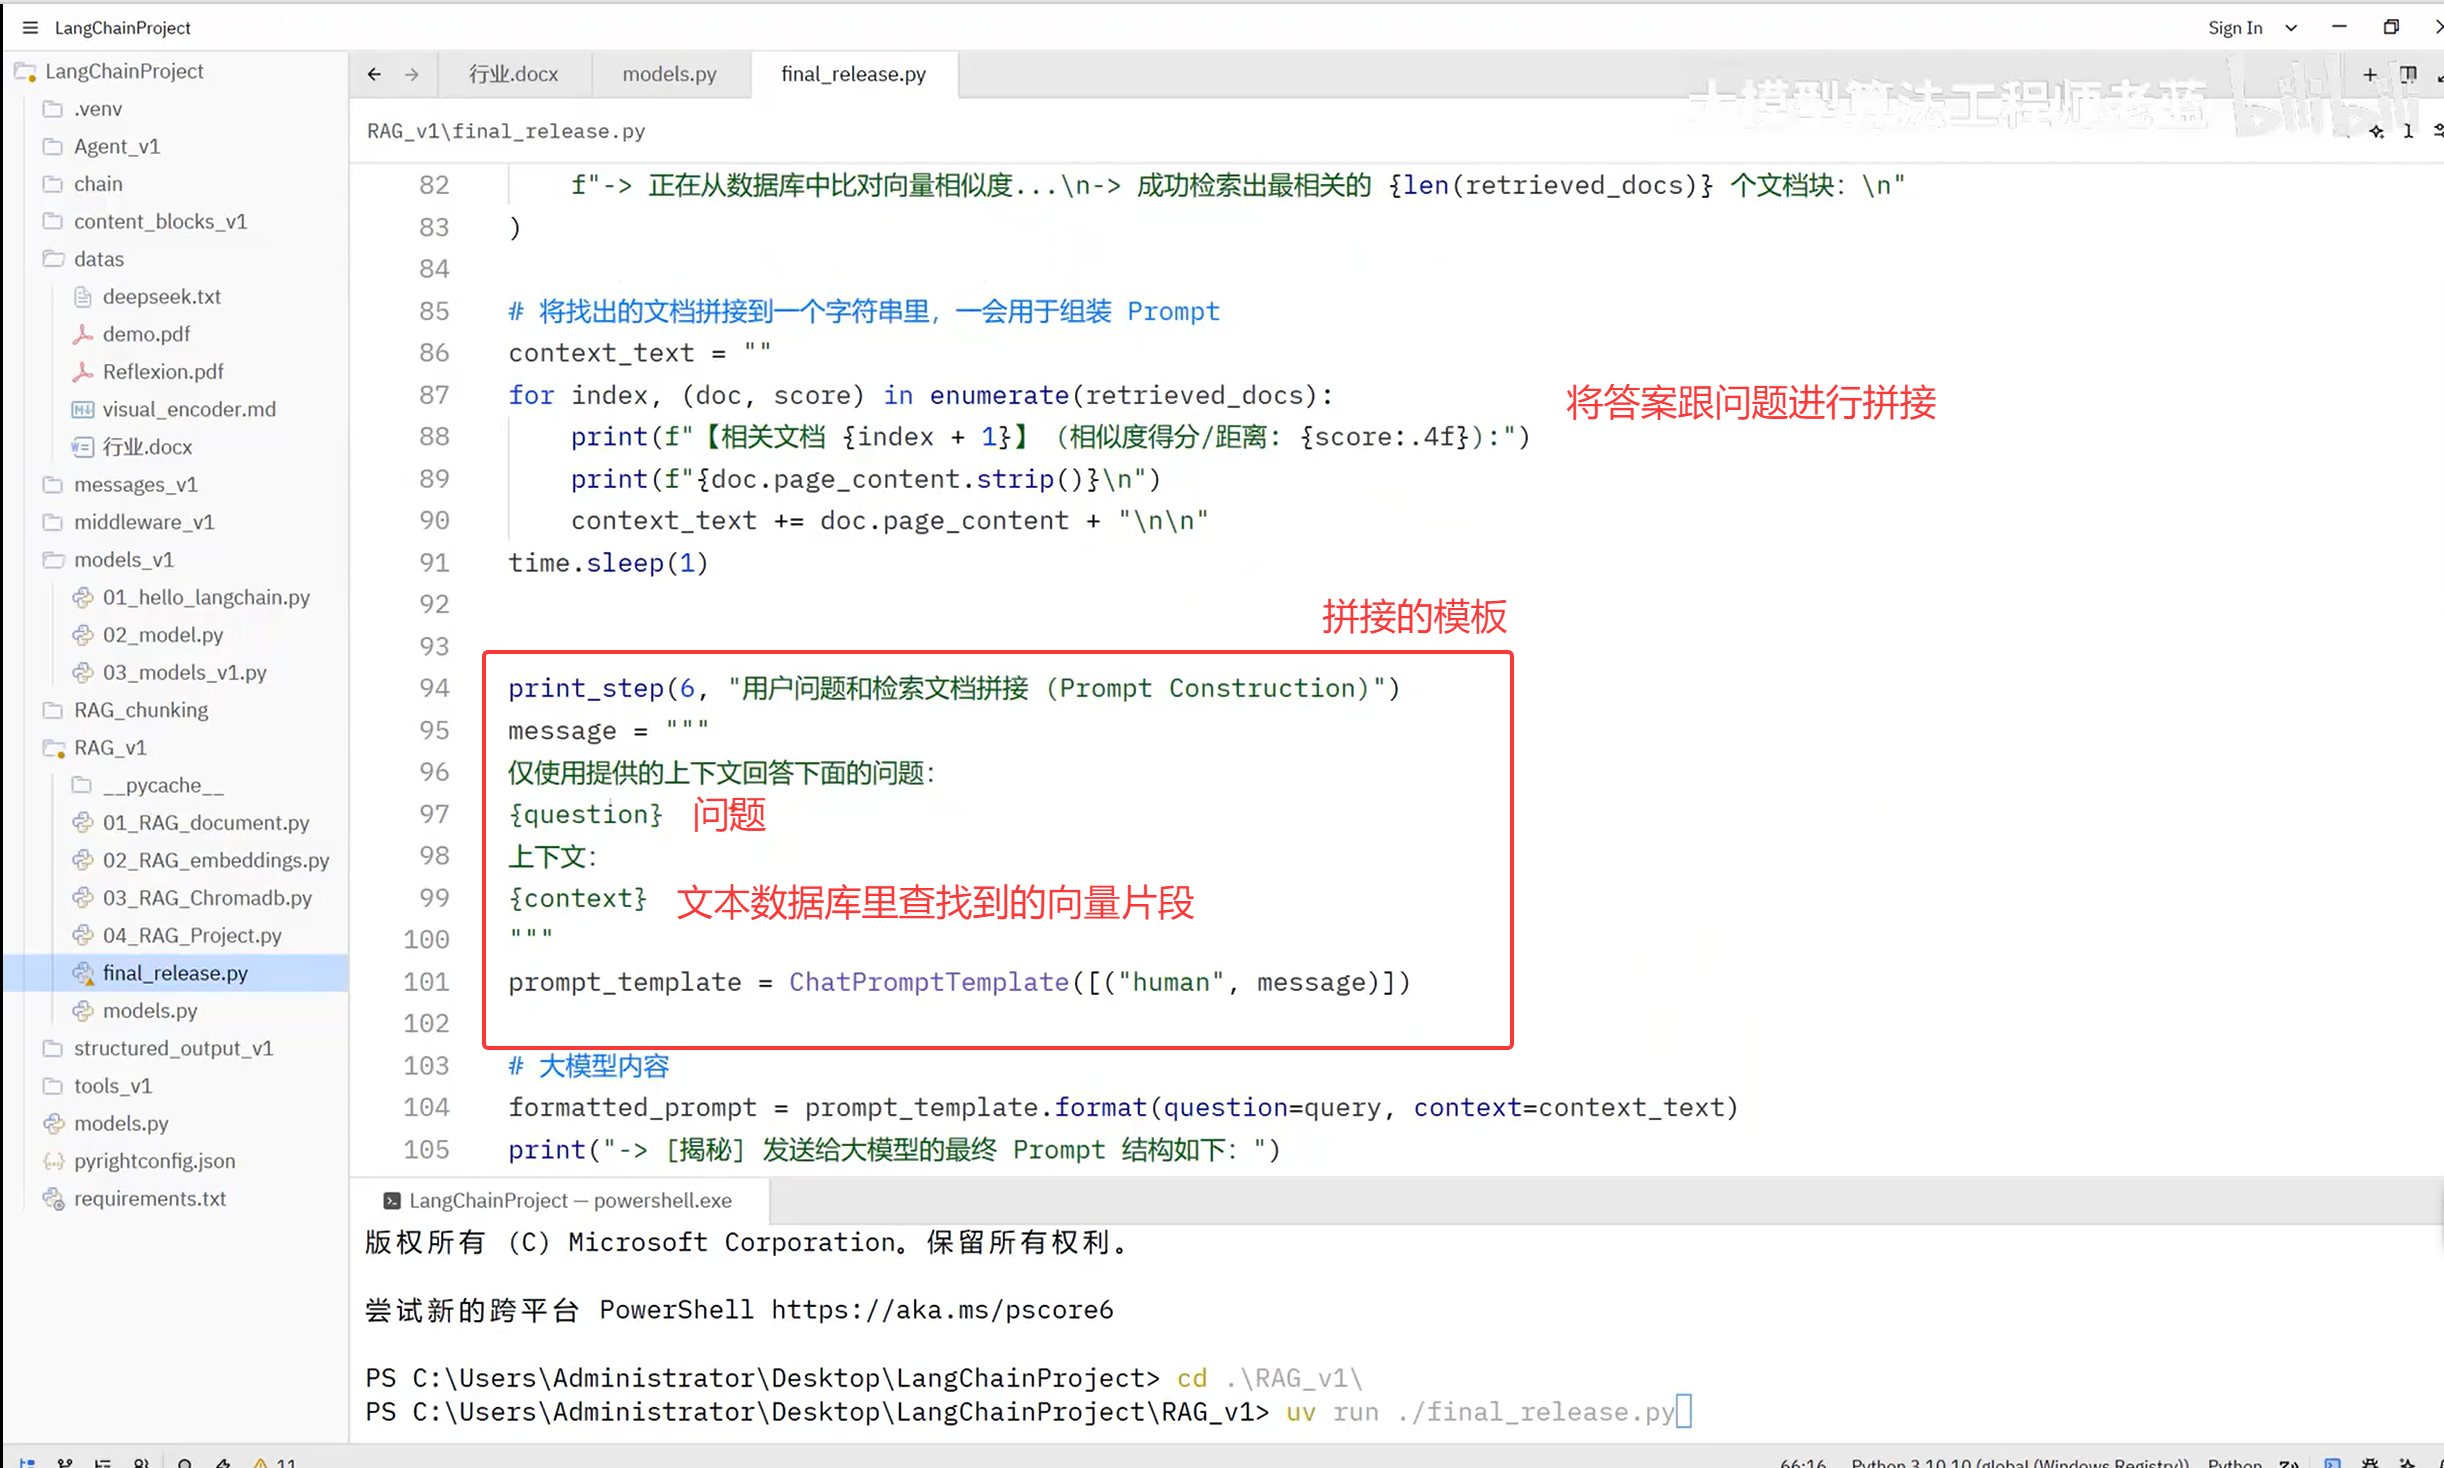
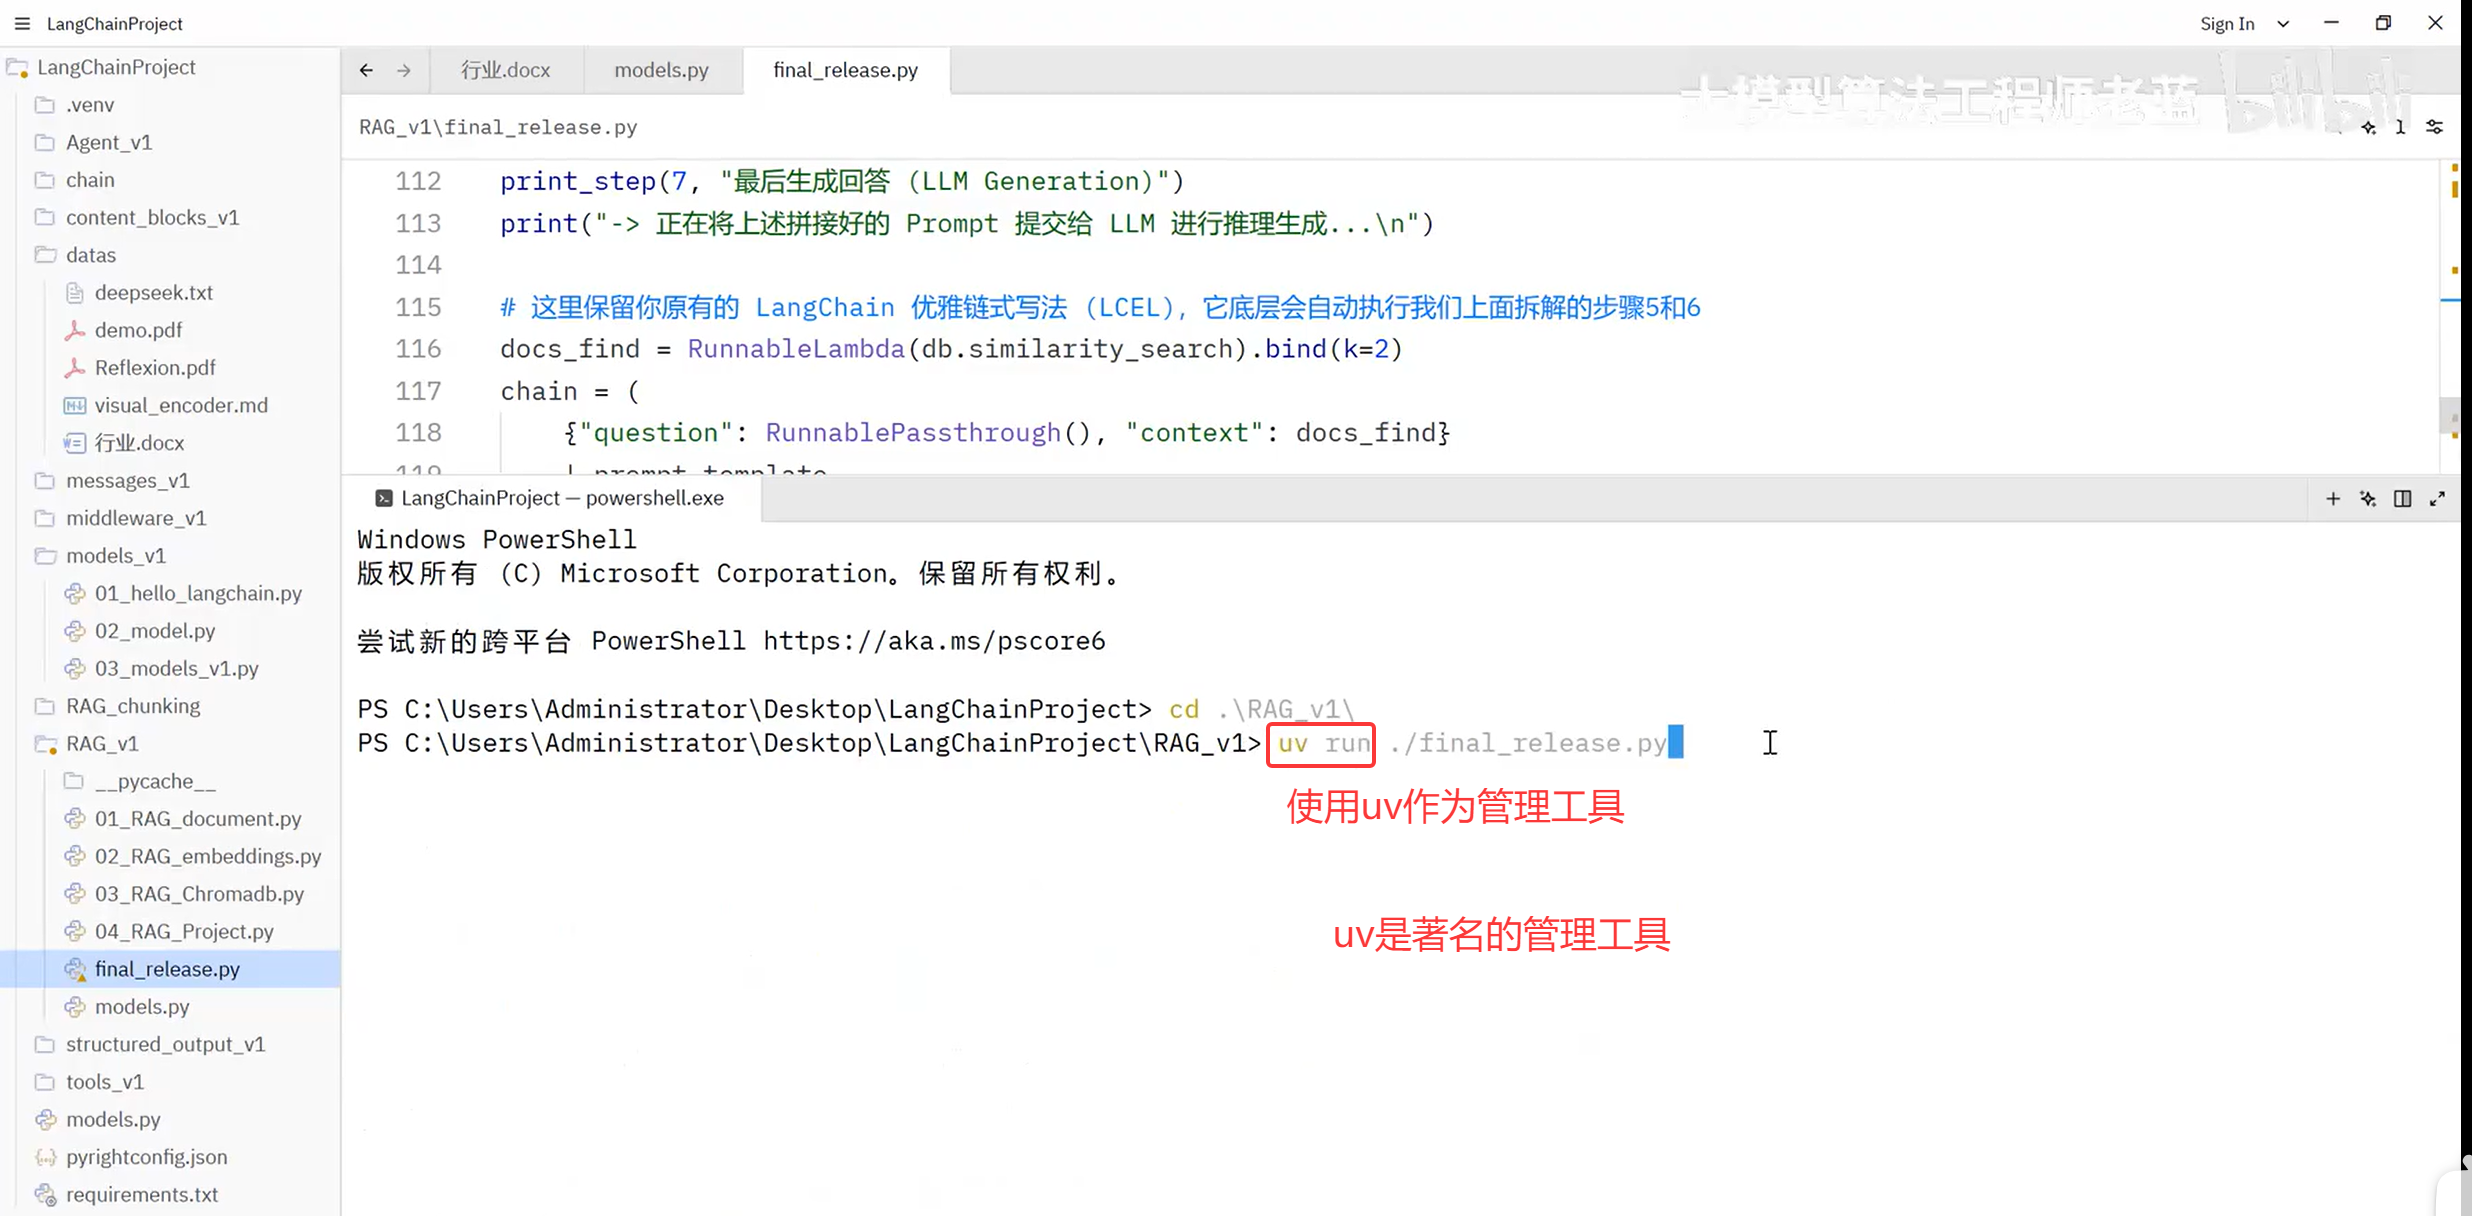
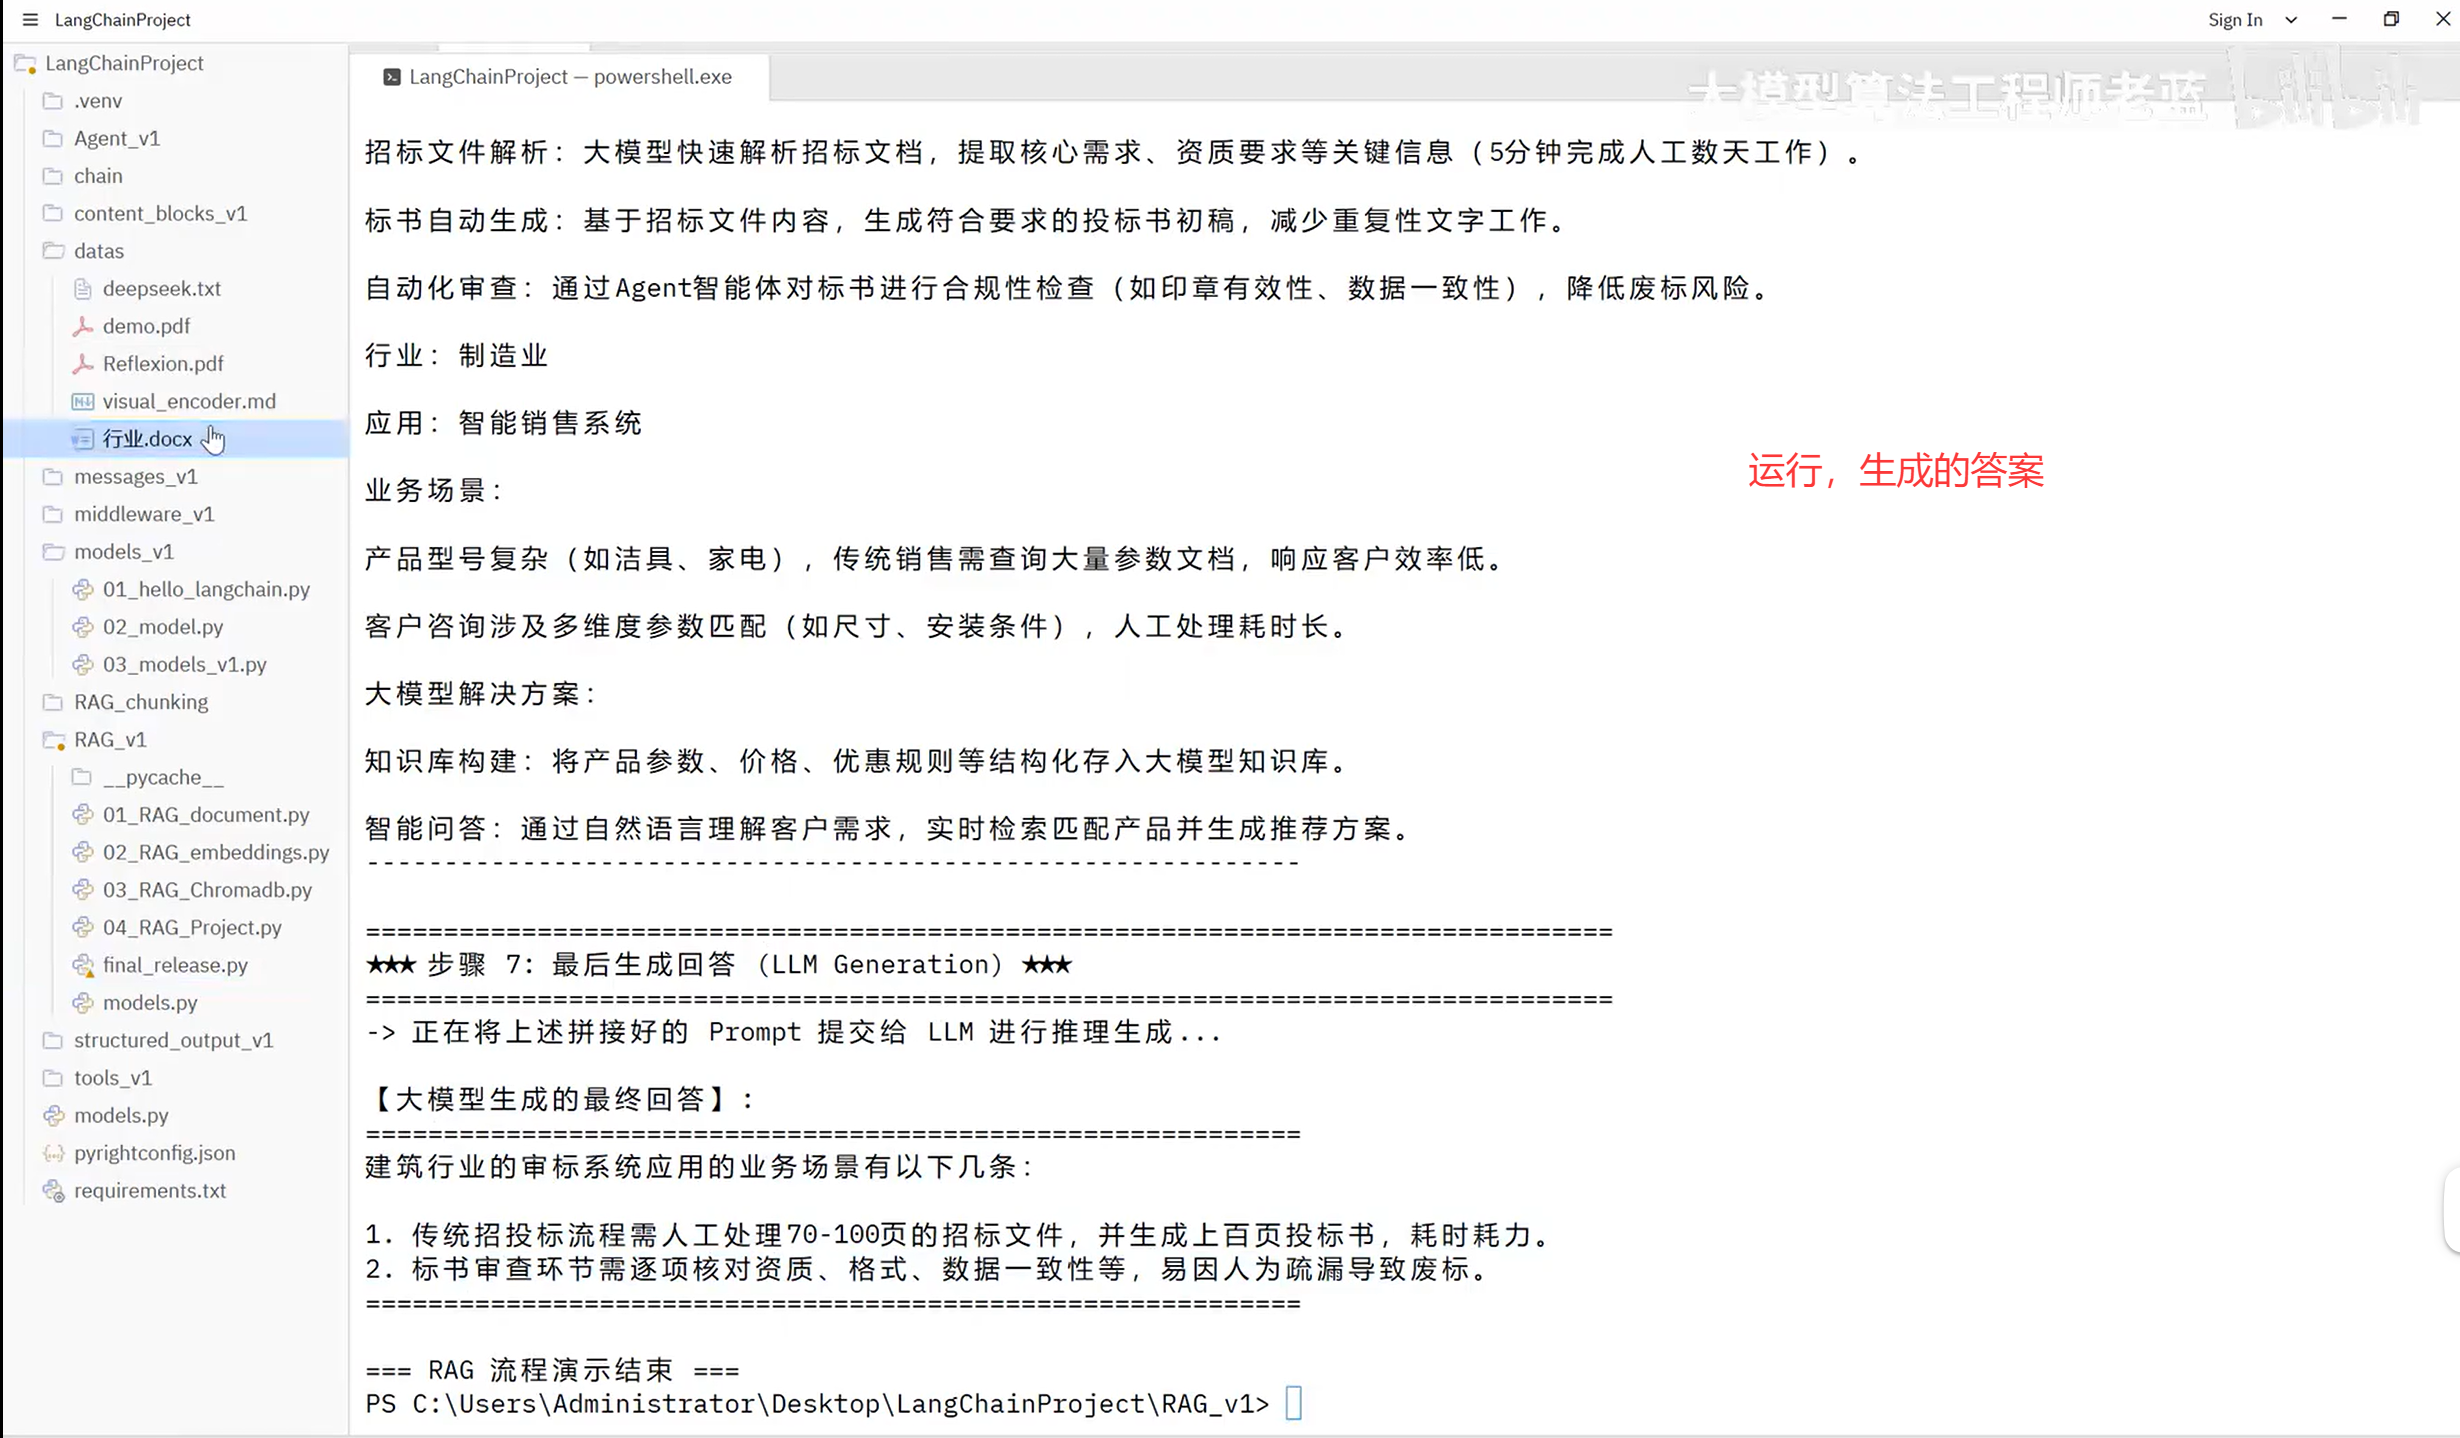
7.4 总结
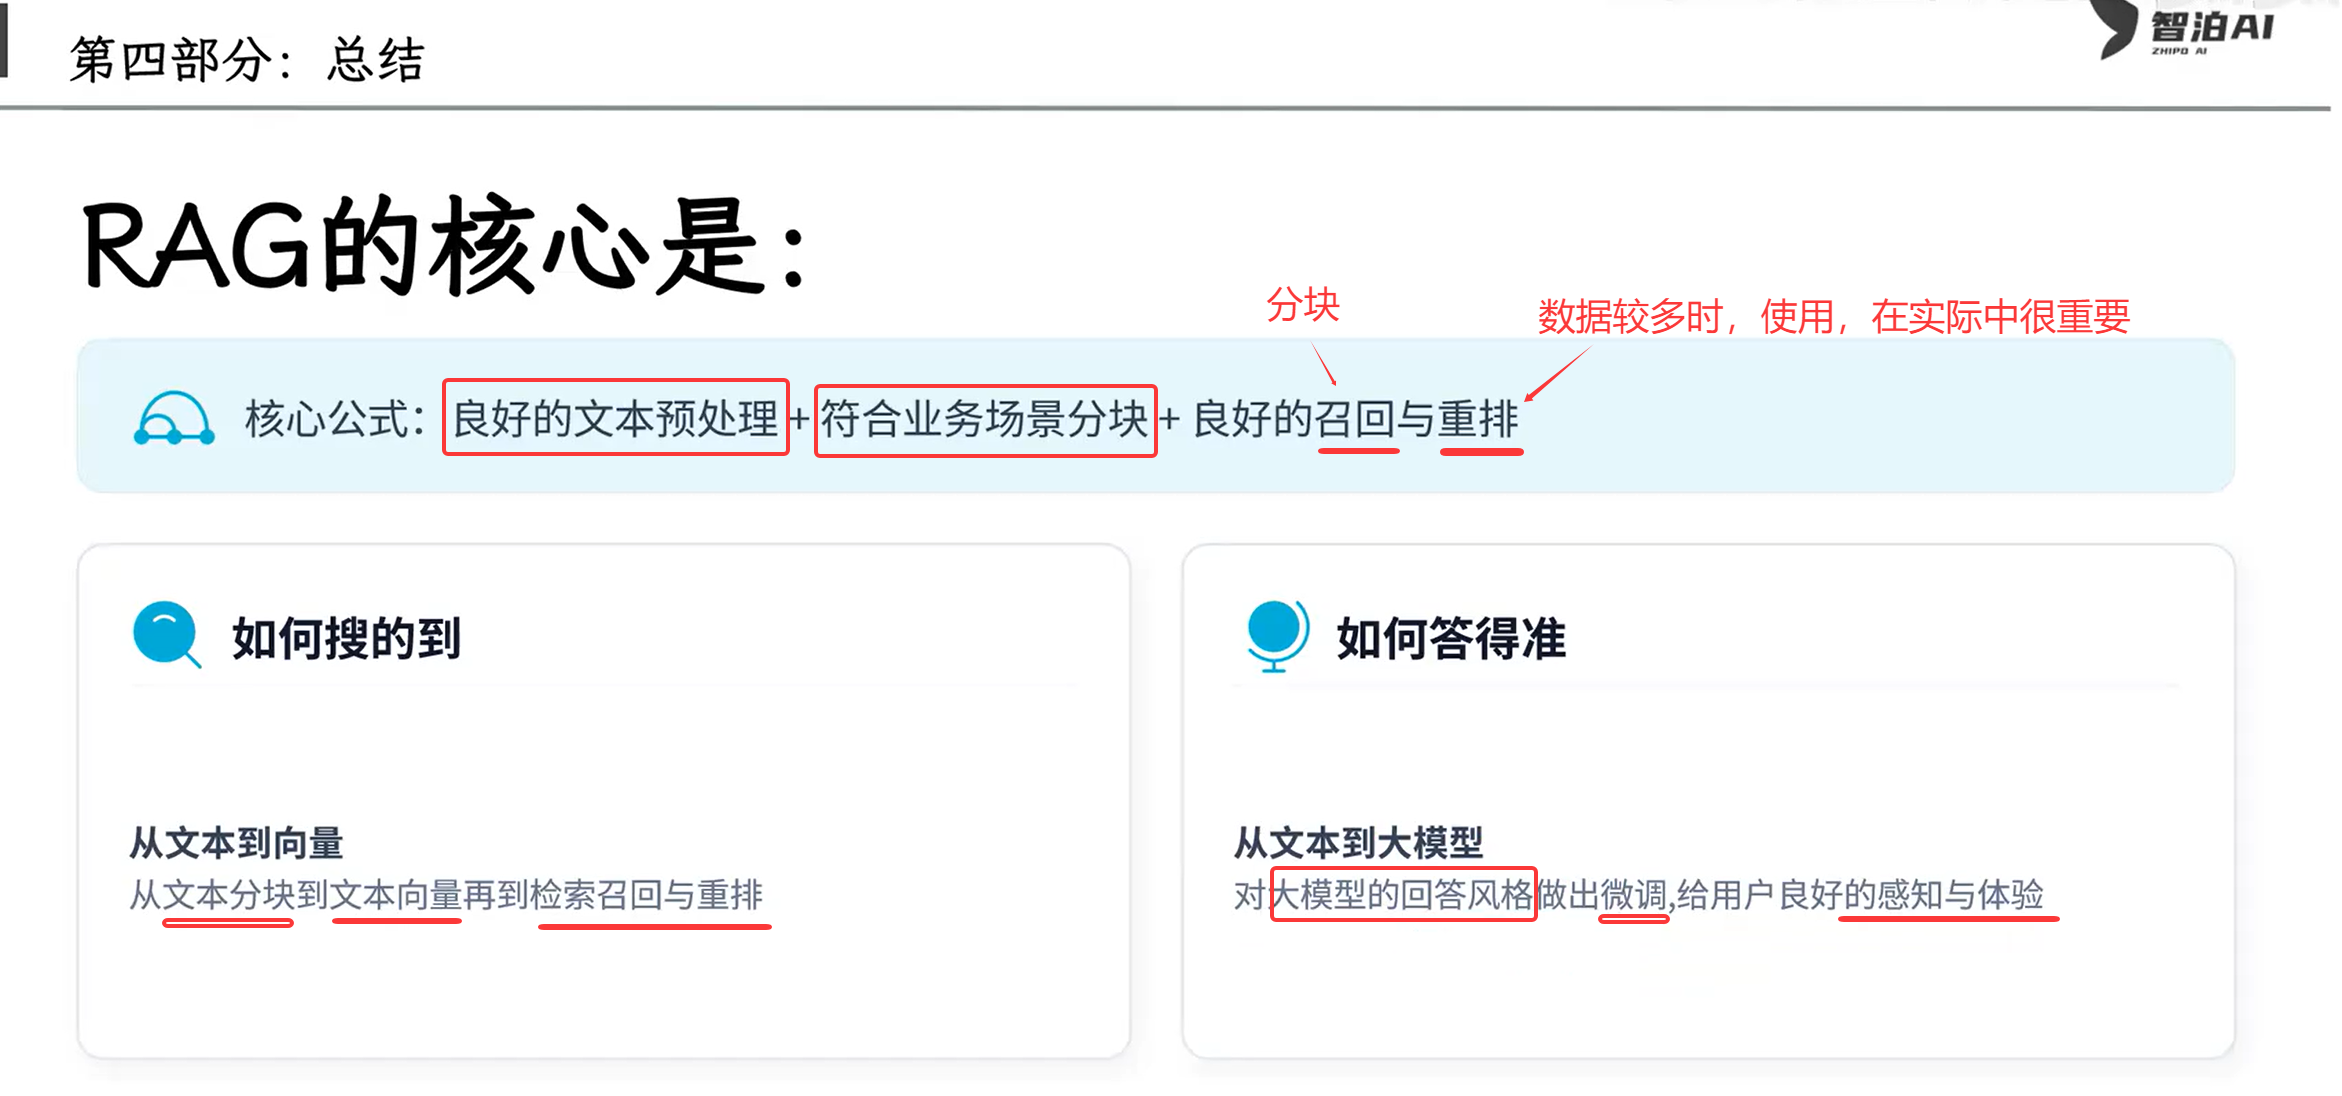
RAG系统开发方法总结


 扫一扫


 305

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


