


保姆级实战:YOLO11 训练图标点选验证码识别模型(附数据集与模型)
图标点选验证码靠传统图像处理很难做稳:背景纹理复杂、图标带旋转缩放、还会不时换一批新图标。本文带你用 YOLO11m 训练一个单类别图标检测模型(
yolo11m.pt→best.pt),再配合剪影模板匹配,跑通"检测图标 → 匹配目标 → 输出点击坐标"的完整链路。适合有 Python 基础、想入门验证码识别/目标检测实战的同学。
资源下载(数据集 + yolo11m.pt 预训练权重 + 训练好的 best.pt + 测试图):
通过网盘分享的知识:验证码
链接: https://pan.baidu.com/s/5iKcZQL-qR1a0yvJcs_91Bw
–来自百度网盘超级会员v5的分享
⚠️ 合规声明:本文内容仅用于图像识别技术学习与研究,请勿将验证码识别用于任何违反目标网站服务协议或法律法规的用途(刷量、抢购、批量注册等),风险自负。
一、图标点选验证码长什么样:先看清敌人
先看要解决的具体问题。这类验证码的典型形态是:
- 一张 300×150 左右的背景图(真实照片纹理,干扰较强);
- 上面散布 4~6 个白色剪影风格小图标(礼物盒、挂锁、风车、数据线……),带轻微旋转、缩放和透视;
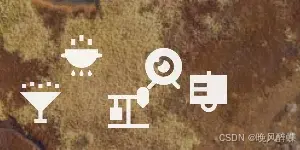
- 顶部提示区给出目标图标(120×120 的透明底剪影图),要求"点击图中所有与目标相同的图标"。(该部分不参与模型训练,模型训练好后,需要用该目标与模型检测出来的目标进行匹配验证,用什么方法匹配代码需要自己编写(网盘里有),模型只做目标检测)
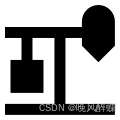
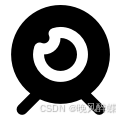
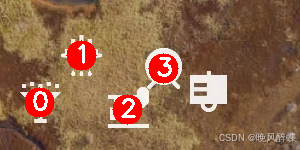
我们的测试样例与模型检测效果(红框 + 序号为模型输出):
测试输出
0: 320x640 5 icons, 352.6ms
Speed: 9.7ms preprocess, 352.6ms inference, 13.7ms postprocess per image at shape (1, 3, 320, 640)
模板 0.png -> 目标框 0 (相似度: 0.72) -> 坐标: [39, 102]
模板 1.png -> 目标框 3 (相似度: 0.93) -> 坐标: [81, 55]
模板 2.png -> 目标框 4 (相似度: 0.77) -> 坐标: [127, 109]
模板 3.png -> 目标框 1 (相似度: 0.66) -> 坐标: [163, 68]
匹配完成,结果已保存至: ./ceshi\result_112.png
最终生成的点击坐标顺序列表为: [[39, 102], [81, 55], [127, 109], [163, 68]]
整体思路:检测 + 匹配,两段式
一个常见的设计误区是把每个图标种类都建成一个 YOLO 类别。本文的选择是:YOLO 只做一件事——把"图标"从复杂背景里框出来;"哪个图标是目标"交给模板匹配。
为什么这样拆?见下一节。
二、数据集设计:为什么只建一个类别
2.1 目录结构与配置
数据集是标准 YOLO 目标检测格式,从网盘下载后目录如下:
图标点选验证码/
├── data.yaml                  # 数据集配置
├── dataset/
│   ├── images/
│   │   ├── train/             # 99 张训练图
│   │   └── val/               # 12 张验证图
│   ├── labels/
│   │   ├── train/             # 与图片同名的 .txt 标注
│   │   └── val/
│   └── candidates/            # 111 个图标模板库(每类一个文件夹)
│       ├── 0/0.png 1.png ...
│       └── 110/...
└── ceshi/                     # 测试验证码图 + 目标图标 + 检测结果图
data.yaml 内容非常简洁——只有一个类别:
path: dataset/
train: images/train
val: images/val
nc: 1
names: ['icon']
标注文件是标准 YOLO 格式(类别id 中心x 中心y 宽 高,均归一化到 0~1):
# labels/train/0.txt:一张图 5 个图标
0 0.105000 0.453333 0.150000 0.306667
0 0.223333 0.733333 0.153333 0.306667
0 0.410000 0.440000 0.153333 0.293333
0 0.631667 0.503333 0.163333 0.313333
0 0.851667 0.493333 0.163333 0.320000
2.2 关键决策:nc=1 的三个理由
| 维度 | 每种图标一个类别(nc=111+) | 单类别 icon(本文方案) |
|---|---|---|
| 标注成本 | 每种图标都要单独标,新图标上线就要重新标 | 只框"是个图标",标注快一个数量级 |
| 数据量要求 | 111 类平摊到 99 张图,多数类别只有几个样本,训练必翻车 | 单类别 99 张图足够收敛 |
| 泛化能力 | 没见过的新图标识别不了 | 换新图标库也能检出,只补模板库即可 |
分类这件事,模板匹配用几行 OpenCV 就能高质量完成(图标是标准剪影图,形状特征极其稳定),没必要让神经网络又当裁判又当运动员。这就是"问题 → 分析 → 结论":检测交给 YOLO 解决背景干扰问题,分类交给模板匹配解决换图标库问题,两边各干各的擅长事。
【图:candidates 图标模板库截图(透明底剪影图),建议放一张】
💡 顺带一提:
candidates/里 111 个文件夹就是图标模板库,每个图标都是 120×120 透明底 PNG。真正参与"匹配目标"这一步的,其实只需要验证码顶部提示的那一张目标图。
三、训练:从 yolo11m.pt 到 best.pt(含环境安装)
3.1 环境安装
# 建议 Python 3.9+,CUDA 版 torch 按官网命令安装
pip install ultralytics -U

# 验证安装
python -c "import ultralytics; print(ultralytics.__version__)"
# 预期输出:8.3.x
3.2 训练脚本
from ultralytics import YOLO

# 加载官方预训练权重(首次运行会自动下载,网盘里也备了一份)
model = YOLO("yolo11m.pt")

model.train(
    data="data.yaml",
    epochs=150,
    imgsz=320,       # 关键:验证码只有 300x150,图标约 45~50px
                     # 用 640 纯属浪费算力,320 正合适
    batch=16,
    patience=30,     # 早停:小数据集 30 个 epoch 无提升就停,防过拟合
    device=0,        # 无 GPU 改成 device="cpu"(建议还是借一张卡)
)
预期运行结果:控制台逐 epoch 输出 box_loss/cls_loss/dfl_loss 与 mAP50;训练结束后在 runs/detect/train/ 生成 results.png(损失与 mAP 曲线)、confusion_matrix.png,权重保存在 runs/detect/train/weights/best.pt 和 last.pt。
【图:训练完成后 runs/detect/train/results.png 训练曲线截图,建议放一张】
💡 为什么选 yolo11m 而不是 n/s:单类别小图 n/s 也能跑起来,但图标剪影在纹理背景上对比度不稳定,m 的特征提取能力明显更稳;且推理阶段一次只处理一张 300×150 的小图,m 的参数量完全不构成瓶颈。
3.3 验证与单图推理
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")

# 1) 验证集评估
metrics = model.val()
print("mAP50:", metrics.box.map50)
# 预期输出:99 张训练量的单类别任务,mAP50 通常能到 0.95 以上

# 2) 单图推理并保存可视化结果
model.predict(source="ceshi/112.png", conf=0.5, save=True)
# 结果保存在 runs/detect/predict/ 下,即第一节的效果图
四、推理实战:YOLO 检测 + 剪影模板匹配
这一步是很多同类教程缺掉的"最后一公里":检测出框只是半成品,要判断哪个框是目标图标并输出点击坐标。
思路:目标图标是透明底剪影 PNG,alpha 通道就是天然的标准模板;验证码里裁出的候选图标用 Otsu 自适应阈值二值化提取剪影,两个掩膜缩放到同一尺寸后算 IoU 相似度即可。完整代码:
import cv2
import numpy as np

def silhouette_from_crop(img_bgr: np.ndarray) -> np.ndarray:
    """从验证码裁剪图中提取图标剪影掩膜(Otsu 二值化)"""
    gray = cv2.cvtColor(img_bgr, cv2.COLOR_BGR2GRAY)
    _, mask = cv2.threshold(gray, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
    return mask

def silhouette_from_target(png_path: str) -> np.ndarray:
    """目标图标是透明底 PNG,直接取 alpha 通道当掩膜"""
    rgba = cv2.imread(png_path, cv2.IMREAD_UNCHANGED)
    return (rgba[:, :, 3] > 0).astype(np.uint8) * 255

def mask_iou(m1: np.ndarray, m2: np.ndarray, size=(64, 64)) -> float:
    """缩放到统一尺寸后计算两个掩膜的 IoU"""
    a = cv2.resize(m1, size) > 127
    b = cv2.resize(m2, size) > 127
    inter = np.logical_and(a, b).sum()
    union = np.logical_or(a, b).sum()
    return inter / union if union else 0.0

def solve(captcha_path: str, target_path: str, model, conf=0.4, thr=0.55):
    """返回目标图标在验证码中的中心点坐标列表(即点击坐标)"""
    target = silhouette_from_target(target_path)
    img = cv2.imread(captcha_path)
    result = model.predict(img, conf=conf, verbose=False)[0]

    points = []
    for box in result.boxes:
        x1, y1, x2, y2 = map(int, box.xyxy[0])
        crop = img[y1:y2, x1:x2]
        mask = silhouette_from_crop(crop)
        # 关键细节:Otsu 的前背景极性可能颠倒(图标比背景亮或暗),
        # 正反掩膜各算一次 IoU 取大者,一行代码救活大量误判
        iou = max(mask_iou(mask, target), mask_iou(255 - mask, target))
        if iou >= thr:
            points.append({"xy": ((x1 + x2) // 2, (y1 + y2) // 2), "score": round(iou, 3)})
    return points

if __name__ == "__main__":
    from ultralytics import YOLO
    model = YOLO("best.pt")
    clicks = solve("ceshi/112.png", "ceshi/0.png", model)
    print(clicks)
    # 预期输出(示例):
    # [{'xy': (34, 69), 'score': 0.81}, {'xy': (182, 47), 'score': 0.76}]
【图:solver 运行后把命中坐标画回原图的效果截图,建议放一张】
几个容易忽略的实现细节,都是实测踩出来的:
- 掩膜极性问题:图标可能是亮色也可能偏暗,Otsu 之后前景/背景可能颠倒,
max(正掩膜 IoU, 反掩膜 IoU)是成本最低的兜底; - 透明背景要用 alpha 而不是二值化:目标 PNG 的"黑色部分"其实是透明的,直接读成灰度图会把整个图当成全黑,
IMREAD_UNCHANGED+ alpha 通道才正确; conf别设太高:0.4 左右配合模板匹配的thr过滤,比单靠高 conf 漏检率低得多——YOLO 负责"宁滥勿缺",匹配负责"去伪存真"。
五、常见问题与排错
| 现象 | 原因 | 解决 |
|---|---|---|
| 训练启动报找不到图片/警告数量对不上 | 网盘下载解压后有 *.png.baiduyun.uploading 残留(百度网盘客户端没传完的临时文件,数据集里有 18 个) | 全局搜索 .baiduyun.uploading 删掉即可 |
| 显存不足 CUDA out of memory | m 模型 + batch 偏大 | batch=8 或换 yolo11s.pt;再不行降 imgsz=256 |
| mAP 很高但实际漏检 | conf 阈值过高、验证集太小看不出 | 预测时 conf=0.4 以下,交给模板匹配过滤 |
| 检测框位置整体偏移 | 训练/推理 imgsz 差异过大 | 训练与推理统一 imgsz=320 |
| 匹配 IoU 全都低于阈值 | 目标图读了灰度而非 alpha | 确认用 IMREAD_UNCHANGED 读取 PNG |
| 换了新图标库后识别变差 | 只影响模板匹配,不影响检测 | 向 candidates/ 补充新图标模板即可,无需重新训练 |
总结
回顾这篇实战,能带走的东西:
- 两段式建模:单类别 YOLO 检测(解决"从背景里找图标")+ 剪影模板匹配(解决"哪个是目标"),比多类别建模省一个数量级的标注量,还天然支持图标库更新;
- 小图小数据集的调参常识:
imgsz贴近原图尺寸(320 足够)、patience早停防过拟合、99 张图也能把 mAP50 做到 0.95+; - 一条完整的推理链路代码:检测框 → Otsu 剪影 → alpha 模板 → 掩膜 IoU → 输出点击坐标,可直接复用到同形态的其他点选验证码上;
- 网盘资源开箱即用:数据集、
yolo11m.pt、训练好的best.pt都在文首链接里,下载后删掉.baiduyun.uploading残留即可复现全流程。
适用边界与时效
- 本文方案适用于剪影/扁平风格的图标点选验证码;如果图标带复杂纹理、强变形,模板匹配的 IoU 阈值需要放宽,或换用特征匹配(ORB/SIFT)乃至小型分类网络;
- 若验证码要求"按提示顺序点击多个不同目标",把
solve()循环调用每个目标即可; - YOLO11 训练接口在 ultralytics 8.3.x 验证可用,后续大版本若 API 变动,以官方文档为准。
如果对你有帮助,点赞收藏关注不迷路~ 有问题欢迎在评论区交流。
标签:YOLO11 验证码识别 目标检测 Python 实战教程


 扫一扫


 625

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


