


本文深入剖析了ChatGPT的成功原因,主要涵盖技术突破与商业策略两大方面。技术层面,ChatGPT基于自回归语言模型,通过无监督训练和大量代码数据训练,并运用人类反馈强化学习(RLHF)进行微调,实现了强大的语言理解和生成能力。商业策略上,ChatGPT通过开放免费使用、便捷操作、多场景适用和卓越性能,迅速获得大众支持。此外,OpenAI与微软等合作,搭建了强大的计算集群,实现了高效的模型训练和工程化应用,进一步巩固了ChatGPT的市场地位。
让我们开始继续跟着阿里的"独行"老师学习AI大模型课程.
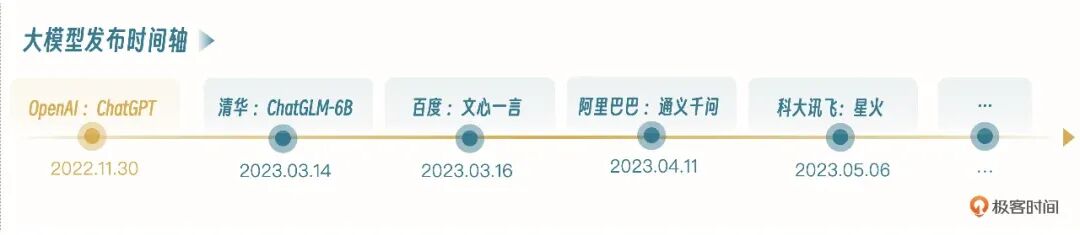
关于介绍chatgpt的文章就略过了.国内从2023年3月开始,相继发布百度的文心一言,4月的阿里通义千问,5月科大讯飞的星火认知大模型等.
(其他一些称赞ChatGPT商业成功的话.包括跟哪些巨头合作了等等)
那么ChatGPT具体是如何赢得这场胜利的呢?
NLP技术突破: 强势整合技术资源
基于Transformer架构的语言模型大体上分为两类,一类是以BERT为代表的掩码语言模型(Masked Language Model,MLM),一类是以GPT为代表的自回归语言模型(Autoregressive Language Model,ALM). OpenAI的创建宗旨是,创建造福全人类的安全通用人工智能(AGI),所以创立之初就摒弃了传统AI模型标注式的训练方式,因为可用来标注的数据总是有限的,很难做得非常通用.那么为了实现AGI,OpenAI在技术上到底做对了什么?
基于自回归的无监督训练
GPT系列模型一直走的是和BERT不同的路线,早些年压力巨大,毕竟BERT是Google发布的,很权威,但是OpenAI一直认为自回归模型训练潜力更大,尤其在GPT-2引入zero-shot后,更加有信心了.
zero-shot(零样本学习)是一种让模型在没有接受特定任务训练样本的情况下,
直接对该任务进行处理的方法。其核心思想是通过在大规模的无标签数据上进行
预训练,使模型学习到丰富的语言知识和理解能力,从而能够理解和执行各种自
然语言处理任务。
那么按照人类语言的习惯,语言本身就有先后顺序,而且我们日常说话也是下文依赖上文.所以有人猜测,自回归语言模型代表了标准的语言模型,利用上文信息预测下文,这比传统AI预测更加复杂,但是上限更高,更有望通向AGI,这正是OpenAI的愿景.尽管在GPT-1和GPT-2的探索中没有取得压倒性的效果,但确实验证了标准语言模型在zero-shot等方面的潜在能力.
(我:刚看了上面zero-shot的介绍,就应该是让模型有学习的目录,但是学习的资源或者学习的标准答案,当时模型其实是没有那么多的,需要模型通过网络等相关方式自查自解答吧)
继续看无监督,无监督自回归的训练方式,使GPT模型可以接受大量文本数据,所以后面有了GPT-3,1750亿的参数规模,使GPT-3直接问鼎当时最大的模型,GPT-3使用了大约45TB的文本数据,一次训练费用接近460万美元,在当时,相比上一代模型GPT-2,效果已经非常好了,这也是人们所讲的大力出奇迹.
但是,我们现在来看这个问题,GPT-3发布时间大概是2020年3月,当时的GPT-3还不具备直接和人类对话的能力,而ChatGPT所使用的模型是GPT-3.5,爆火时间在2022年年底到2023年3月,期间2年时间,OpenAI在做什么呢?(我:作者不问谁也不会问这个问你吧,如果你和我一样一开始也是从2022年末尾接触的chatgpt,其他时间都是躲避疫情,根本没关注2020年的gpt-3,你应该那个时间还编码比较手工的,属于古法编程了)
答案是OpenAI在想办法让GPT模型可以优雅地和人类对话.
与人类意识对齐(Alignment)
其实就是讲述怎样让GPT回答更符合人类常识.然后细化的模型如code-davince就是codex使用的模型,在text-davince-001基础上使用源代码进行了训练,产生了code-davinci-002模型(codex)等等.
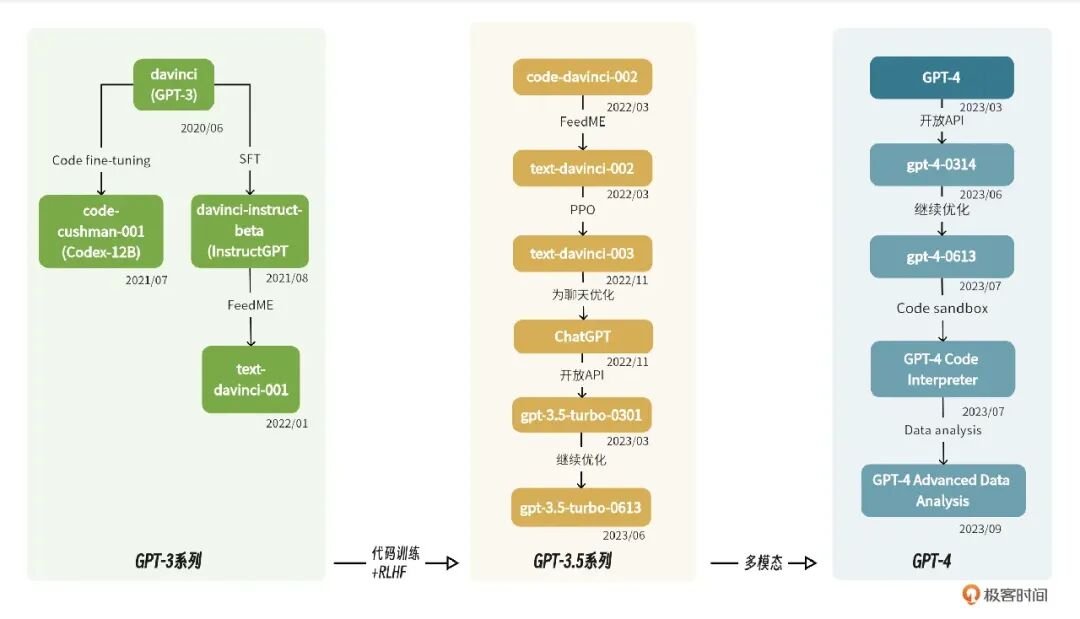
GPT-3经过充分训练,但是依然不是一个适合与人类进行对话的模型,所以从GPT-3到GPT-3.5再到InstructGPT和ChatGPT,参数规模并没有太大变化,主要经过了各种技术的微调,说白了就是适配人类情景.其中最突出的就是RLHF,RLHF就是Reinforcement Learning From Human Feedback(人类反馈强化学习)的简称.
突现能力(Emergent Ability)
突现能力是指大预言模型展现出来的特有的强大能力,比如复杂推理,思维链等.这些是NLP领域一直追求的能力,在大模型出现后,这些能力也随之浮现出来.文章中这段还讲了面向对象编程和AI解答问题的相关性.不过没法证明这点.
Summary
-
模型不是越大越好,论参数,GPT-3的1750亿不是参数最大的模型,比如,微软和英伟达联合开发的Megatron-Turing模型拥有超过5000亿个参数,但是性能方面并不是最好的,因为模型未经过充分地训练.
-
RLHF也不是最早用在GPT上的,却在恰当的时机用到了ChatGPT身上.
-
在语言模型上使用大量代码进行训练,只有codex这么做了.
所以,ChatGPT在技术上的突破可以理解为:
自回归语言模型+充分无监督训练+大量代码训练+有监督指令微调+RLHF
作者夸赞GPT的大力出奇迹…为什么它能大力呢?
超大规模数据集: 超过40T的文本数据
大模型训练首先需要搞定高质量的数据集,我们分两个点去考虑.
首先,我们一起看作者整理好的GPT-3的训练数据集介绍,GPT-3模型具有1750亿个参数,训练数据集大约500B个token(1B=1 billion,也就是10亿),下面是训练数据大概的组成结构:
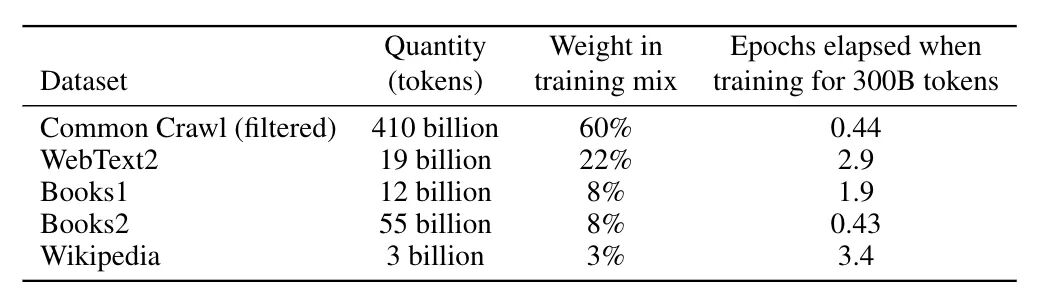
数据源于官方的 GPT-3 论文《Language Models are Few-Shot Learners》
原始大约45T的纯文本数据,经历过滤后,大概是750G的高质量文本数据.
再看ChatGPT的训练数据,ChatGPT属于GPT-3.5系列,官方并没明确说明这个模型的参数规模,所以网上看到的大部分数据都是猜测,有人说15亿,有人说20亿甚至1500亿,但是大概率,ChatGPT的参数规模是小于GPT-3的,其训练数据基于大量对话型数据进行指令微调,典型训练数据如下:
-
Persona-Chat 的数据集: 专门用于训练ChatGPT等会话式AI模型,由两个人类参与者之间的超过160,000条对话组成,每个参与者都被分配了一个独特的角色来描述他们的背景,兴趣和个性,这使得ChatGPT能够学习如何生成个性化且与对话的特定上下文相关的响应.
-
康奈尔电影对话语料库: 包含电影脚本中角色之间对话的数据集. 包括10,000多个电影角色之间的200,000多次对话,涵盖各种主题和类型.
-
Ubuntu对话语料库: 寻求技术支持的用户与Ubuntu社区支持团队之间多轮对话的集合. 它包含超过100万个对话,使其成为用于对话系统研究的最大的公开数据集之一.
-
DailyDialog: 各种主题的人与人对话的集合,从日常生活对话到有关社会问题的讨论,数据集中的每个对话都由几个回合组成,并标有一组情感,情绪和主题信息.
除了这些数据集之外,ChatGPT还接受了互联网上大量非结构化数据的训练,包括网站,书籍和其他文本源,这使得ChatGPT能够从更一般的意义上了解语言的结构和模式,然后可以针对对话管理或情感分析等特定应用进行微调.
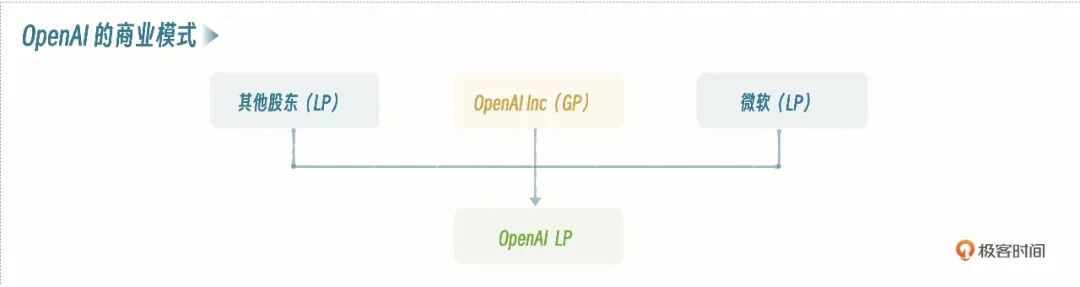
然后关于商业这块讲了一下,这里不展开.
产品化开放: 让大家随便玩
ChatGPT成功在于,愿意公开免费给普通用户用.
便捷使用
大部分的AI厂家只发布模型,而ChatGPT注册完成就可以通过网页使用.
适用场景多
https://platform.openai.com/examples
OpenAI官网公开的ChatGPT使用场景有30类(见上面链接),可以用于代码编写,代码翻译,智能问答,语音识别,模拟面试,情感分析,机器翻译,智能客服等多个领域,这使得更多的人能够感受到ChatGPT带来的便利和价值,容易获得大众的支持和信任.
使用效果好
作者对比了原来的微软小冰和小度,这种很有局限性,小冰是由小模型组成的,只能同时处理特定类型任务,无法相互关联,小度也一样,无法做到通用性的回答.而ChatGPT,拟人,有记忆,有感情.
工程化应用
工程化即系统化,模块化,规范化的一个过程,我们做工程技术的开发人员很清楚,一个优秀的产品背后一定有着惊人的技术参数,就拿支付宝来说,双十一高峰期,50万笔/秒的支付吞吐量,背后是大量的服务堆出来的,比如数百万台的服务器,大量的分布式技术的应用,如缓存,消息,文件存储等等.
ChatGPT一样,OpenAI不是仅仅提供一个模型,让我们自己部署自己玩,而是直接将以大模型为内核的整套技术完成了产品化.对于两个月注册用户过亿的世界级产品来讲,这里面涉及到的技术可想而知,除了AI本身涉及的技术外,常见的工程化技术一样少不了.Web相关的不讲,主要分享模型训练相关的技术.
为了方便进行大模型训练,2020年,微软为OpenAI在Azure上搭建了计算集群,包含285,000个AMD infiniBand连接的CPU内核,另外还有10,000个NVIDIA V100 Tensor Core GPU,是当时世界上第五大超级计算机,也是有史以来在公共云中(Azure)建立的最大的超级计算机.
大模型训练动不动就是几周,几个月,而如果服务器出现故障或网络连接不稳定,怎么办?肯定不希望从头开始,那么如何实现容错呢?
微软开发了Project Forge,即Azure容器化和全局调度服务,可以保证AI计算负载保持高水平的利用率;通过建立透明检查点,定期增量保存模型的状态和代码,出现故障,恢复到最近检查点;同时硬件厂家NVIDIA也做了调整,他们的GPU实现CRIU(用户模式下的检查点恢复),可以恢复GPU的内存使用,最终和CPU的检查点保持一致.软件和硬件协同工作,提高了效率.
所以光是模型训练这一步,为了实现可靠性,就集微软工程部门,微软研究院,OpenAI团队,NVIDIA团队共同努力于一体.同时,还涉及了隐私计算,私密GPU,TE空间等等.除此之外,OpenAI还雇佣了大量工人(约7.7万人)进行人工标注,总体硬件成本接近10亿美金,单日运营成本高达70万美金,真的是很烧钱.(我:我想起前一阵子在家那边供职的那家公司,本来面试的时候聊过,我说不建议做大模型训练,只做知识库还可以,然后沟通了下云服务器大概的费用千百块钱按或按年,但是做的cms和erp差不多了,我也没急着非要服务器,那边可能自己核算了下,跟我说服务器成本又高,公司那边厂房还没建立起来erp可能暂时也不用,然后我就听懂了,然后和平分手了,这种小公司没有开发人员,之前都是找外部做的网站,其实像这种要是考虑做AI,可能要非常大的思想上和投入上的思考转变吧~)
所谓工程化主要就是指集技术,数据,产品,资源于一身,是一个系统性,规范性的工程项目.
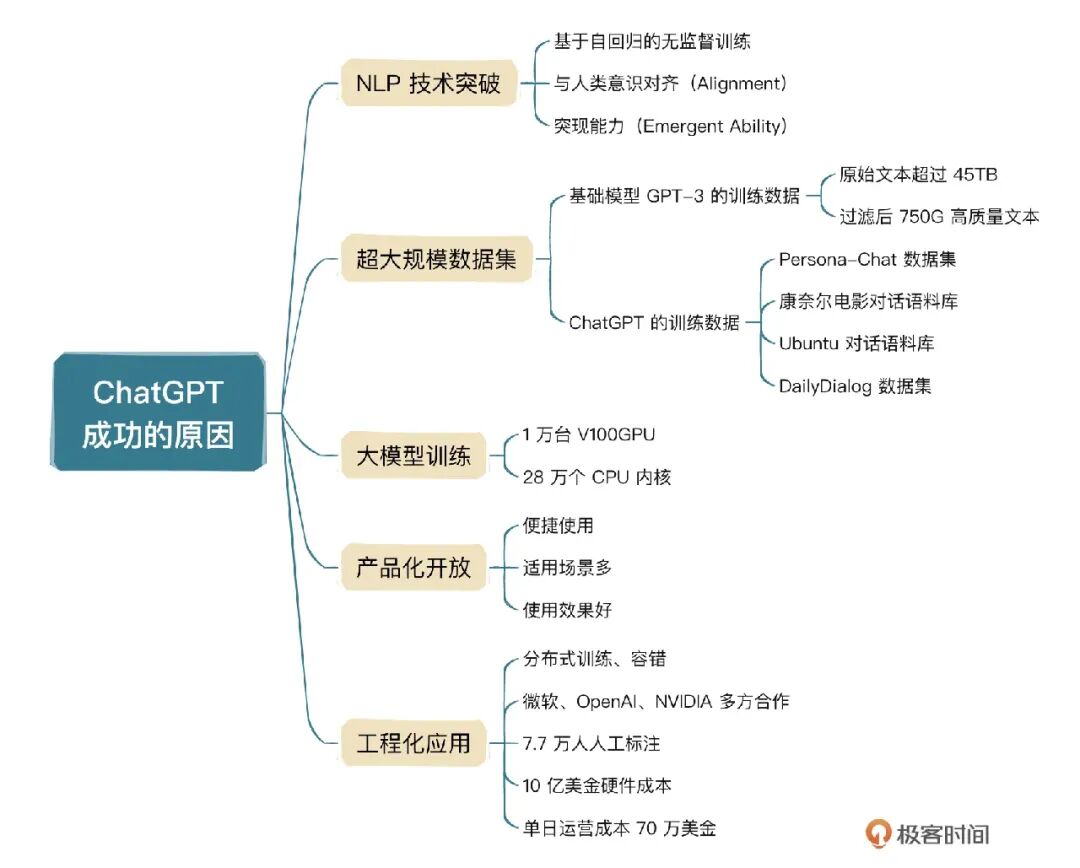
ChatGPT不是只是大模型本身,也是工程化组成的.
AI大模型还处于发展迅速的阶段(我:包括现在Authropic),实际上天天都在发生变化,所以很多事情都还没有定论,我们需要保持开放心态,不断接纳,不断学习.下一节课是,怎样用好大模型,用好提示词.
假如你从2026年开始学大模型,按这个步骤走准能稳步进阶。
接下来告诉你一条最快的邪修路线,
3个月即可成为模型大师,薪资直接起飞。
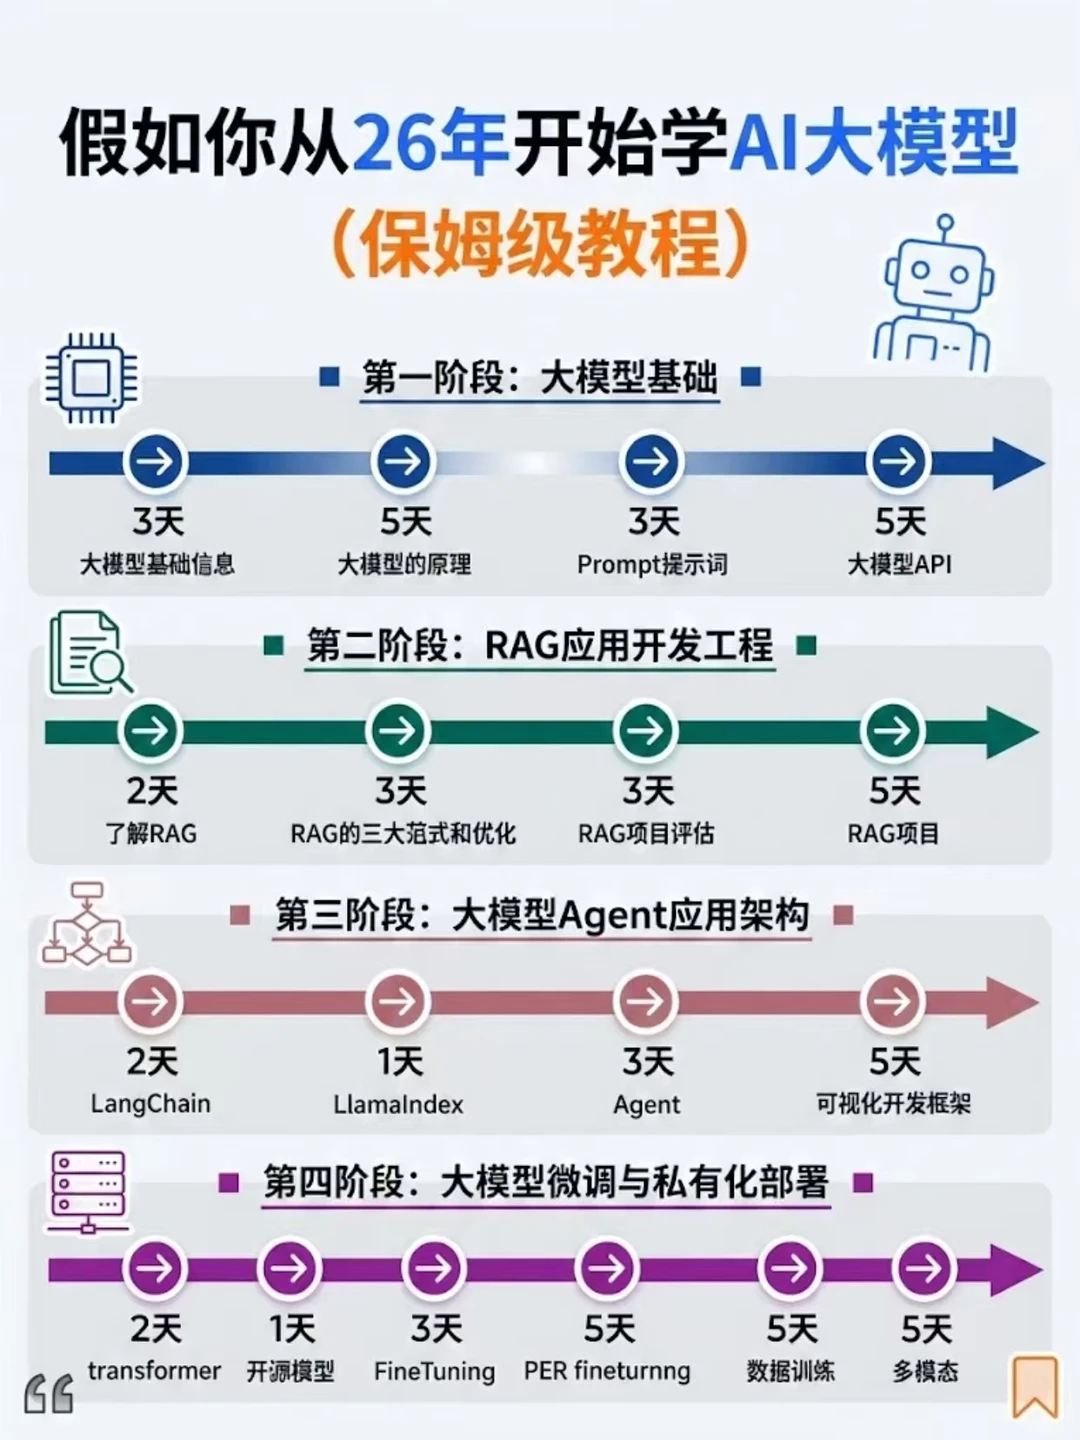
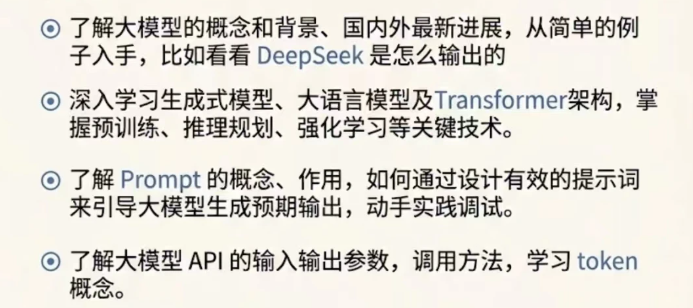
阶段1:大模型基础
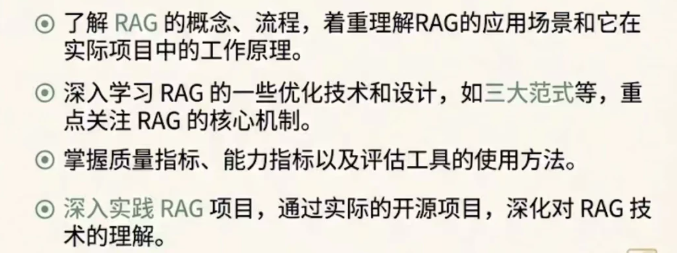
阶段2:RAG应用开发工程
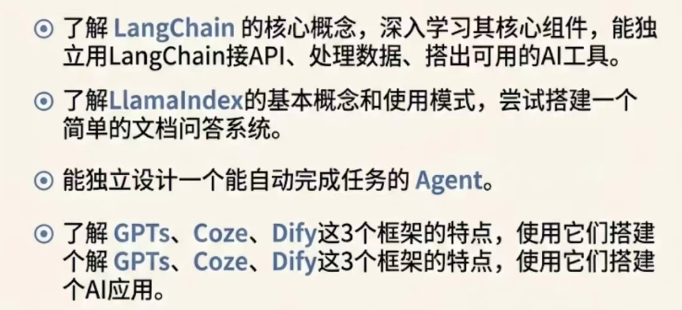
阶段3:大模型Agent应用架构
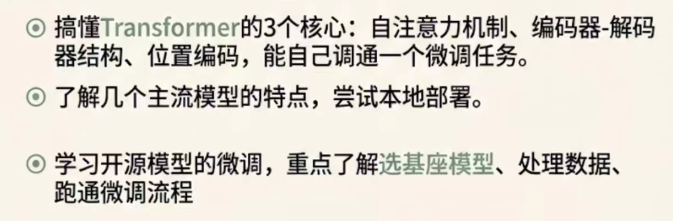
阶段4:大模型微调与私有化部署
配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇

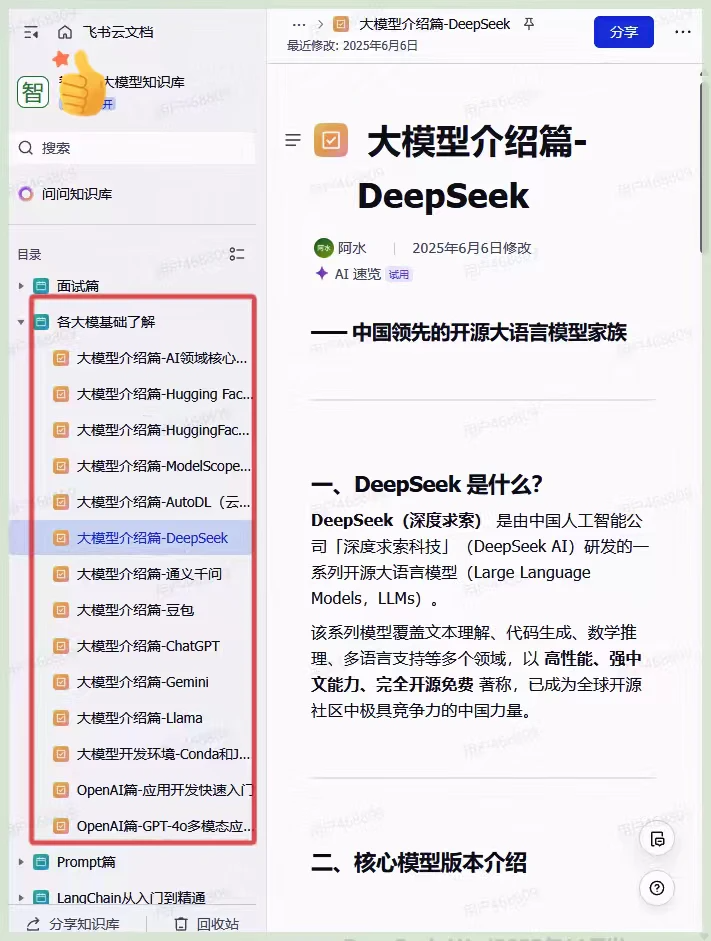
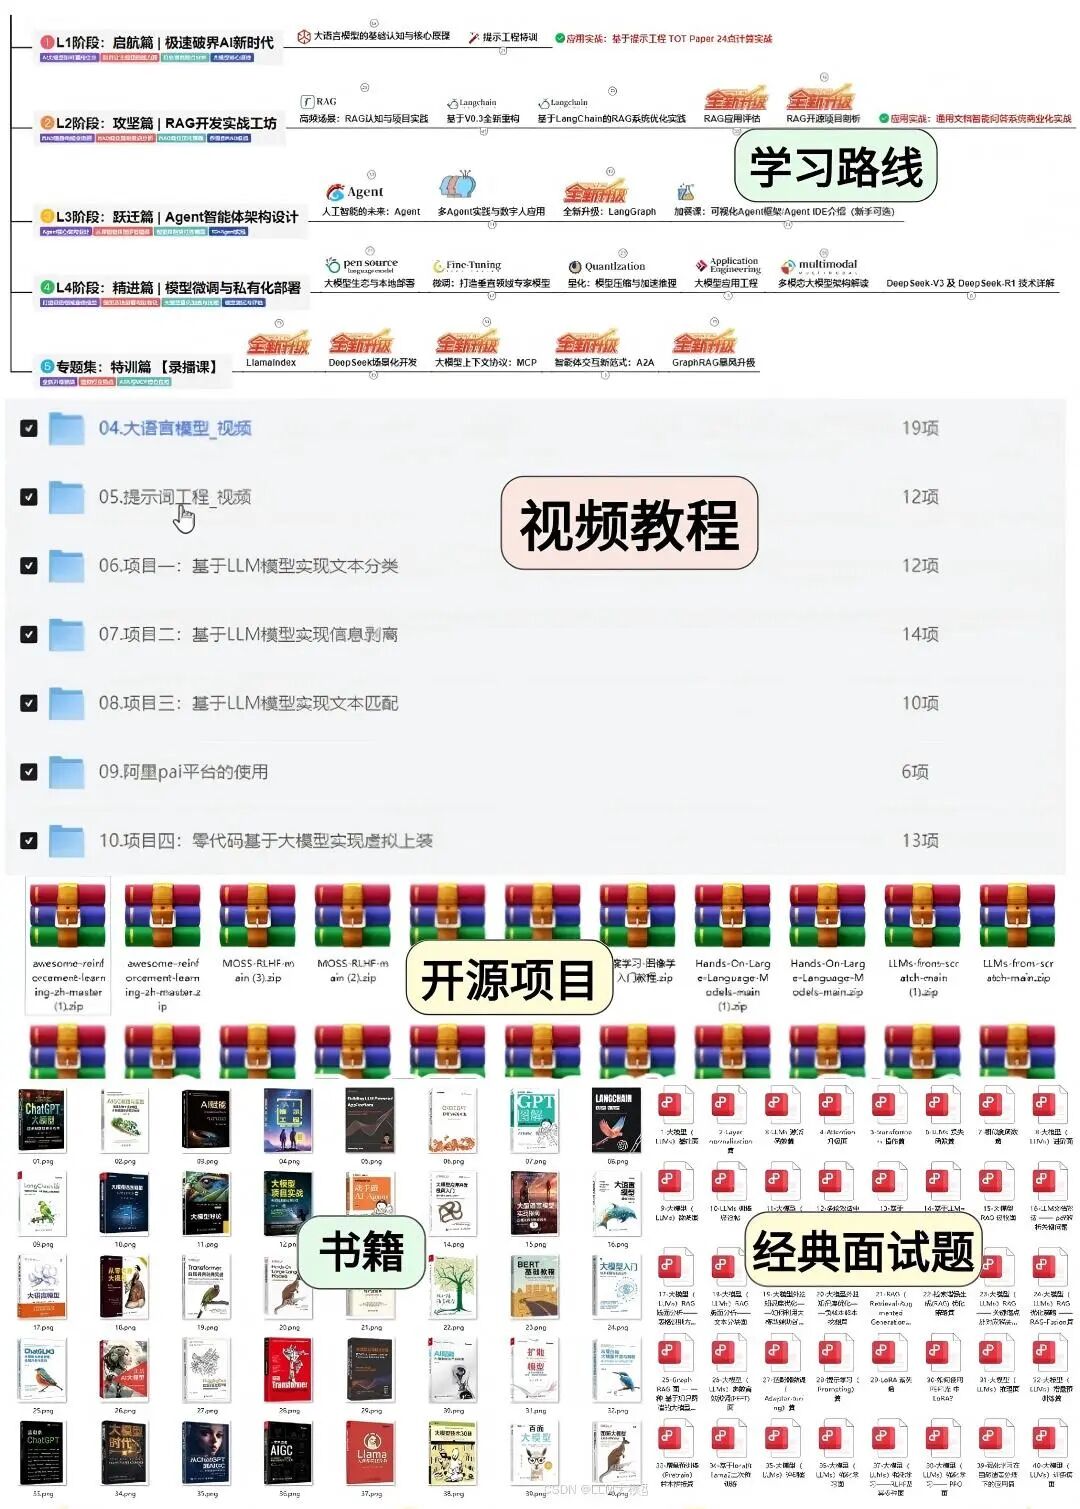
配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇


 扫一扫


 307

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


