图文匹配:Clip模型介绍

CLIP 模型全面解析 图 1:CLIP 将相关的图像和文本映射到相近的向量空间位置,不相关的则距离较远 (例如,文本描述“两只狗在寒冷田野上奔跑”会被编码到与真实犬类奔跑场景图片相似的向量;而描述“大象在塞伦盖蒂”的文本与狗的图片在向量空间中距离很远。CLIP(Contrastive Language-Image Pre-training,对比语言-图像预训练)是 OpenAI 于 2021 年提出的一种多模态模型,它通过在海量图像-文本对上进行自监督训练,将图像和文本映射到简单来说,CLIP 包含两个主体:一个和一个。 阅读详情

论文地址:Learning Transferable Visual Models From Natural Language Supervision

代码:https://github.com/openai/CLIP

Clip(Contrastive Language-Image Pre-Training)是由OpenAI于2021年推出的一种深度学习模型,它是一种可以同时处理文本和图像的预训练模型。与以往的图像分类模型不同,Clip并没有使用大规模的标注图像数据集来进行训练,而是通过自监督学习的方式从未标注的图像和文本数据中进行预训练,使得模型能够理解图像和文本之间的语义联系。

CLIP(Contrastive Language Image Pretraining)这篇文章出自OPEN-AI大名鼎鼎的Alec-Radford(GPT系列的一作,在GAN,Diffusion等各种生成领域都颇有影响力)。而CLIP这篇论文可以看做是多模态在预训练时代的一次妙到巅峰的任务设计。

NLP领域里借助海量文本进行无(自)监督式的预训练使得各种与下游任务类型无关的模型架构成为可能,并取得了非常好的迁移性和效果。CLIP使用了一种对比学习的方式,在4亿图文对上进行了文本和图片的匹配任务训练,使得该模型在无任何微调的情况下(zero-shot),在imageNet上取得了和ResNet-50微调后一样的效果。
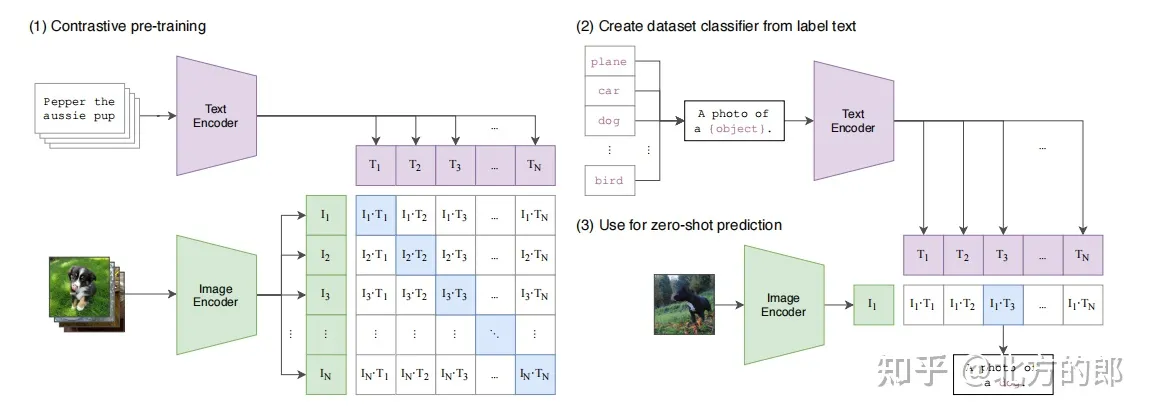
Clip模型的核心思想是通过学习图像和文本之间的匹配关系来提高模型的性能。具体来说,Clip模型包含两个主要组成部分:一个用于处理图像的卷积神经网络(CNN)和一个用于处理文本的Transformer模型。这两个组件都被训练成能够将输入的信息映射到相同的嵌入空间中,并使得相似的图像和文本在嵌入空间中的距离更近。

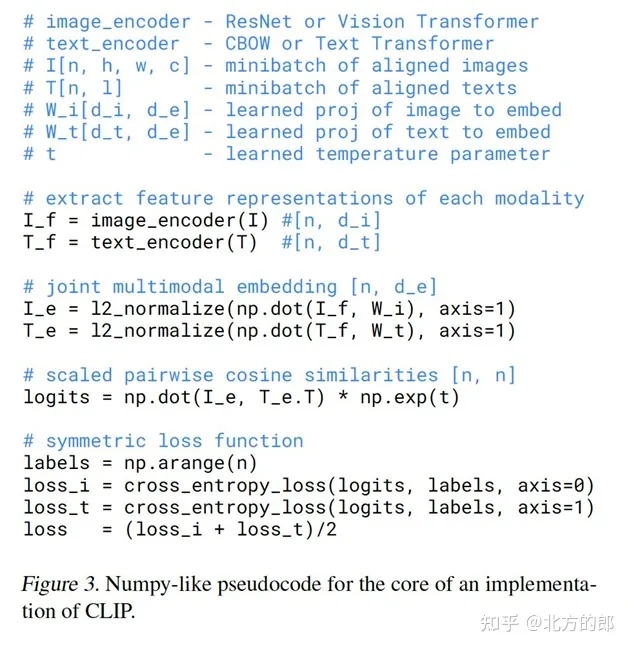
Clip模型的预训练分为两个阶段:第一阶段是通过一个大规模的文本数据集来训练Transformer模型,使得模型能够理解文本之间的关系;第二阶段则是使用一个大规模的图像和文本数据集来训练整个Clip模型,使得模型能够将文本和图像之间的联系进行匹配。实现的伪代码如下:
Clip模型的一个重要应用是图像分类,它可以将输入的图像和文本信息进行匹配,从而识别图像的内容。此外,Clip模型还可以用于图像生成、图像检索、视觉问答等任务。


大模型学习 -- CLIP 这样做的好处是减小了sequence的长度,也就减少了计算量,训练速度更快;CLIP的双塔结构分别提取图像和文本的全局特征做对比学习,缺少局部信息的交互,FILIP增加了image tokens和text tokens的细粒度交互。最后,为了减少分布上的gap(训练mask测试一版不mask),FLIP会在最后增加少量的unmasking训练,可以进一步提升模型的性能。一种简单高效的CLIP加速训练方法,只需mask掉部分图像,就可以将CLIP的训练过程加速2~3倍,而且能实现更好的性能。 阅读详情

相关推荐

clip预训练模型综述

CLIP是一个预训练模型,就像BERT、GPT、ViT等预训练模型一样。首先使用大量无标签数据训练这些模型,然后训练好的模型就能实现,输入一段文本(或者一张图像),输出文本(图像)的向量表示。CLIP和BERT、GPT、ViT的区别在于,CLIP是多模态的,包含图像处理以及文本处理两个方面内容,而BERT、GPT是单文本模态的,ViT是单图像模态的。.........

zcyzcyjava的博客 2万+

openai多模态大模型:clip详解及实战

零次学习(Zero-Shot Learning,简称ZSL)假设斑马是未见过的类别,但根据描述外形和马相似、有类似老虎的条纹、具有熊猫相似的颜色,通过这些描述推理出斑马的具体形态,从而能对斑马进行辨认。零次学习就是希望能够模仿人类的这个推理过程,使得计算机具有识别新事物的能力,如下图所示。如今深度学习非常火热,使得纯监督学习在很多任务上都达到了让人惊叹的结果,但其限制是:往往需要足够多的样本才能训练出足够好的模型,并且利用猫狗训练出来的分类器,就只能对猫狗进行分类,其他的物种它都无法识别。

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 7万+

避坑指南:MTK平台Widevine L1密钥安装全流程详解(含SP META工具使用与Log分析)

本文详细解析了MTK平台实现Widevine L1认证的全流程,涵盖密钥申请、格式转换、安全烧录等关键步骤,特别针对Trustonic TEE环境下的SP META工具使用与日志分析提供实用指南。帮助开发者规避常见错误,确保DRM密钥安全部署,满足高端内容保护需求。

weixin_27219587的博客 471

多模态模型学习1——CLIP对比学习 语言-图像预训练模型

学了一些多模态的知识,CLIP算是其中最重要也是最通用的一环,一起来看一下吧。CLIP的全称是Contrastive Language-Image Pre-Training,中文是对比语言-图像预训练,是一个预训练模型,简称为CLIP。该模型是 OpenAI 在 2021 年发布的,最初用于匹配图像和文本的预训练神经网络模型,这个任务在多模态领域比较常见,可以用于文本图像检索,CLIP是近年来在多模态研究领域的经典之作。该模型大量的成对互联网数据进行预训练,在很多任务表现上达到了目前最佳表现(SOTA)

Bubbliiiing的学习小课堂 6万+

基于STM32的馆藏文物保存环境监测系统设计与实现

针对馆藏文物保存环境中温湿度、光照、有害气体等参数波动易导致文物损坏的问题,本文设计了一种基于STM32微控制器的馆藏文物保存环境监测系统。该系统以STM32L431RCT6为核心,集成高精度传感器实现多参数实时采集,通过有线与无线结合的通信方式构建监测网络,具备数据存储、异常预警、远程监控等功能。测试结果表明,系统温湿度测量精度分别达±0.2℃、±2%RH,光照与有害气体检测误差≤5%,可满足文物保存环境的高精度监测需求,为文物保护提供科学的数据支撑。

m0_74026776的博客 1534

26 硬件工程师笔面试高频考点真题解析——CAN总线

CAN总线是一种差分多主串行半双工总线,采用非破坏性位仲裁机制和五层硬件错误检测(位错误、填充错误、CRC校验、格式错误、应答错误),具有高可靠性和故障容错能力。关键设计包括两端120Ω终端电阻匹配阻抗、手拉手总线拓扑、显性/隐性电平优先级仲裁。常见故障分析指出多节点异常多因终端电阻错配/漏装、星型布线违规或总线过载;高速通讯失败常由阻抗失配或线缆过长导致信号反射。相比RS485,CAN支持多主架构、硬件自动仲裁和节点故障隔离,更适用于汽车、工业等高可靠场景。

XU157303764的博客 524

CLIP有多牛?AI终于能”看图说话”了!

CLIP是OpenAI开发的多模态预训练模型,通过对比学习将图像和文本映射到共享向量空间,使语义相近的内容向量距离更近。其核心是通过图像编码器(ResNet/ViT)和文本编码器(Transformer)分别处理多模态数据,使用InfoNCE损失函数优化图文匹配能力。CLIP可直接应用于图文检索、零样本分类等任务,并作为Stable Diffusion等模型的语义编码器。当前大模型技术岗位需求激增,掌握CLIP等AI技术可显著提升职业竞争力。学习路径建议分阶段从应用开发延伸至模型训练,最终实现商业落地。

2401_85390073的博客 1120

(11-3-03)多任务与元强化学习:综合实战:基于元强化学习的迷宫导航系统(3)

本文介绍了策略网络隐空间可视化的实现方法及其在强化学习中的应用。通过设计visualize_latent_space函数,使用t-SNE算法将高维隐空间特征降维至二维进行可视化,直观展示策略网络在不同任务中的特征分布。文章详细阐述了实现流程:状态收集、t-SNE降维和可视化绘图,并提供了完整的Python代码示例。实验结果表明,该方法能有效分析策略网络的学习过程与适应能力,为优化模型提供重要依据。同时,文章还介绍了主程序的完整流程,包括环境初始化、元智能体训练与评估、学习策略比较等环节,最后对实验结果进行可

码农三叔 1034

CLIP-GmP-ViT-L-14图文匹配测试工具快速上手:3步完成Dify工作流集成

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,并快速集成至Dify工作流。通过简单的三步配置,用户无需编码即可构建一个能计算图片与文本语义相似度的应用,典型场景如快速从图库中筛选出与“阳光下睡觉的猫”等描述最匹配的图片。

weixin_42594419的博客 195

三臂杆大型液压机械臂集中式ADRC控制系统设计

本文设计了一种用于三臂杆液压机械臂的集中式自抗扰控制(ADRC)系统。该系统通过建立包含惯性矩阵、科氏力、重力及摩擦力的非线性动力学模型,并集成液压系统传递函数,构建了完整的系统模型。控制方案采用跟踪微分器安排过渡过程,扩张状态观测器实时估计系统状态和总扰动,以及非线性状态误差反馈生成控制量。MATLAB实现展示了集中式ADRC控制器的核心结构,包括参数定义、跟踪微分器、扩张状态观测器和非线性反馈模块的设计。该系统能有效处理多关节耦合效应,实现三输入三输出的MIMO控制,具有抗干扰能力强、响应速度快的特点。

huanghm88的专栏 261

一文读懂 SAP ERP / SAP S/4HANA 里的 Price List:概念、配置、定价流程与可运行 ABAP 示例

SAP ERP/S4HANA中的Price List解析 本文系统阐述了SAP定价体系中Price List的核心概念和实现机制。Price List并非独立的价目表,而是通过条件技术(条件类型、访问序列、条件记录)与Price List Type(PLTYP)共同作用的定价维度。文章详细说明了: Price List本质上是客户主数据中的PLTYP字段,作为定价查找键使用 定价流程中条件访问序列如何利用PLTYP查找特定价格 S4HANA与ECC版本在价格维护入口的差异 实际业务中如何通过不同PLTYP实

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 636

CLIP-GmP-ViT-L-14图文匹配工具基础教程:理解CLIP相似度矩阵与logits物理意义

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,并解析其核心原理。该工具能快速计算图片与文本描述的匹配度,其典型应用场景包括评估AI生成的图片描述准确性或进行商品图片的自动化分类,为多模态AI应用开发提供直观的验证手段。

weixin_33759613的博客 315

swl安装无法与服务器建立链接,如何解决?

🏆本文收录于《全栈Bug调优(实战版)》专栏,主要记录项目实战过程中所遇到的Bug或因后果及提供真实有效的解决方案,希望能够助你一臂之力,帮你早日登顶实现财富自由🚀;同时,欢迎大家关注&&收藏&&订阅!持续更新中,up!up!up!! 备注:部分问题/疑难杂症搜集于互联网。

**My Coding Family** 2055

CLIP图文匹配测试工具快速入门:Streamlit界面,操作简单效果直观

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,实现高效的图文匹配验证。该工具基于Streamlit界面,用户无需编写代码即可上传图片、输入文本描述,快速获取匹配结果,适用于内容审核、智能推荐等场景。

weixin_42629522的博客 57

平衡小车原理图

平衡小车原理图,结构化小车,更加方便制作属于自己的平衡小车

RexUniNLU多模态扩展:结合CLIP模型的图文理解

本文介绍了如何在星图GPU平台上自动化部署中文NLP综合分析系统(RexUniNLU零样本通用自然语言理解)镜像,并结合CLIP模型构建多模态图文理解系统。该系统的一个典型应用场景是电商平台的智能图文审核,可自动校验商品图片与文字描述的一致性,提升审核效率与准确性。

weixin_42405592的博客 173

动漫设计基于暗黑神话的3D角色生成提示词:西游记29位人物动漫形象构建与视觉表现系统

内容概要:本文档提供了《西游记》中29位经典角色的暗黑风格3D动漫人物生成提示词,适用于AI绘画工具进行图像创作。每个角色均配有详细、富有张力的视觉描述,涵盖服饰、神情、武器、背景及氛围设定,融合电影级光影、8K超高清画质与极致细节纹理,突出暗黑神话美学,呈现半神半魔、战损残破、妖异诡谲的艺术风格,强化角色的凶戾气质与视觉冲击力。; 适合人群:AI绘画爱好者、数字艺术创作者、3D动漫设计师、《西游记》文化改编从业者及需要高质量角色概念设计的视觉开发人员。; 使用场景及目标:①用于豆包AI等生成模型输入,产出横屏16:9比例的暗黑风格角色立绘;②为游戏、动画、影视等领域的角色原画设计提供创意参考与文本基础;③探索传统神话人物在暗黑美学下的重构可能性。; 阅读建议:使用时应逐条复制对应角色提示词至AI绘图平台,可根据实际需求微调关键词以优化生成效果;建议配合图像生成实验同步调整描述细节,实现最佳视觉还原。

CLIP-GmP-ViT-L-14图文匹配工具入门指南:适配CLIP蒸馏小模型(如TinyCLIP)验证框架

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,实现快速评估CLIP蒸馏小模型(如TinyCLIP)的性能。该工具能通过上传图片与输入文本描述,在本地自动化计算并可视化图文匹配度,为模型验证与AI图文理解应用提供直观、高效的测试方案。

weixin_36304957的博客 258

模式识别 第四版_tixijiegou_

bangzhuruanjiankaifa

西南交通大学计算机组成原理课程设计报告.doc

西南交通大学计算机组成原理课程设计报告.doc

CLIP模型学习记录

CLIP(对比语言-图像预训练)是OpenAI提出的多模态模型,通过4亿图文对进行对比学习训练。该模型采用双流架构,分别处理图像和文本数据,在嵌入空间进行语义对齐。核心是对比学习策略,通过比较正负样本优化特征表示。训练完成后,CLIP可转换为零样本分类器,将类别名称嵌入并与图像特征匹配实现分类。该模型在零样本学习和图像搜索等任务中表现优异,能有效识别新类别并实现图文跨模态检索。

m0_62881487的博客 907

【技术解析】CLIP4Clip:多模态视频检索中的CLIP迁移实践

本文深入解析了CLIP4Clip模型,这是一种将CLIP强大的图文匹配能力迁移至视频检索领域的多模态实践。文章拆解了其视频编码器、文本编码器与相似度计算器三大核心模块的协同机制,并分享了训练技巧与参数调优心得,旨在高效解决视频-文本的跨模态检索难题。

nept的博客 811

快速验证CLIP模型效果:图文匹配测试工具本地部署指南,小白也能上手

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,实现零代码本地验证。用户可通过该工具快速测试AI模型的图文匹配能力,例如上传一张猫的图片并输入多个描述,模型即可自动计算并展示最佳匹配结果,适用于产品原型验证与技术可行性评估。

weixin_35752233的博客 263

CLIP-GmP-ViT-L-14图文匹配工具入门指南:图文匹配准确率 vs. 人类标注一致性分析

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,快速搭建本地化图文匹配测试环境。该工具可用于评估AI模型与人类判断的一致性,例如在电商场景中,自动化测试商品图片与不同文案描述的匹配准确度,为内容审核和推荐系统提供参考。

weixin_34064233的博客 370

CLIP-GmP-ViT-L-14图文匹配测试工具:为STM32嵌入式项目添加视觉问答原型

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,为STM32嵌入式设备快速构建视觉问答原型。该工具能理解图像内容并生成文本描述,典型应用场景包括智能家居监控,例如识别画面中是否有人并触发相应操作。

weixin_36213081的博客 431

CLIP-GmP-ViT-L-14实操手册:如何用该工具生成图文对比报告用于CLIP模型选型决策

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,以高效评估不同CLIP模型的性能。该工具通过直观的界面,让用户无需编码即可快速测试图片与文本描述的匹配度,核心应用场景是为智能相册、内容打标签等项目的CLIP模型选型提供可视化的数据对比报告,从而支撑技术决策。

weixin_35750953的博客 585

5步搞定CLIP图文匹配测试:上传图片输入文字看匹配结果

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,实现高效的图片与文本匹配分析。该工具可快速评估AI对图片内容的理解能力,适用于内容审核、智能标签生成等场景,用户只需上传图片并输入文字描述即可获得精准匹配结果。

weixin_28939623的博客 60

CLIP-GmP-ViT-L-14图文匹配工具保姆级教程:含模型缓存机制@st.cache_resource原理说明

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,并利用其进行AI图文相似度分析。该工具通过加载预训练模型,可快速评估图片与多个文本描述的匹配度,典型应用场景包括辅助图片内容标注、验证多模态模型理解能力等,极大提升了交互测试与原型验证的效率。

weixin_42576186的博客 265

CLIP-GmP-ViT-L-14测试工具在AR场景应用:实景图像与虚拟对象描述匹配

本文介绍了如何在星图GPU平台上自动化部署CLIP-GmP-ViT-L-14图文匹配测试工具,并探讨了其在增强现实(AR)领域的核心应用。该工具能够快速计算图像与文本描述的匹配度,典型应用场景包括AR应用中虚拟对象的智能放置,例如根据实时摄像头画面自动推荐风格匹配的虚拟家具,从而提升虚拟与现实融合的自然度与用户体验。

weixin_29496633的博客 430
上一篇: 从GPT-1到ChatGPT及最新的GPT-4,GPT系列技术的发展过程
下一篇: HugingGPT 模型整合,贾维斯来了
才能我浪费
博客等级 码龄25年 118粉丝 120原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值