


一、为什么 Agent 不是“更长的 Prompt”
很多人第一次做 Agent,会从这个公式开始:
Agent = LLM + Prompt + Tools
这个公式没错,但只够解释 Demo。
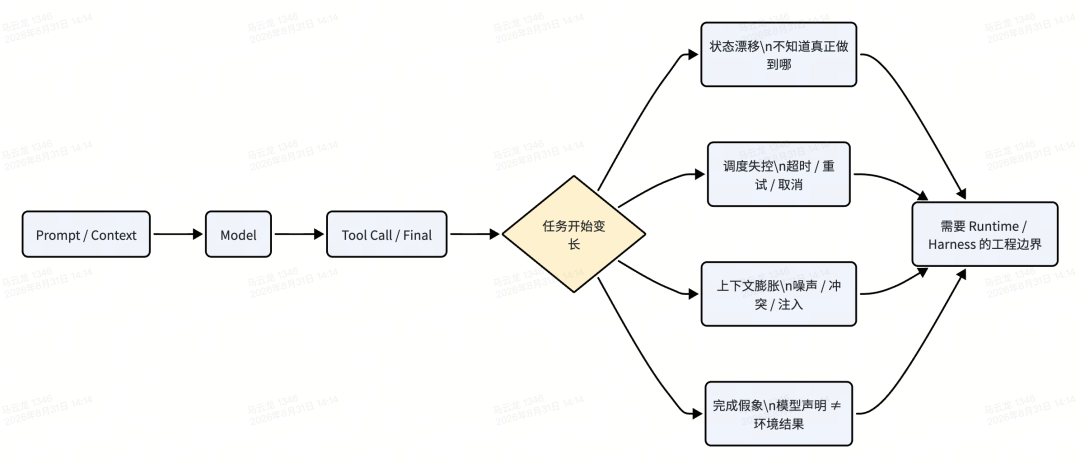
只要任务从“一次问答”变成“持续执行”,问题就会迅速从 Prompt Engineering 变成系统工程:执行到一半失败怎么办?一个动作是否已经真正提交?多个任务能不能同时修改同一个仓库?模型说“测试通过”到底算不算完成?
这些问题并不是把 Prompt 再写长一点就能解决的。
图 1:Prompt-only 为什么会失控
这里有一个特别重要的区分:
模型看到的状态,不等于系统真实状态。
例如模型在 Context 里读到“数据库已经更新”,这只代表它看到了这句话,并不代表数据库写入真的成功;模型说“测试通过”,也不代表测试命令真的以退出码 0 结束。
因此,一个生产级 Agent 至少要把下面四件事从“模型自己记住”变成“系统明确管理”:
| 问题 | 不能只靠什么 | 应由谁保证 |
| 任务进行到哪里 | 聊天历史 | 结构化状态 / Event |
| 动作是否允许执行 | Prompt 里的“不要做危险操作” | Policy / Permission / Approval |
| 失败后怎么继续 | 重新把历史塞给模型 | Checkpoint / Resume / Retry |
| 是否真的完成 | 模型最终回答 | Artifact / Test / Outcome Validation |
所以,Agent 的核心变化并不是“Prompt 更复杂”,而是:
把概率性的推理能力,放进确定性的工程边界。
二、五个核心概念:从认知到生产
为了把 Agent 讲清楚,本文只保留五个核心抽象:
Context、Model、Loop、Harness、Runtime。
它们不是某个厂商发布的官方五层标准,而是一种工程分层:每一层负责解决一种不同的问题。
图 2:五个核心概念的关系
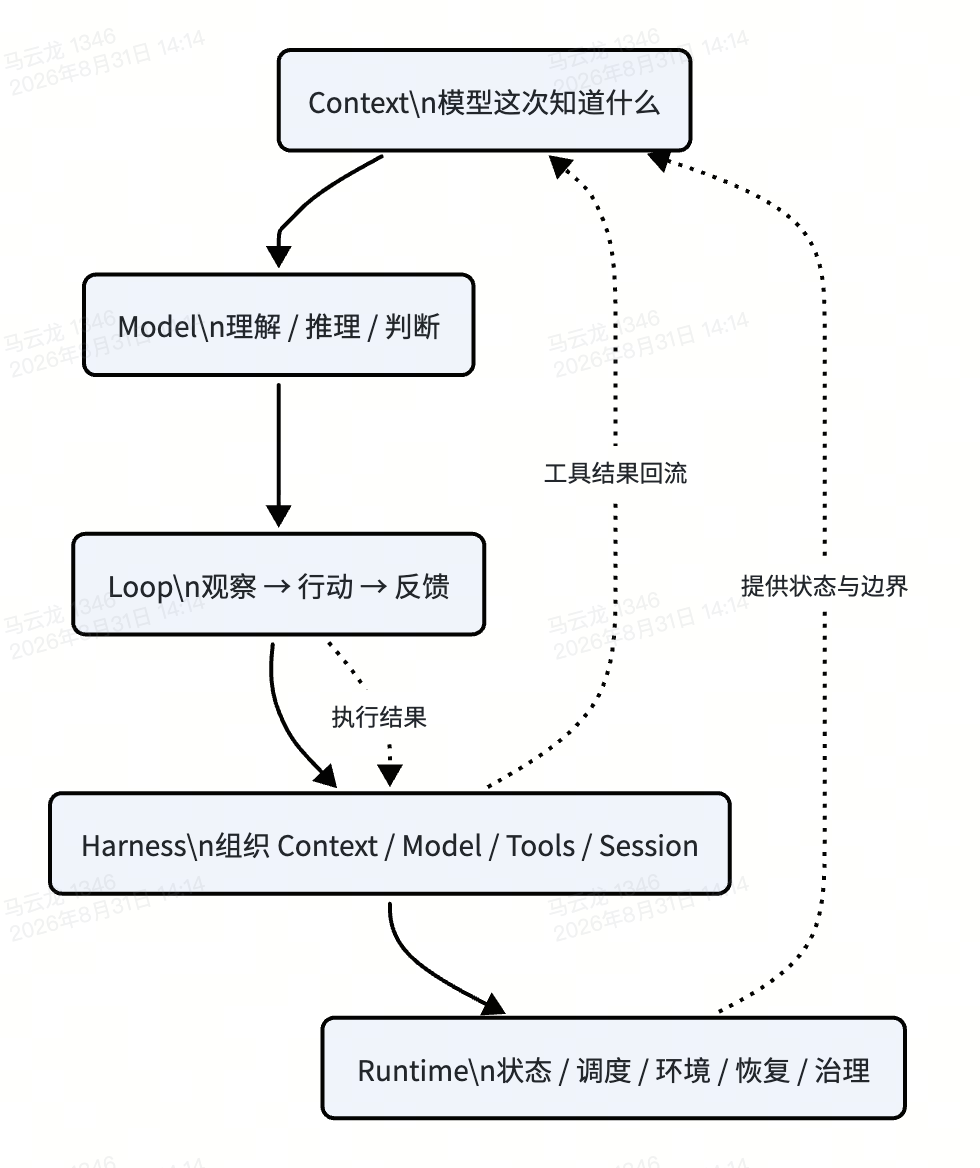
可以这样理解:
| 核心 | 最关键的问题 | 典型错误理解 |
| Context | 模型这次到底看到了什么 | 把所有历史都塞进去 |
| Model | 谁负责非确定性推理 | 把模型本身当成完整 Agent |
| Loop | 如何根据环境反馈持续行动 | 调一次工具就叫 Agent |
| Harness | 一个 Agent Session 怎样真正运行 | 只把它理解成 Model SDK |
| Runtime | 任务怎样长期、可靠、安全地存在 | 只把它理解成 API 封装层 |
这五层不是一条严格的“上级调用下级”的流水线。
真正运行时,信息会不断反向流动:Tool Result 会更新 Context,Loop 会改变当前决策,Harness 会产生 Session Event,Runtime 会保存状态、限制权限、判断是否继续。
因此,更准确的理解是一个持续反馈系统。
三、Context:真正要管理的不是 Token,而是认知边界
Context 经常被误解成“聊天记录”。
但在 Agent 里,Context 更接近:
当前这一轮决策时,模型能够看到的全部有效信息集合。
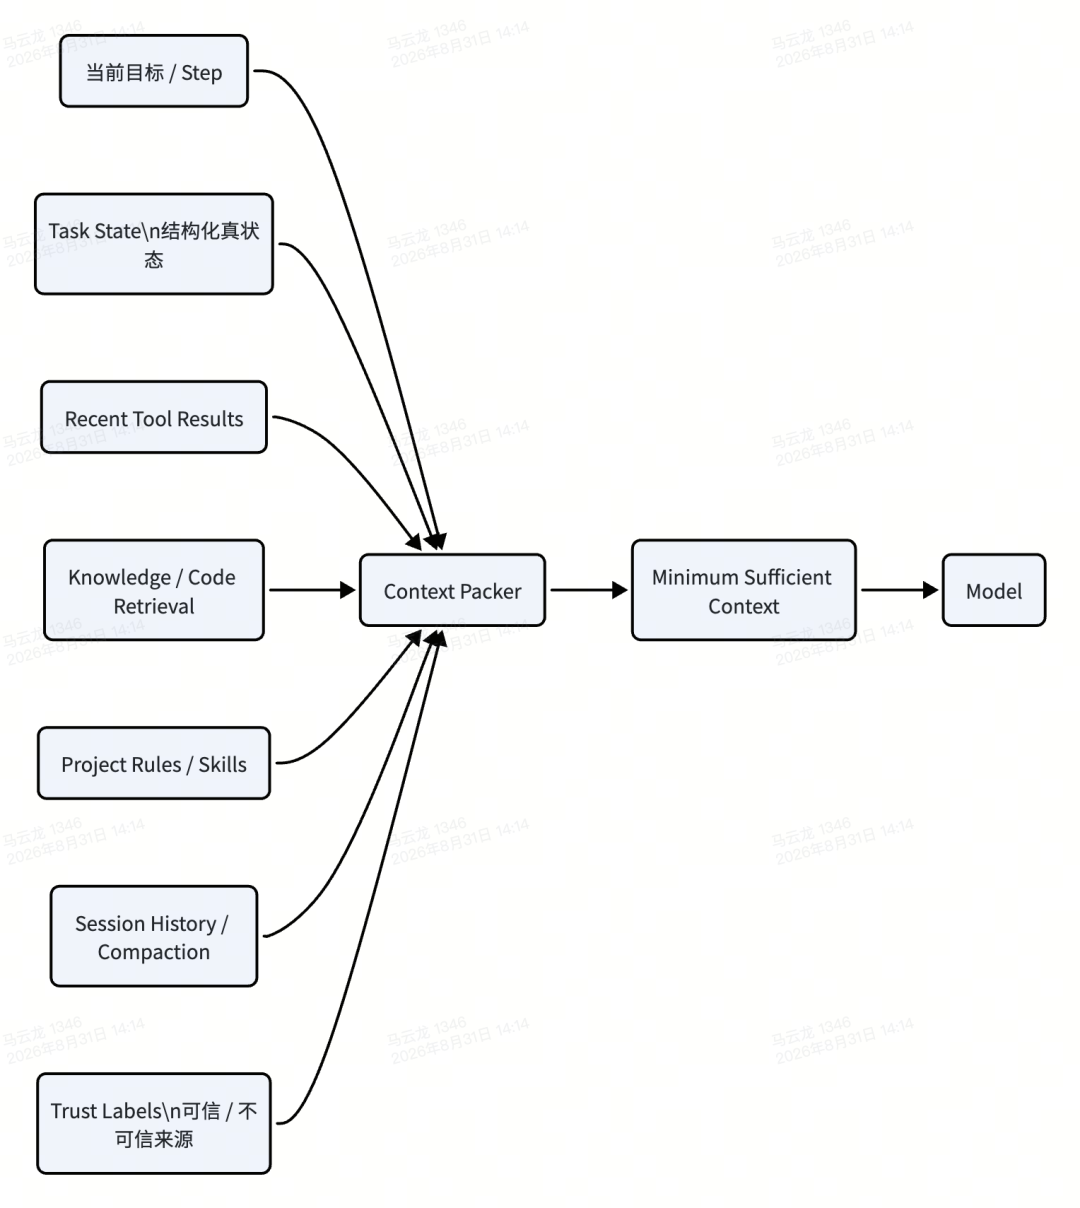
它通常包括:系统指令、用户目标、项目规则、当前任务状态、最近工具结果、工具 Schema、检索到的代码和文档、以及被压缩后的历史。
真正难的不是“怎么把更多内容塞进去”,而是怎么保证模型在这一轮只看到最需要看到的东西。
图 3:Context Packing——把系统状态投影成“最小充分上下文”
1. Context 不是数据库
这是最容易踩坑的地方。
模型上下文中的文字,只是“模型对状态的认知”,不能作为系统状态的唯一事实来源。
例如一个 Coding Agent 已经执行了:
- 创建分支;
- 修改文件;
- 跑了一次测试;
- 产生了一个 Patch;
- 等待某个审批。
真正应该被可靠保存的是:动作有没有提交、Tool Result 是什么、Artifact 在哪里、当前是否等待审批、哪一步可以重试、哪些副作用不可逆。
这些信息应该存在 Runtime 的结构化状态和事件里;进入模型的,只是当前决策需要的那一部分投影。
2. Context 越长,不一定越好
上下文过长通常会同时带来五个问题:
- Token 成本和延迟增加;
- 旧信息干扰当前决策;
- 关键约束被大量日志淹没;
- Tool Result、网页和文档中的 Prompt Injection 被持续带入;
- 模型分不清“历史讨论”和“当前事实”。
因此 Context Engineering 通常做四件事:
选择、检索、压缩、标记信任边界。
这也是为什么 Compaction 不能只是“把聊天总结一下”。好的 Compaction 应明确保留:当前目标、已完成项、未完成项、约束、失败原因、Artifact 和下一步动作。
3. Memory 也不是一个 Vector DB
在工程上,更实用的分层是:
| 层 | 保存什么 | 怎么进入 Context |
| Working Context | 当前目标、最近结果 | 每轮直接加入 |
| Task State | 状态、完成标准、审批、预算 | 按需序列化 |
| Episode / Run History | 完整执行轨迹 | 排障、恢复时读取 |
| Semantic Knowledge | 文档、代码、历史决策 | 检索后裁剪进入 |
| Procedural Knowledge | Skill、工具规则、Policy | 按任务加载 |
向量检索只是 Semantic Knowledge 的一种实现,它不适合承担事务状态、权限规则、外部副作用账本和精确顺序事实。
一个很实用的判断:凡是“必须精确知道现在到底是什么”的信息,都不应该只依赖模型记忆。
四、Model:智能来源,但不要把“判断权”和“提交权”混在一起
Model 是系统中的概率推理组件。
它擅长处理传统程序最难处理的部分:
- 理解模糊需求;
- 阅读非结构化文档和代码;
- 生成计划;
- 判断下一步应该获取什么信息;
- 生成 Tool Call;
- 根据测试失败继续修复;
- 做 Reviewer、Router、Planner、Verifier 等不同角色。
但 Model 本身并不会“真正执行”动作。
即使它返回:
{ "tool": "shell", "arguments": { "command": ["go", "test", "-race", "./internal/runtime/..."] }}
这也只是一个动作请求。
真正执行命令的,是模型之外的 Tool Executor、Sandbox、Harness 或外部系统。
因此,一个非常实用的工程原则是:
模型拥有候选决策权,确定性系统拥有副作用控制权。
也就是说,模型可以提出“删除这个文件”“执行这条 SQL”“部署这个服务”,但是否允许做、用谁的身份做、在哪个环境做、是否需要审批,应该由确定性系统决定。
这会直接带来两个好处。
第一,安全边界不依赖模型“记得遵守 Prompt”。即使模型受到 Prompt Injection,真正的副作用链路仍然可以被 Policy、Sandbox、Credential Boundary 和 Approval 拦住。
第二,模型可以随时替换。Model 可以升级、降级、路由到不同厂商,但 Task State、Workspace、Artifact、权限和验收标准不需要跟着模型重做。
所以评估 Agent 时,也不应该只问“用了什么模型”。真正效果通常来自:
Agent Quality= Model× Context× Tools× Harness× Runtime Environment× Verification
其中任何一项明显短板,都会拖累最终结果。
五、Loop:Agent 真正的核心,是“根据结果继续行动”
Tool Calling 并不是 Agent 最重要的地方。
真正重要的是:模型能否在执行之后读取环境反馈,并改变下一步。
这就是 Agent Loop。
图 4:一个 Coding Agent 的真实闭环
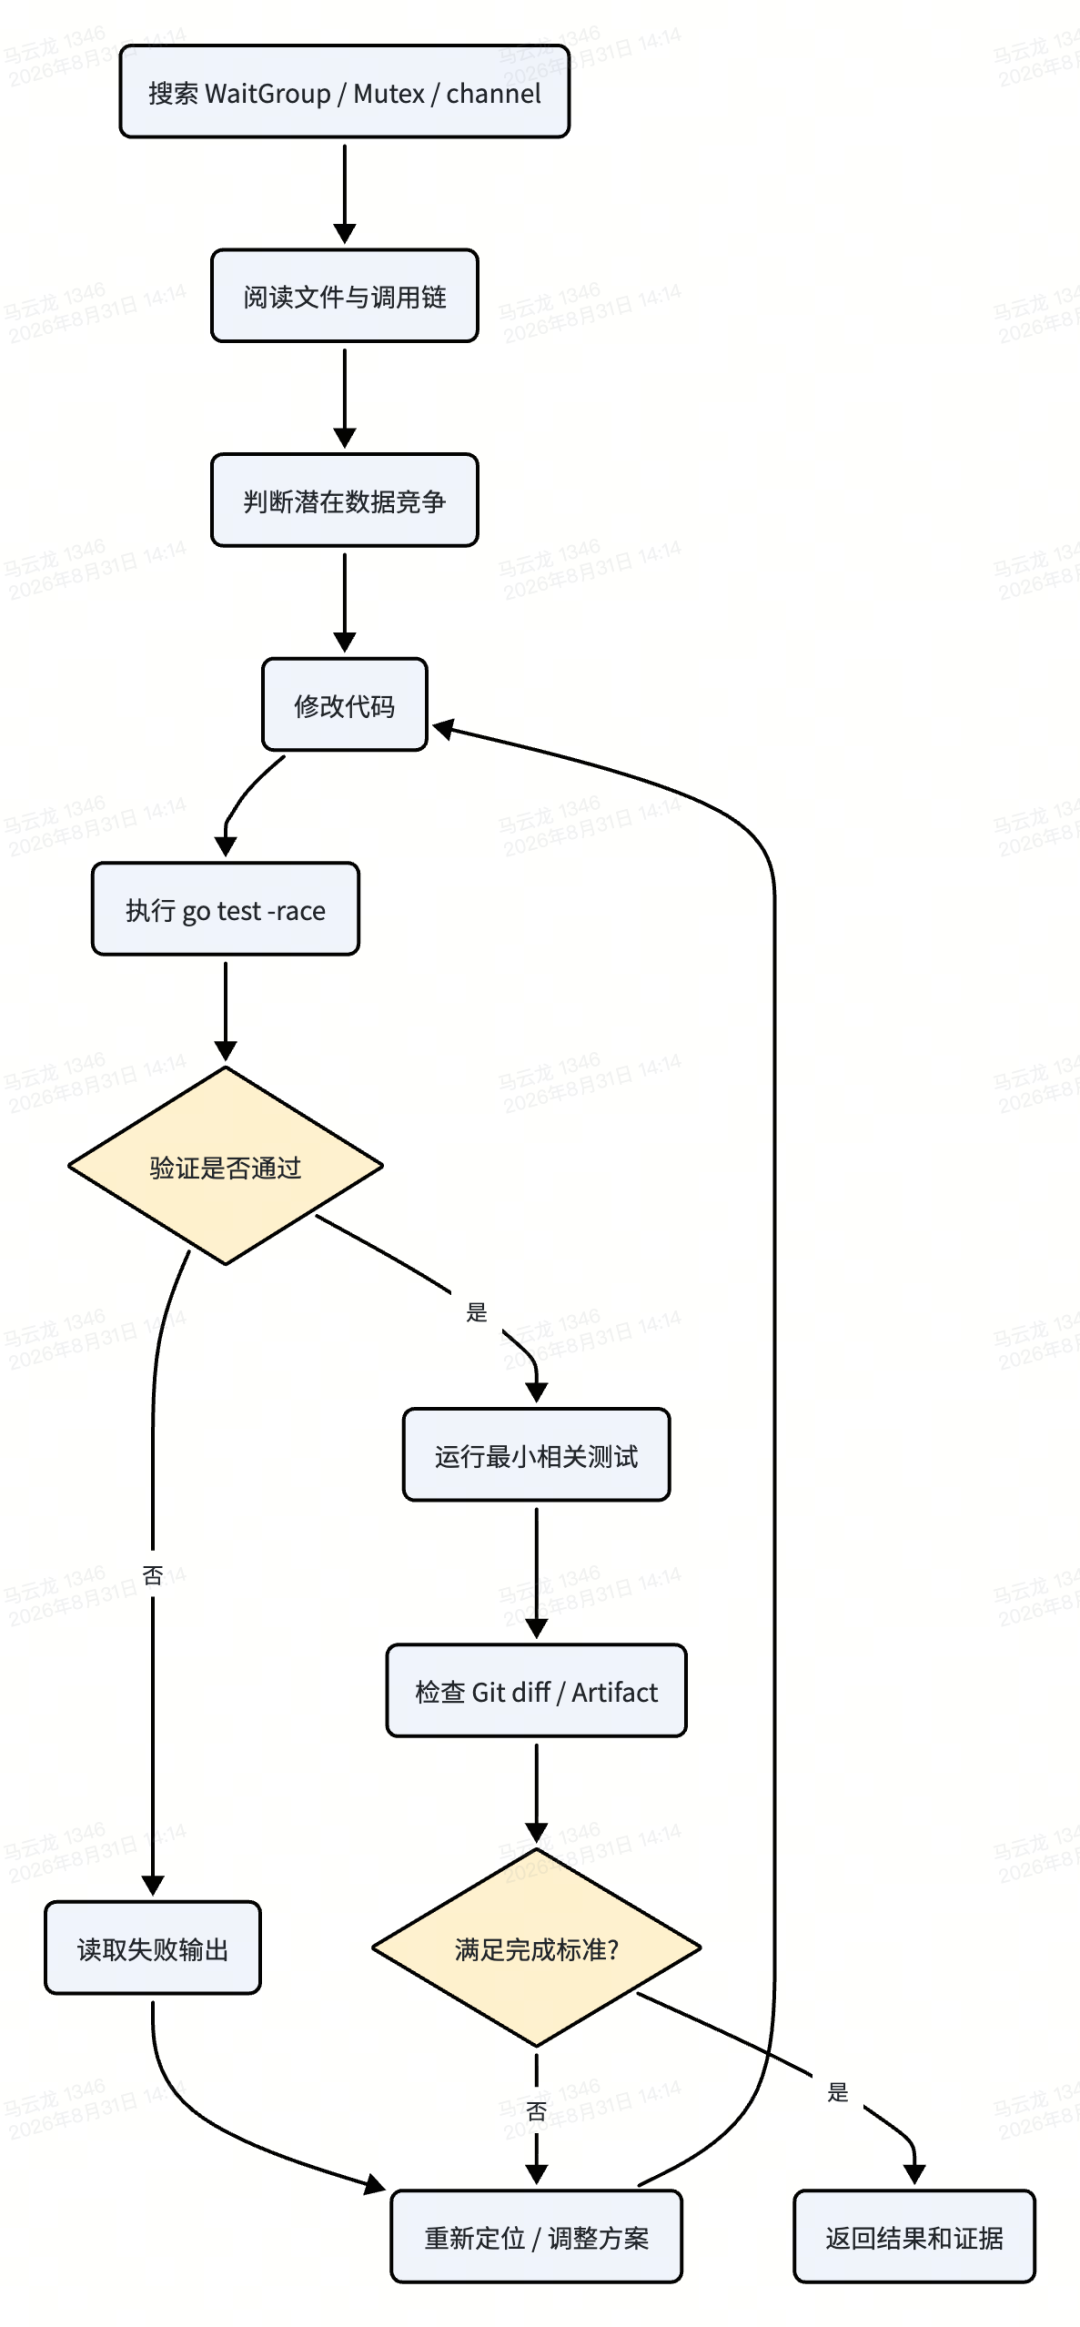
这张图里最值得注意的不是“用了 Shell”,而是两件事:
- 路径不是预先写死的。 测试失败以后,下一步取决于真实反馈。
- Final Answer 不是完成条件。 任务是否结束,要看验证结果和完成标准。
Agent Loop 和 Workflow 的分界
不是所有任务都值得 Agent 化。
固定流程:
拉取数据 → 固定 SQL → 套模板 → 发报表
这类任务用 Workflow、DAG 或脚本更稳定。
真正适合 Agent Loop 的任务,通常至少满足两个条件:
- 路径无法提前完全确定;
- 必须根据环境反馈改变下一步。
例如 Bug 修复、复杂研究、浏览器自动化、CI 自动修复、动态排障,都属于典型场景。
Loop 必须有停止条件
没有停止条件的 Agent,很容易变成“模型一直觉得还能再试一次”。
成熟 Harness 通常会同时考虑:
- 完成标准是否满足;
- 模型是否返回 Final;
- 是否需要用户输入;
- 是否触发审批;
- 是否达到最大轮次;
- 是否超过时间 / Token / 成本预算;
- Tool 是否连续失败;
- Validator 是否要求重新规划。
所以 Agent Loop 并不是简单的 while(true),而是一个受约束的动态控制算法。
六、Harness:为什么 Codex、Claude Code 不是“普通模型 Provider”
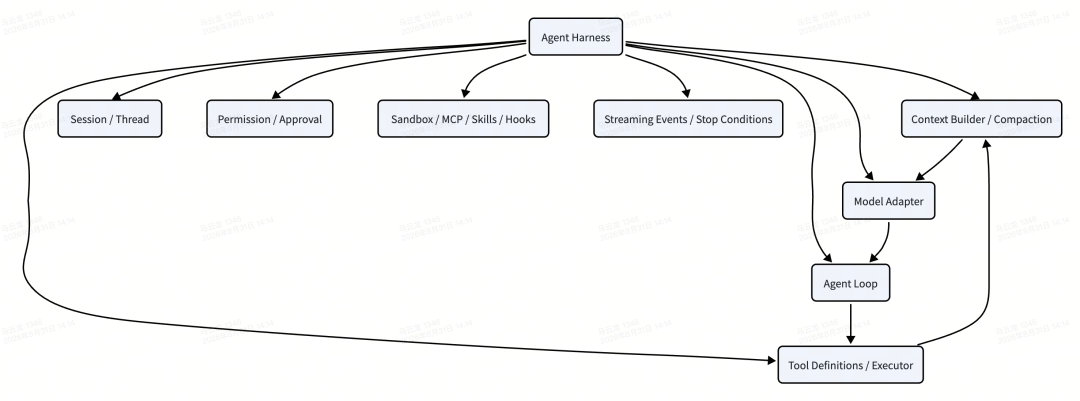
如果说 Model 是“大脑”,Loop 是“行动闭环”,那么 Harness 就是把这些东西真正组织起来的 Agent 执行框架。
它关心的是:
当前这个 Agent Session,怎样获取上下文、调用模型、执行工具、处理反馈、管理会话,并在合适的时候结束。
图 5:Harness 不是一个 API Wrapper,而是一套 Session 执行系统
Tool Calling 为什么还不等于 Agent
一次 Tool Calling 只能说明:模型会生成函数名和参数。
真正的 Harness 还要处理:
- Tool 参数解析失败怎么办;
- 一个响应里有多个工具调用怎么办;
- 工具超时怎么取消;
- Tool Result 如何进入下一轮 Context;
- Session 什么时候压缩;
- 高风险动作如何暂停;
- 执行过程如何流式返回 UI;
- Skill、MCP、Hooks 如何进入生命周期;
- 什么情况下真正停止。
这就是为什么 Codex、Claude Code 不能简单抽象成:
Generate(prompt string) string
这种接口会丢掉最重要的东西:Session、Event Stream、Tool Progress、Approval、Diff、Resume、Cancel、Artifact,以及 Provider 原生错误语义。
更合理的抽象是区分三类 Provider:
OpenAI / Anthropic 原始 API → ModelProviderCodex / Claude Code → AgentProviderScript / DAG / Temporal → WorkflowProvider
这个区别非常实用。
如果已经使用 Codex 或 Claude Code,外层平台通常不应该为了“统一”而重新实现一遍它们已有的 Coding Agent Loop、文件编辑、Shell、Session、Compaction、Skills、MCP 和权限逻辑。
更值得统一的是:Task、Run、Event、Workspace、Artifact、Budget、Approval 和 Validation Contract。
Harness 和 Runtime 的边界不是绝对的
这里容易陷入术语争论。
现实产品中,一个组件可能同时承担 Harness 和部分 Runtime 职责。例如某个 Agent Core 既有 Loop,也保存 Session 状态。
因此与其争论“它到底算 Harness 还是 Runtime”,不如问五个更有价值的问题:
- 谁是状态 Source of Truth?
- 谁负责进程退出后的恢复?
- 谁拥有组织级权限和预算?
- 谁控制真实副作用?
- 谁判断 Task 是否真的完成?
这五个问题比术语本身更能决定架构边界。
七、Runtime:Agent 从 Demo 到生产,真正缺的是什么
Harness 解决的是“一个 Agent Session 怎样工作”。
Runtime 解决的是:
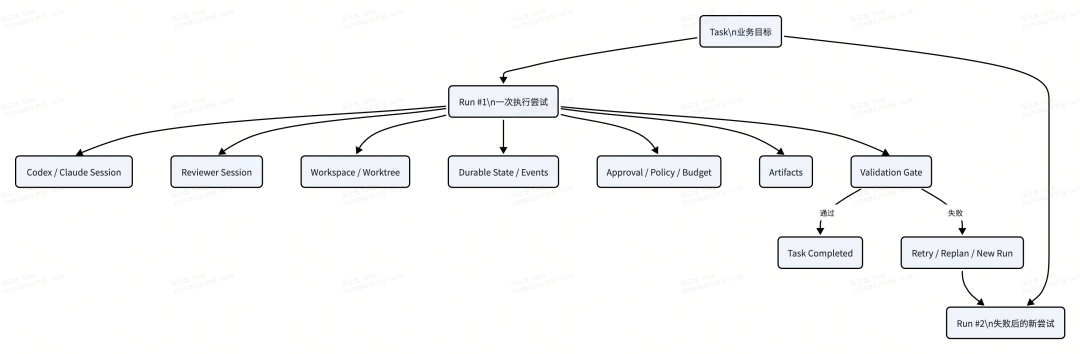
一个 Task 怎样跨 Session、跨进程、跨失败长期存在,并且最终可验证地完成。
这也是整个 Agent 架构里工程味最重的一层。
图 6:Runtime 管的不是“模型调用”,而是任务生命周期
1. Task、Run、Session 必须分开
这是非常关键、但很多系统一开始没有建模清楚的地方。
| 对象 | 含义 | 示例 |
| Task | 用户真正想完成的业务目标 | 修复支付模块并发 Bug |
| Run | 为完成 Task 发起的一次执行尝试 | 第一次用 Codex,失败后换 Claude |
| Session | 某个 AgentProvider 内的一段交互 | Codex Thread / Claude Session |
这会带来两个重要结论:
Session 失败,不等于 Task 失败。
Session 完成,也不等于 Task 真正完成。
例如 Coding Session 已经返回“修复完成”,Runtime 仍然可以启动独立 Reviewer 或 Validator;验证失败以后,可以继续原 Session,也可以新建 Run、换 Provider、换 Workspace。
2. Runtime 才应该保存“真状态”
Runtime 至少应该知道:
- 当前 Task / Run 状态;
- 已执行动作;
- Provider Session ID;
- Workspace 占用情况;
- 待审批动作;
- 已产生 Artifact;
- Token / Cost / Time 使用量;
- 最终验证结果。
状态回答“现在是什么”,事件回答“为什么变成这样”。
这也是为什么生产 Agent 通常不仅要保存 Current State,还需要 Append-only Event Log:它用于审计、回放、恢复和排障。
3. Checkpoint、Resume、Retry、Rollback 不是一回事
这几个词经常被混用,但工程语义差别很大:
| 能力 | 解决什么问题 |
| Checkpoint | 记录执行到哪里 |
| Resume | 从已保存状态继续 |
| Retry | 重新执行失败动作 |
| Idempotency | 重复执行不产生重复副作用 |
| Rollback | 撤销已经提交的变更 |
| Compensation | 用反向动作抵消不可直接回滚的副作用 |
Checkpoint 能告诉你“第 5 步执行过”,但它不能自动撤回一封邮件、退款一笔支付、删除已经创建的云资源。
因此,真正的恢复能力不是一句“支持断点续传”,而是要根据不同副作用设计对应策略:Git 可以用 Worktree / Patch,数据库可以用 Transaction / Outbox,HTTP API 可以用 Idempotency Key,消息和支付往往需要 Compensation。
4. 完成必须有 Validation Gate
Agent 系统最容易自欺的一点,就是把 Final Answer 当成成功。
更可靠的判断链路应该是:
Agent Result→ Artifact Check→ Execution Check→ Environment Readback→ Completion Criteria→ Task Completed
例如:
- “代码修好了” → Diff 是否真的存在?
- “测试通过” → 测试命令是否真的成功?
- “部署完成” → 服务状态是否真的 Ready?
- “订单已创建” → 外部系统是否真的存在对应记录?
所以生产级 Agent 一个非常核心的原则是:
模型负责声明,环境负责证明。
5. 内层 Agent Loop 与外层 Task Loop
最后把 Harness 和 Runtime 放到一起看,就会发现系统里其实有两个不同层级的循环:
内层 Agent Loop:
Model → Tool → Result → Model → Final
负责一个 Session 内怎么完成当前任务。
外层 Task Loop:
Task→ Route Provider→ Create / Resume Session→ Consume Events→ Validate Outcome→ Retry / Review / Approval / Complete
负责整个业务任务是否真正完成。
这也是“外层 Runtime + 内层成熟 Harness”这种架构为什么实用:外层不需要重新发明 Codex 或 Claude Code,但可以统一控制任务、状态、权限、成本、恢复和验收。
结语:真正的 Agent,不是让模型控制一切
回到最开始的问题:
一个只能生成 Token 的模型,为什么最终可以像 Codex、Claude Code 一样读取仓库、修改代码、执行测试,并持续完成一个复杂任务?
答案并不是“因为 Prompt 写得够长”。
而是因为模型外面逐渐形成了一整套工程系统:
- Context 决定模型这一次真正知道什么;
- Model 提供理解、推理和候选决策;
- Loop 让系统能够根据环境反馈持续修正;
- Harness 把 Context、Model、Tools 和 Session 组织成一个可运行 Agent;
- Runtime 让 Task 能够跨失败、跨 Session、跨进程可靠存在,并最终被验证。
真正值得建设的,不是一个“什么都让 LLM 自己决定”的系统。
而是:
让模型在确定性的边界内发挥最擅长的非结构化推理能力,让状态、权限、副作用、恢复和完成验证继续由工程系统负责。
如果只记住一句话,可以记住:
Context 决定它知道什么,Model 决定它怎么想,Loop 决定它怎么继续,Harness 决定它怎么工作,Runtime 决定它能不能真正交付。
普通人如何抓住AI大模型的风口?
领取方式在文末
2026年入行AI大模型的黄金窗口!!!
AI产业正迎来前所未有的爆发式增长。 从DeepSeek以百万年薪重金招募顶尖研究员,到百度、阿里、腾讯等头部企业加速推进AI Agent商业化布局,再到国家层面持续出台政策,大力扶持数字经济与AI人才培育体系,多重信号清晰指向一个共识:AI的“黄金十年”已全面开启
在产业浪潮的强劲推动下,AI人才争夺战日趋白热化。技术迭代与场景落地双轮驱动,催生海量高价值岗位。放眼未来,AI领域的职业发展前景广阔无垠,正涌现出大量高潜机遇,堪称一片值得深耕的**“人才蓝海”**。
脉脉数据显示📊:
2026年1-2月,AI岗位数量同比增长约12倍,增速远超新经济行业整体增幅;AI岗位在全部新经济岗位中的占比也从2025年同期的2.29%跃升至26.23%,几乎占据新经济招聘市场的四分之一。
与此同时,AI新发岗位平均月薪高达60738元,较新经济行业整体平均月薪48189元高出约26%。
这一切都说明一件事:2026年,正是入行AI大模型的黄金窗口❗️❗️
最佳学习路线
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。
希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
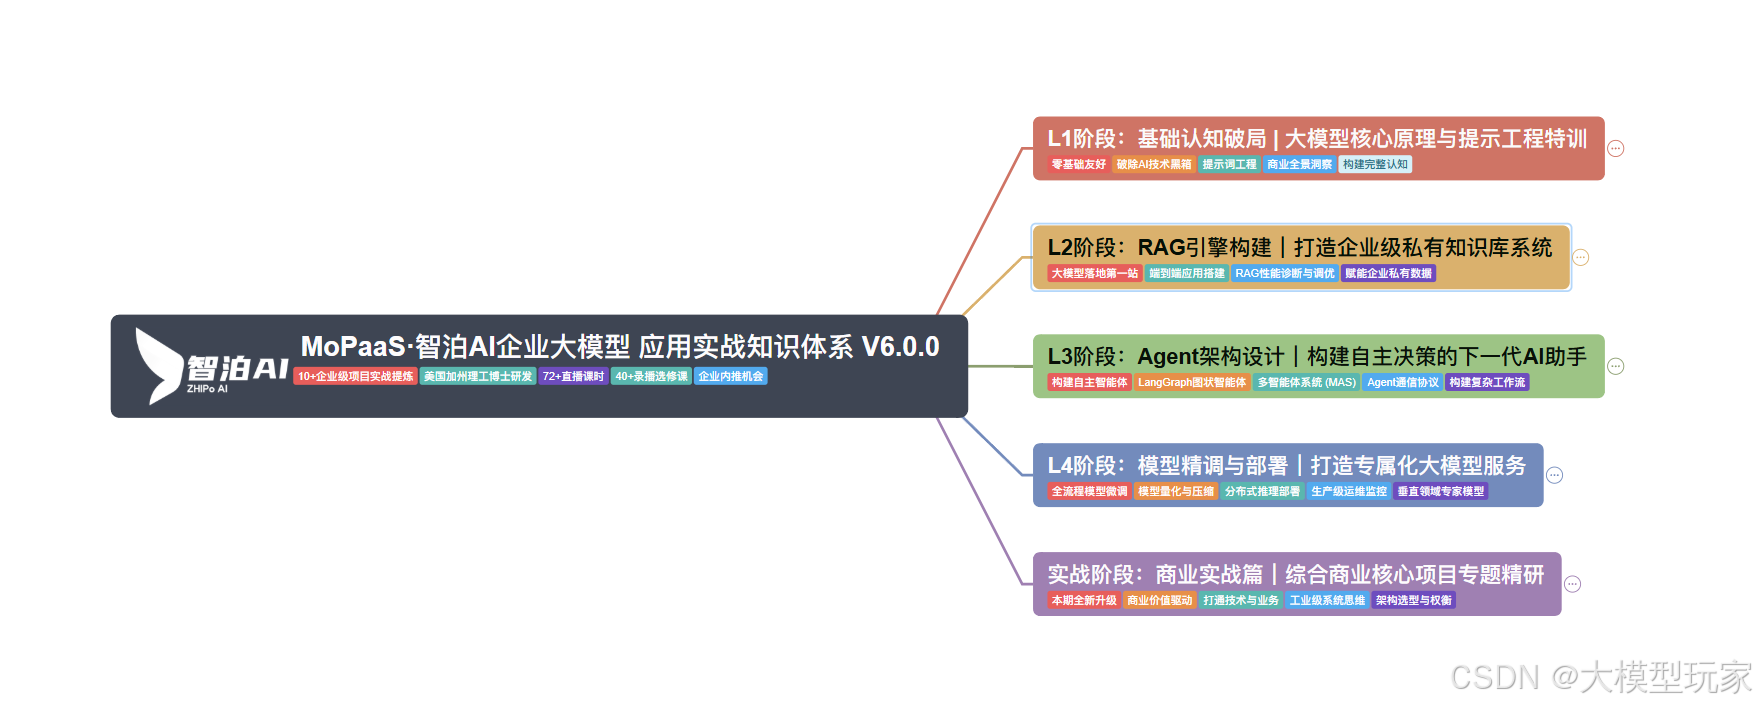
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:
04 视频和书籍PDF合集
从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)
05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】


 扫一扫


 7600

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


