昇腾910B ATLAS 300 A2 计算卡开箱检验与集群通信使能指南

昇腾910B国产化大模型适配指南 华为910B国产化大模型训练环境安装指南,支持Huggingface模型以及DDP分布式训练框架。 阅读详情

简介

昇腾910B通过卡上AICPU内置的NIC与集群中的其他卡进行通信,其中通信协议是,集合通信库( Huawei Collective Communication Library ,简称HCCL)是基于昇腾硬件的高性能集合通信库,提供单机多卡以及多机多卡间的数据并行、模型并行集合通信方案。HCCL支持AllReduce、Broadcast、Allgather、ReduceScatter、AlltoAll等通信原语,Ring、Mesh、HD等通信算法,在HCCS、RoCE和PCIe高速链路实现集合通信。

开箱检验

在获取到910B的裸金属服务器或者容器后,先进行设备检查

设备检验

lspci | grep d802
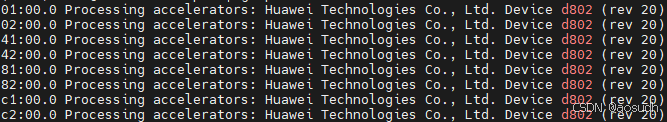
加入能识别到8张加速卡后,进入昇腾官网

社区版资源下载-资源下载中心-昇腾社区

下载安装固件包与驱动包

根据指导手册,首先更新卡的firmware包,然后安装driver包
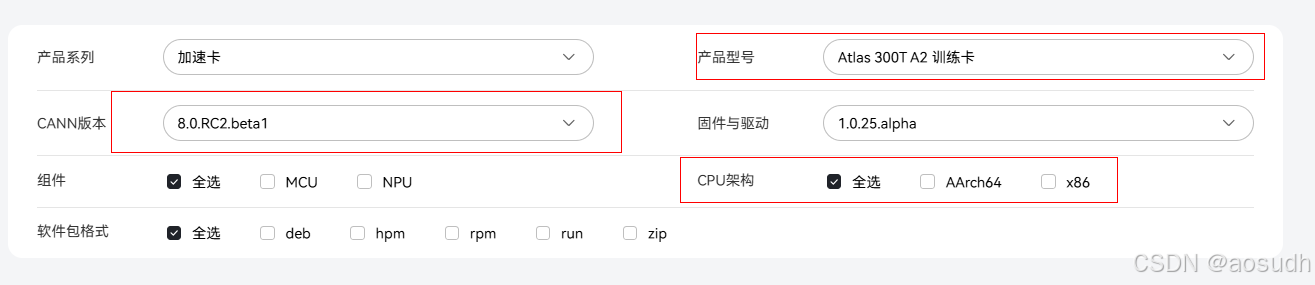
社区版-固件与驱动-昇腾社区

首先确定产品型号不变,ALTAS 300T A2,然后根据需要安装的cann包版本与cpu架构选择固件包与驱动包

  • Ascend-hdk-910b-npu-driver_开头的为系统驱动包
  • Ascend-hdk-910b-npu-firmware_xxx格式的为固件包

先装固件包,后装驱动包

安装cann包与kernal包

安装完成后,再进行cann包与kernal包的安装

社区版资源下载-资源下载中心-昇腾社区

  • Ascend-cann-toolkit_xxx的为cann包
  • Ascend-cann-kernals-910b_xxx的为kernal包

先安装cann包再安装kernal包

安装后检验

装好上述版本后,输入

npu-smi info

即可看到如下显示

那卡基本就可以正常使用了,如果有疑虑可以安装mindx-toolbox,使用其中的ascend-dmi 命令行工具进行卡本身的性能检测

简介-Ascend DMI工具-ToolBox-MindX DL6.0.RC3开发文档-昇腾社区

通信算子测试环境安装

通信环境检测

 查看节点内NPU上的网卡状态UP和DOWN

for i in {0..7};do hccn_tool -i ${i} -link -g;done

查看单节点内NPU网卡IP连通性

for i in $(seq 0 7);do hccn_tool -i $i -net_health -g;done

假设上述命令有报错,说明机器NPU网口未互联,无法进行多机测试

假如物理网口已经链接

可以参考下面文章对NPU IP进行配置

昇腾多卡通信教程【配置网络检测对象IP】 - 技术栈

安装mpich-3.2.1.tar.gz

下载地址

 https://www.mpich.org/static/downloads/3.2.1/mpich-3.2.1.tar.gz

安装mpich

mkdir -p /home/mpich
mv /root/mpich-3.2.1.tar.gz /home/
cd /home/;tar -zxvf mpich-3.2.1.tar.gz
cd /home/mpich-3.2.1
./configure --prefix=/home/mpich --disable-fortran
make && make install

配置环境

export PATH=/home/mpich/bin:$PATH
cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test
export LD_LIBRARY_PATH=/home/mpich/lib/:/usr/local/Ascend/ascend-toolkit/latest/lib64:$LD_LIBRARY_PATH
make MPI_HOME=/home/mpich ASCEND_DIR=/usr/local/Ascend/ascend-toolkit/latest

测试单机通信算子

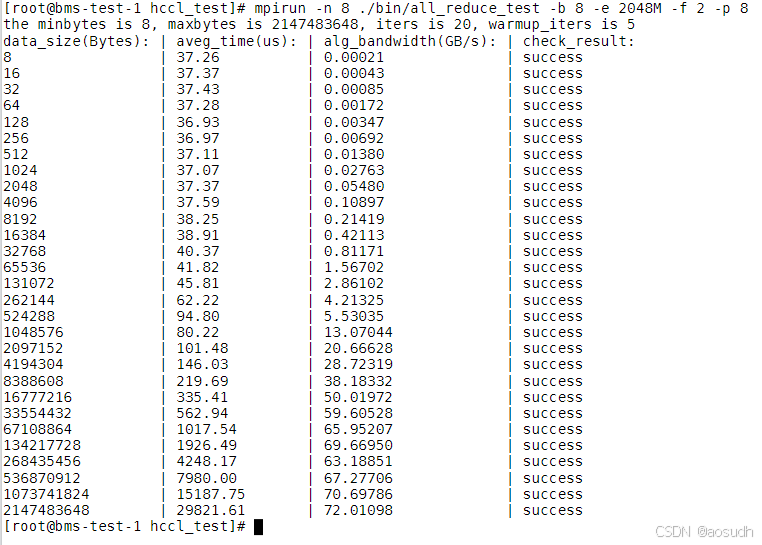
单机all_reduce_test

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

(1) 单机单卡:mpirun -n 1 ./bin/all_reduce_test -b 8 -e 1024M -f 2 -p 8 

(2) 单机多卡:mpirun -n 8 ./bin/all_reduce_test -b 8 -e 2048M -f 2 -p 8
单机reduce_scatter_test 

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

(1) 单机多卡:mpirun -n 8 ./bin/reduce_scatter_test -b 8K -e 2048M -f 2 -d fp32 -o sum -p 8

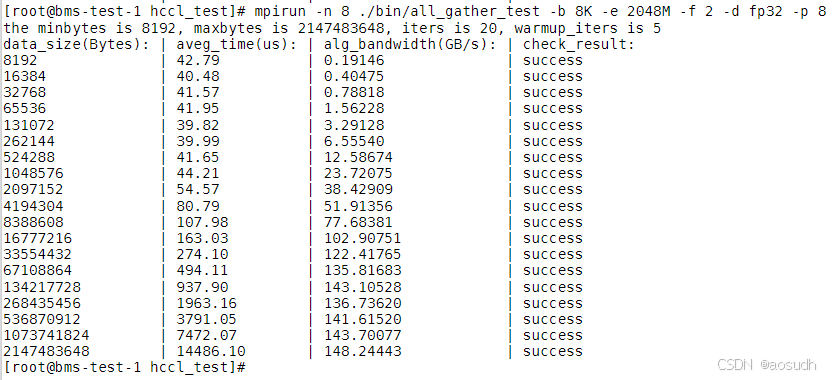
单机all_gather_test 

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

(1) 单机多卡:mpirun -n 8 ./bin/all_gather_test -b 8K -e 2048M -f 2 -d fp32 -p 8
 单机alltoallv_test 

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

(1) 单机多卡:mpirun -n 8 ./bin/alltoallv_test -b 8K -e 2048M -f 2 -d fp32 -p 8

多机通信算子测试

 准备事项

a. 确保主节点已经配置了其他节点机器的免密登录

   配置方法,参考:【昇腾】NPU Snt9B裸金属服务器多机免密互通解决方案

b. 确保mpirun的安装路径都是相同的

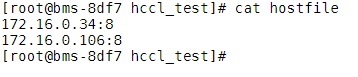
c. 确保设置的hostfile文件位于主节点中,且配置格式如下所示

# 训练节点ip:每节点的进程数
192.168.1.1:8

示例:
5.png

d. 确保所有节点的机器防火强都已关闭

# 查看防火墙状态
systemctl status firewalld
# 关闭防火墙
systemctl stop firewalld

2. 测试通信算子

在 主节点 中执行以下命令

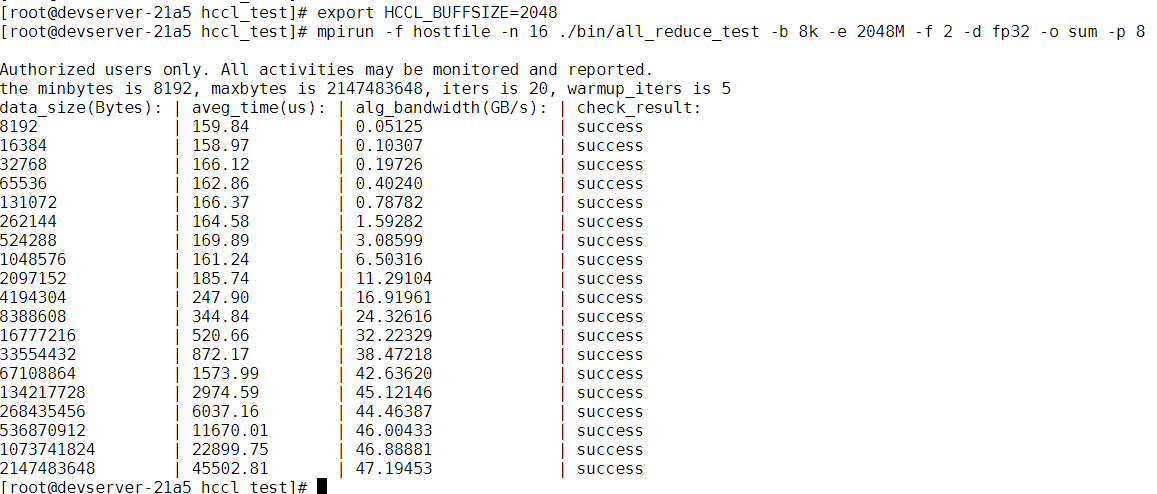
export HCCL_BUFFSIZE=2048

环境变量HCCL_BUFFSIZE用于控制分布式业务场景下用于NPU之间通信的共享数据缓存区大小,单位为MB,默认值是200MB。 HCCL_BUFFSIZE 按照通信域粒度管理,即每个通信域拥有一份独立的数据共享缓冲区,保证通信域之间并发通信操作时的资源隔离。参考资料:

2.1 多机all_reduce_test

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

(1) 多机多卡:mpirun -f hostfile -n 16 ./bin/all_reduce_test -b 8k -e 2048M -f 2 -d fp32 -o sum -p 8
2.2 多机reduce_scatter_test

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

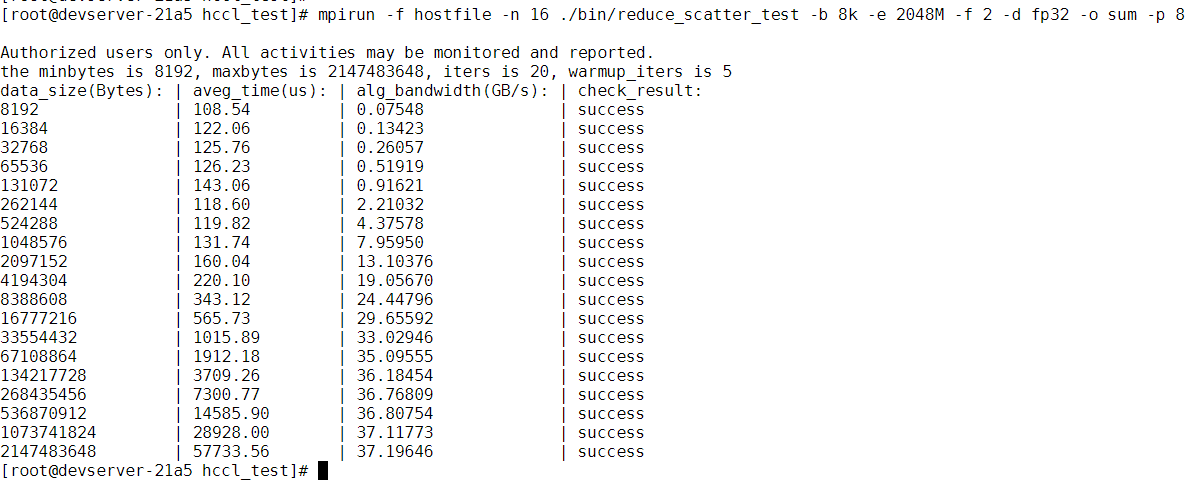
(1) 多机多卡:mpirun -f hostfile -n 16 ./bin/reduce_scatter_test -b 8k -e 2048M -f 2 -d fp32 -o sum -p 8
2.3 多机all_gather_test

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

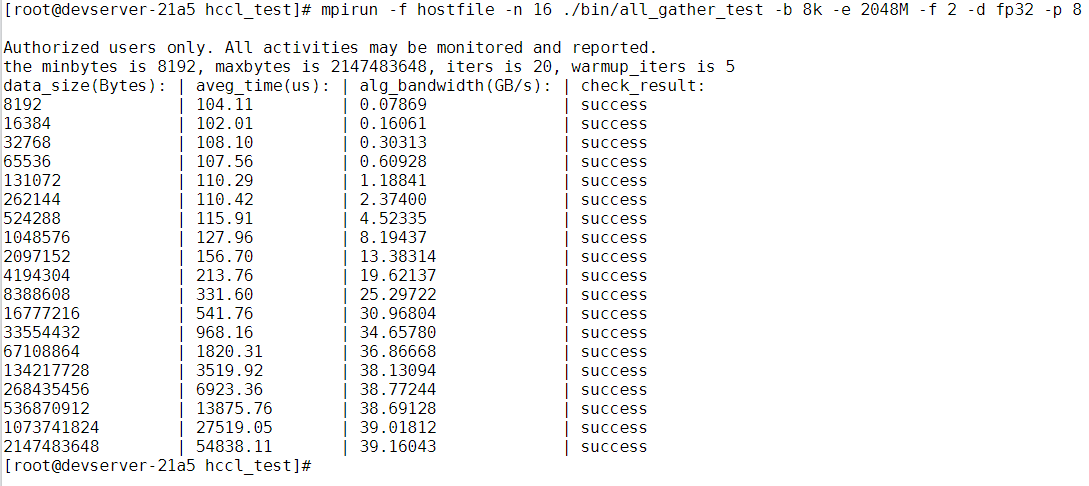
(1) 多机多卡:mpirun -f hostfile -n 16 ./bin/all_gather_test -b 8k -e 2048M -f 2 -d fp32 -p 8
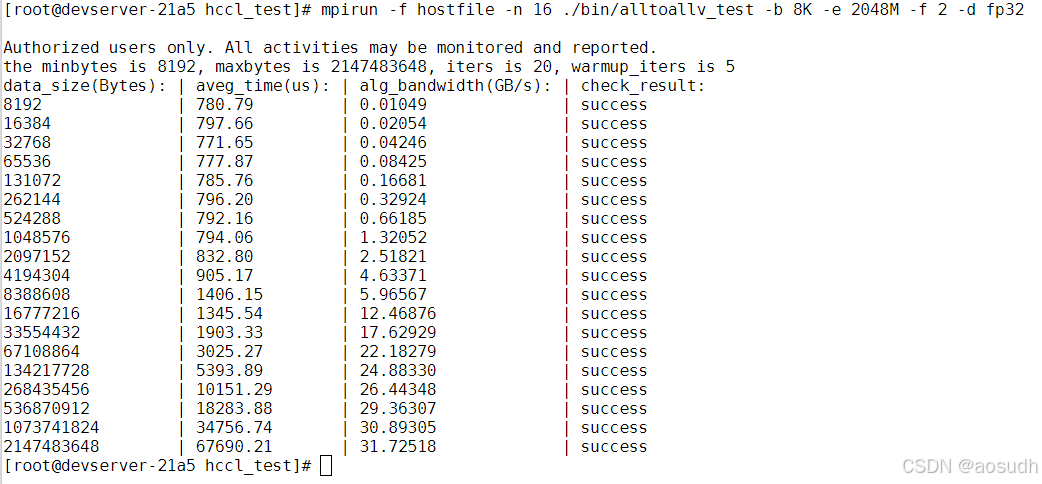
2.4 多机alltoallv_test

cd /usr/local/Ascend/ascend-toolkit/latest/tools/hccl_test

(1) 多机多卡:mpirun -f hostfile -n 16 ./bin/alltoallv_test -b 8K -e 2048M -f 2 -d fp32
华为昇腾910B编程实战:大模型推理性能优化全攻略 阅读详情

相关推荐

昇腾910B AI芯片深度解析:达芬奇架构、全场景算力与实战指南

AI算力作为支撑大模型训练与推理的核心基础设施,其底层硬件架构与软件生态的协同优化至关重要。达芬奇架构通过专为张量运算设计的3D Cube单元、向量单元与标量单元的异构组合,实现了极高的计算效率与能效比,这是现代AI处理器的典型设计思路。这种软硬件协同优化的价值在于,它能显著降低大规模AI计算的单位成本与能耗,为智慧城市、工业质检、科研计算等对算力密度和实时性要求高的场景提供可靠支撑。昇腾910B正是基于这一理念构建的AI处理器,它不仅是单颗高性能芯片,更通过CANN异构计算架构与MindSpore框架,形

ctk87443的博客 431

GPU 进阶笔记(二):华910B GPU

!

hao_wujing的专栏 6万+

昇腾Atlas服务器选型全解析:从训练卡到集群的硬件搭配与内核版本匹配

本文全面解析了昇腾Atlas服务器的硬件选型与内核版本匹配策略,涵盖从单卡训练到大规模集群部署的解决方案。通过详细的产品对比和性能分析,帮助用户根据业务需求选择最优配置,特别强调了昇腾内核版本与硬件型号的严格对应关系,确保系统稳定性和性能表现。

bean的博客 366

“华为Ascend 910B AI芯片挑战NVIDIA A100:效能比肩,市场角逐加剧“

如此高性能低功耗的表现,吸引了包括腾讯、百度在内的多家中国领先企业采用,用于会议任务,显示出市场对华为AI芯片的广泛接纳,同时对NVIDIA的AI芯片市场份额构成实质性的冲击。华为自主研发的人工智能芯片——Ascend 910B,近期在世界半导体大会及南京国际半导体博览会上由华为ICT基础设施管理委员会执行董事、主任王涛发表声明称,该芯片在训练大规模语言模型时的效率高达80%,与NVIDIA的A100相比毫不逊色,且在具体测试性能上更是超出NVIDIA A100 AI GPU约20%之多。

存储随笔 1万+

华为昇腾Ascend系列 之 01 什么是昇腾芯片?AIGC浪潮已至,进一步推动对芯片和算力的需求,主流 GPGPU/ASIC 产品性能对比(Ascend 910、Ascend 910B)

昇腾 310 和 910 处理器为华为AI 算力领域核心产品,910 单卡 Int8 算力大致可达 0.6 P,最大功耗为 300W,已可对标国际主流 GPU。且昇腾计算产业在硬件方面坚持“硬件开放”策略,通过自有硬件和合作硬件相结合的方式,可为客户提供多样化的算力选择。

iCloudEnd的博客 7489

基于华为昇腾910B和LLaMA Factory多卡微调的实战教程

本文主要介绍了基于华为昇腾910B和LLaMA Factory多卡微调的实战教程,希望对使用大语言模型的同学们有所帮助。 文章目录 1. 前言 2. 配置环境 2.1 安装虚拟环境 2.2 安装依赖库 2.3 模型选型与下载 2.4 配置多卡环境 3. 运行代码 3.1 构建训练数据 3.2 修改配置文件 3.3 继续预训练(CPT) 3.4 SFT

herosunly的博客 17万+

Atlas 300V 24G部署YOLO全攻略:从环境配置到性能调优

在AI推理加速领域,专用硬件与通用GPU的界限日益清晰。昇腾Atlas系列作为国产AI计算平台,其推理加速卡在CV场景中表现突出。Atlas 300V 24G基于达芬奇架构,通过矩阵、向量、标量三类计算单元协同,高效运行YOLO等主流检测模型。其核心价值在于低功耗、高吞吐的推理能力,适合x86服务器改造、边缘视频分析等场景。本文从硬件定位、环境配置、模型转换到推理代码编写,系统梳理了在Atlas 300V 24G上部署YOLO的完整流程,并分享性能实测与常见坑点,为工程实践提供可复用的参考。

weixin_28733637的博客 298

快手did did_gt edid的注册过程

接口 https://gdfp.ksapisrv.com/rest/infra/gdfp/report/kuaishou/android did 是本地生成的16进制 或者 获取的 android_id did_gt 是did生成时间戳 1595073601970 public static final Random f16237a = new Random(System.currentTimeMillis()); public static long m19668a() {  &n

HURUWO的技术博客 1万+

Atlas 300V 24G部署YOLO全流程:推理卡选型、模型转换与性能调优

在AI推理场景中,专用加速卡正成为替代通用GPU的高性价比选择。与NVIDIA显卡不同,华为昇腾Atlas系列推理卡采用NPU架构,通过CANN工具链完成模型转换与部署,其中Atlas 300V 24G凭借大显存、低功耗和优秀的INT8算力,在目标检测任务中表现突出。其核心工作流程涉及将PyTorch模型导出为ONNX,再借助ATC工具编译成适配昇腾芯片的OM模型,同时通过AIPP硬件预处理和静态batch策略显著提升吞吐量。无论是视频流分析、OCR还是人脸识别,Atlas 300V都能在有限功耗下稳定承载

weixin_42628941的博客 253

STRING数据库的蛋白质相互作用(PPI)网络分析

在转录调控相关的文献中,我们经常能够看到这样的蛋白质相互作用网络(protein protein interaction network,PPI network)。具体而言,这些相关的文献中首先通过RNA-seq、表达谱芯片或者蛋白质组分析等,找到了在不同分组样本间一系列的差异表达基因或蛋白。

weixin_43029125的博客 9447

二维码扫描与页面跳转的完整流程解析

本文详细解析了二维码扫描与页面跳转的完整流程,从核心原理到前后端实现,涵盖了二维码生成、扫码事件处理、后端验证机制及跳转逻辑等关键环节。特别介绍了如何使用qrcode.js生成二维码、WebSocket处理扫码状态以及JWT令牌验证设计,帮助开发者构建安全高效的扫码跳转系统。

cicd6pipeline的博客 1083

国内外 AI 芯片概述

AI芯片也被称为AI加速器或计算卡,从广义上讲只要能够运行人工智能算法的芯片都叫作 AI 芯片。但是通常意义上的 AI 芯片指的是针对人工智能算法做了特殊加速设计的芯片。本文简要介绍了AI芯片的种类以及一些国内外AI芯片厂商发布的AI芯片。

顺其自然~专栏 2万+

零基础吃透!Python爬虫实战:超详细爬取小红书图文,解析封面+标题+文案全流程

本文为零基础开发者提供小红书图文爬取全流程指南,针对动态加载、严格反爬等核心痛点,从环境配置到数据解析详细讲解。主要内容包括: 核心特性分析:动态加载机制需抓包获取真实接口,严格反爬依赖Cookie验证和请求头伪装 环境准备:Python 3.8-3.10环境,使用requests/beautifulsoup4等库,通过浏览器开发者工具获取有效Cookie 实战步骤: 定位关键API接口(note/list) 配置请求头(含Cookie/User-Agent/Referer) 实现分页爬取和异常处理 解析封

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 716

AI芯片:华为Ascend(昇腾)910结构分析

前几天,华为发布了最新的AI芯片,号称目前全球最强,算力吊打谷歌TPU3和英伟达Tesla V100。 这么震撼人心,必须挺一波!! 华为牛逼!! (这句5毛) 下面来具体分析一下。 一、昇腾910的整体结构 我去华为官网查了一下,然后就得到这么一点信息: (之后截图补上,这是地址:https://e.huawei.com/cn/products/cloud-computing-dc/atlas/...

evolone的专栏 4万+

ZeroClaw安装、使用方法详细全解

ZeroClaw 是一个用 Rust 编写的轻量级、高性能、完全自主的 AI 助手运行时框架

洛星核的博客 613

Python时间序列:PaddleTS-时间序列分类

评估的指标采用F1,Precision,Recall,PaddleTS已经基于TSDataset实现了这三个指标的计算,直接调用即可。使用内置的API:get_dataset加载BasicMotions数据集。模型训练完成之后,可以对测试集进行预测并评估。模型保存之后,可以加载模型用于新的数据预测。可以将训练完成的模型保存到指定路径。概率预测 可以返回每个分类的概率。安装paddlets。

斌擎科技 1288

昇腾910b部署Chatglm3-6b进行流式输出【pytorch框架】NPU推理

解决chatglm输出乱码,No such file or directory: "*.safetensors"

懒惰是科技进步的原始动力 7458

【图像拼接】论文精读:As-Rigid-As-Possible Shape Manipulation(ARAP)

文章目录前言1.摘要2.算法的总体流程总结 前言 图像变形算法 1.摘要 论文提出了一个二维图形互动系统。图形是建立在三角形网格上的,用户只需移动几个网格顶点(限制顶点),系统通过最小化每个三角形的误差计算网格剩余顶点(自由顶点)的位置。 算法分两步: 适当旋转每个三角形。 调整大小。 关键是使用二次度量误差将最小化问题转换成线性方程组,然后再解这个方程组。 刚性形状变形是很难的,论文的研究使其变得简单。 2.算法的总体流程 总的流程分三步: 将图形用三角形网格覆盖 选择三个点(限制顶点) 操纵限

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 15万+

思腾云计算

昇腾910,高性能训练 AI 处理器,半精度(FP16) 算力达到 320 TFLOPS,整数精度(INT8)算力达到 640 TOPS,功耗 310W,采用 7nm 先进工艺。● 算法工程师:通过AI框架开发网络模型,调试训练代码,导入训练数据集,启动训练,观测训练过程(包含多次迭代的loss趋势),导出训练好的模型。● 系统管理员:操作界面是iBMC系统,通过带外的方式实现设备管理,包含OS安装,固件升级,服务器系统信息查询,故障处理。AI算力、通用算力、I/O能力三合一。原创 Sitonholy。

STGPU的博客 2614

如何使用Agent框架来模拟群体智能?

Agent 框架作为人工智能领域的重要工具,可以模拟复杂的群体智能行为,广泛应用于社会科学、经济学和行为学等领域。

328

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

昇腾910B部署满血DeepSeek-R1(可推理版)

记录本周大模型的部署情况,使用昇腾910B物理机部署DeepSeek-R1满血大模型,可显示推理过程。

qq_73797346的博客 7014

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Ascend 910B 服务器深度解析:国产 AI 大模型训练的最强底座

Ascend910B深度解析:国产AI大模型训练的最强底座 Ascend910B是华为推出的第二代旗舰AI训练芯片,采用自研DaVinci架构和HCCS高速互联技术,算力对标NVIDIA A100,FP16/BF16算力超2000TFLOPS,支持32GB HBM内存。其软件生态成熟,兼容CANN、MindSpore及PyTorch/TensorFlow插件,已支持LLaMA、Qwen等主流大模型训练。典型配置包括Atlas800服务器(8卡)和Atlas900超算集群,适用于7B-100B参数模型训练及高

gs80140的专栏 5422

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

昇腾系列芯片命名

Ascend310(基本淘汰)

顺其自然~专栏 1万+

昇腾910上分布式加载模型与增量训练

问题描述:【功能模块】mindspore.train.serialization.load_distributed_checkpoint【操作步骤&问题现象】1、在Modelarts 16个节点128张昇腾910上从头训练130亿模型,模型代码修改自:https://gitee.com/mindspore/mindspore/tree/r1.3/model_zoo/official/nlp/pangu_alpha2、使用相同计算资源,和 load_distributed_checkpoint API 加载第

Kenji_Shinji的博客 1629

华为昇腾910B性能及应用场景

华为昇腾910B性能及应用场景

2402_84466582的博客 1万+

在华为昇腾 910B 上进行阿里大模型 Qwen2.5 推理

异构 GPU 支持:支持异构 GPU 资源,当前支持 Nvidia、Apple Metal、华为昇腾和摩尔线程等各种类型的 GPU/NPU多推理后端支持:支持vLLM和推理后端,兼顾生产性能需求与多平台兼容性需求多平台支持:支持 Linux、Windows 和 macOS 平台,覆盖 amd64 和 arm64 架构多模型类型支持:支持 LLM 文本模型、VLM 多模态模型、Embedding 文本嵌入模型 和 Reranker 重排序模型等各种类型的模型多模型仓库支持。

2301_78285120的博客 8416
上一篇: 高通QCM6490开发板与aidlux系统使用
下一篇: 昇腾 Profiling 性能调优工具 Ascend PyTorch Adaptor 使用
aosudh
博客等级 码龄6年 4937粉丝 25原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

aosudh

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


