


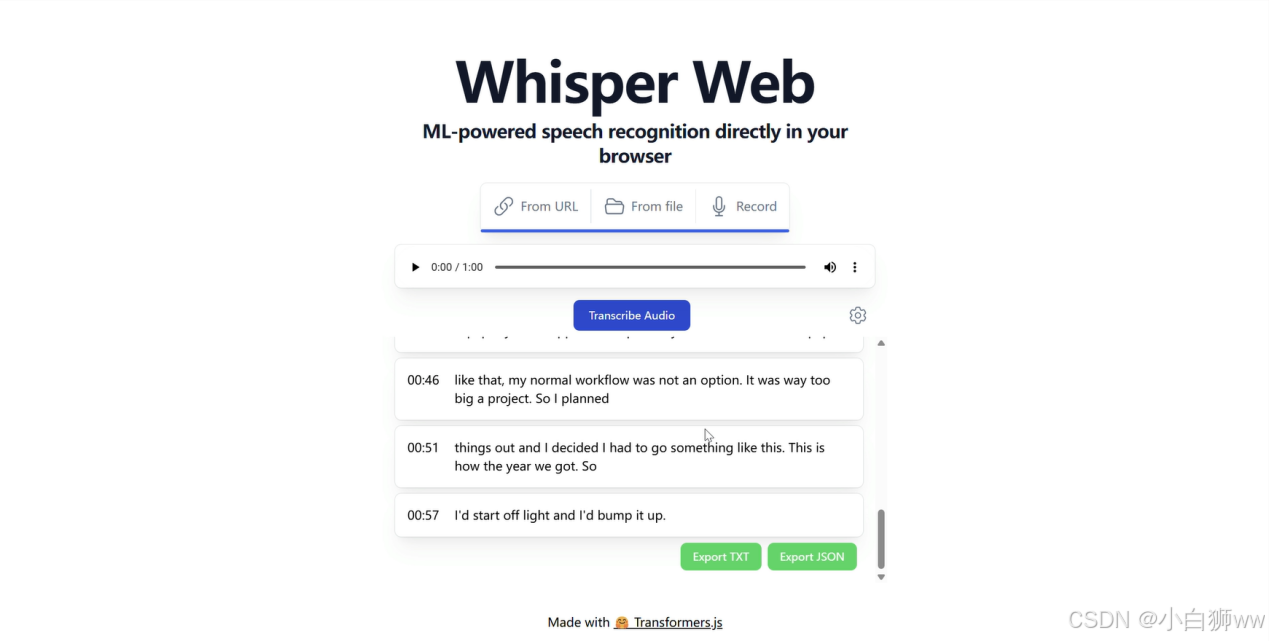
Whisper 是 OpenAI 于 2023 年开源的语音转文本模型,其生成效果广受好评,Whisper 基于 ML 进行语音识别,并可通过 WebGPU 进行运行加速。支持 100 多种语言的线上/本地音频文件上传和即时录音,识别到的文本支持导出 TXT 和 JSON 两种文件格式,还可以直接翻译为英文。
使用云平台:OpenBayes
注册 - OpenBayes http://openbayes.com/console/signup?r=sony_0m6v
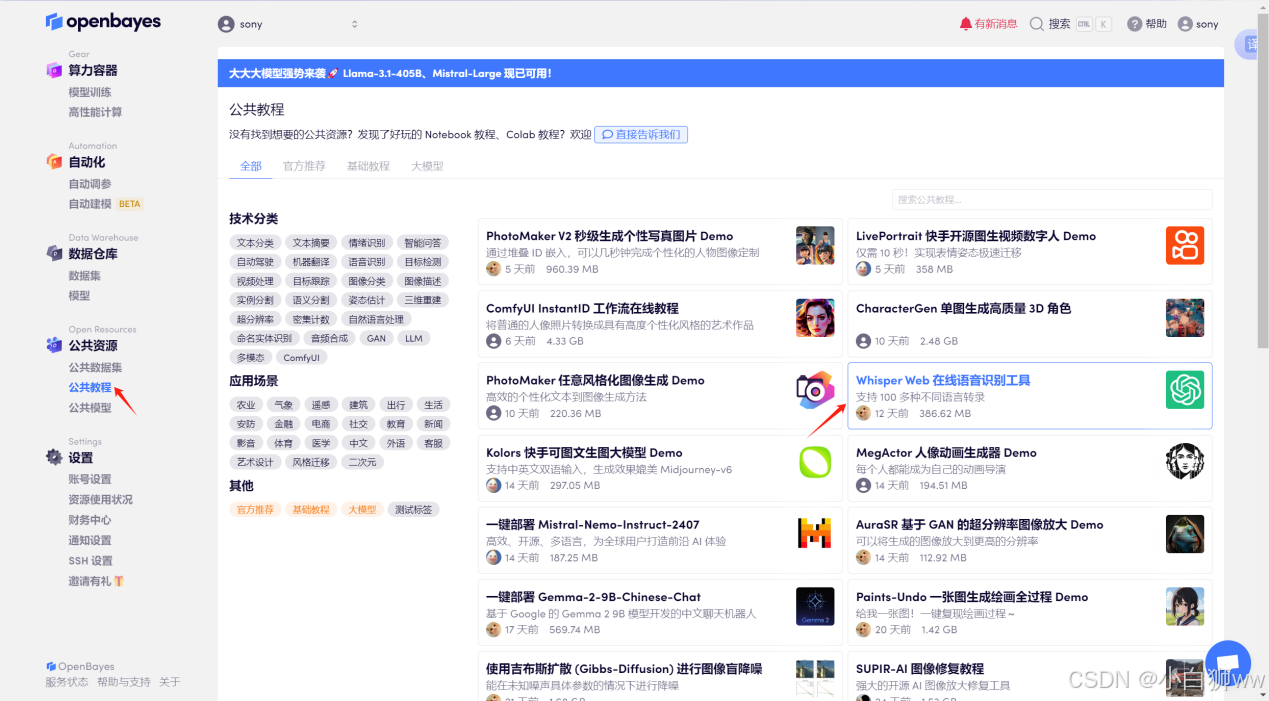
登录到 OpenBayes 平台后,打开「公共教程」,找到「Whisper Web 在线语音识别工具」的教程。
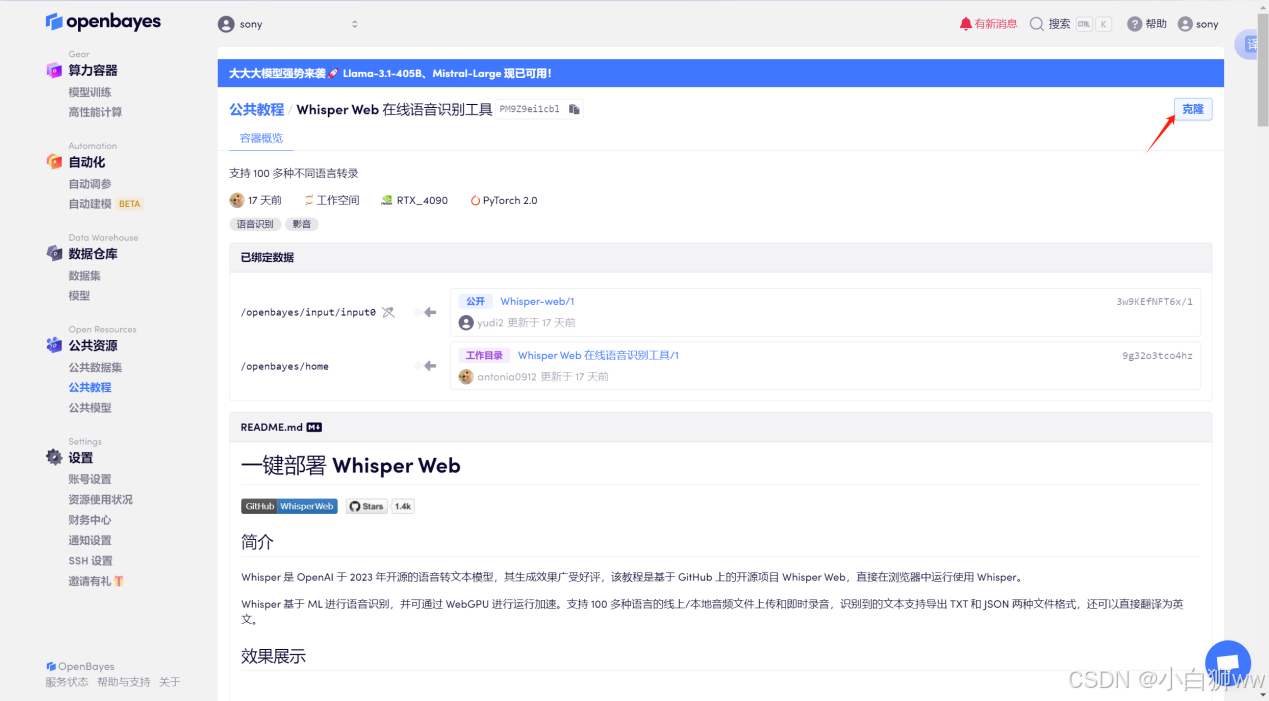
进入教程后,点击右上角「克隆」。
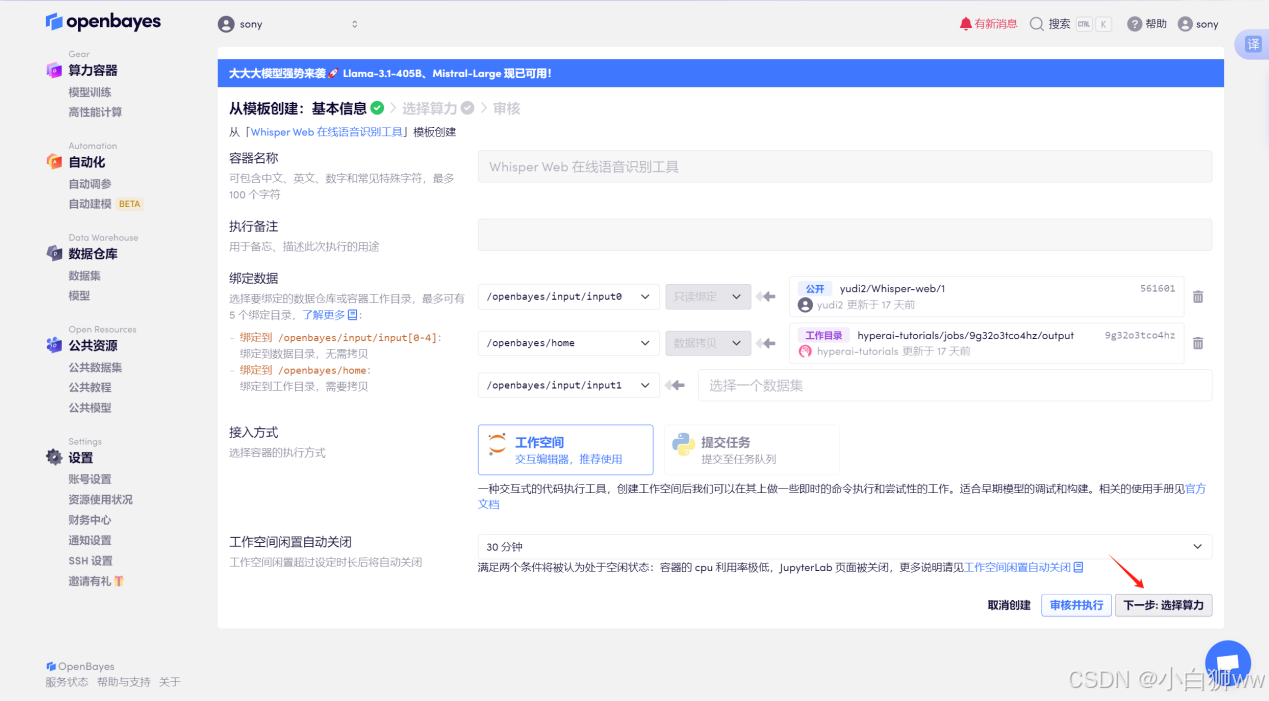
平台在克隆过程中会自动为容器绑定所需要的数据,不需要我们再手动配置,直接点击「下一步:选择算力」。
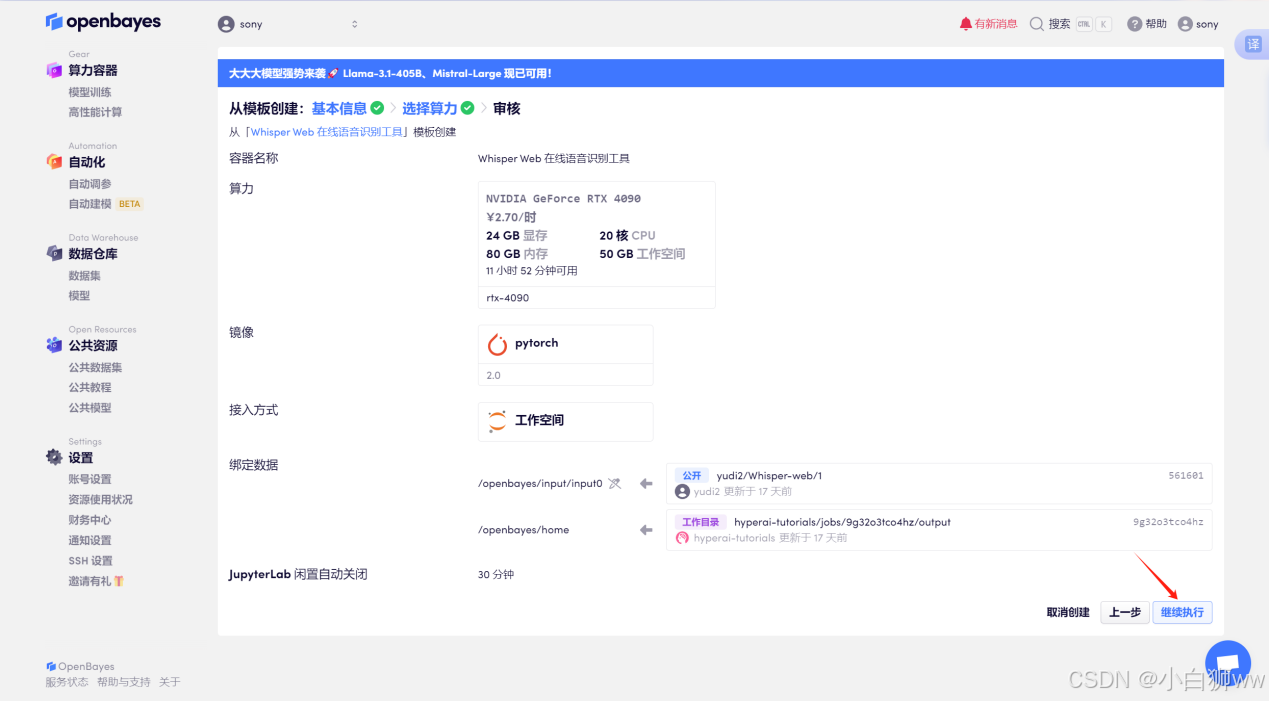
平台会自动为容器选配合适的算力资源和镜像版本,这里使用的是英伟达 RTX 4090 的算力资源和 PyTorch 的镜像,别忘了使用文章开头的邀请链接,get 免费时长!选择好后,点击「下一步:审核」即可。
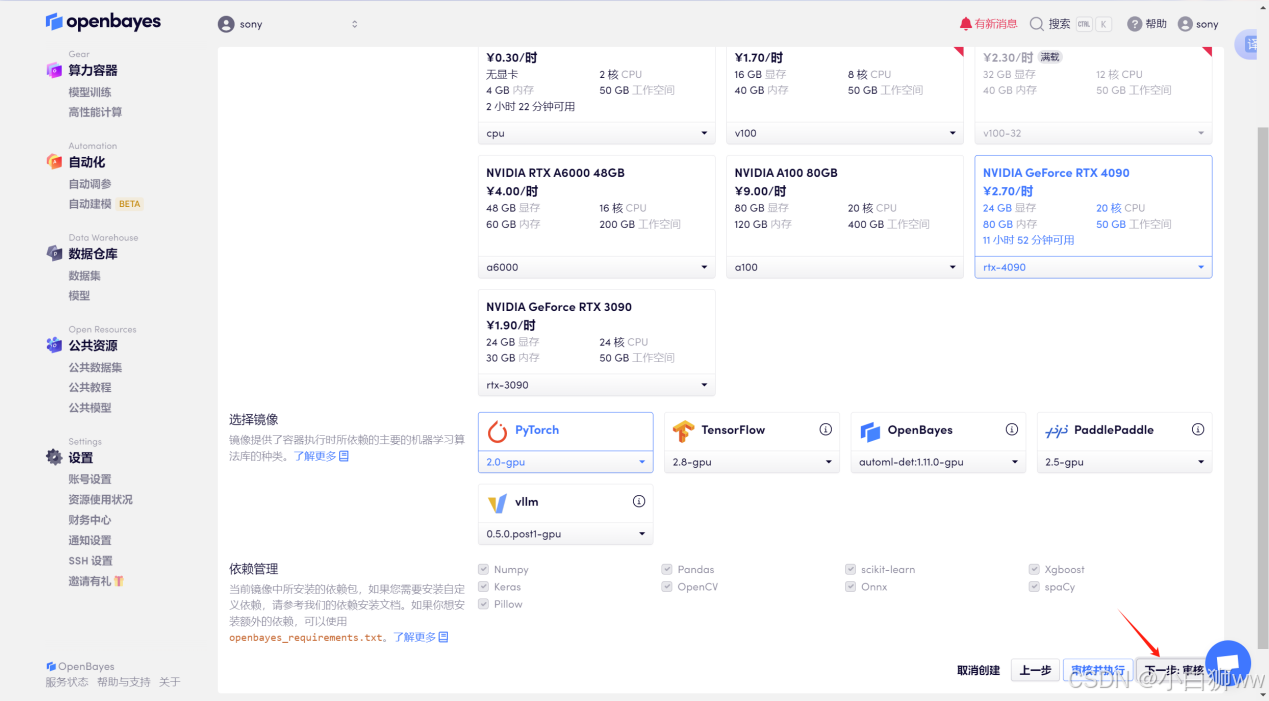
确认无误后,点击「继续执行」。
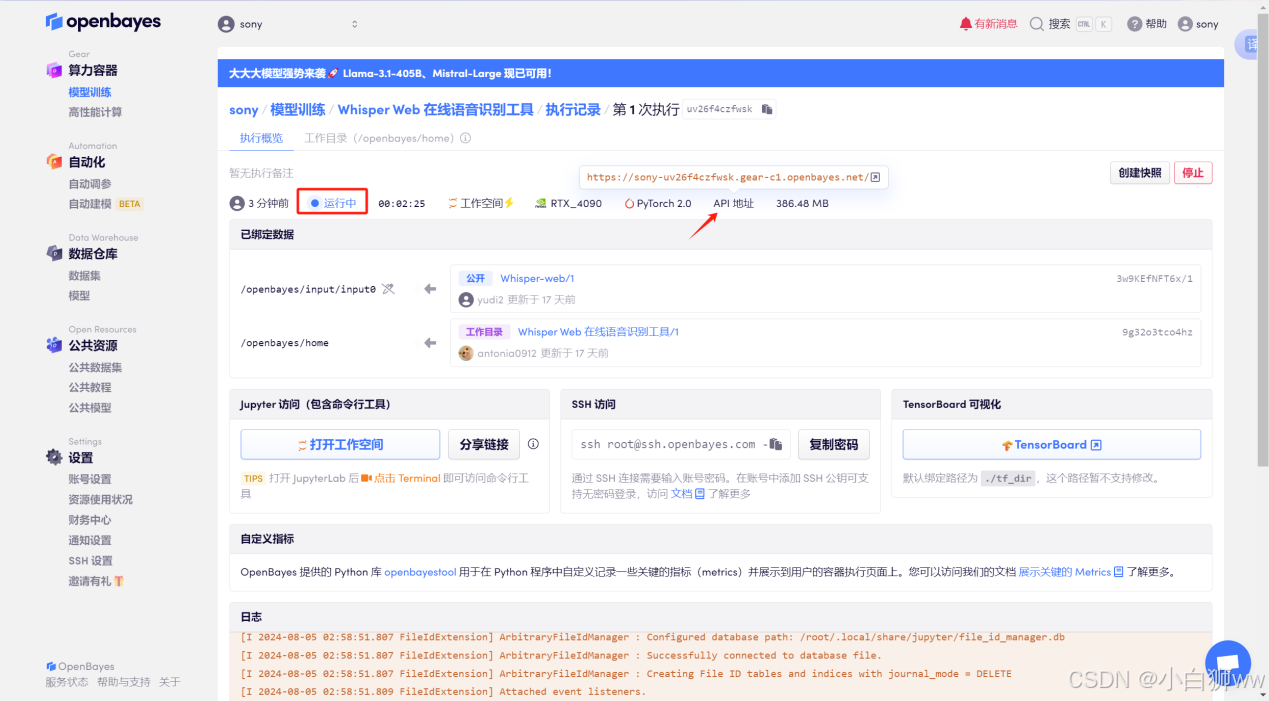
系统分配资源完成后,待状态显示为「运行中」后,将鼠标悬停在 API 地址处,点击链接进入模型。使用 API 需要进行现进行实名认证~
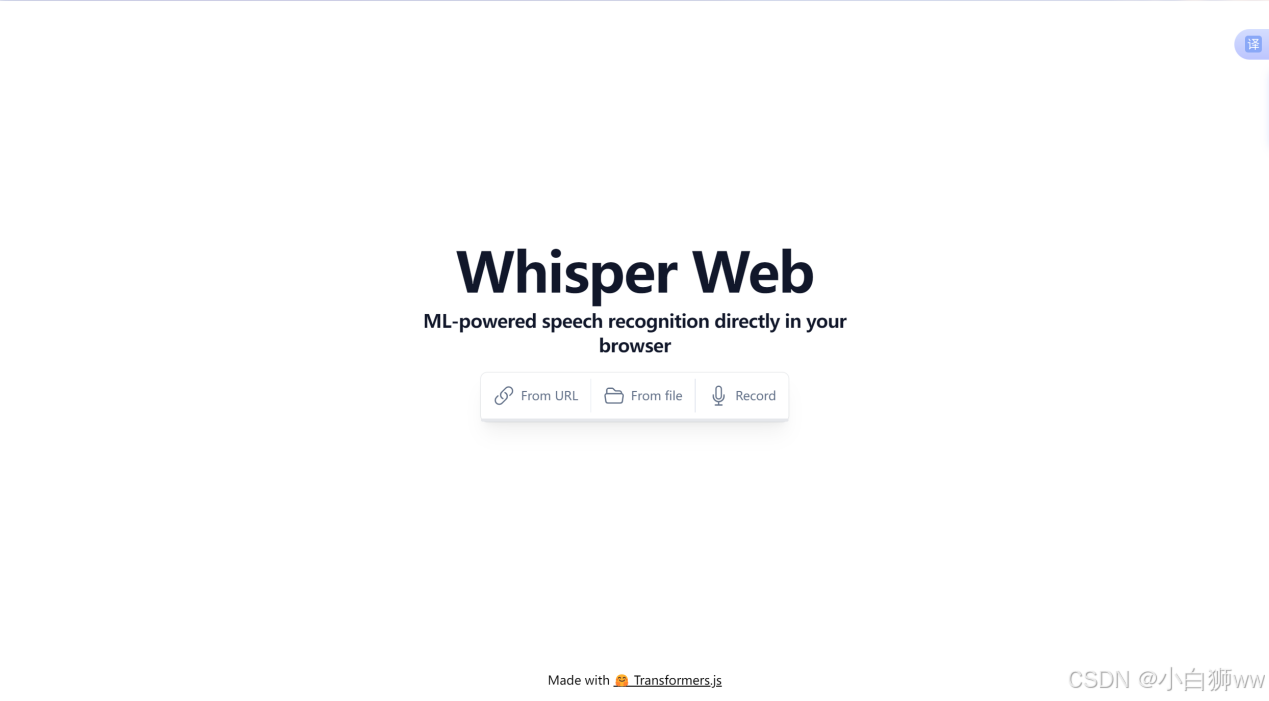
可以看到有三个选项可以选择:
From URL:通过线上的方式进行语音文件的下载。
From file:通过本地上传进行语音文件的下载。
Record:即使录音。
方式一:From URL
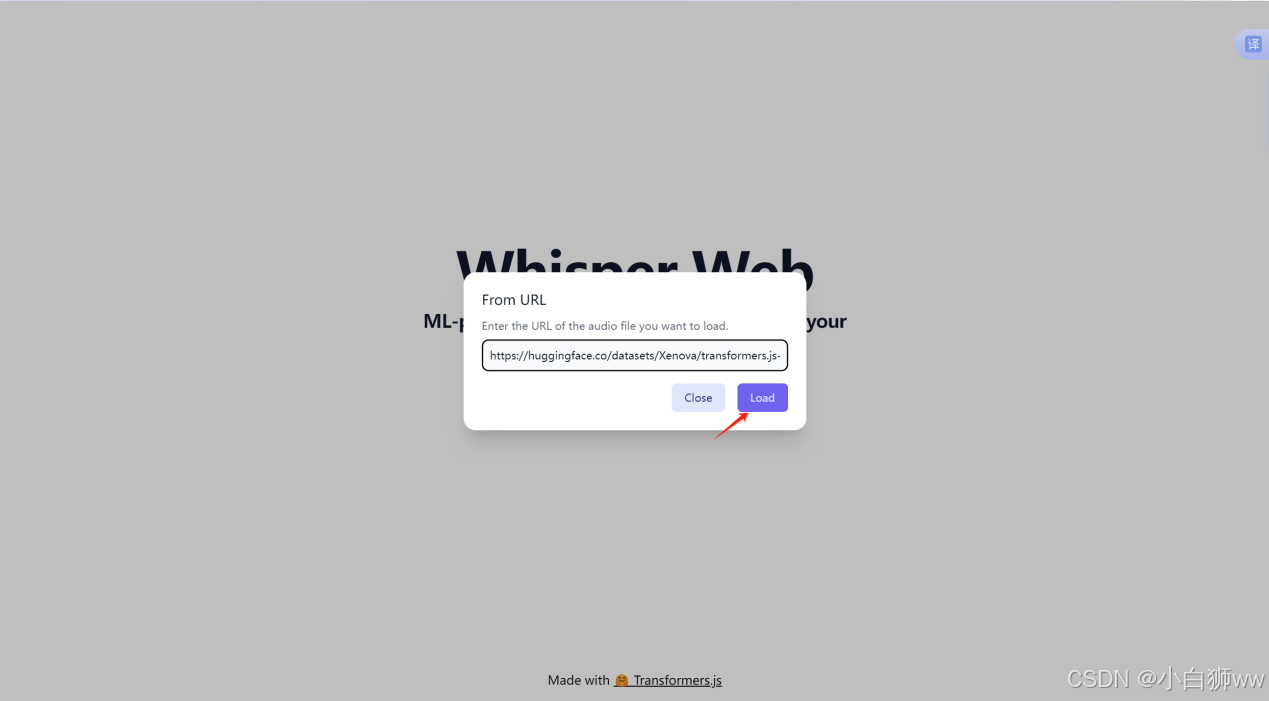
点击「From URL」,上传音频 URL,直接点击 Load 进行下载。
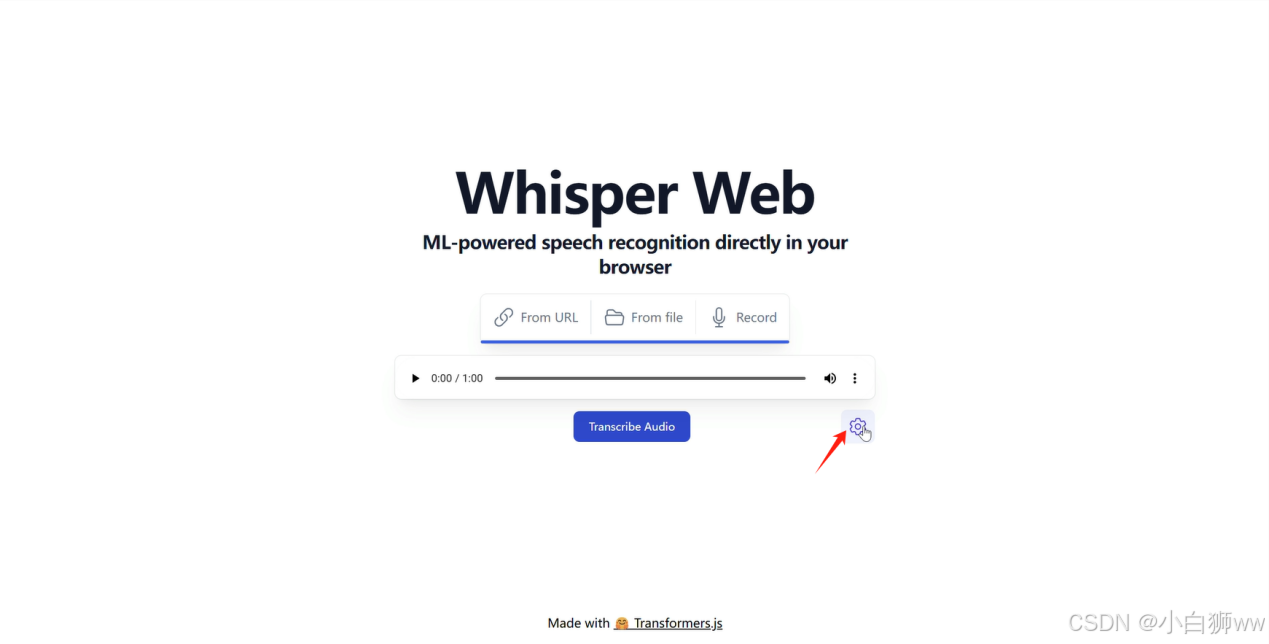
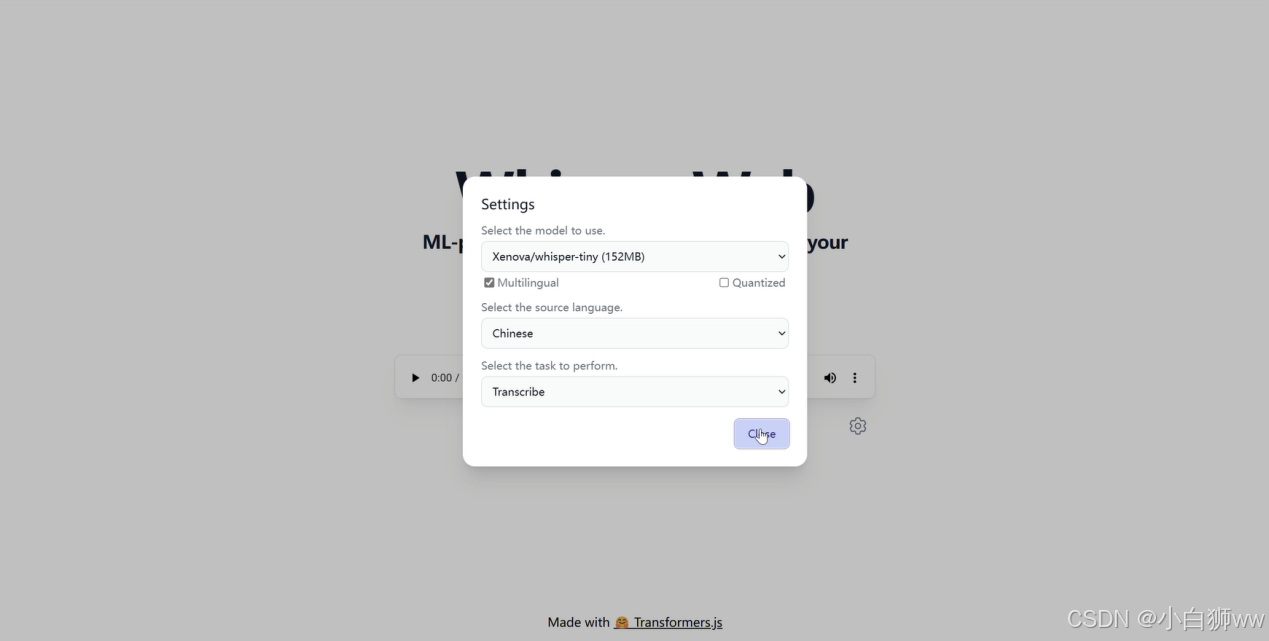
下载完成后,点击下方的设置按钮。
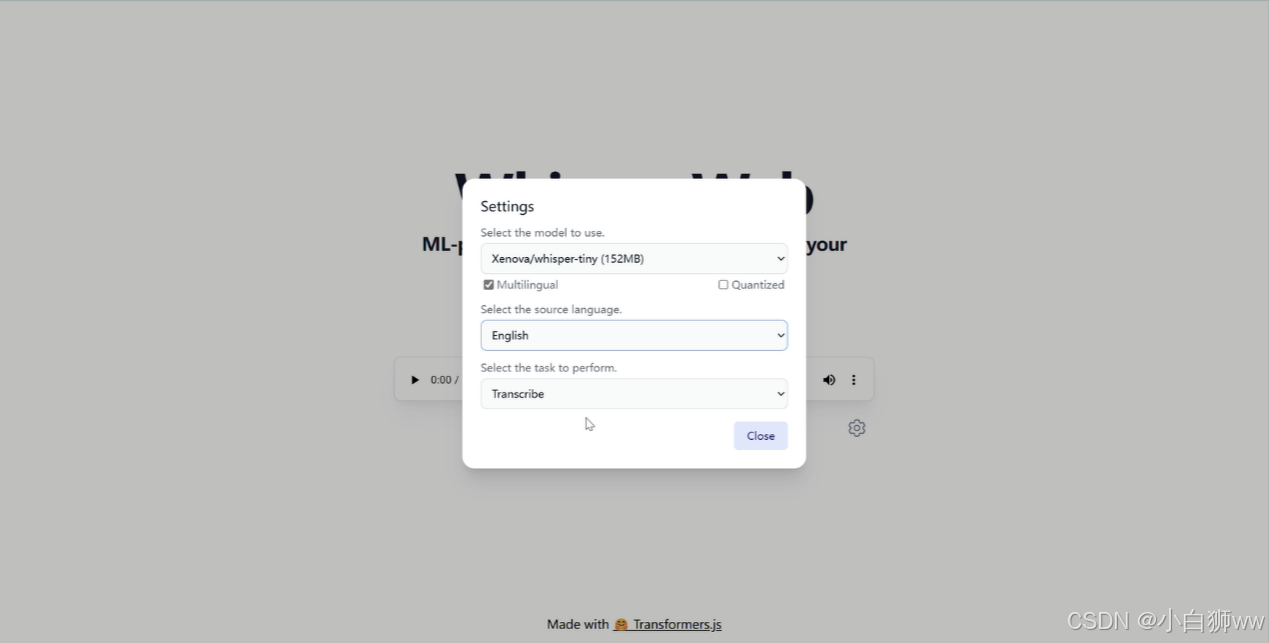
 选择 Multilingual 项,设置需要的语言。
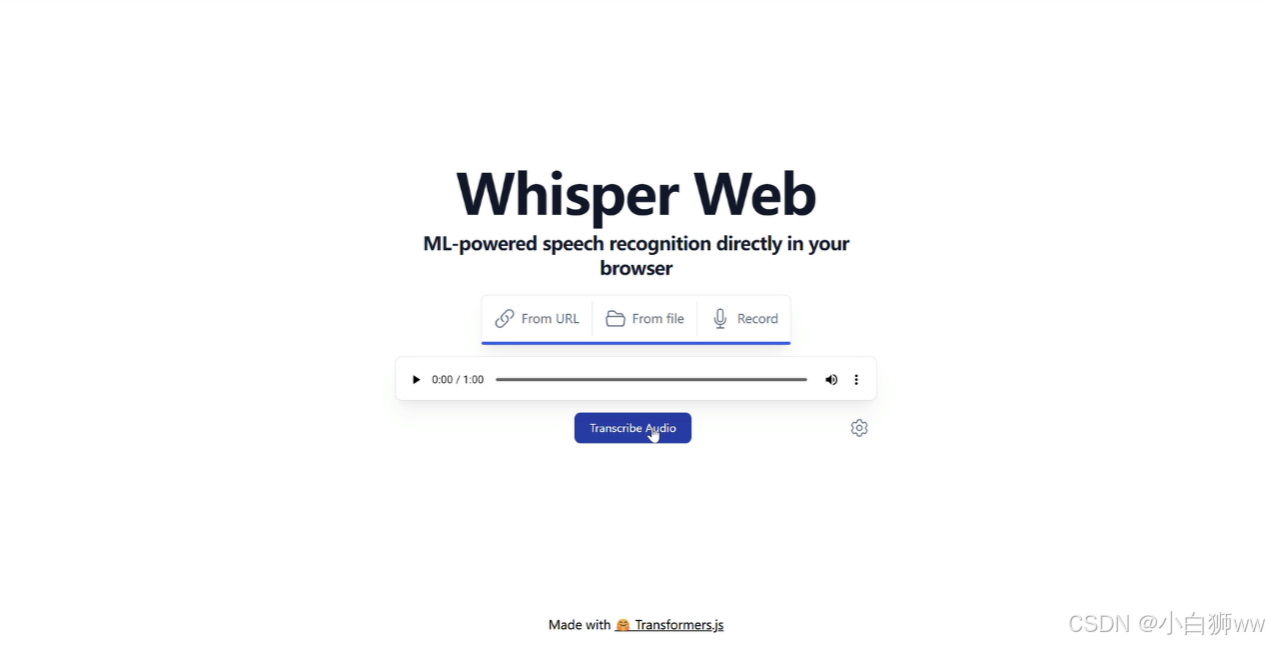
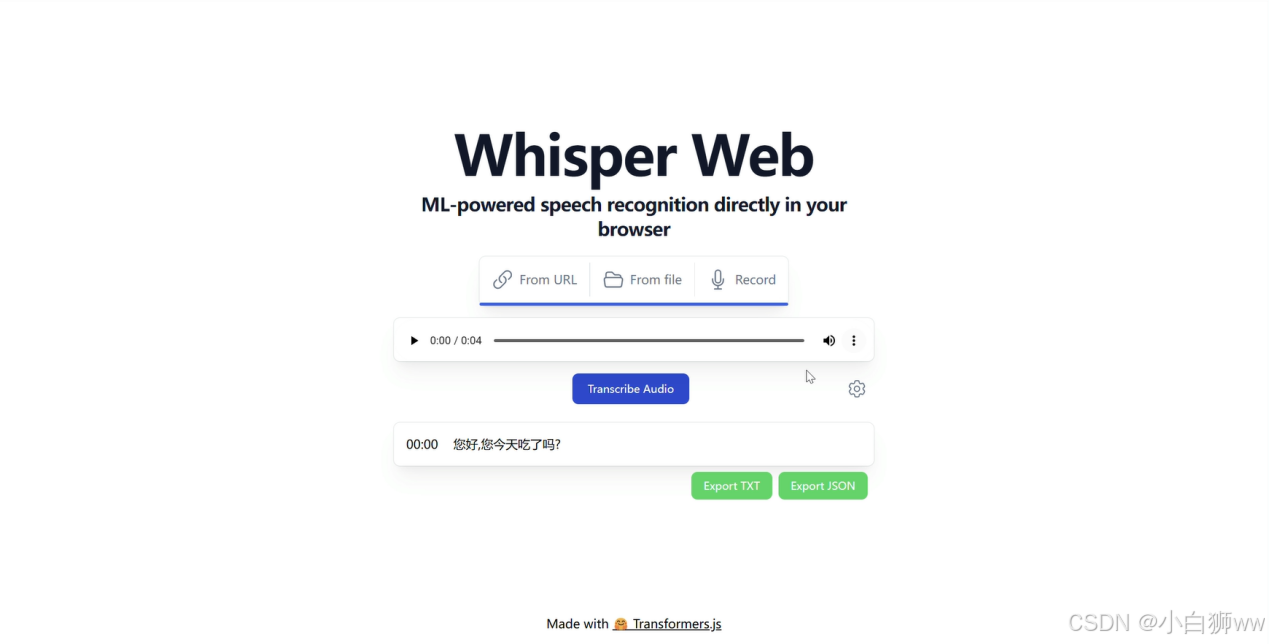
点击「Transcribe Audio」即可生成。
方式二:From file
点击「From file」,上传一个准备好的本地文件。

根据文件更改语言设置。

方式三:Record
选择「Record 」,点击Start Recording 开始录音。
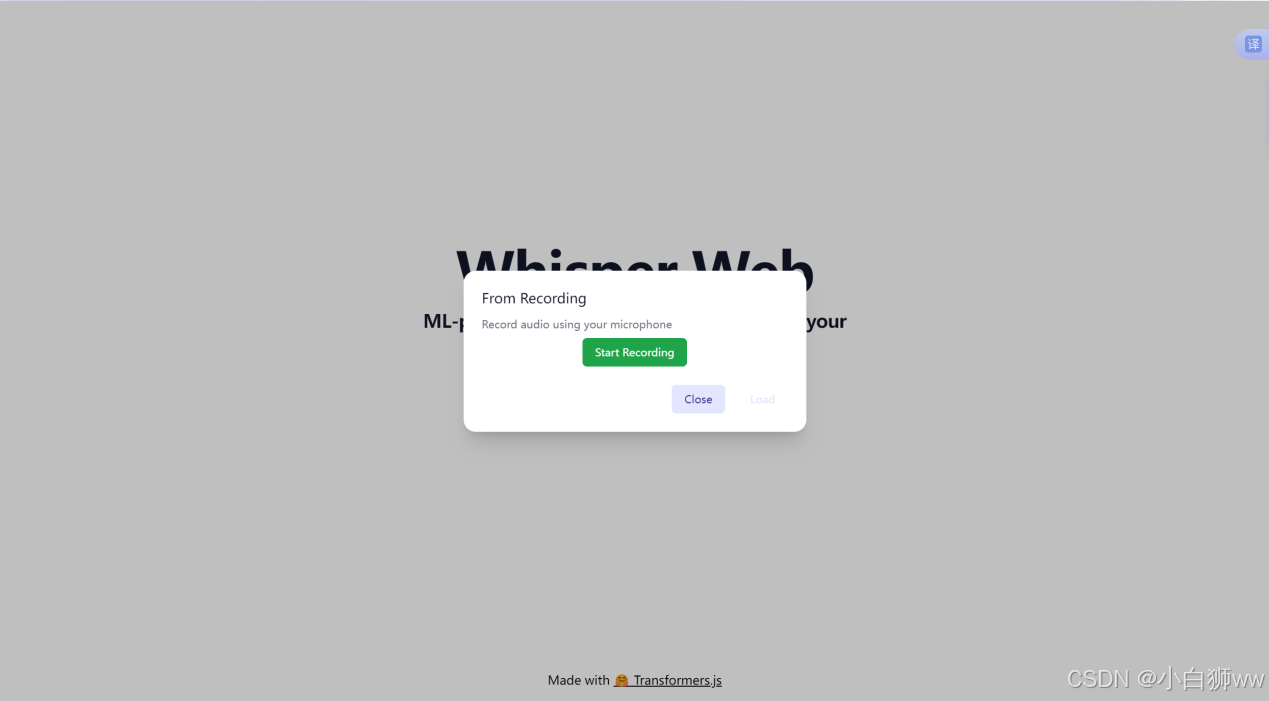
录好之后进行加载,点击「Transcribe Audio」进行翻译。


 扫一扫


 3978

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


