


预警流失项目
代码及数据文件下载地址:电信行业用户流失预警案例——python实现多模型预测
#导入所需的库
import numpy as nm
import pandas as pd
import sklearn
#将数据文件转化为csv文件
#csv文件是逗号分隔文件,可以使用excel查看,便于后期处理。
""""
import csv
with open('list1_test.csv', 'w+', newline='') as csvfile:
    spamwriter = csv.writer(csvfile, dialect='excel')
    with open('list1_test.txt', 'r', encoding='utf-8') as filein:
        for line in filein:
            line_list = line.strip('\n').split(',')   #数据之间以,间隔
            spamwriter.writerow(line_list)
with open('list2_test1.csv', 'w+', newline='') as csvfile:
    spamwriter = csv.writer(csvfile, dialect='excel')
    with open('list2_test1.txt', 'r', encoding='utf-8') as filein:
        for line in filein:
            line_list = line.strip('\n').split(',')   #数据之间以,间隔
            spamwriter.writerow(line_list)
with open('list2_test2.csv', 'w+', newline='') as csvfile:
    spamwriter = csv.writer(csvfile, dialect='excel')
    with open('list2_test2.txt', 'r', encoding='utf-8') as filein:
        for line in filein:
            line_list = line.strip('\n').split(',')   #数据之间以,间隔
            spamwriter.writerow(line_list)
with open('list3_test.csv', 'w+', newline='') as csvfile:
    spamwriter = csv.writer(csvfile, dialect='excel')
    with open('list3_test.txt', 'r', encoding='utf-8') as filein:
        for line in filein:
            line_list = line.strip('\n').split(',')   #数据之间以,间隔
            spamwriter.writerow(line_list)
"""
合并数据文件
调用pandas库中的merge函数,设置d_userid为合并标识,使用左连接方式,将用户所有信息连接到一个表格中,合并前需删除多余的month_id数据列,否则在合并时会出现填充错误。读取合并文件时设置参数为utf_8,否则会出现乱码。
#删除month_id数据列
inputfile1=r'month1list1.csv'
inputdata1=pd.read_csv(inputfile1,low_memory=False)
inputdata1=inputdata1.drop(['month_id'],axis=1)
inputfile2=r'month1list2a.csv'
inputdata2=pd.read_csv(inputfile2,low_memory=False)
inputdata2=inputdata2.drop(['month_id'],axis=1)
inputfile3=r'month1list2b.csv'
inputdata3=pd.read_csv(inputfile3,low_memory=False)
inputdata3=inputdata3.drop(['month_id'],axis=1)
outfile = r'month1list3.csv'
outdata = pd.read_csv(outfile,low_memory=False)
outdata =outdata.drop(['month_id'],axis=1)
#合并采用左连接方式
#第一次合并
outfile1 = pd.merge(outdata,inputdata1,left_on='d_userid',right_on='d_userid',how='left')
outfile1.to_csv('outfile.csv',encoding='utf_8',index=False)
outfile = r'outfile.csv'
outdata = pd.read_csv(outfile,low_memory=False)
#第二次合并
outfile2 = pd.merge(outdata,inputdata2,left_on='d_userid',right_on='d_userid',how='left')
outfile2.to_csv('outfile.csv',encoding='utf_8',index=False)
outfile = r'outfile.csv'
outdata = pd.read_csv(outfile,low_memory=False)
#第三次合并
outfile3 = pd.merge(outdata,inputdata3,left_on='d_userid',right_on='d_userid',how='left')
#文件保存
outfile3.to_csv('outfile.csv',encoding='utf_8',index=False)
数据去重
通过调用drop_duplicates()方法,以d_userid作为唯一标识,去除数据集中的重复数据。
#数据去重
initfile_locate=r'outfile.csv'
#打开文件
initfile=pd.read_csv(initfile_locate,encoding='utf-8',low_memory=False)
initfile.drop_duplicates(subset='d_userid',inplace=True)
#保存文件
initfile.to_csv(initfile_locate,encoding='utf_8',index=False)
#查看去重后的数据集信息
initfile.shape
(150822, 29)
#查看去重后的数据前十项
initfile.head(10)
| d_userid | mou | dou | arpu | mou_var | dou_var | arpu_var | sms | flux_4g | call_ring | ... | brand_code | start_date | end_date | service_type | pay_mode | cert_age | chnl_type | product_class_desc | comp_type | activity_type | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1000925 | 165 | 349 | 30 | 22.34 | -182.69 | -5.95 | 1 | 1.00 | 24 | ... | 3G03 | 2017/11/1 0:00 | 2050/12/31 0:00 | 40AAAAAA | 1 | 43.0 | 社会实体渠道 | NaN | 无 | 单卡 |
| 1 | 1000927 | 141 | 0 | 18 | -4.60 | 0.00 | 0.00 | 0 | 0.00 | 18 | ... | 3G03 | 2017/1/1 0:00 | 2050/12/31 0:00 | 20AAAAAA | 1 | 53.0 | 社会实体渠道 | NaN | 无 | 单卡 |
| 2 | 1000929 | 163 | 2 | 18 | 40.14 | 0.13 | 4.12 | 0 | 0.00 | 23 | ... | 3G03 | 2017/12/9 12:59 | 2050/12/31 0:00 | 40AAAAAA | 1 | 46.0 | 社会实体渠道 | NaN | 无 | 单卡 |
| 3 | 1000930 | 37 | 475 | 18 | -4.86 | 22.12 | 0.00 | 0 | 0.00 | 2 | ... | 3G03 | 2017/5/28 10:13 | 2050/12/31 0:00 | 20AAAAAA | 1 | 59.0 | 营业厅 | NaN | 无 | 单卡 |
| 4 | 1000932 | 6 | 147 | 18 | 1.00 | 28.06 | 4.15 | 0 | 0.36 | 1 | ... | 3G03 | 2017/12/7 18:36 | 2050/12/31 0:00 | 40AAAAAA | 1 | 30.0 | 社会实体渠道 | NaN | 无 | 单卡 |
| 5 | 1001009 | 18 | 6 | 18 | 3.80 | 1.01 | 4.11 | 0 | 1.00 | 3 | ... | 3G03 | 2017/12/1 14:59 | 2050/12/31 0:00 | 20AAAAAA | 1 | 21.0 | 社会实体渠道 | NaN | 无 | 单卡 |
| 7 | 1001010 | 97 | 0 | 19 | -13.34 | 0.00 | 0.90 | 0 | 0.00 | 6 | ... | 3G03 | 2017/3/11 10:55 | 2050/12/31 0:00 | 20AAAAAA | 1 | 32.0 | 营业厅 | NaN | 无 | 单卡 |
| 9 | 1001012 | 154 | 176 | 23 | -20.23 | -15.74 | 0.58 | 0 | 0.98 | 6 | ... | 3G03 | 2017/8/1 0:00 | 2050/12/31 0:00 | 40AAAAAA | 1 | 46.0 | 营业厅 | NaN | 无 | 单卡 |
| 11 | 1001014 | 69 | 5 | 14 | 16.26 | -0.14 | 4.56 | 0 | 1.00 | 10 | ... | 3G03 | 2017/10/13 15:24 | 2050/12/31 0:00 | 20AAAAAA | 1 | 64.0 | 营业厅 | NaN | 无 | 单卡 |
| 13 | 1001016 | 8 | 0 | 13 | 0.23 | 0.01 | 4.22 | 0 | 0.00 | 0 | ... | 3G03 | 2017/11/15 9:10 | 2018/4/30 23:59 | 20AAAAAA | 1 | 48.0 | 社会实体渠道 | NaN | 无 | 单卡 |
10 rows × 29 columns
#统计显示数据集相关信息
initfile.columns
initfile.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 150822 entries, 0 to 150827
Data columns (total 29 columns):
 #   Column              Non-Null Count   Dtype
---  ------              --------------   -----
 0   d_userid            150822 non-null  int64
 1   mou                 150822 non-null  int64
 2   dou                 150822 non-null  int64
 3   arpu                150822 non-null  int64
 4   mou_var             150822 non-null  float64
 5   dou_var             150822 non-null  float64
 6   arpu_var            150822 non-null  float64
 7   sms                 150822 non-null  int64
 8   flux_4g             150822 non-null  float64
 9   call_ring           150822 non-null  int64
 10  unicom_score        150822 non-null  float64
 11  innet_months        150822 non-null  int64
 12  is_card             150822 non-null  int64
 13  is_group            150822 non-null  int64
 14  is_lv               150822 non-null  int64
 15  is_trans            150822 non-null  int64
 16  is_acct_lost        150822 non-null  int64
 17  product_mode        150808 non-null  float64
 18  product_id          150808 non-null  float64
 19  brand_code          150808 non-null  object
 20  start_date          150808 non-null  object
 21  end_date            150808 non-null  object
 22  service_type        150822 non-null  object
 23  pay_mode            150822 non-null  object
 24  cert_age            146287 non-null  float64
 25  chnl_type           150822 non-null  object
 26  product_class_desc  82618 non-null   object
 27  comp_type           150822 non-null  object
 28  activity_type       150822 non-null  object
dtypes: float64(8), int64(12), object(9)
memory usage: 34.5+ MB
数据集分析
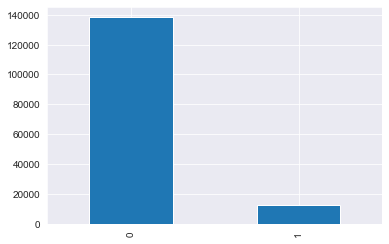
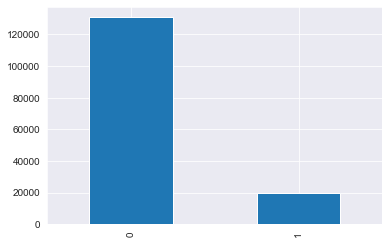
通过使用matplotlib.pyplot中的相关方法对数据进行可视化分析,通过绘图查看数据分布和相关关系,通过绘制热图查看与用户流失最相关的15个 因素,便于后期建模预测。
#导入绘图分析相关包
import matplotlib.pyplot as plt
#可以直接在python console里面生成图像。
%matplotlib inline
import seaborn as sns
color=sns.color_palette()
sns.set_style('darkgrid')
#查看用户流失列的数据分布
initfile["is_acct_lost"].value_counts().plot(kind = 'bar')
<AxesSubplot:>
#查看低价值用户数量分布
initfile["is_lv"].value_counts().plot(kind = 'bar')
<AxesSubplot:>
#热图绘制,查看与用户流失最相关的因素
para = 15
#查看相关度最高的15个特征
corrmat = initfile.corr() #获得相关性矩阵
cols = corrmat.nlargest(para,"is_acct_lost").index
cm = nm.corrcoef(initfile[cols].values.T)
#绘制热图
sns.set(font_scale=1.25)
hm = sns.heatmap(cm,cbar=True,annot=True,square=True,fmt='.2f',annot_kws={

   'size':10},yticklabels=cols.values,
                 xticklabels=cols.values)
plt.show()
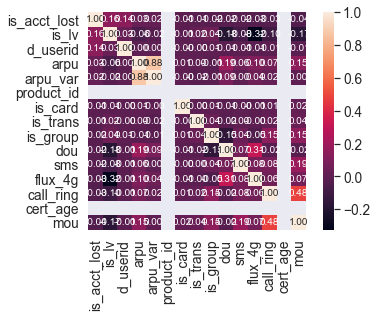
通过热图可以发现与用户流失最相关的因素分别是:is_lv(低价值用户),arpu(月均出账费),arpu_var(月出账费-方差),product_id(产品 编码),is_card(是否单卡),is_trans(是否转网),is_group(是否集客),dou(户均上网流量),sms(短信使用条数),flux_4g(4G流量使用量), call_ring(呼叫圈个数),cert_age(年龄),mou(户均通话时长)。接下来对其中的部分因素进行分析,并选择多个因素进行相关分析。
#查看is_trans(转网)与is_acct_lost的相关关系。
cust_0=initfile["is_trans"][initfile["is_acct_lost"]==0].value_counts()
cust_1=initfile["is_trans"][initfile["is_acct_lost"]==1

 1342


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


