我用加强版RFM模型,轻松扒出B站优质up主!(含数据+实战代码)

如何从RHEL 8升级到RHEL 9 Red Hat 于 2022 年 5 月 17 日宣布全面推出 RHEL 9。这是 RHEL(Red Hat Enterprise Linux)的最新版本,它具有许多功能和增强功能。 阅读详情

↑ 关注 + 星标 ~ 别错过有趣内容


不管前浪还是后浪,能够浪起来的才算是好浪。

相信大家最近都被号称“浪里白条”的b站刷了不止一次屏。这次咱们先不谈价值观,主要从数据的角度,扒一扒让b站能够在浪里穿梭的资本——优质UP主。

本文在RFM模型基础上做了调整,尝试用更符合b站特性的IFL模型,找到各分区优质up主。整个过程以分析项目的形式展开,最终附上了完整源数据和代码,方便感兴趣的同学练手。
项目概览

  分析目的

对2019年1月~2020年3月发布的视频进行分析,挑选出视频质量高,值得关注的up主。

  数据来源

分析数据基于 bilibili 网站上的公开信息,主要爬取了以下数据维度:

2019年1月~2020年3月,科技区播放量过5w视频的分区名称、作者名称、作者id、发布时间、播放数、硬币数、弹幕数、收藏数、点赞数、分享数、评论数,共计50130行。

  源数据下载链接

后台回复“b站”,获取完整数据源和代码。
数据概览

视频信息表:
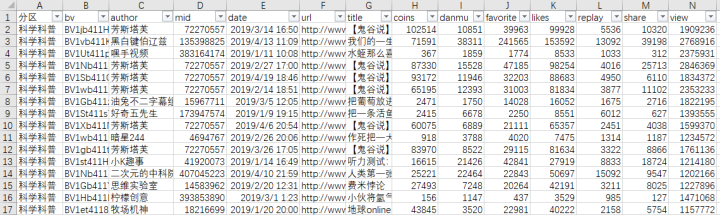
coins:投硬币数

danmu:弹幕数

favorite:收藏数

likes:点赞数

replay:评论数

share:分享数

view:播放量

各字段数量:

缺失值数量:
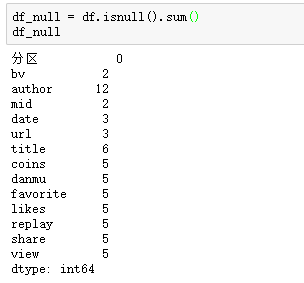
数据清洗

  删除空值

df = df.dropna()
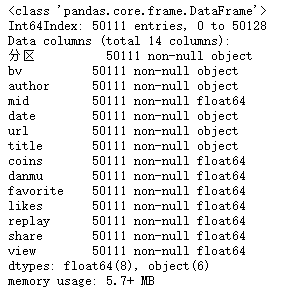
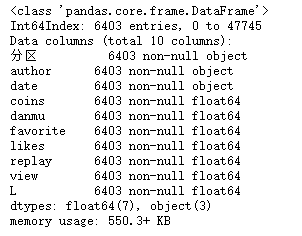
df.info()

共删除了19行数据,剩余50111行数据

  删除重复值

df = df.drop_duplicates()
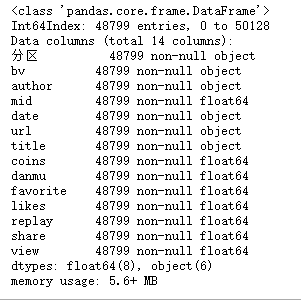
df.info()

删除了1312行重复的数据,剩余数据量48799行

  提取所需关键词

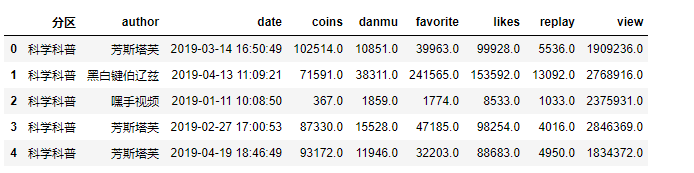
df = df[['分区', 'author','date','coins','danmu','favorite','likes','replay','share','view']]
df.head()

构建模型

RFM模型是衡量客户价值和创利能力的重要工具和手段。通过一个客户近期购买行为、购买的总体频率以及消费金额三项指标来描述客户的价值状况。

R:最近一次消费时间(最近一次消费到参考时间的间隔)

F:消费的频率(消费了多少次)

M:消费的金额 (总消费金额)

但RFM模型并不能评价视频的质量,所以在这里针对up主的视频信息构建了IFL模型,以评估视频的质量。

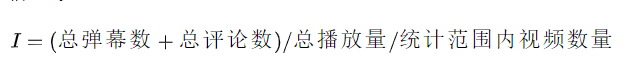
I(Interaction_rate):

I值反映的是平均每个视频的互动率,互动率越高,表明其视频更能产生用户的共鸣,使其有话题感。
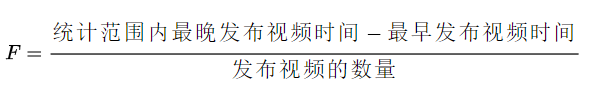
F(Frequence):

F值表示的是每个视频的平均发布周期,每个视频之间的发布周期越短,说明内容生产者创作视频的时间也就越短,创作时间太长,不是忠实粉丝的用户可能将其遗忘。
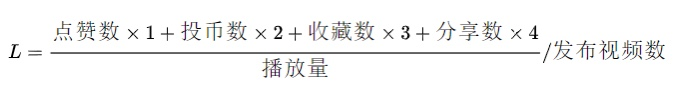
L(Like_rate):

L值表示的是统计时间内发布视频的平均点赞率,越大表示视频质量越稳定,用户对up主的认可度也就越高。
  提取需要的信息

根据不同的分区进行IFL打分,这里以科普区为例

sc = df.loc[df['分区']=='科学科普']
so = df.loc[df['分区']=='社科人文']
ma = df.loc[df['分区']=='机械']
tec = df.loc[df['分区']=='野生技术协会']
mi = df.loc[df['分区']=='星海'] # 一般发布军事内容
car = df.loc[df['分区']=='汽车']
sc.info()

  关键词构造

F值:首先,先筛选出发布视频大于5的up主,视频播放量在5W以上的视频数少于5,说明可能是有些视频标题取得好播放量才高,而不是视频质量稳定的up主。

# 计算发布视频的次数
count = sc.groupby('author')['date'].count().reset_index()
count.columns =['author','times']
# 剔除掉发布视频少于5的up主
com_m = count[count['times']>5]
#com_m = pd.merge(count,I,on='author',how='inner')
com_m.info()
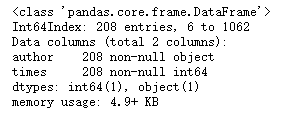
筛选完只剩下208个up主的视频数在5个以上:

last = sc.groupby('author')['date'].max()
late = sc.groupby('author')['date'].min()
# 最晚发布日期与最早之间的天数/发布次数,保留整数,用date重新命名列
F =round((last-late).dt.days/sc.groupby('author')['date'].count()).reset_index()
F.columns =['author', 'F']
F = pd.merge(com_m, F,on='author', how='inner')
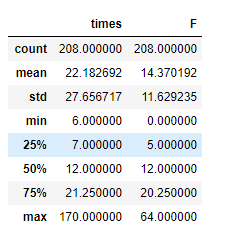
F.describe()

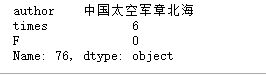
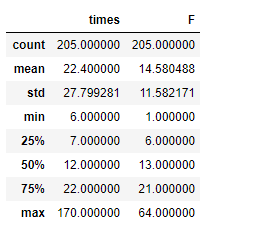
通过describe()方法发现,最晚发布日期与最早发布日期为0的现象,猜测是在同一天内发布了大量的视频。

# 查找的一天内发布视频数大于5的人
F.loc[F['F'].idxmin()]

其视频皆为转载,将其剔除统计范围内。

F = F.loc[F['F']>0]
F.describe()

I值

# 构建I值
danmu = sc.groupby('author')['danmu'].sum()
replay = sc.groupby('author')['replay'].sum()
view = sc.groupby('author')['view'].sum()
count = sc.groupby('author')['date'].count()
I =round((danmu+replay)/view/count*100,2).reset_index() #
I.columns=['author','I']
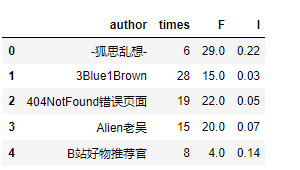
F_I = pd.merge(F,I,on='author',how='inner')
F_I.head()

L值

# 计算出点赞率计算出所有视频的点赞率
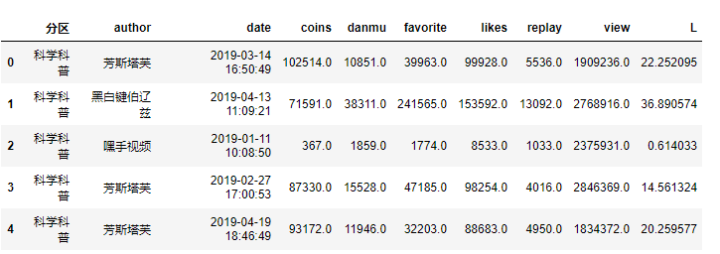
sc['L'] =(sc['likes']+sc['coins']*2+sc['favorite']*3)/sc['view']*100
sc.head()

# 构建L值
L =(sc.groupby('author')['L'].sum()/sc.groupby('author')['date'].count()).reset_index()
L.columns =['author', 'L']
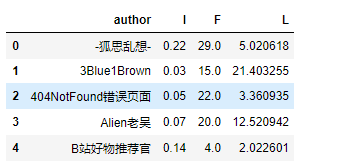
IFL = pd.merge(F_I, L, on='author',how='inner')
IFL = IFL[['author', 'I','F','L']]
IFL.head()

  维度打分

维度确认的核心是分值确定,按照设定的标准,我们给每个消费者的I/F/L值打分,分值的大小取决于我们的偏好,即我们越喜欢的行为,打的分数就越高:

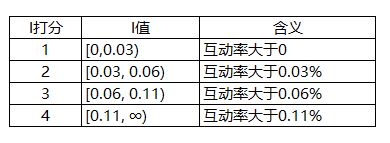
  • I值,I代表了up主视频的平均评论率,这个值越大,就说明其视频越能使用户有话题,当I值越大时,分值越大。

  • F值表示视频的平均发布周期,我们当然想要经常看到,所以这个值越大时,分值越小。

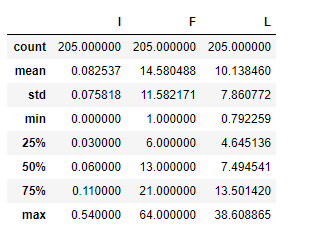
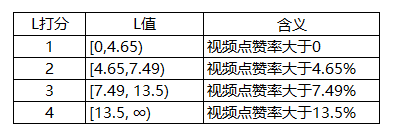
  • L值表示发布视频的平均点赞率,S值越大时,质量越稳定,分值也就越大。I/S值根据四分位数打分,F值根据更新周期打分。

IFL.describe()
I值打分:
L值打分:
F值根据发布周期打分:
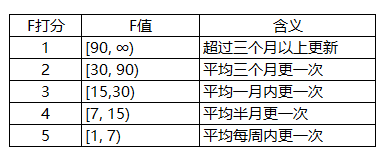
  分值计算

# bins参数代表我们按照什么区间进行分组
# labels和bins切分的数组前后呼应,给每个分组打标签
# right表示了右侧区间是开还是闭,即包不包括右边的数值,如果设置成False,就代表[0,30)
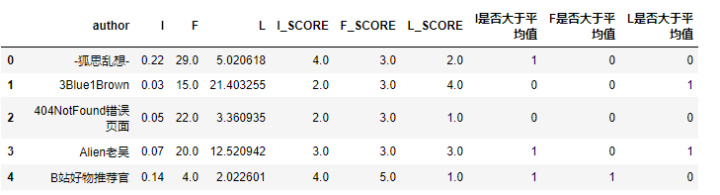
IFL['I_SCORE'] = pd.cut(IFL['I'], bins=[0,0.03,0.06,0.11,1000],
                        labels=[1,2,3,4], right=False).astype(float)
IFL['F_SCORE'] = pd.cut(IFL['F'], bins=[0,7,15,30,90,1000],
                        labels=[5,4,3,2,1], right=False).astype(float)
IFL['L_SCORE'] = pd.cut(IFL['L'], bins=[0,5.39,9.07,15.58,1000],
                        labels=[1,2,3,4], right=False).astype(float)
IFL.head()

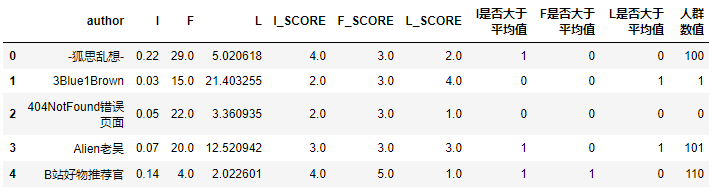
判断用户的分值是否大于平均值:

# 1为大于均值 0为小于均值
IFL['I是否大于平均值'] =(IFL['I_SCORE'] > IFL['I_SCORE'].mean()) *1
IFL['F是否大于平均值'] =(IFL['F_SCORE'] > IFL['F_SCORE'].mean()) *1
IFL['L是否大于平均值'] =(IFL['L_SCORE'] > IFL['L_SCORE'].mean()) *1
IFL.head()

  客户分层

RFM经典的分层会按照R/F/M每一项指标是否高于平均值,把用户划分为8类,我们根据根据案例中的情况进行划分,具体像下面表格这样:
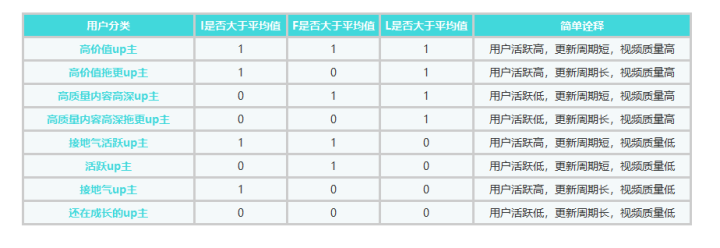
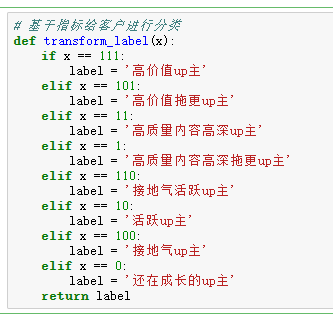
引入人群数值的辅助列,把之前判断的I\F\S是否大于均值的三个值串联起来:

IFL['人群数值'] =(IFL['I是否大于平均值'] *100) +(IFL['F是否大于平均值'] *10) +(IFL['L是否大于平均值'] *1)
IFL.head()

构建判断函数,通过判断人群数值的值,来返回对应标签:

将标签分类函数应用到人群数值列:

IFL['人群类型'] = IFL['人群数值'].apply(transform_label) 

IFL.head()
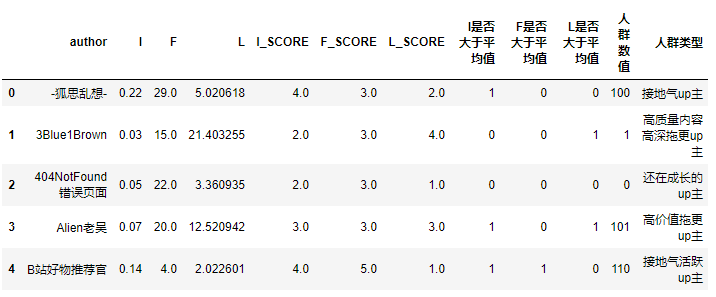
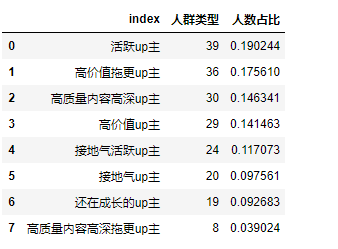
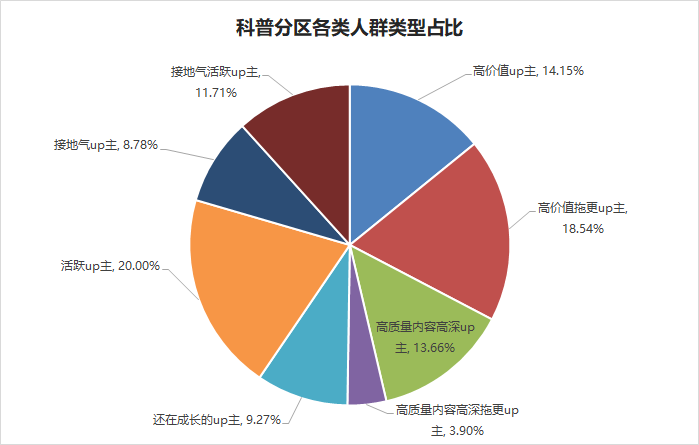
  各类用户占比

cat = IFL['人群类型'].value_counts().reset_index()
cat['人数占比'] = cat['人群类型'] / cat['人群类型'].sum()
cat

各分区up主排行top15

  科学科普分区

high = IFL.loc[IFL['人群类型']=='高价值up主']
rank = high[['author','L','I','F']].sort_values('L',ascending=False)
rank.to_excel('rank.xlsx', sheet_name='科学科普',encoding='utf-8')
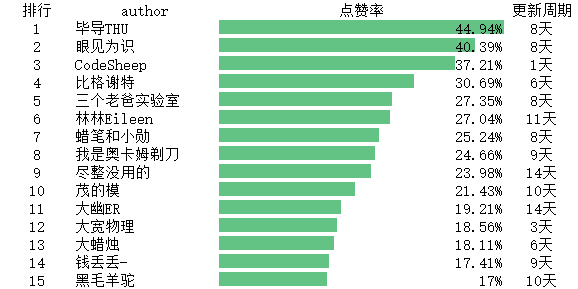
  社科人文分区
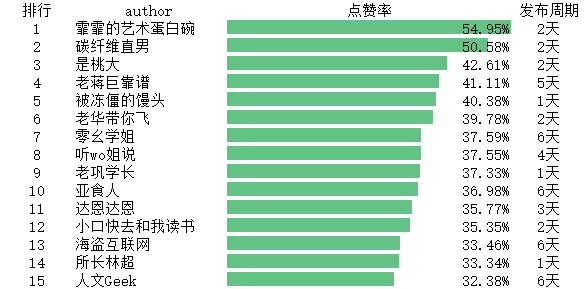
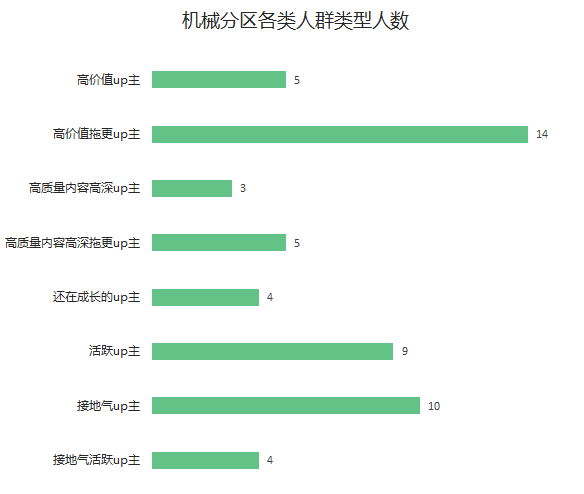
  机械分区
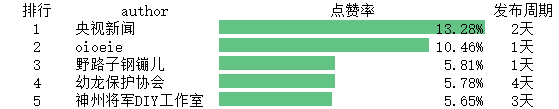
机械分区高价值up主只有5位,因为机械分区在科技区是个小分区,发布视频的up主仅有54位。
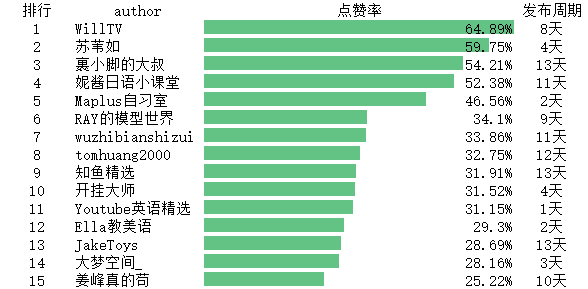
  野生技术协会分区
  星海
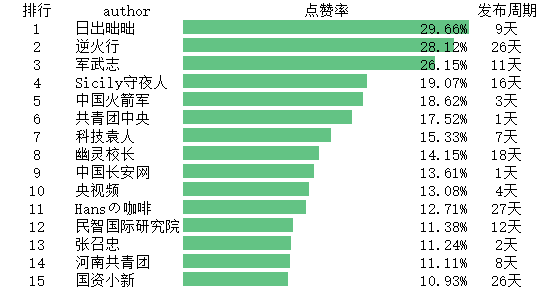
  汽车
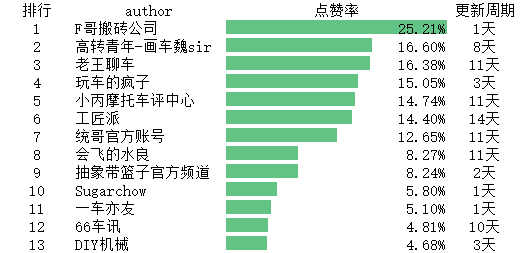
参考文章:

1.数据不吹牛:《不到70行Python代码,轻松玩转RFM用户分析模型》

2.Crossin:《B站用户行为分析非官方报告》

3.https://github.com/Vespa314/bilibili-api/blob/master/api.md


End


    100道练习题,玩转Numpy模块!    面试真题:1亿张彩票堆起来有多高?    数据分析里常用的五个统计学概念
小z微信坑位限时开放后台回复“芝麻开门”即可捕捉号主本人

“优秀~”

基于TENG的呼吸测量与识别系统:从蓝牙到WiFi的改造与上位机实现 本文介绍了一种基于摩擦纳米发电机(TENG)的呼吸测量系统改造方案,将原有蓝牙通信升级为WiFi传输。系统通过TENG传感器采集呼吸信号,STM32微控制器处理数据后,经ESP8266 WiFi模块发送至上位机。文中详细阐述了硬件改造(四通道改单通道、蓝牙换WiFi)、嵌入式软件修改(包括ESP8266驱动、数据采集与TCP通信实现)以及上位机软件设计。改造后的系统提升了传输距离和稳定性,为可穿戴健康监测提供了更优解决方案。 阅读详情

相关推荐

ZLMediaKit源码分析(二)推流创建

ZLMediaKit推流结构体创建是在RtspSession::onRecv()之后。如何触发onRecv()请参考上一篇文章这里不在赘述。

cliffordl的专栏 5062

数据分析实战(四) 改进版RFM模型挖掘B站动画区优质UP主

目录

shine4869的博客 4470

二相混合式步进电机闭环矢量控制simulink仿真(含仿真文件)

在位置跟踪伺服系统中二相混合式步进电机闭环矢量控制simulink仿真

qq_39023633的博客 2万+

Python 数据处理数据挖掘(四):用户分层模型RFM

声明本文为学习笔记,侵权删。

qq_46380784的博客 5199

用workbuddy自定义Skill:手把手搭建AI炒股分析助手

AI Agent正成为个人投资研究的重要工具,而Skill作为行为规范,能让AI输出保持稳定与专业。在AI Agent应用中,很多人分不清Skill与Agent的区别:Agent负责目标拆解与执行,Skill则固化分析流程与输出模板。借助本地工作台workbuddy,用户可自定义Skill,实现从市场环境检查到财务排雷的五段式分析。通过调低温度参数、设定数据验证规则,该方案能有效避免大模型凭空编造数据,帮助个人投资者快速完成基本面体检、资金面观察与风险清单生成。本文基于一套可直接套用的配置与一个月实测,展示

weixin_29038537的博客 456

深入解析SAP MM模块OBYC自动科目分配机制:从T030表到实战配置

本文深入解析SAP MM模块中OBYC自动科目分配机制,阐明其作为连接物流与财务核心桥梁的作用。文章以T030表为核心,详细拆解其字段结构与检索逻辑,并通过采购收货、生产发料等实战场景,手把手演示配置步骤与关键要点,帮助读者掌握从原理到实践的完整知识体系,实现业财无缝对接。

nft7creator的博客 347

哔哩哔哩如何一键给全部粉丝发私信

作为Up主,可能有时候我们需要给全部粉丝发私信,但是B站又没有开通这个功能,如果一个一个发的话,又非常非时间,所以为了解决这个问题,故写了个脚本来一键给所有粉丝发私信。

DG息的博客 5229

YOLOv8交通管理 详细解释及代码完整示例

YOLOv8在交通管理中的应用及代码实现 摘要:本文详细介绍了YOLOv8在交通管理领域的应用场景,包括车辆检测、违规行为识别和行人安全预警等。文章提供了完整的Python代码示例,展示了如何使用YOLOv8进行交通对象检测和车辆计数统计。代码包含模型加载、对象检测、结果可视化等功能模块,并给出了性能优化和功能扩展建议。该实现基于Ultralytics框架,支持多种YOLOv8模型选择,可根据实际需求调整模型大小和检测参数。

u010117029的博客 148

埋点数据设计

简单来说,埋点就是在网站或APP中加入一些程序代码,用以收集和统计用户在该网站/APP中的浏览、访问数据和应用使用情况,分析用户交互行为,从而帮助产品和运营进行后续优化。

yangyanping20108的博客 1157

芒果YOLO11改进176:2025最新顶会论文|尺度动态损失函数Scale-based Dynamic Loss,即插即用|以减少标签不准确对损失函数稳定性的影响

芒果YOLO11改进186:2025最新顶会论文|尺度动态损失函数Scale-based Dynamic Loss,即插即用|以减少标签不准确对损失函数稳定性的影响

包括YOLOv5、YOLOv7、YOLOv8等模型改进 2115

【2024遥感应用组一等奖】基于时空融合和水量平衡法的若尔盖高原水源涵养功能评价

考虑到水源涵养的概念和尺度特征、数据的可获得性、模型的模拟精度等,构建了一种基于遥感、气象和水量平衡原理的草原湿地水源涵养评价方法,估算若尔盖湿地近23年(2000-2022)来的水源涵养量。若尔盖湿地是我国黄河源区的重要水源地,所以本研究以若尔盖湿地的水源涵养功能评估为科学问题,基于遥感数据、GIS数据等,利用水量平衡原理,发展计算简单、便捷、数据易获取的“水源涵养估算方法”,科学估算若尔盖湿地水源涵养服务量,探究其时空动态变化趋势及其影响因素;公式中,Z1和Z2为两个不同高度面的高度,u为摩擦速率;

JData_Engineer的博客 236

机械学习 --客户价值模型 RFM

RFM模型引入 比如电商网站要做一次营销活动,需要针对不同价值的客户群体进行分群,对于高价值的用户推荐手表,珠宝等高端商品,对于低价值用户推荐打折促销的廉价商品,当然还有以下这些问题都是需要考虑的: 1.谁是我的最佳客户? 2.谁即将要成为流失客户? 3.谁将有潜力成为有价值的客户 4.哪些客户能够留存? 5.哪些客户会对你目前对活动有所反应? 那么最终的问题是如何对客户进行分群,即如何建立客户的价值模型呢? 在传统企业和电商众多的客户细分模型中,RFM模型是被广泛提到和使用的。 RFM模

kismet 2980

架构师之HBase vs MongoDB 技术选型与场景决策实战案例

面对海量数据和高并发查询,该选 HBase 还是 MongoDB?本文为你提供完整的决策框架!从数据模型对比、架构解析、六大真实场景(电信 CDR、金融行情、广告点击流、电商商品、社交档案、内容管理)到性能、一致性、运维全面对比,助你在 PB 级时序数据和灵活查询之间做出精准选择!

肖哥弹架构博客 1088

加强版RFM模型,轻松扒出B站优质up主!

不管前浪还是后浪,能够浪起来的才算是好浪。相信大家最近都被号称“浪里白条”的b站刷了不止一次屏。这次咱们先不谈价值观,主要从数据的角度,扒一扒让b站能够在浪里穿梭的资本——优质UP主。本...

lovenankai的专栏 710

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

237篇 历史文章合集

大家好,我是朱小五给大家整理了一下「凹凸数据」截止到2020年7月5日的历史文章合集。点击文章标题就可以跳转到相应文章,定期更新。大家可以按目录依次查看,也可以搜索(手机端点击右上角3个...

zhuxiao5的博客 5011

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

用户精准运营必备2大用户模型:ASG ; RFM

ASG ASG又叫动态等级算法,是企业在具备产品运营数据的基础上,精准把控用户行为路径、消费行为,用算法、刺激等手段提高用户产品使用频率的方法。 ASG模型的组成=算法+高频刺激+用户等级 包含三个主要核心要素: l算法 l高频刺激 l用户等级 A(algorithm):算法 ASG的算法中用户等级会随时间上下波动、企业会制定期望的用户等级人群、算法主要的作用为: 1.通过智能的判断用户等级波动给运营人员发出提醒信息 2.配备不同的触达场景、营销手段、留用户在期望的用户等级内..

PEXUE的专栏 985

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Bilibili,B站视频缩略图快速预览实现再分析

之前的这篇文章曾经有过一次分析 在B站视频搜索结果中,可以在不进入视频的状态下对视频快速预览。 今天详细分析和复现一下实现过程 1.首先,获取某视频的完整缩略图资源 通过下面接口获取 https://api.bilibili.com/x/player/videoshot?index=1&aid=XXX 以 https://www.bilibili.com/video/av8370807...

ucsheep-You see sheep! 6428

考研经历贴(2023)

考研经验

heshaohui12345的博客 2822

(新)B站视频播放源地址获取及B站视频下载

突然之间,我们的B站视频播放失效了。之前直接使用的ibilibili发现它的低清版本视频无法正常加载了。ibilibili站提供的高清视频下载器,下载m4s文件,最后再用ffmpeg转成mp4。 对于我们而言,视频的清晰度并不重要,我们需要播放直链,仅仅是为了播放和预览视频。下载B站视频本身并不是一个难事,所以下文我将首先介绍如何获取低清版直链,然后谈谈高清版下载如何是实现。

ucsheep-You see sheep! 194万+

BilibiliDown:5分钟掌握B站视频下载的终极免费工具

你是否经常在B站看到精彩的教学视频想要保存下来反复学习?或者想批量收藏UP主的系列作品却苦于一个个下载太麻烦?BilibiliDown正是为解决这些痛点而生的开源B站视频下载器,它让你只需简单几步就能轻松保存B站内容,无论是单个视频还是整个系列。这个跨平台的免费工具支持Windows、macOS和Linux三大操作系统,为你提供完整的B站视频下载解决方案。 ## 🔍 为什么你需要专业的B站下载

gitblog_00668的博客 390

2026终极指南:BiliTools哔哩哔哩工具箱,一键下载B站所有资源

还在为无法下载喜欢的B站视频、番剧或课程而烦恼吗?想要永久保存那些珍贵的教程、音乐或弹幕文化?今天我要向大家推荐一款**跨平台哔哩哔哩工具箱**——BiliTools,它将成为你管理B站资源的得力助手。 ## 🎯 为什么需要B站资源下载工具? 作为国内最大的视频分享平台,B站拥有海量的优质内容:从专业教程到娱乐番剧,从音乐作品到知识分享。然而,B站官方并不提供下载功能,这给用户带来了诸多不便

gitblog_00231的博客 366

分享7个比B站更刺激的老司机网站,别轻易点开

俗话说摸鱼一时爽,一直摸一直爽,作为一个程序员老司机了,一头乌黑浓密的头发还时不时被同事调侃,就靠这10个网站让我健康生活,不建议经常性使用,因为还有一句俗话,那就是“摸鱼一时爽,没有年终奖”,记得点赞收藏!

JNPF 专注低代码开发 12万+

如何快速翻译英文论文 PDF?PDFMathTranslate 完整教程与避坑指南

机器翻译论文时,公式被乱译、图表编号对不上、双栏排版错位,是绕不开的头疼事。PDFMathTranslate(命令行名 pdf2zh)专治这个问题:它先做版面检测再动笔,科学 PDF 里的数学符号与分栏结构在译文中基本原样保留,一份原文还会产出纯译文与中英对照两份文档。 ## 先看效果:翻译前后对比 📄 同一篇 Nature 论文翻译前后的官方截图如下,左为英文原文、右为 pdf2zh 输出

gitblog_00192的博客 901

MQTT 是什么?一文读懂 MQTT 协议的原理与优势

MQTT协议是什么

weixin_46739493的博客 8242

解锁Bilibili-Evolved:5个维度重塑你的哔哩哔哩体验

Bilibili-Evolved作为一款功能强大的哔哩哔哩增强脚本,通过深度个性化定制和自动化操作,彻底改变了用户与B站内容的交互方式。这个开源项目不仅提供了丰富的视频下载、弹幕管理、界面美化功能,更构建了一个完整的插件生态,让每个用户都能打造专属的B站浏览体验。 ## 🎯 价值主张:为什么你需要Bilibili-Evolved? 在内容消费日益个性化的今天,Bilibili-Evolved

gitblog_00462的博客 454

Java面试突击训练营,又升级了!

哈喽,大家好,我是磊哥!在过去的一段时间里,想必大家也感受到了找工作的难度,尤其是找好工作的难度。当然,这也是时代发展的趋势,但同时也对 Java 从业人员提出了更高的技术要求。哪怎么才能在短时间内提升自己的技术能力和面试能力?已得到更好的工作呢?这就是「面试突击训练营」所要解决的问题了。什么是面试突击训练营?面试突击训练营是短期内,帮助学员找到满意工作的一门课程和一系列就业辅导服务。也就是面试突...

磊哥聊Java 777
上一篇: 拼多多面经分享:24个「数据分析师」岗位面试题和答案解析
下一篇: 数据分析师必备思维——矩阵思维
数据不吹牛
博客等级 码龄10年 1570粉丝 67原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值