


Pytorch框架
张量的创建
'''
案例:演示张量的基本创建方式
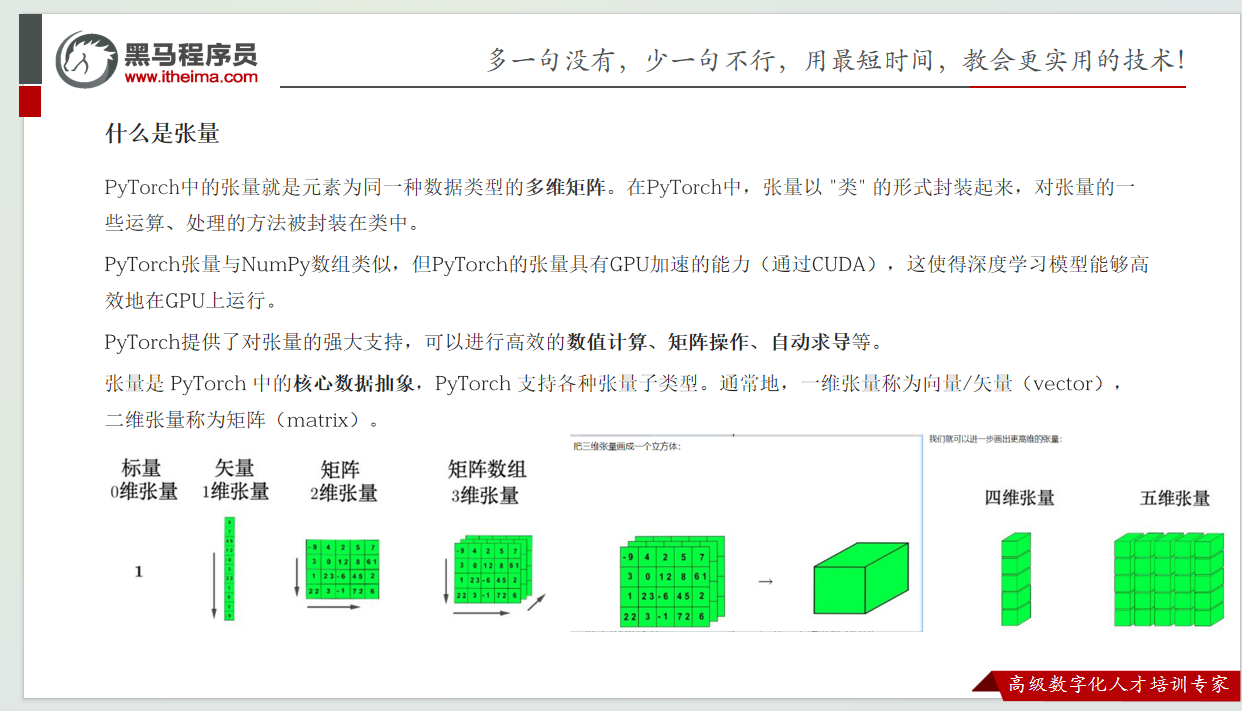
张量(Tensor):
    PyTorch框架属于最常用的深度学习框架,无论是后续要学的ANN(人工神经网络),还是CNN(卷积神经网络),RNN(循环神经网络)底层在处理数据是,
    都是使用张量来处理的。
    张量->存储同一类型元素的容器,且元素值必须是数据才可以
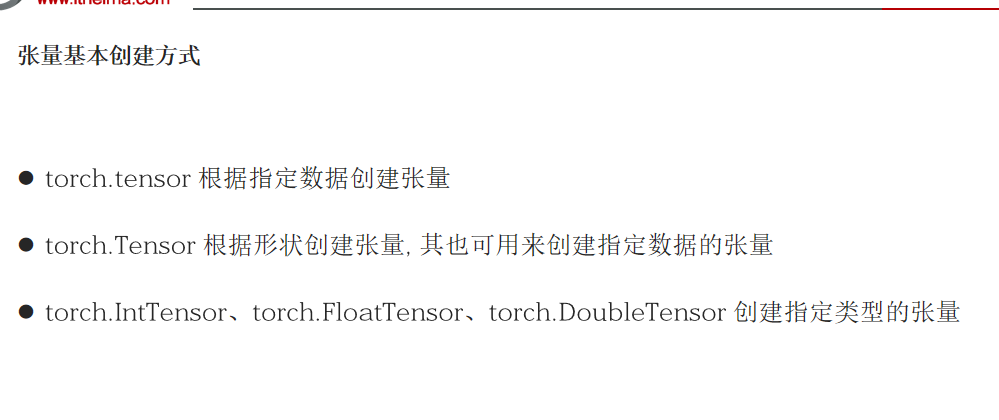
张量的基本创建方式:
    torch.tensor根据指定数据创建张量
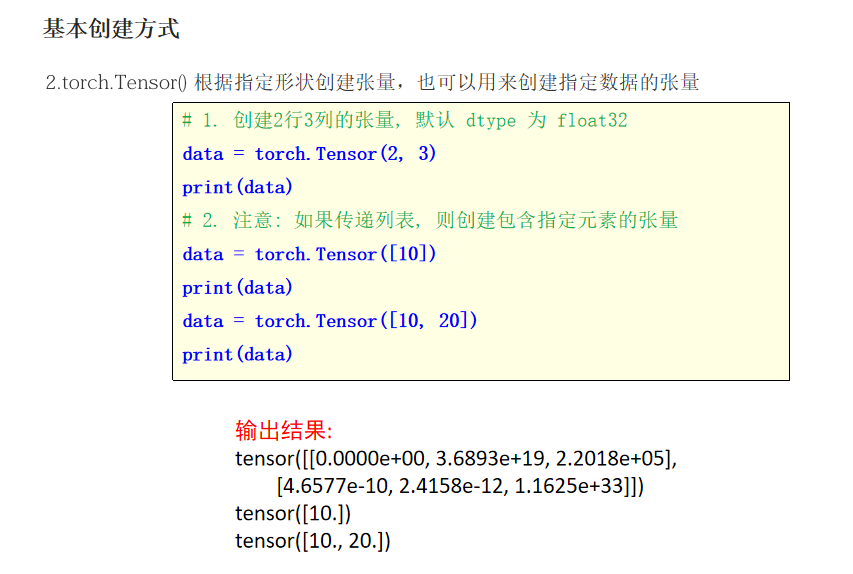
    torch.Tensor根据形状创建张量,其也可以用来创建指定数据的张量
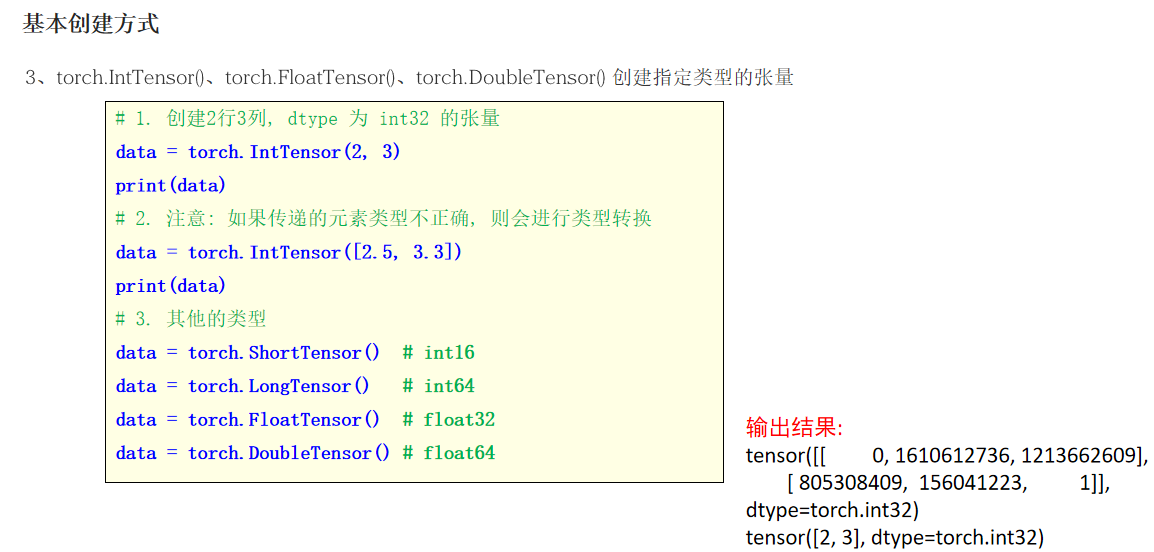
    torch.IntTensor\torch.FloatTensor\torch.DoubleTensor创建指定类型的张量
细节:
    Tensor方式较之于tensor方式,可以基于形状来直接创建张量
需要掌握的方式:
    tensor(值,类型),例如:
    data=no.random.randint(0,10,size=(3,4))
    t3=torch.tensor(data,dtype=torch.float32)
'''
#导包
import torch
import numpy as np
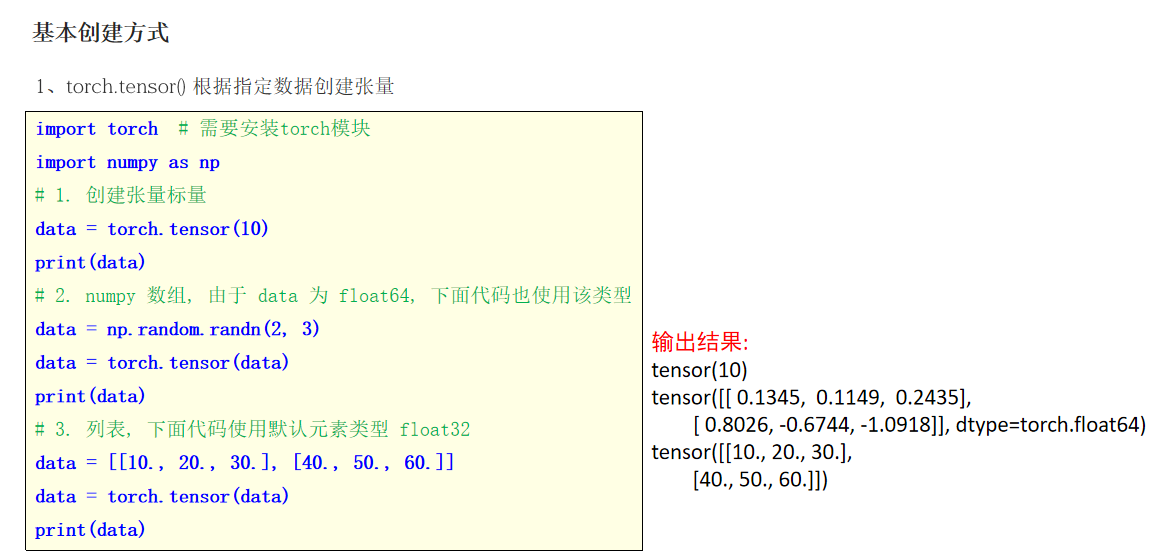
#1.定义函数,演示:torch.tensor根据指定数据创建张量
def dm01():
    #场景1:标量 张量
    t1=torch.tensor(10)
    print(f't1:{t1},type:{type(t1)}')
    print('-'*30)
    #场景2:二维列表->张量
    data=[[1,2,3],[4,5,6],[7,8,9]]
    t2=torch.tensor(data)
    print(f't2:{t2},type:{type(t2)}')
    print('-'*30)
    #场景3:numpy nd数组->张量
    data=np.random.randint(0,10,size=(3,4))
    t3=torch.tensor(data,dtype=torch.float32)
    print(f't3:{t3},type:{type(t3)}')
    print('-'*30)
    #场景4:尝试直接创建指定维度(例如:2行3列的)张量
    # t4=torch.tensor(2,3)#报错
    # print(f't4:{t4},type:{type(t4)}')
#2.定义函数,演示:torch.Tensor根据形状创建张量,其也可以用来创建指定数据的张量
def dm02():
    #场景1:标量 张量
    t1=torch.Tensor(10)
    print(f't1:{t1},type:{type(t1)}')
    print('-'*30)
    #场景2:二维列表->张量
    data=[[1,2,3],[4,5,6],[7,8,9]]
    t2=torch.Tensor(data)
    print(f't2:{t2},type:{type(t2)}')
    print('-'*30)
    #场景3:numpy nd数组->张量
    data=np.random.randint(0,10,size=(3,4))
    t3=torch.Tensor(data)
    print(f't3:{t3},type:{type(t3)}')
    print('-'*30)
    #场景4:尝试直接创建指定维度(例如:2行3列的)张量
    t4=torch.Tensor(2,3)
    print(f't4:{t4},type:{type(t4)}')
#3.定义函数演示
def dm03():
    #场景1:标量 张量
    t1=torch.IntTensor(10)
    print(f't1:{t1},type:{type(t1)}')
    print('-'*30)
    #场景2:二维列表->张量
    data=[[1,2,3],[4,5,6],[7,8,9]]
    t2=torch.IntTensor(data)
    print(f't2:{t2},type:{type(t2)}')
    print('-'*30)
    #场景3:numpy nd数组->张量
    data=np.random.randint(0,10,size=(3,4))
    t3=torch.IntTensor(data)
    print(f't3:{t3},type:{type(t3)}')
    print('-'*30)
    #场景4:尝试直接创建指定维度(例如:2行3列的)张量
    t4=torch.IntTensor(2,3)
    print(f't4:{t4},type:{type(t4)}')


#测试
if __name__ == '__main__':
    # dm01()
    # dm02()
    dm03()
'''
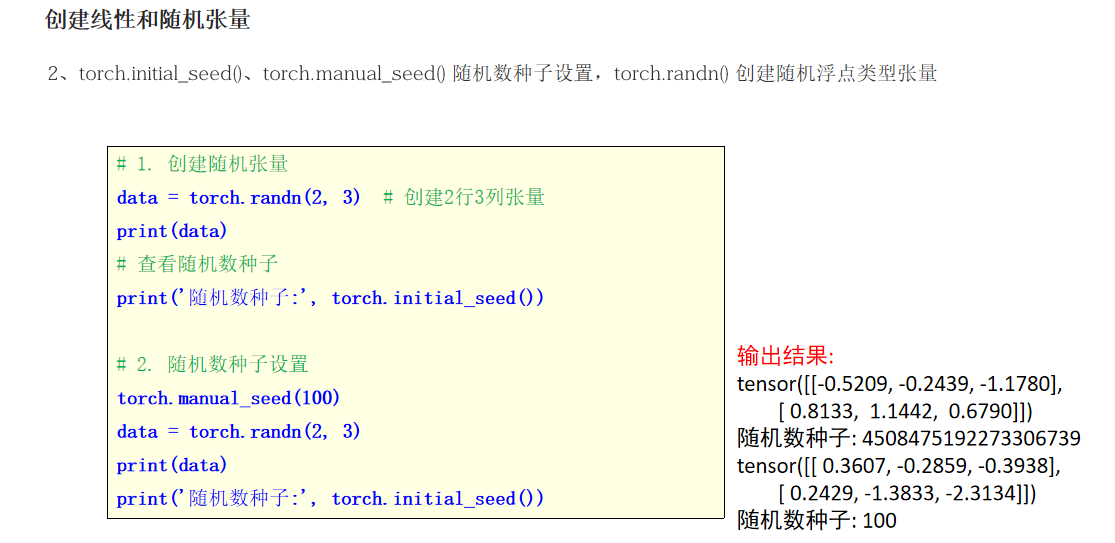
案例:演示Pytorch创建线性和随机张量
涉及的函数:
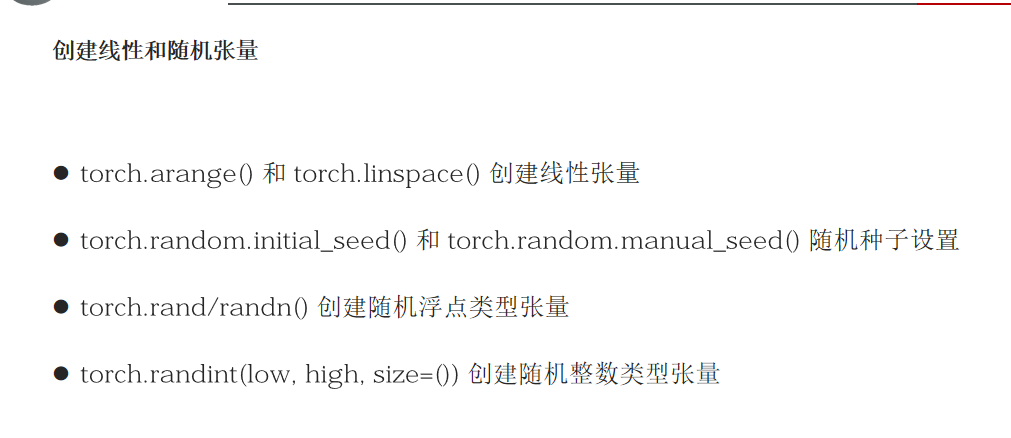
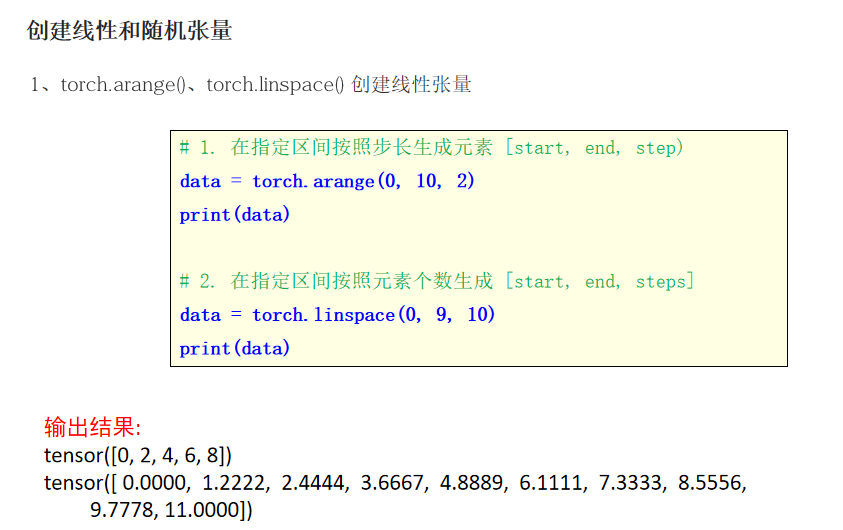
torch.arange()和torch.linspace()创建线性张量
torch.random.initial_seed()和torch.random.manual_seed()随机种子设置
torch.rand/randn()创建浮点类型张量
torch.randint(low,high,size=())创建随机整数张量
要掌握的函数:
    arange(),linspace(),manual_seed(),randint()
'''
#导包
import torch
#1.定义函数,演示:创建线性张量
def dm01():
    #场景1:创建指定范围的线性张量
    #参1:起始值 参数2:结束值 参数3:步长
    t1=torch.arange(1,10,2)
    print(f't1:{t1},type:{type(t1)}')
    print('-'*30)
    #场景2:创建指定范围的线性张量->等差数列
    #参1:起始值 参数2:结束值 参数3:元素个数
    t2=torch.linspace(1,10,4)
    print(f't2:{t2},type:{type(t2)}')
    print('-'*30)
#2.定义函数:演示:创建随机张量
def dm02():
    #step1:设置随机种子
    # torch.initial_seed()#默认种子采用当前系统的时间戳作为随机种子
    torch.random.manual_seed(1)#设置随机种子,那么每次运行结果都相同,这个最常用
    #step2:创建随机张量
    #场景1:均匀分布的(0,1)随机张量
    t1=torch.rand(size=(2,3))#创建2行3列的随机张量
    print(f't1:{t1},type:{type(t1)}')
    print('-'*30)
    #场景2:正态分布的(0,1)随机张量
    t2=torch.randn(size=(2,3))#创建2行3列的随机张量
    print(f't2:{t2},type:{type(t2)}')
    print('-'*30)
    #场景3:随机整数张量
    t3=torch.randint(low=0,high=10,size=(2,3))#创建2行3列的随机整数张量
    print(f't3:{t3},type:{type(t3)}')
    print('-'*30)
   #测试函数
if __name__=='__main__':
    # dm01()
    dm02()
'''
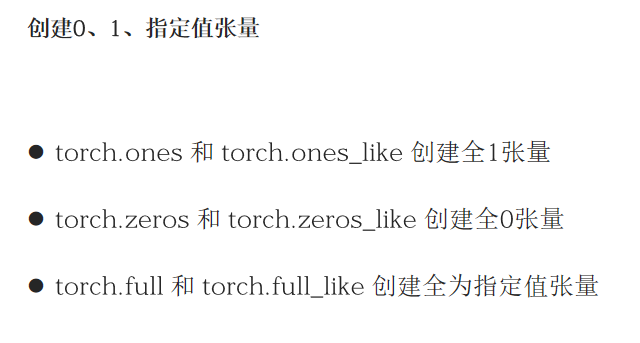
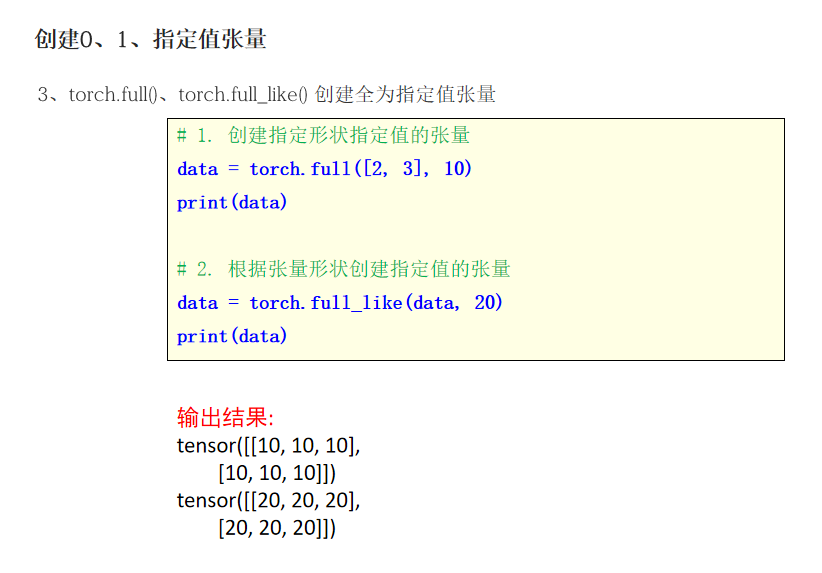
案例:演示如何创建全0,全1,指定值的张量
涉及到的函数
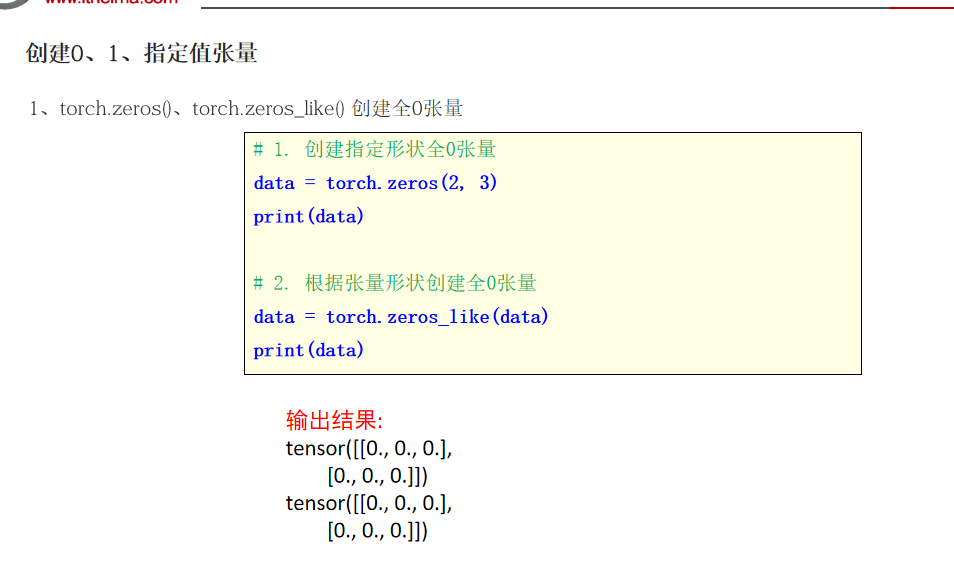
    torch.zeros和torch.zeros_like创建全0的张量
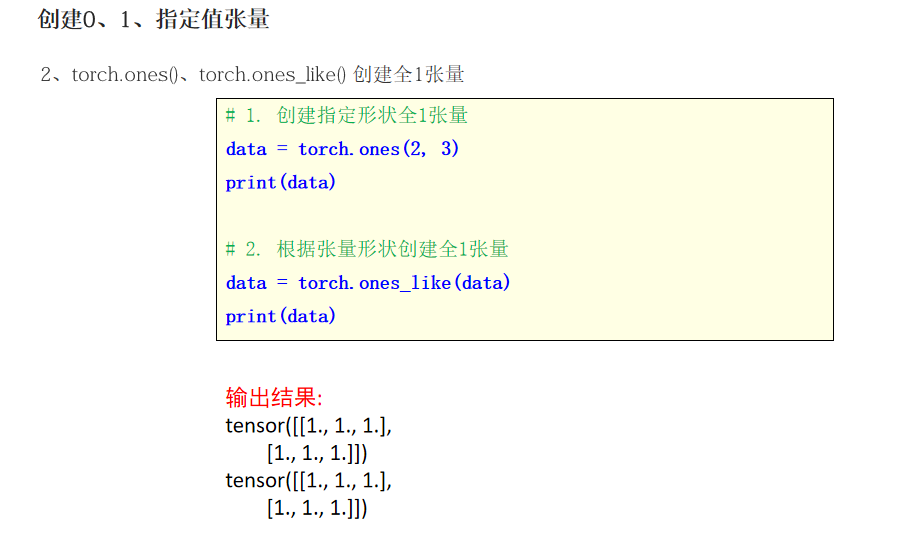
    torch.ones和torch.ones_like创建全1的张量
    torch.full和torch.full_like创建全为指定值的张量
需要掌握的函数:
    zeros(),full()
'''
import torch
#场景1:torch.ones和torch.ones_like创建全1的张量
t1=torch.ones(size=(2,3))#创建2行3列的全1张量
print(f't1:{t1},type:{type(t1)}')
print('-'*30)
#t2:3行2列
t2=torch.tensor([[1,2],[4,5],[7,8]])
print(f't2:{t2},type:{type(t2)}')
print('-'*30)
#t3->基于t2的形状,创建全1张量
t3=torch.ones_like(t2)
print(f't3:{t3},type:{type(t3)}')
print('-'*30)
#场景2:torch.zeros和torch.zeros_like创建全0的张量
t1=torch.zeros(size=(2,3))#创建2行3列的全0张量
print(f't1:{t1},type:{type(t1)}')
print('-'*30)
#t2:3行2列
print(f't2:{t2},type:{type(t2)}')
print('-'*30)
#t3->基于t2的形状,创建全0张量
t3=torch.zeros_like(t2)
print(f't3:{t3},type:{type(t3)}')
print('-'*30)
t2=torch.tensor([[1,2],[4,5],[7,8]])
#场景3:torch.full和torch.full_like创建全为指定值的张量
t1=torch.full(size=(2,3),fill_value=255)#创建2行3列的全255张量
print(f't1:{t1},type:{type(t1)}')
print('-'*30)
#t2:3行2列
print(f't2:{t2},type:{type(t2)}')
print('-'*30)
#t3->基于t2的形状,创建全255张量
t3=torch.full_like(t2,fill_value=255)
print(f't3:{t3},type:{type(t3)}')
print('-'*30)
'''
案例:创建指定类型的张量
涉及到的函数:
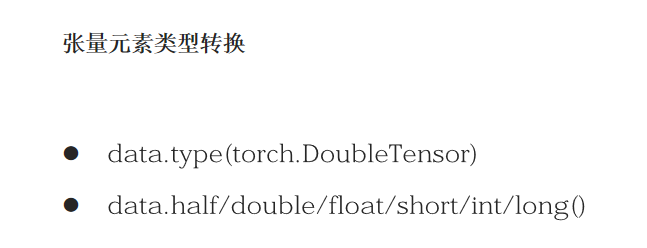
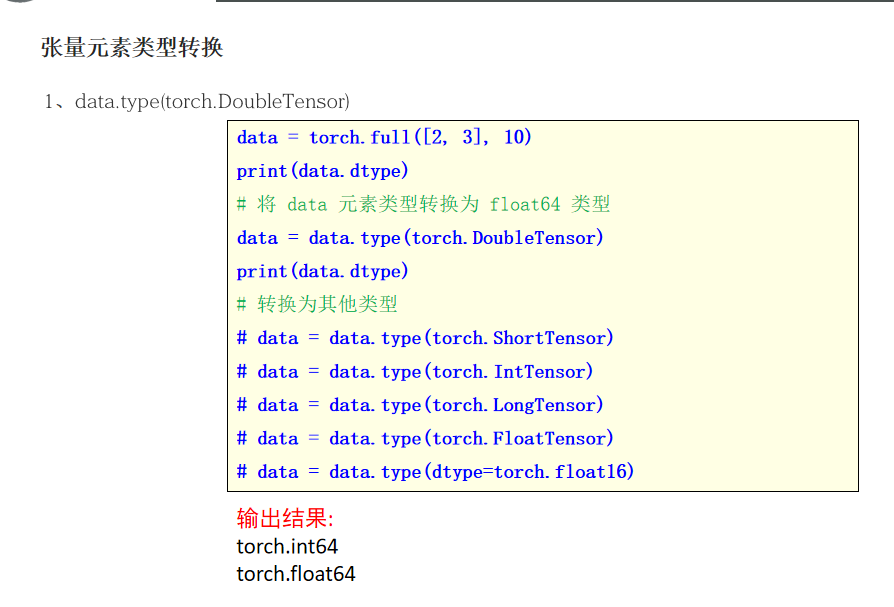
    type(torch支持的数据类型)
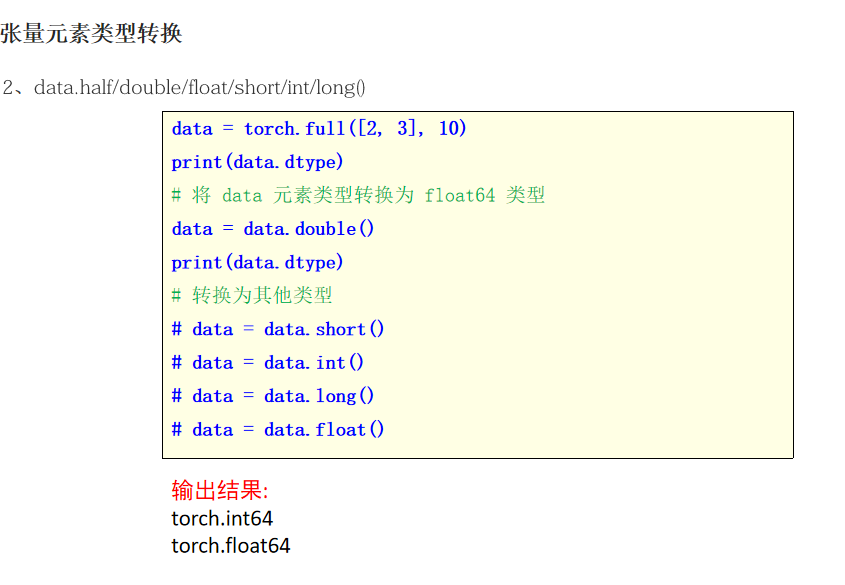
    half()/float()/double()/int()/long()
要掌握的函数:type()
'''
#导包
import torch
#场景1:直接创建指定类型的张量
t1=torch.tensor([1,2,3,4,5],dtype=torch.float)#默认是float32
print(f't1:{t1},type:{type(t1)}')
print('-'*30)
#场景2:创建好张量后->做类型转换
#思路1:直接调用type()函数,推荐掌握
t2=t1.type(torch.long)
print(f't2: {t2}, (元素)类型: {t2.dtype}, (张量)类型: {type(t2)}')
print('-'*30)
#思路2:half()/float()/double()/int()/long()
print(t1.half())#float16
print(t1.float())#float32默认
print(t1.double())#float64
print(t1.int())#int32
print(t1.long())#int64默认
print(t1.short())#int16
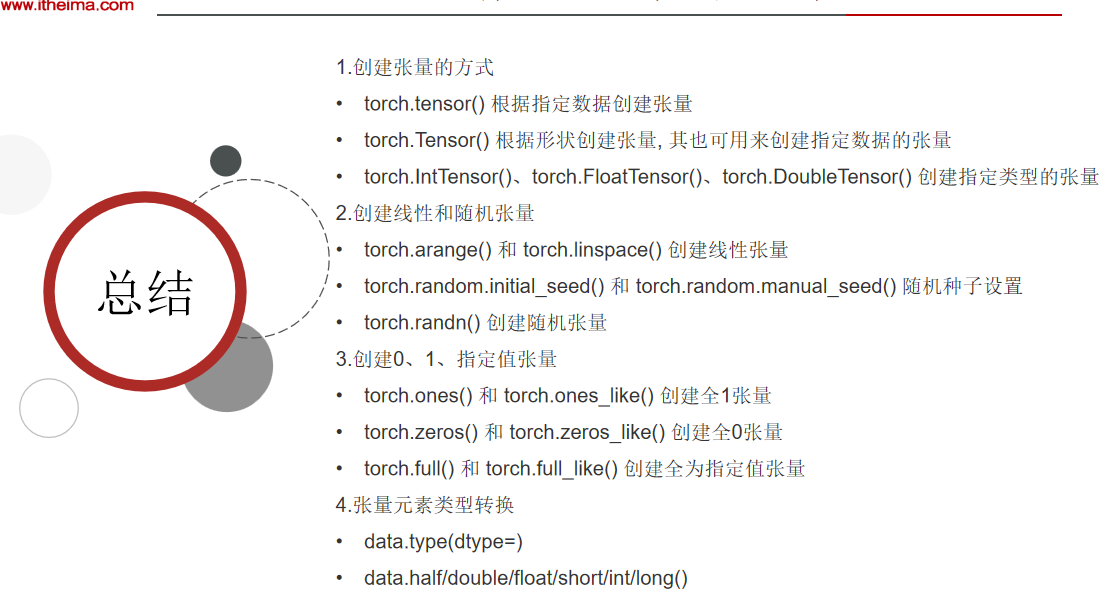
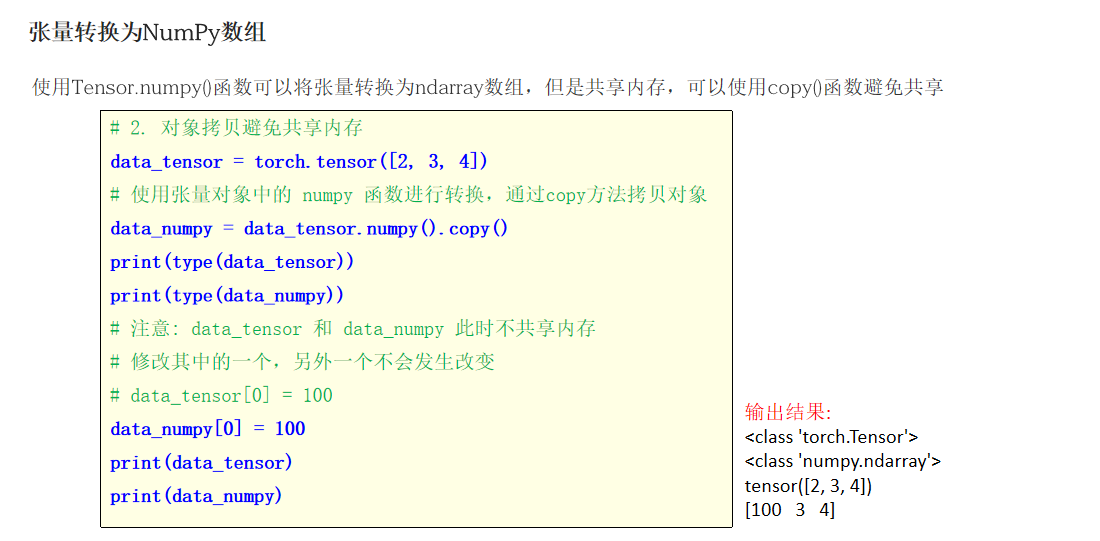
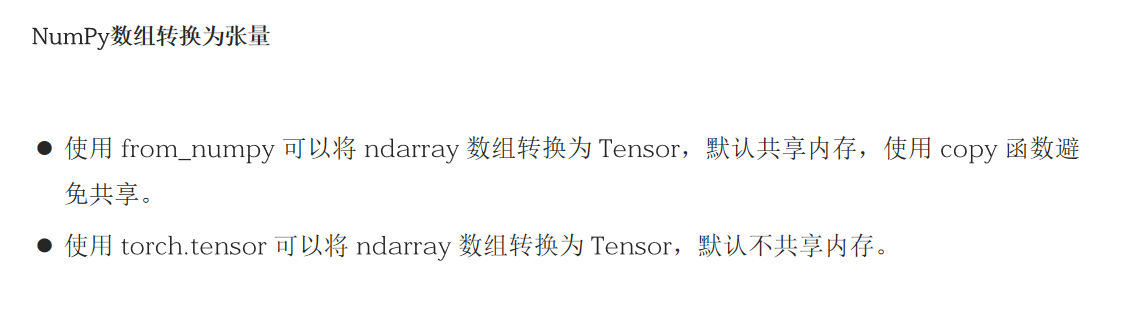
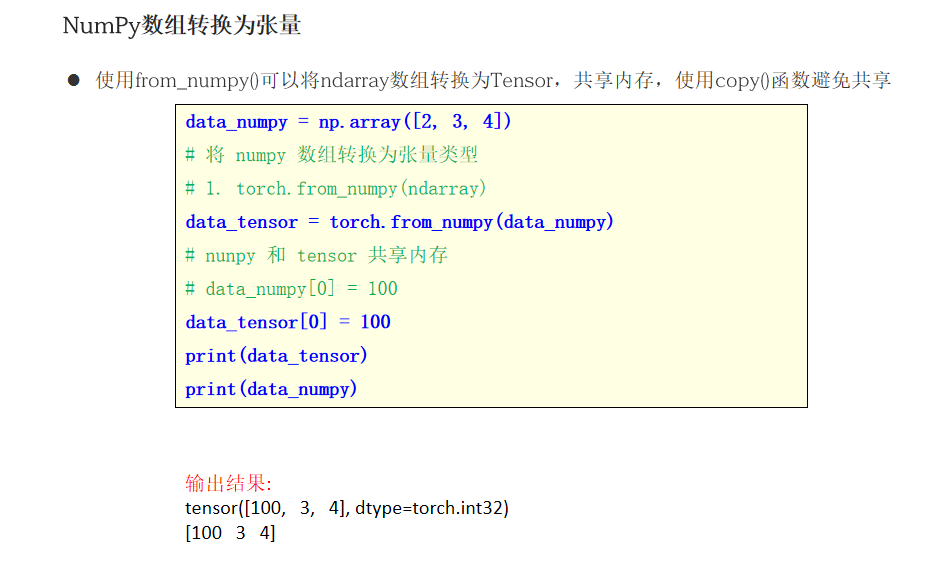
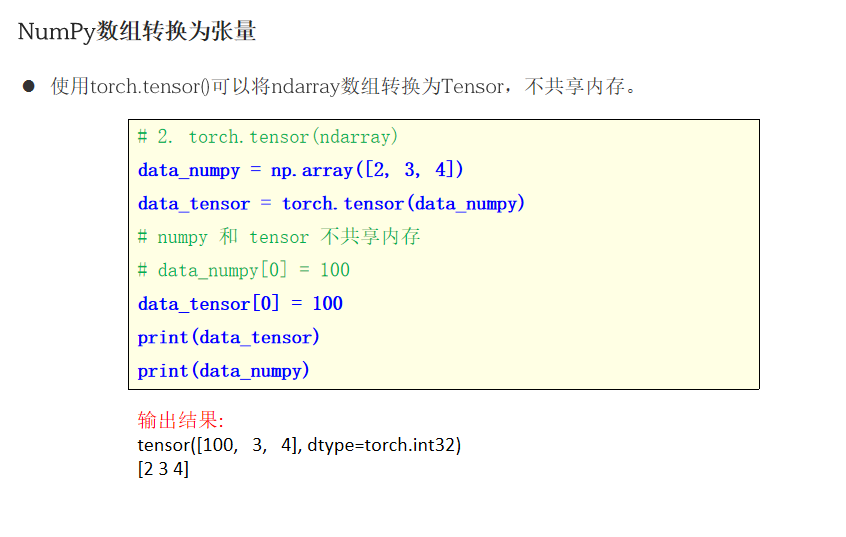
张量的类型转换
浅拷贝:共享内存,深拷贝:不共享
'''
案例:演示张量和numpy之间的转换,以及 如何从标量张量中提取内容
涉及到的API:
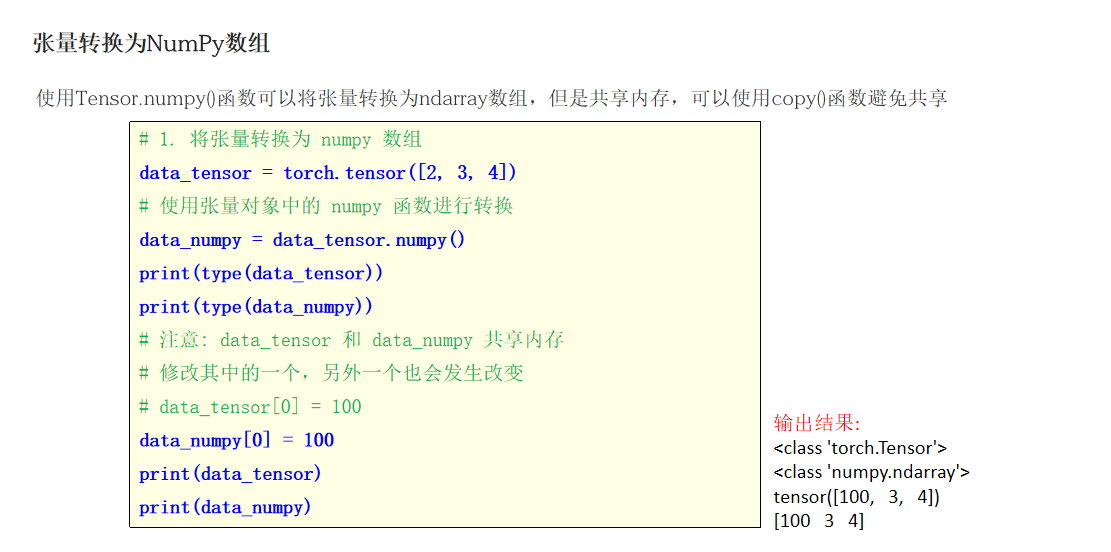
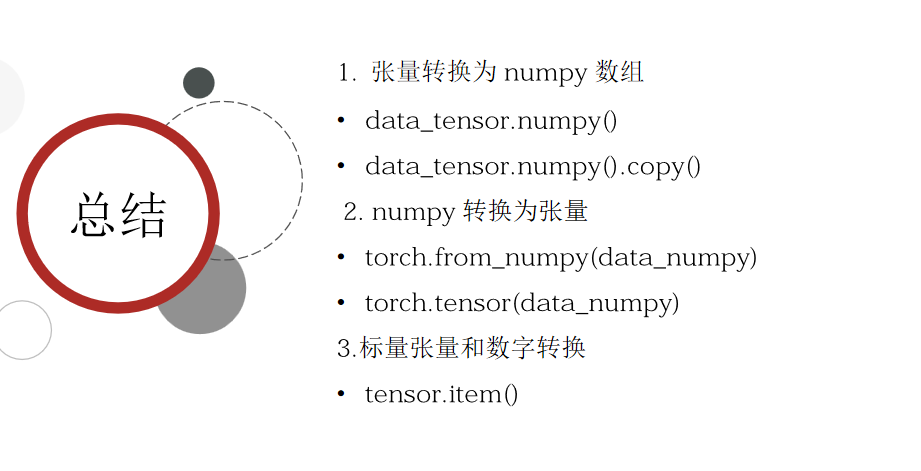
    #场景1:张量->numpy nd数组对象
    张量对象.numpy()   共享内存
    张量对象.numpy().copy() 不共享内存
    #场景2:numpy nd数组对象->张量
    from_numpy()      共享内存
    torch.tensor()      不共享内存
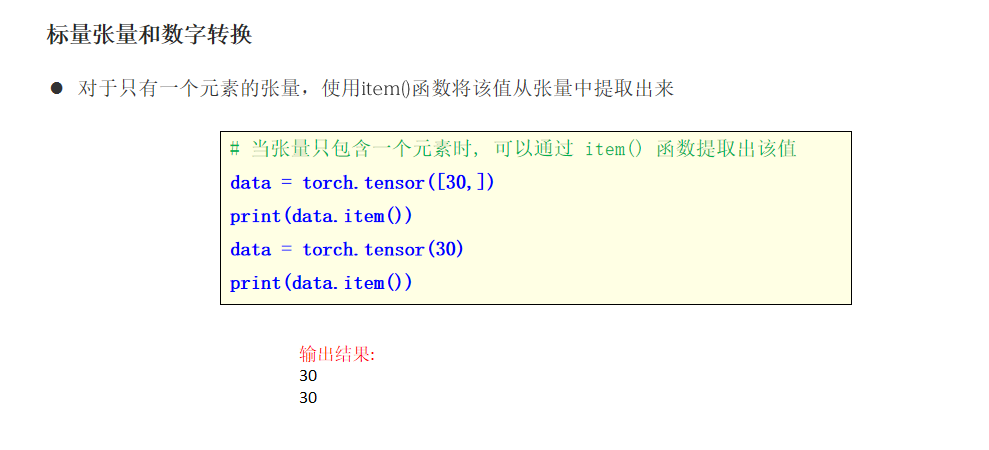
    #场景3:从标量张量中提取内容
    标量张量对象.item()
掌握:
    张量->numpy nd数组对象.numpy()
    numpy nd数组对象->张量:torch.tensor()
    从标量张量中提取内容:标量张量对象.item()
'''
import numpy as np
import torch
#1.定义函数,演示:张量->numpy nd数组对象
def dm01():
    #1.创建张量
    t1=torch.tensor([1,2,3])
    print(f't1: {t1}, (元素)类型: {t1.dtype}, (张量)类型: {type(t1)}')
    #2.将张量转换为numpy nd数组对象
    # n1=t1.numpy()#共享内存
    n1=t1.numpy().copy()#不共享内存
    print(f'n1: {n1}, (元素)类型: {n1.dtype}, (数组)类型: {type(n1)}')
    #3.验证是否共享内存
    n1[0]=100
    print(f'n1: {n1}')#[100 2 3]
    print(f't1: {t1}')#[1,2,3]

#2.定义函数,演示:numpy nd数组对象->张量
def dm02():
    #1.创建numpy数组
    n1=np.array([1,2,3])
    print(f'n1: {n1}, (元素)类型: {n1.dtype}, (数组)类型: {type(n1)}')
    #2.把上述的numpy数组,转换成张量
    # t1=torch.from_numpy(n1).type(torch.float)#转换+类型转换
    t1=torch.from_numpy(n1)#共享内存
    print(f't1: {t1}, (元素)类型: {t1.dtype}, (张量)类型: {type(t1)}')
    t2=torch.tensor(n1)#不共享内存
    print(f't2: {t2}, (元素)类型: {t2.dtype}, (张量)类型: {type(t2)}')
    #3.验证是否共享内存
    n1[0]=100
    print(f'n1: {n1}')#[100 2 3]
    print(f't1: {t1}')#[100,2,3]
    print(f't2: {t2}')#[1,2,3]
#3.定义函数,演示:从标量张量中提取内容
def dm03():
    #1.创建标量张量
    t1=torch.tensor(100)
    # t1=torch.tensor([1,])#可以
    # t1=torch.tensor([1,2])#不可以
    print(f't1: {t1}, (元素)类型: {t1.dtype}, (张量)类型: {type(t1)}')
    #2.从标量张量中提取内容
    a=t1.numpy()
    print(f'a: {a}')#[100]
#4.测试函数
if __name__=='__main__':
    # dm01()
    # dm02()
    dm03()
张量数值计算
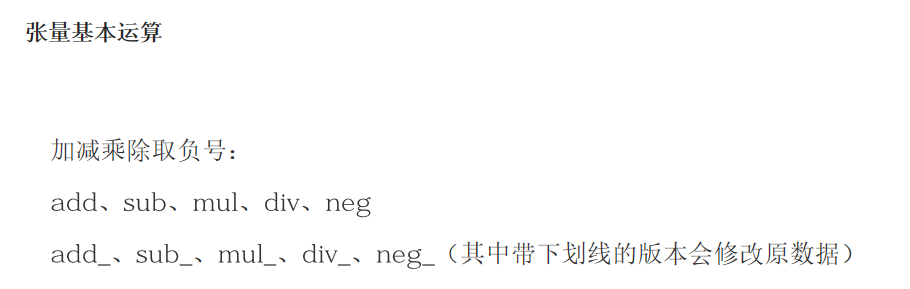
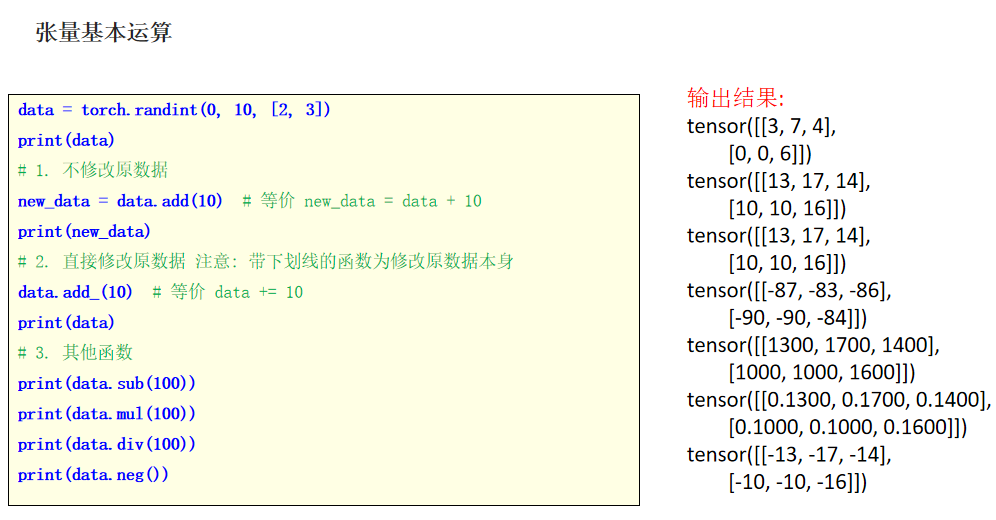
"""
案例:
    演示张量的基本运算.

涉及到的API:
    add(), sub(), mul(), div(), neg()       -> 加减乘除, 取反, substract, multiply, divide
    add_(), sub_(), mul_(), div_(), neg_()  -> 功能同上, 只不过可以修改源数据, 类似于 Pandas部分的 inplace = True

需要你记忆的:
    1. 可以用 +, -, *, / 符号来替代 上述的 加减乘除函数.
    2. 如果是张量 和 数值运算, 则: 该数值会和张量中的每个值依次进行 对应的运算.
"""

# 导包
import torch

# 1. 创建张量.
t1 = torch.tensor([1, 2, 3])

# 2. 演示 加法.
# t2 = t1.add(10)      # 不会修改源数据.
# t2 = t1 + 10         # 效果同上.

# t1.add_(10)            # 会修改源数据.
# t1 += 10               # 效果同上


# 其它函数效果同上, 这里就快速演示了.
# t2 = t1.sub(1)      # 减法
# t2 = t1.mul(2)      # 乘法
# t2 = t1.div(2)      # 除法, [0.5000, 1.0000, 1.5000]
t2 = t1.neg()         # 取反


# 3. 打印结果.
print(f't1: {t1}')
print(f't2: {t2}')
"""
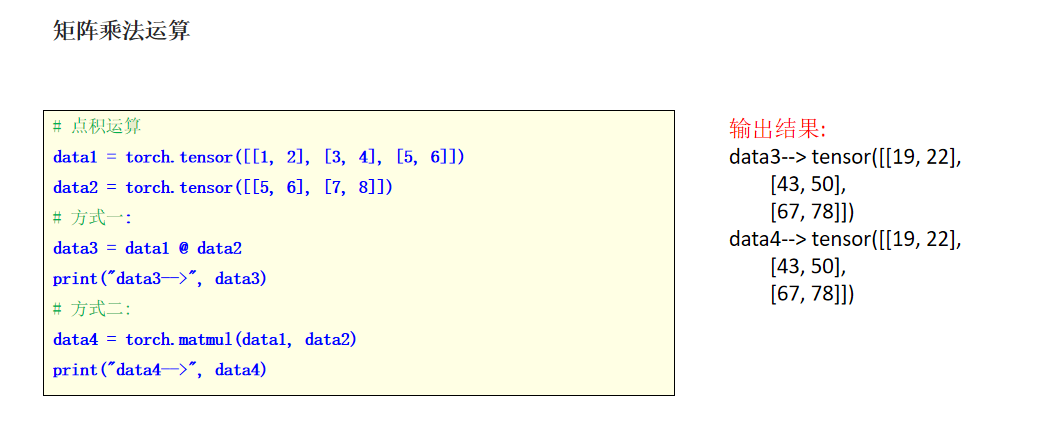
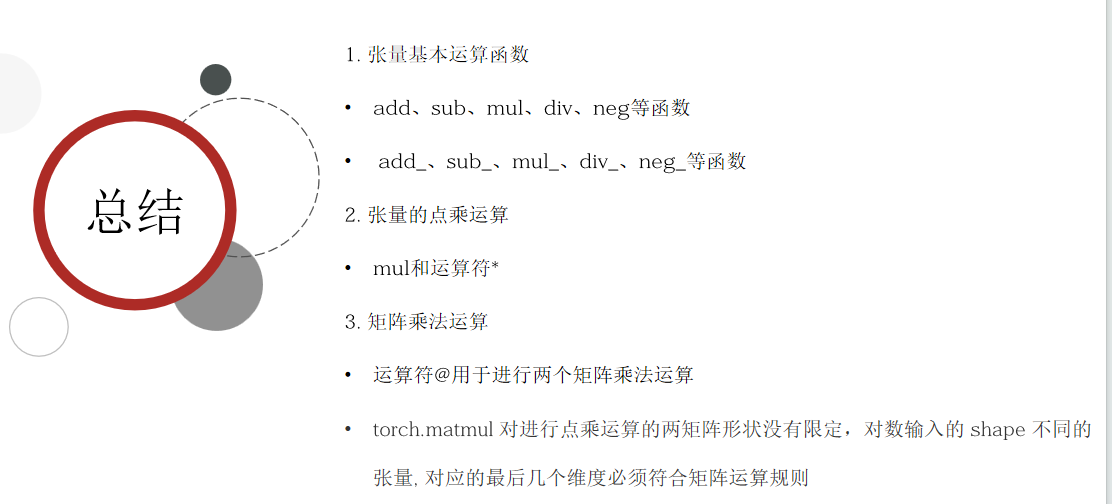
案例:
    演示张量的点乘 和 矩阵乘法操作.

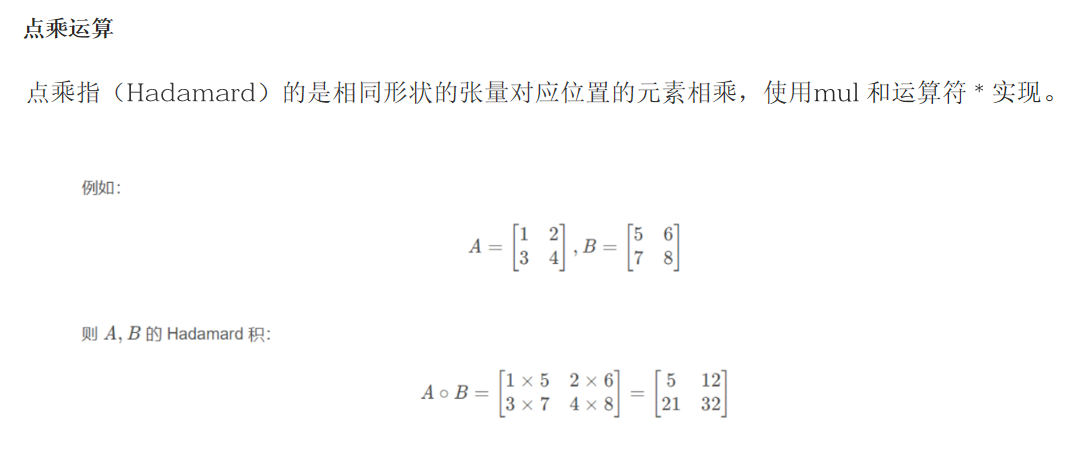
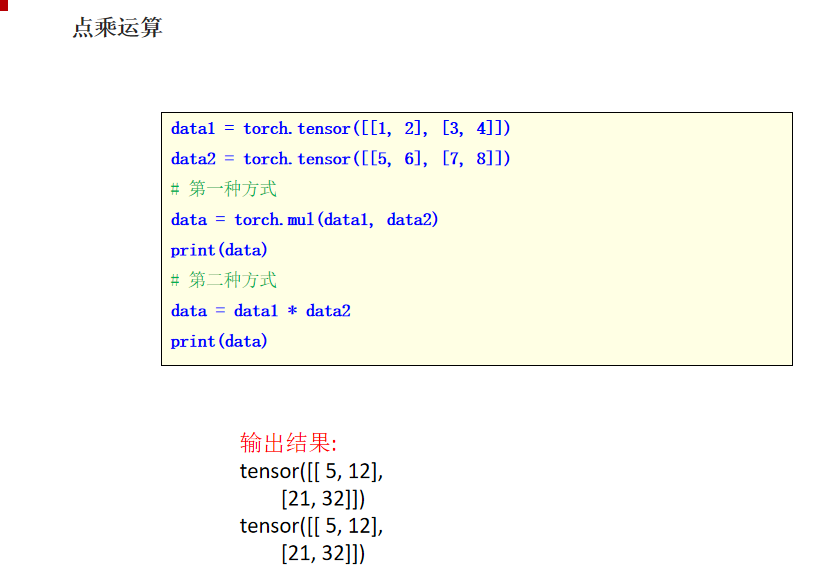
点乘:
    要求: 两个张量的维度保持一致, 对应元素直接做 乘法操作.
    API:
        t1 * t2
        t1.mul(t2)          # multiply: 乘法

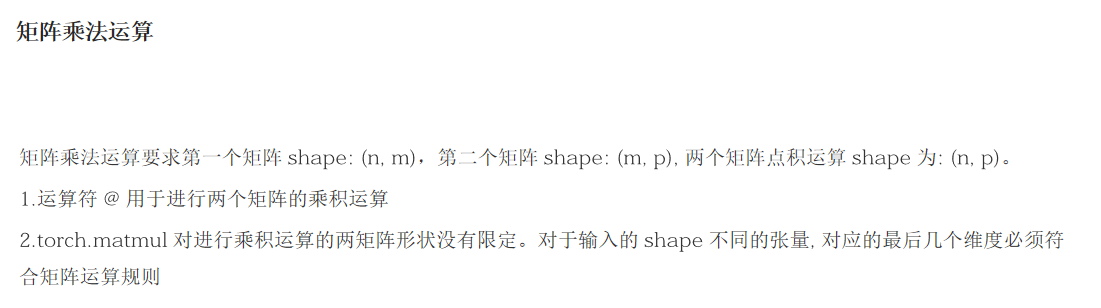
矩阵乘法:
    要求: 两个张量, 第一个张量 的列数, 等于 第二个张量 的行数(A列 = B行)
    结果: A行B列
    API:
        t1 @ t2
        t1.matmul(t2)
        t1.dot(t2)          扩展: 只针对于一维张量有效.
"""

# 导包
import torch

# 1. 定义函数, 演示张量: 点乘
def dm01():
    # 1. 定义张量, 2行3列.
    t1 = torch.tensor([[1, 2, 3], [4, 5, 6]])
    print(f't1: {t1}')

    # 2. 定义张量, 2行3列.
    t2 = torch.tensor([[1, 2, 3], [4, 5, 6]])
    print(f't2: {t2}')

    # 3. 演示 张量 点乘操作.
    # t3 = t1 * t2
    t3 = t1.mul(t2)     # 效果同上.

    # 4. 打印结果.
    print(f't3: {t3}')


# 2. 定义函数, 演示张量: 矩阵乘法
def dm02():
    # 条件: A列=B行, 结果: A行B列
    # 1. 定义张量, 2行3列.
    t1 = torch.tensor([[1, 2, 3], [4, 5, 6]])
    print(f't1: {t1}')

    # 2. 定义张量, 3行2列.
    t2 = torch.tensor([[1, 2], [3, 4], [5, 6]])
    print(f't2: {t2}')

    # 3. 演示 张量 矩阵乘法操作.
    t3 = t1 @ t2
    # t3 = t1.matmul(t2)  # 效果同上, matrix multiply(矩阵乘法)

    # 4. 打印结果.
    print(f't3: {t3}')

    # 5. 演示 dot()函数.
    # t3 = t1.dot(t2)       # 报错, dot() 只针对于一维张量有效.
    t4 = torch.tensor([1, 2, 3])
    t5 = torch.tensor([4, 5, 6])
    t6 = t4.dot(t5)
    print(f't6: {t6}')


# 3. 测试.
if __name__ == '__main__':
    # dm01()
    dm02()
张量运算函数
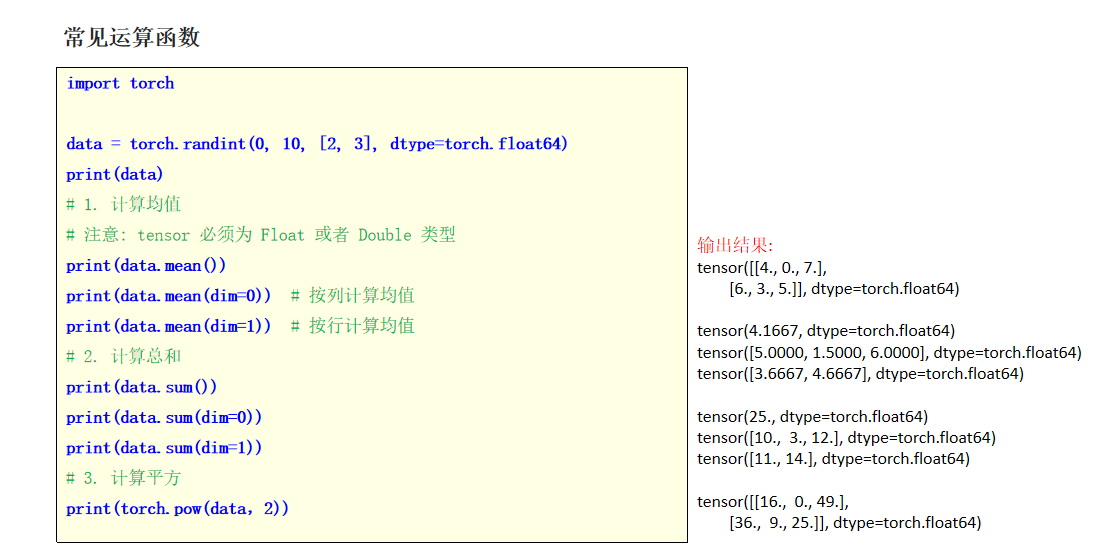
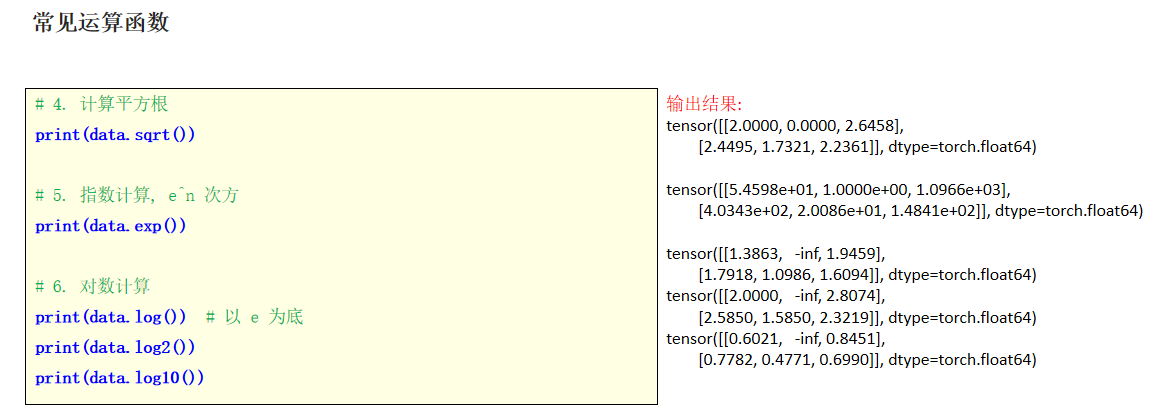
"""
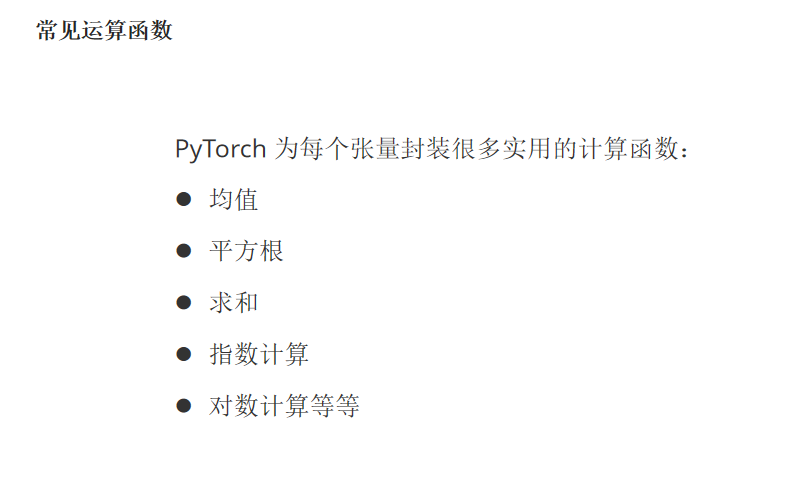
案例:
    演示张量常用的运算函数.
涉及到的 API(函数) 如下:
    sum(), max(), min(), mean()                     -> 都有 dim 参数, 0表示列, 1表示行
    pow(), sqrt(), exp(), log(), log2(), log10()    -> 没有dim参数
掌握的函数:
    sum(), max(), min(), mean()
"""
# 导包
import torch

# 1. 定义张量, 记录初值.
t1 = torch.tensor([
    [1, 2, 3],
    [4, 5, 6]
], dtype=torch.float)
print(f't1: {t1}')

# 2. 演示 有dim参数的 函数.
# sum() 求和
print(t1.sum(dim=0))        # 按 列 求和
print(t1.sum(dim=1))        # 按 行 求和
print(t1.sum())             # 整 体 求和
print('-' * 30)

# max()求最大值, min()同理, 这里就不演示了.
print(t1.max(dim=0))        # 按 列 求最大值
print(t1.max(dim=1))        # 按 行 求最大值
print(t1.max())             # 整 体 求最大值
print('-' * 30)

# mean(), 计算平均值
print(t1.mean(dim=0))        # 按 列 求平均值
print(t1.mean(dim=1))        # 按 行 求平均值
print(t1.mean())             # 整 体 求平均值
print('*' * 30)

# 3. 演示 没有dim参数的 函数.
# pow() n次幂
print(t1.pow(2))            # 每个数的平方
print(t1.pow(3))            # 每个数的立方
print(t1 ** 3)              # 效果同上.
print('-' * 30)

# sqrt() 平方根
print(t1.sqrt())            # 每个数的平方根
print('-' * 30)

# exp() e的n次幂,  n就是矩阵中的每个元素, 这里是: e^1, e^2, e^3, e^4, e^5, e^6
print(t1.exp())
print('-' * 30)

# log(), log2(), log10()  对数
print(t1.log())
print(t1.log2())
print(t1.log10())
张量索引操作
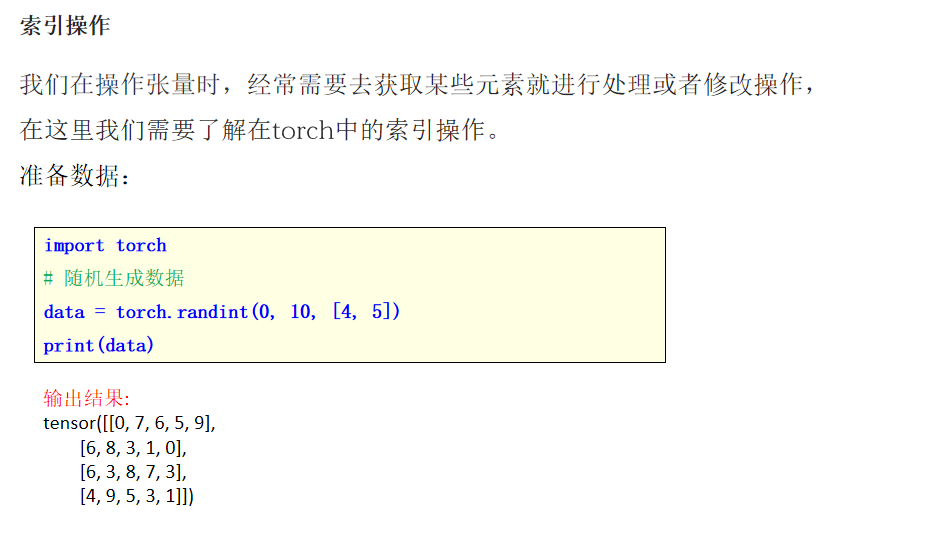
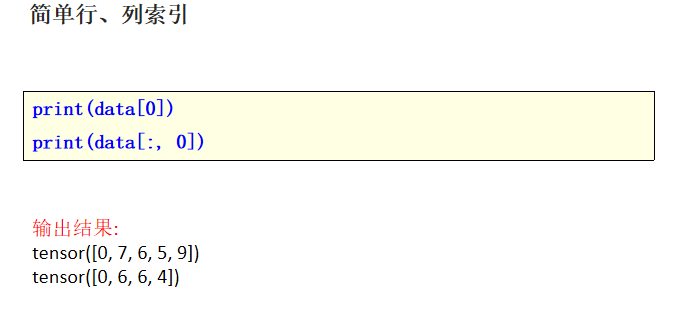
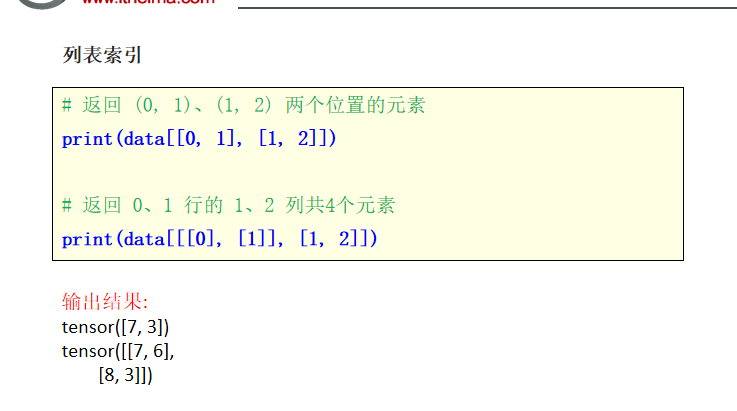
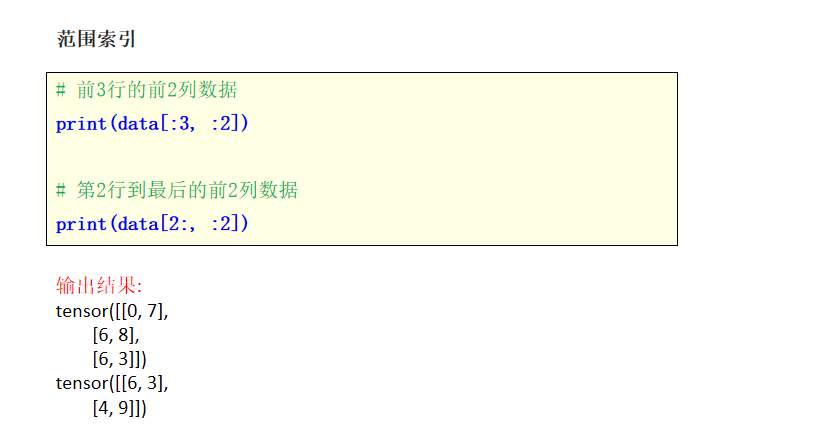
"""
案例:
    演示 张量的 索引操作.

分类:
    简单行列索引
    列表索引
    范围索引
    布尔索引
    多维索引

掌握:
    简单行列索引, 范围索引, 多维索引.
"""
# 导包
import torch

# 1. 设置随机种子.
torch.manual_seed(24)

# 2. 创建随机张量.
t1 = torch.randint(1, 10, (5, 5))
print(f't1: {t1}')
print('-' * 30)

# 3. 演示张量的索引操作.
# 场景1: 简单行列索引, 格式: 张量对象[行, 列]
# 需求1: 获取第2行的数据.
print(t1[1])
print(t1[1, :])  # 效果同上, 这里的:表示 所有列

# 需求2: 所有行的第3列数据
print(t1[:, 2])
print('-' * 30)

# 场景2: 列表索引, 前边的表示行, 后边的表示列.
# 需求1: 返回(0, 1), (1, 2)两个位置的元素.
print(t1[[0, 1], [1, 2]])

# 需求2: 返回(1, 2), (3, 4)两个位置的元素.
print(t1[[1, 3], [2, 4]])

# 需求3: 获取第0, 1行的 1, 2列共4个元素.
print(t1[[[0], [1]], [1, 2]])
print('-' * 30)

# 场景3: 范围索引
# 需求1: 前3行, 前2列.
print(t1[:3, :2])

# 需求2: 第2行到最后一行, 前2列的数据.
print(t1[1:, :2])

# 需求3: 所有奇数行, 偶数列.
print(t1[1::2, ::2])
print('-' * 30)

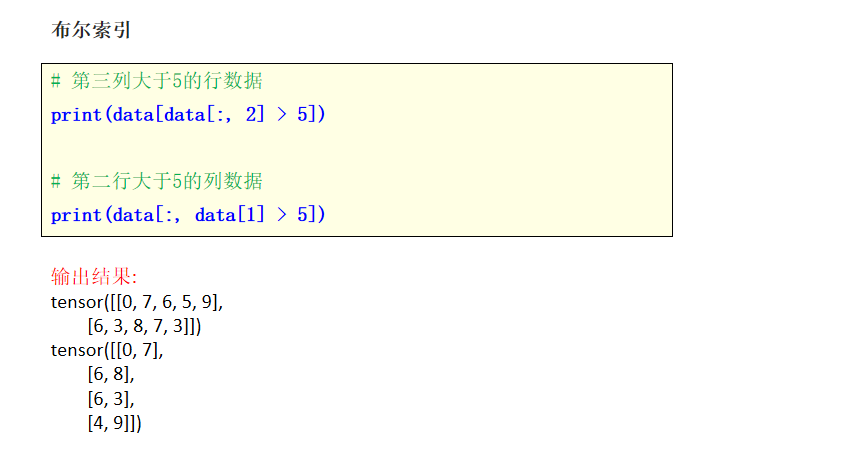
# 场景4: 布尔索引
# print(t1[torch.tensor([True, False, False, True, True]), :])    # 演示布尔写法, 看看就好.

# 需求1: 第3列 大于5的行数据.
print(t1[t1[:, 2] > 5])

# 需求2: 第2行大于5的 列数据.
# 理解1: 在第2行基础上 找到该行中大于5的列索引, 然后找所有行中对应列的元素.
print(t1[:, t1[1, :] > 5])
print(t1[:, t1[1] > 5])     # 效果同上.

# 理解2: 在第2行的基础上, 找该行所有列中大于5的元素
print(t1[1, t1[1, :] > 5])
print('-' * 30)


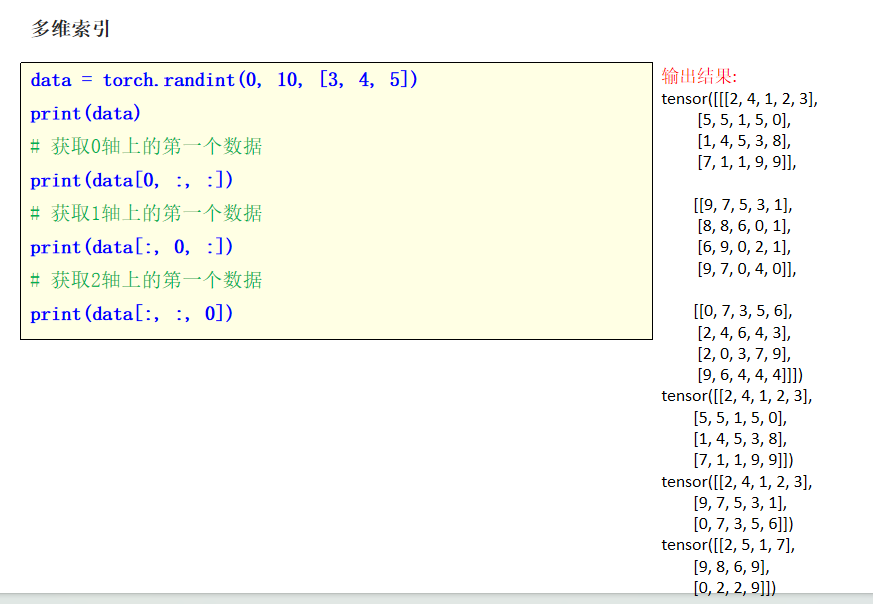
# 场景5: 多维索引
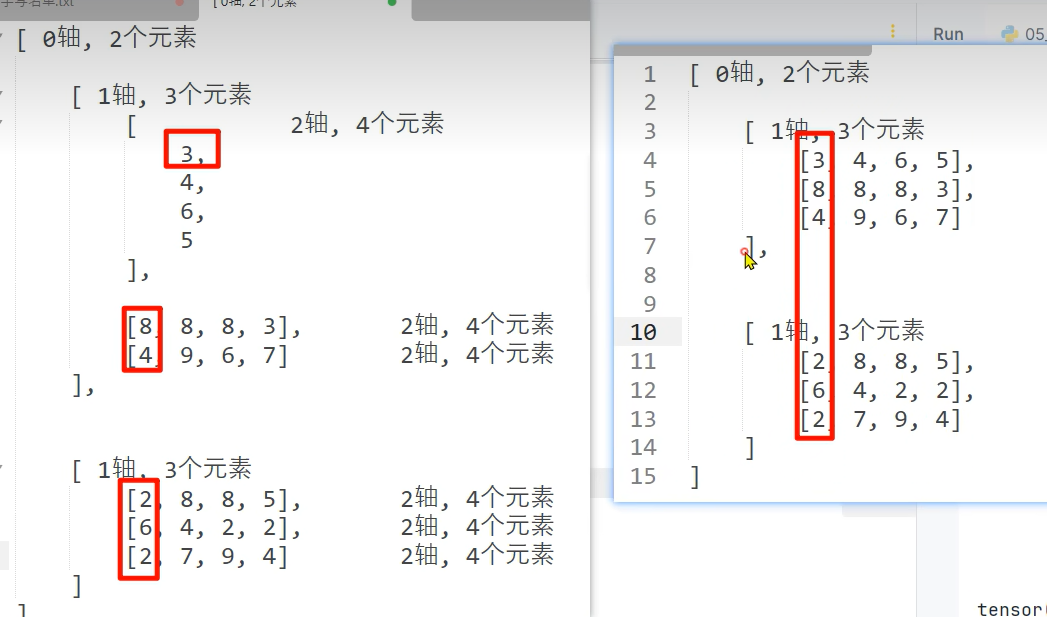
# 创建3维张量, 即: 2个3行4列的矩阵.
t2 = torch.randint(1, 10, (2, 3, 4))
print(f't2: {t2}')

# 需求1: 获取0轴上的第1个数据.
print(t2[0, :, :])

# 需求2: 获取1轴上的第1个数据.
print(t2[:, 0, :])

# 需求3: 获取2轴上的第1个数据.
print(t2[:, :, 0])
张量形状操作
"""
案例:
    演示张量的形状操作.

涉及到的API:
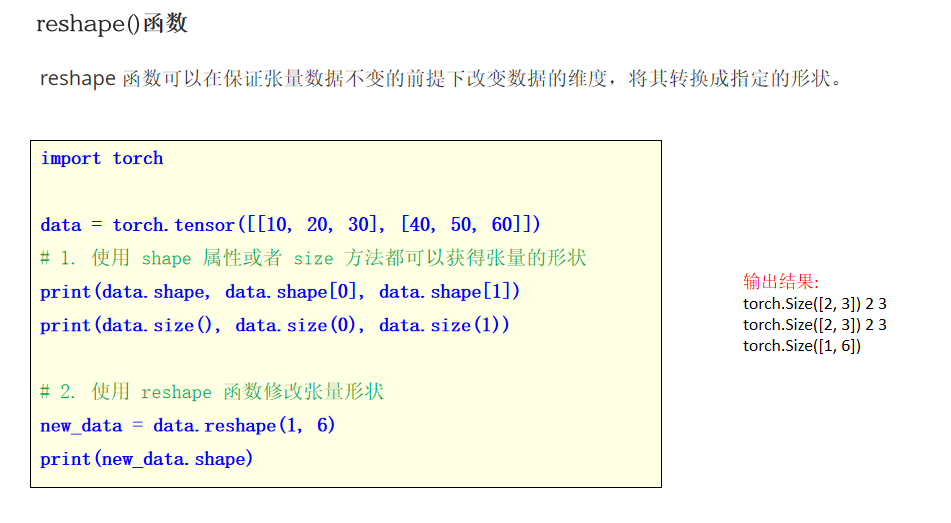
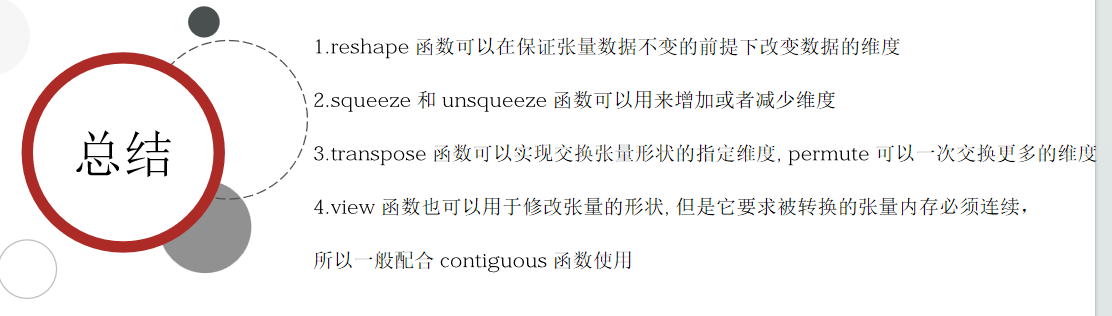
    reshape():      在不改变张量内容的前提下, 对其形状做改变.
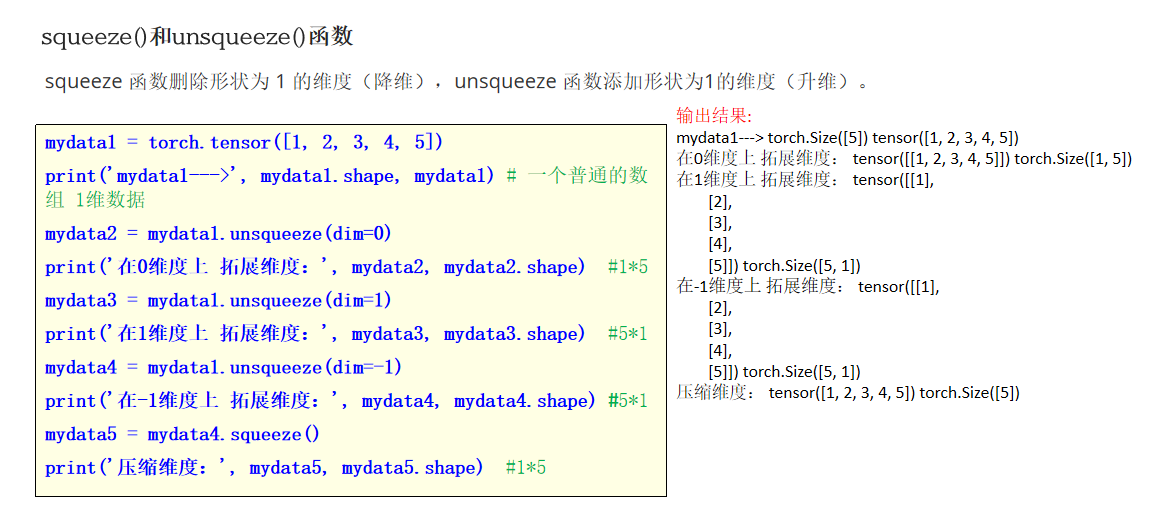
    unsqueeze()     在指定的轴上增加一个(1)维度, 等价于: 升维.
    squeeze()       删除所有为1的维度, 等价于: 降维.
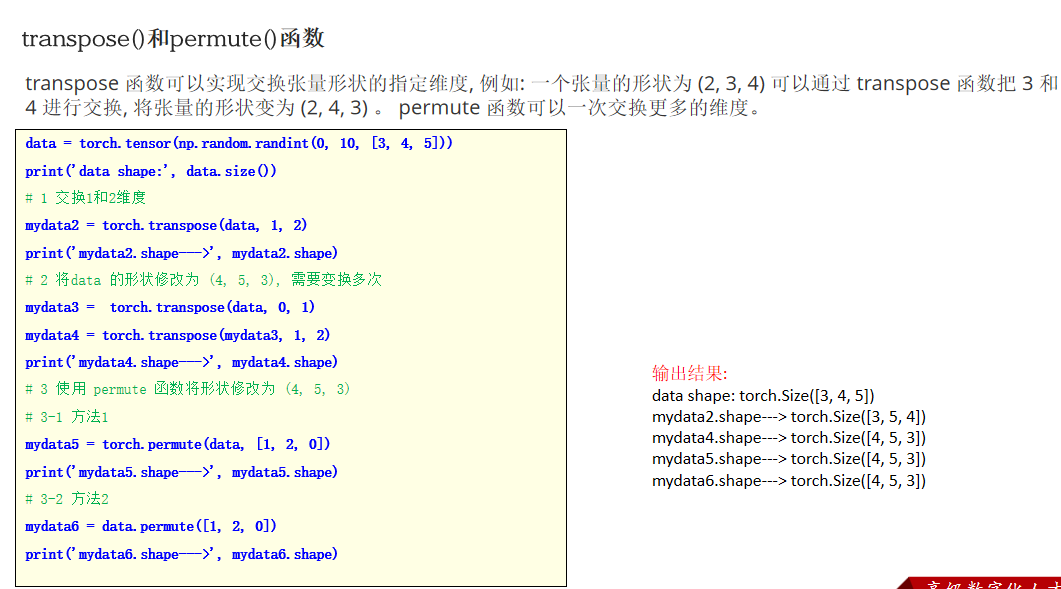
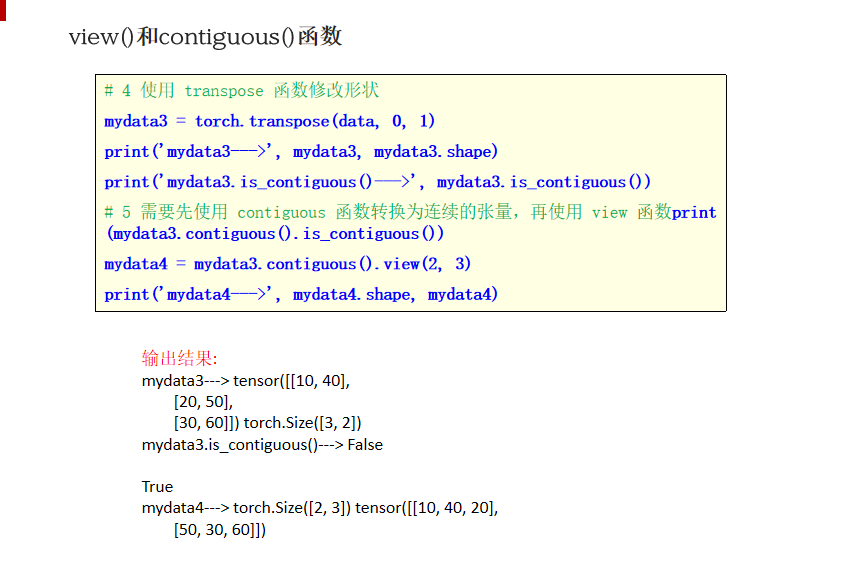
    transpose()     一次只能交换2个维度.
    permute()       一次可以同时交换多个维度.
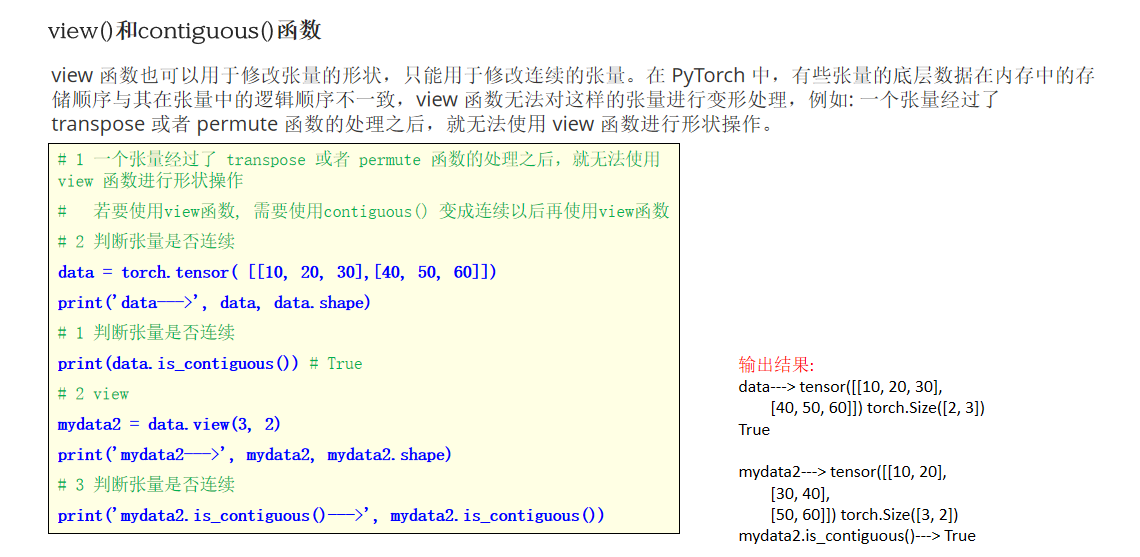
    view()          只能修改连续的张量的形状,  连续张量 = 内存中存储顺序 和 在张量中显示的顺序相同.
    contiguous()    把不连续的张量 -> 连续的张量, 即: 基于张量中显示的顺序, 修改内存中的存储顺序.
    is_contiguous() 判断张量是否是连续的.

需要你掌握的函数:
    reshape(), unsqueeze(), permute(), view()
"""

# 导包
import torch

# 指定随机种子
torch.manual_seed(24)

# 1. 定义函数, 演示: reshape()函数.
def dm01():
    # 1. 定义2行3列的张量.
    t1 = torch.randint(1, 10, size=(2, 3))
    print(f't1: {t1}, shape: {t1.shape}, row: {t1.shape[0]}, columns: {t1.shape[1]}, {t1.shape[-1]}')

    # 2. 通过reshape()函数, 把t1 -> 3行2列, 1行6列, 6行1列.
    t2 = t1.reshape(3, 2)
    # t2 = t1.reshape(1, 6)
    # t2 = t1.reshape(6, 1)
    print(f't2: {t2}, shape: {t2.shape}, row: {t2.shape[0]}, columns: {t2.shape[1]}, {t2.shape[-1]}')

    # 3. 尝试通过reshape()函数, 把t1 -> 2行5列的结果.
    # t3 = t1.reshape(2, 5)       # 报错, 转之前共计 2*3=6个元素, 转之后共计 2*5=10个元素, 不一致.
    # print(f't3: {t3}')


# 2. 定义函数, 演示: unsqueeze()函数, squeeze()函数.
def dm02():
    # 1. 定义2行3列的张量.
    t1 = torch.randint(1, 10, size=(2, 3))
    print(f't1: {t1}, shape: {t1.shape}')       # (2, 3)

    # 2. 在0维上, 添加一个维度.
    t2 = t1.unsqueeze(0)
    print(f't2: {t2}, shape: {t2.shape}')       # (1, 2, 3)

    # 3. 在1维上, 添加一个维度.
    t3 = t1.unsqueeze(1)
    print(f't3: {t3}, shape: {t3.shape}')       # (2, 1, 3)

    # 4. 在2维上, 添加一个维度.
    t4 = t1.unsqueeze(2)
    print(f't4: {t4}, shape: {t4.shape}')       # (2, 3, 1)

    # 5. 在3微上(不存在), 添加一个维度.
    # t5 = t1.unsqueeze(3)        # 报错, 越界.
    # print(f't5: {t5}, shape: {t5.shape}')       # (2, 3, ???, 1)

    # 6. 删除所有为1的维度.
    t6 = torch.randint(1, 10, size=(2, 1, 3, 1, 1))
    print(f't6: {t6}, shape: {t6.shape}')        # (2, 1, 3, 1, 1)

    t7 = t6.squeeze()
    print(f't7: {t7}, shape: {t7.shape}')        # (2, 3)


# 3. 定义函数, 演示: transpose()函数, permute()函数.
def dm03():
    # 1. 定义张量.
    t1 = torch.randint(1, 10, size=(2, 3, 4))
    print(f't1: {t1}, shape: {t1.shape}')
    print('-' * 30)

    # 2. 改变维度从 (2, 3, 4) -> (4, 3, 2)
    # t2 = t1.transpose(0, 2)
    t2 = t1.transpose(0, -1)        # 效果同上.
    print(f't2: {t2}, shape: {t2.shape}')

    # 3. 改变维度从 (2, 3, 4) -> (4, 2, 3)
    t3 = t1.permute(2, 0, 1)
    print(f't3: {t3}, shape: {t3.shape}')


# 4. 定义函数, 演示: view()函数, contiguous()函数, is_contiguous()函数.
def dm04():
    # 思路: 演示 view()无法改变 不连续的张量的形状, 可以通过 is_contiguous()判断张量是否连续, 也可以通过 contiguous()把不连续的张量 -> 连续张量.
    # 1. 定义张量.
    t1 = torch.randint(1, 10, size=(2, 3))
    print(f't1: {t1}, shape: {t1.shape}')

    # 2. 判断张量是否连续. 即: 张量中的顺序 和 内存中存储顺序是否一致.
    # print(t1.is_contiguous())       # True

    # 3. 通过 view()函数, 修改上述张量的形状. 从(2, 3) -> (3, 2)
    t2 = t1.view(3, 2)
    print(f't2: {t2}, shape: {t2.shape}')
    print(t2.is_contiguous())        # True

    # 4. 通过 transpose()交换维度 -> 交换之后, 不连续了.
    t3 = t1.transpose(0, 1)
    print(f't3: {t3}, shape: {t3.shape}')
    print(t3.is_contiguous())        # False

    # 5. 尝试把 t3张量 从(3, 2), 通过 view() 转成 (2, 3).
    # t4 = t3.view(2, 3)      # t3不连续, 所以view()无法改变形状. 报错.
    # print(f't4: {t4}, shape: {t4.shape}')

    # 6. 可以通过 contiguous()函数, 把 t3张量 -> 连续张量 -> 然后就能通过view修改形状了.
    t5 = t3.contiguous().view(2, 3)
    print(f't5: {t5}, shape: {t5.shape}')

# 5. 测试
if __name__ == '__main__':
    # dm01()
    # dm02()
    # dm03()
    dm04()
张量拼接操作
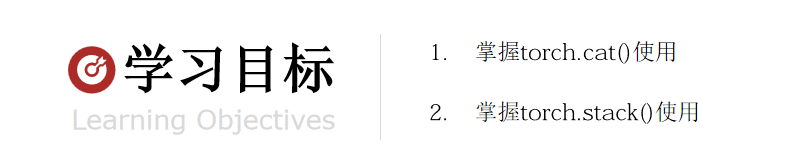
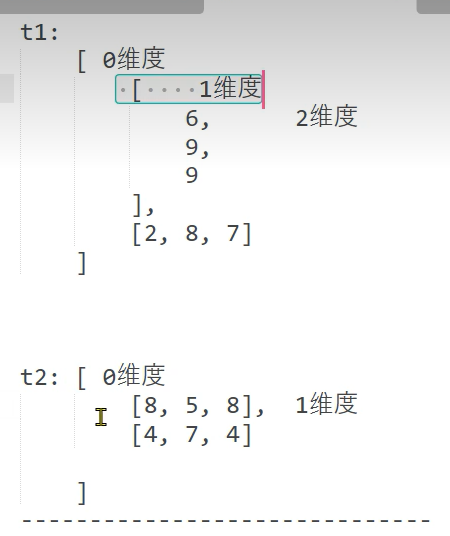
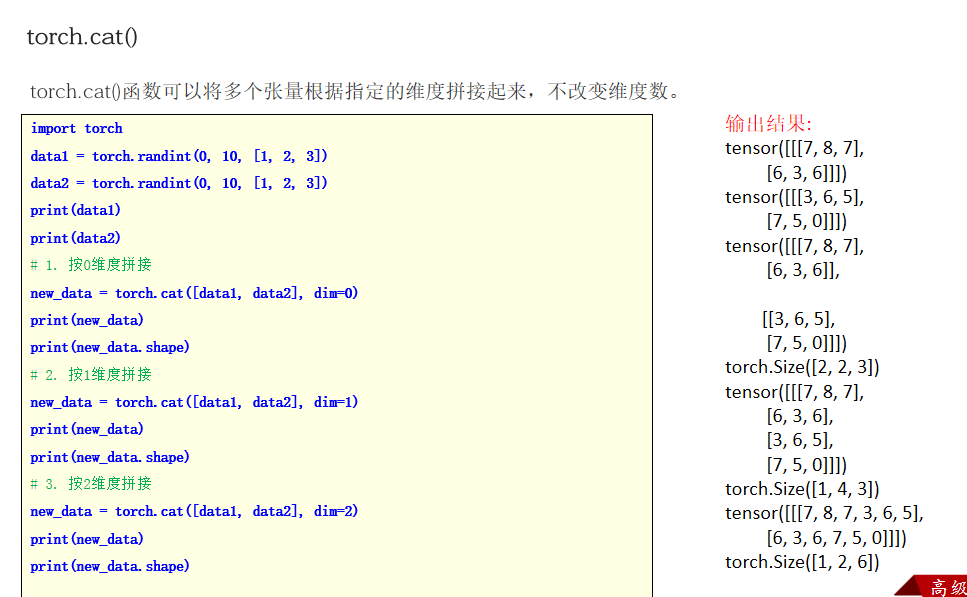
cat不改变维度 stack改变维度
可以想象成长方体,0维度是高,0维度拼接是两个1为张量叠在一起成了2维张量,1维度拼接可以把刚刚按0维拼成的’长方体‘翻一下,把’之前的1维‘变成现在的0维(高),可以画一下,数字对应从6开始
"""
案例:
    演示张量的拼接操作.

涉及到的API:
    cat()     不改变维度数, 拼接张量. 除了拼接的那个维度外, 其它维度数必须保持一致.
    stack()   会改变维度数, 拼接张量. 所有的维度都必须保持一致.
"""

# 导包
import torch

# 设置随机种子.
torch.manual_seed(24)

# 1. 创建两个张量.
t1 = torch.randint(1, 10, (2, 3))
print(f't1: {t1}, shape: {t1.shape}')

t2 = torch.randint(1, 10, (2, 3))
print(f't2: {t2}, shape: {t2.shape}')

# 2. 演示张量的拼接
# 思路1: cat() 拼接张量.
# t3 = torch.cat([t1, t2], dim=0)     # (2, 3) + (2, 3) = (4, 3)
# print(f't3: {t3}, shape: {t3.shape}')

# t4 = torch.cat([t1, t2], dim=1)     # (2, 3) + (2, 3) = (2, 6)
# print(f't4: {t4}, shape: {t4.shape}')

# t5 = torch.cat([t1, t2], dim=-1)    # 效果同上
# print(f't5: {t5}, shape: {t5.shape}')

# t6 = torch.cat([t1, t2], dim=2) # 报错.
# print(f't6: {t6}, shape: {t6.shape}')
print('-' * 30)

# 思路2: stack() 拼接张量, 可以是新维度, 但是无论新旧维度, 所有维度都必须保持一致.
# t7 = torch.stack([t1, t2], dim=0)   # (2, 3) + (2, 3) = (2, 2, 3)
# print(f't7: {t7}, shape: {t7.shape}')

# t8 = torch.stack([t1, t2], dim=1)   # (2, 3) + (2, 3) = (2, 2, 3)
# print(f't8: {t8}, shape: {t8.shape}')

t9 = torch.stack([t1, t2], dim=2)   # (2, 3) + (2, 3) = (2, 3, 2)
print(f't9: {t9}, shape: {t9.shape}')

# 报错.
# t10 = torch.stack([t1, t2], dim=3)   # (2, 3) + (2, 3) = (2, 3, ?, 2)
# print(f't10: {t10}, shape: {t10.shape}')
自动微分模块
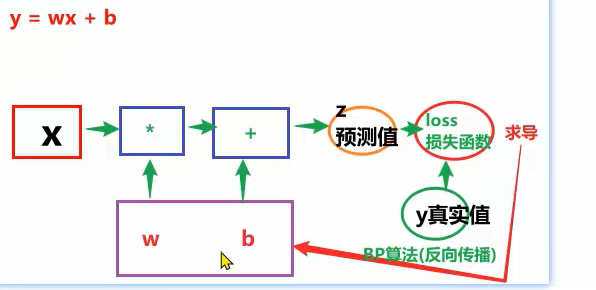
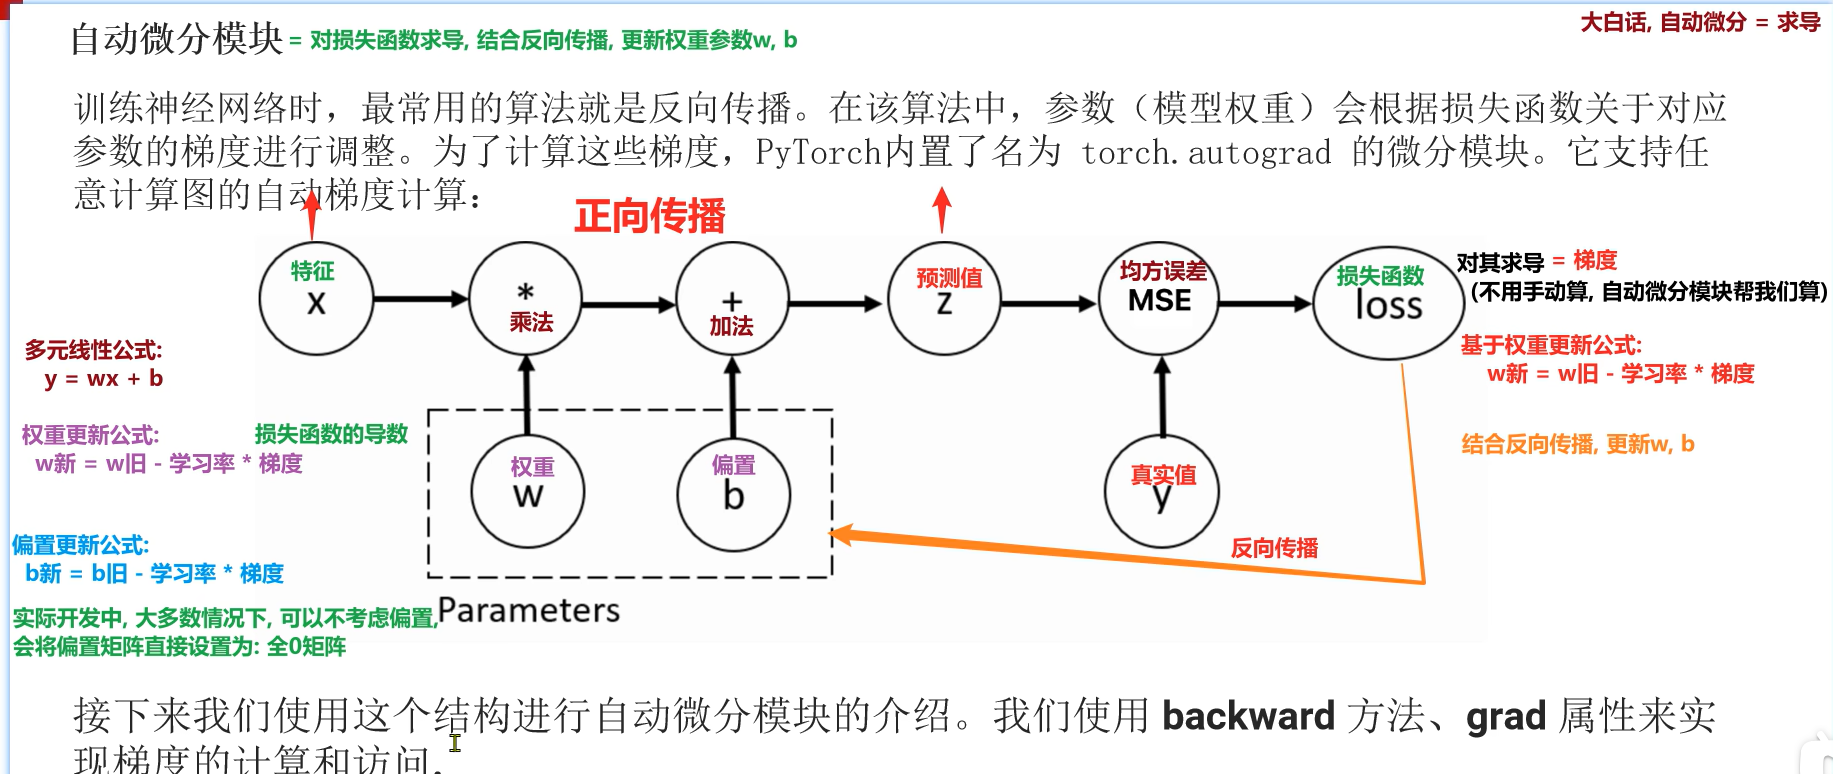
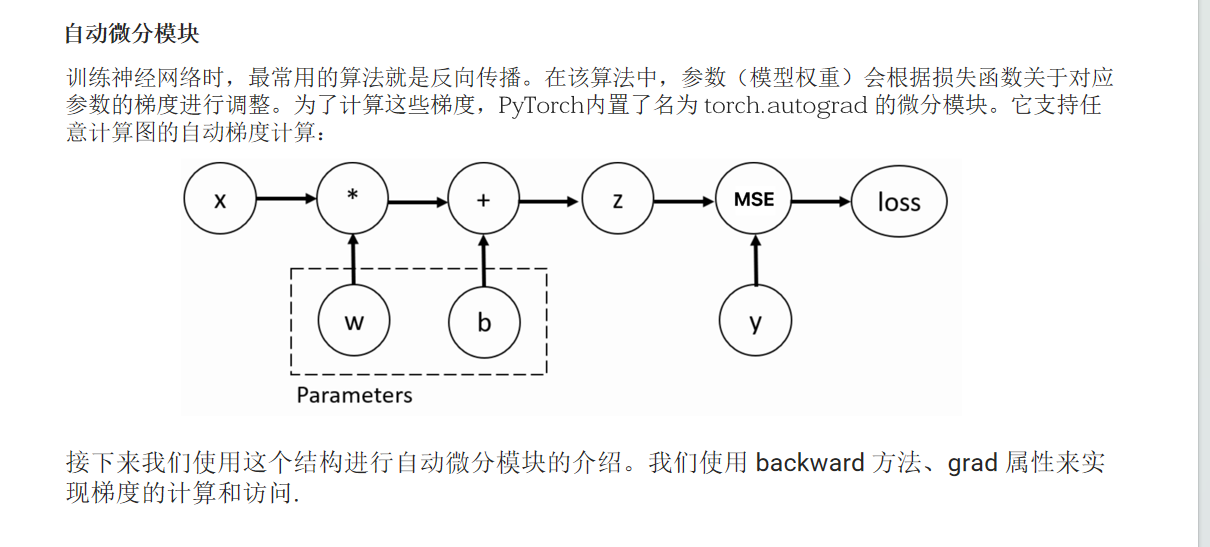
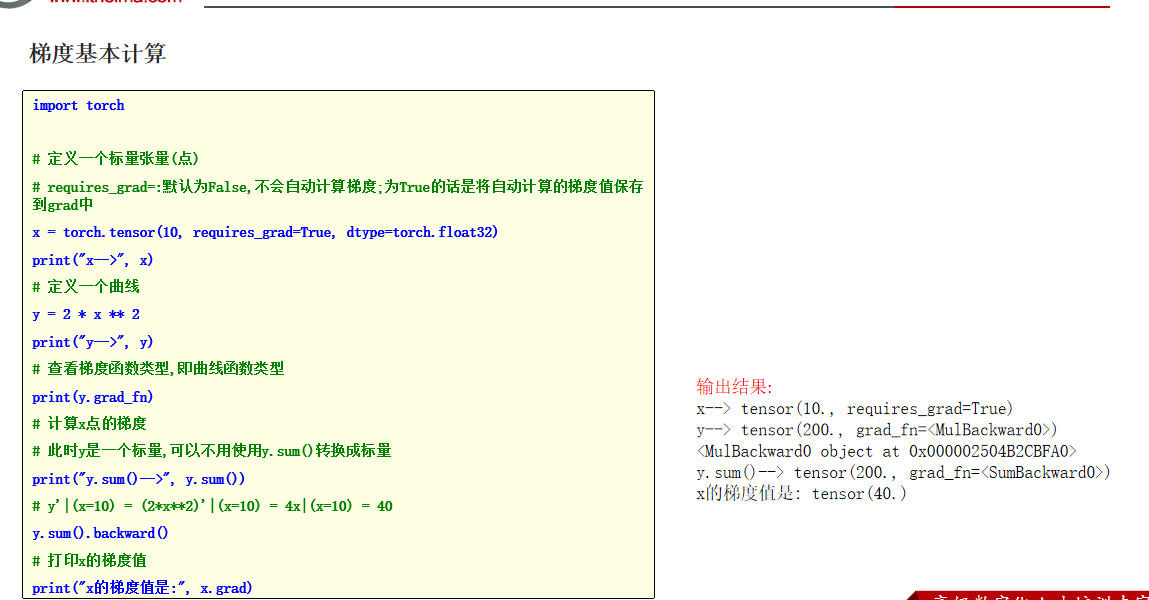
'''
案例:演示自动微分模块,具体如何求导
回顾:
    权重更新公式:
    W新=W旧-学习率*梯度
    梯度=损失函数对权重的偏导数
    关于损失函数的导数,无需我们手动计算,因为非常常用,所以Pytorch模块内置有自动微分模块,专门
     实现针对不同的损失函数求导,从而实现 结合反向传播,更新权重参数W和偏置参数b
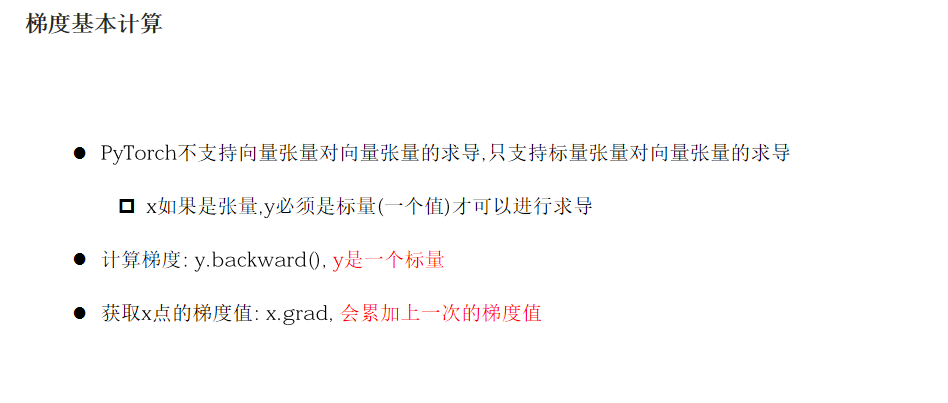
细节 :只有标量张量才能求导,且大多数底层操作的都是浮点型,记得转型
'''
#导包
import torch
#1.定义变量,记录:初始的权重W(旧)
#参1:初始值 参2:是否需要求导 参3:元素类型
w=torch.tensor(10,requires_grad=True,dtype=torch.float)
#2.定义loss变量,表示损失函数
loss=2*w**2#loss=2w^2->求导为4w
#3.打印梯度函数类型(了解)
print(f'梯度函数类型: {type(loss.grad_fn)}')#梯度函数类型: <class 'MulBackward0'>
#4.计算梯度,梯度=损失函数的导数,计算完毕后,会记录到w.grad中
# loss.backward()#这里因为y本身是标量,可以不写
loss.sum().backward()#保证loss是1个标量
#5.代入权重更新公式:W新=W旧-学习率*梯度
w.data=w.data-0.01*w.grad
#6.打印更新后的权重W(新)
print(f'更新后的权重W(新): {w}')#[9.6]
标准的四个步骤是:正向传播求损失,损失反向传播求梯度,使用梯度更新参数,梯度清零。这样根本不用考虑梯度为None的情况
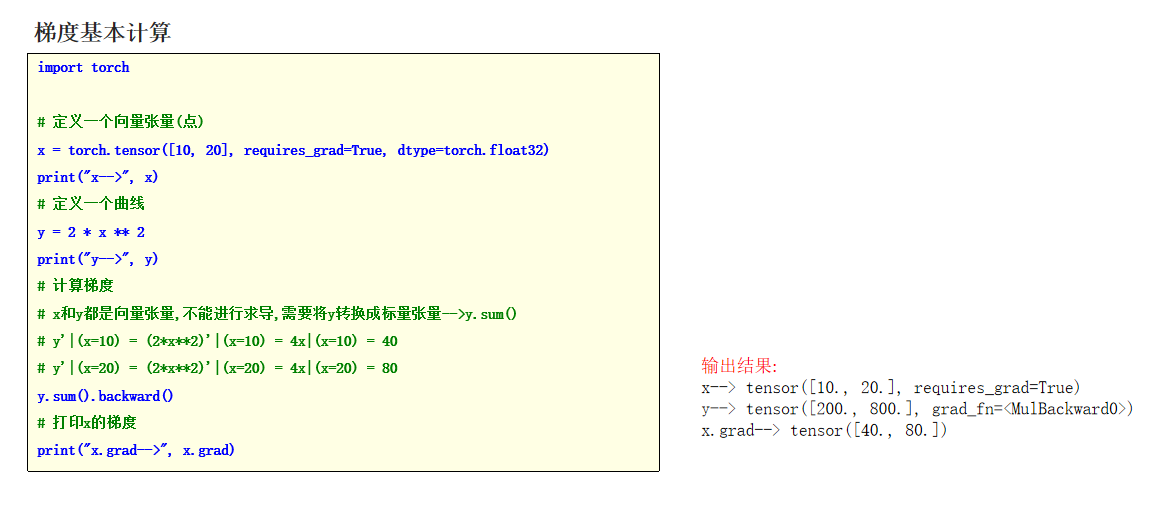
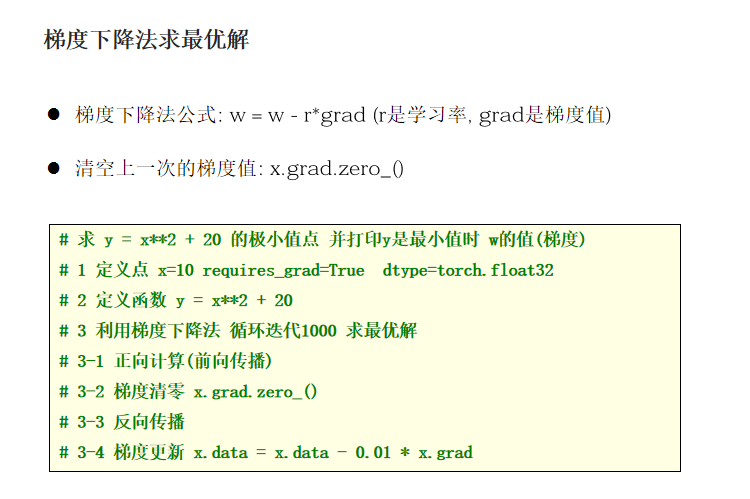
'''
案例:自动微分模块,循环实现计算梯度,更新参数
需求:
    求 y = x**2 + 20 的极小值点 并打印y是最小值时 w的值(梯度)

解题步骤:
    1. 定义点 w=10 requires_grad=True  dtype=torch.float32
    2. 定义函数 loss = w**2 + 20
    3. 利用梯度下降法 循环迭代1000 求最优解
    3.1 正向计算(前向传播)
    3.2 梯度清零 w.grad.zero_()
    3.3 反向传播
    3.4 梯度更新 w.data = w.data - 0.01 * w.grad
回顾:
    W新=W旧-学习率*梯度
'''
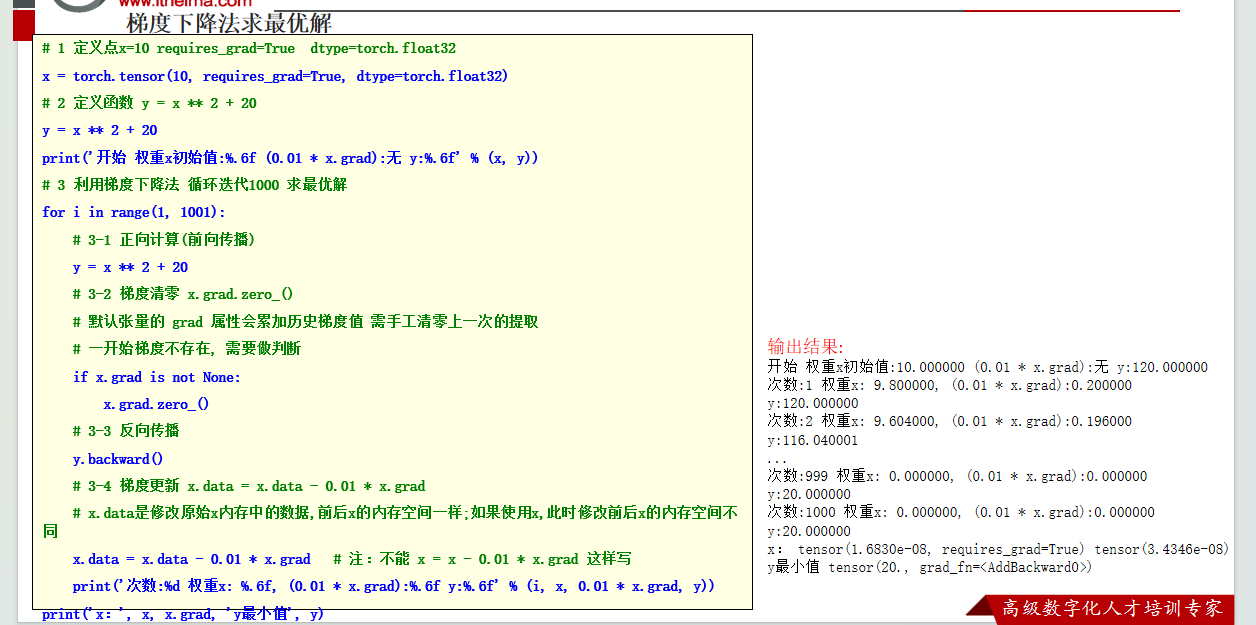
#导包
import torch

# 1.定义点w = 10 requires_grad = True dtype = torch.float32
w=torch.tensor(10,requires_grad=True,dtype=torch.float32)
# 2.定义函数 loss = w ** 2 + 20
loss=w**2+20
# 3.利用梯度下降法循环迭代1000 求最优解
for i in range(1,101):
    # 3.1 正向计算(前向传播)
    loss=w**2+20
    # 3.2 梯度清零  w.grad.zero_()
    # 至此(第一次的时候), 还没有计算梯度, 所以w.grad = None, 要做非空判断.
    if w.grad is not None:
        w.grad.zero_()
    # 3.3 反向传播
    loss.sum().backward()
    # 3.4 梯度更新 w.data = w.data - 0.01 * w.grad
    w.data=w.data-0.01*w.grad
    # 3.5 打印本次 梯度更新后的 权重参数结果.
    print(f'第 {i} 次, 权重初始值: {w}, (0.01 * w.grad): {0.01 * w.grad:.5f}, loss: {loss:.5f}')

# 4. 打印最终结果.
print(f'最终结果 权重: {w}, 梯度: {w.grad:.5f}, loss: {loss:.5f}')
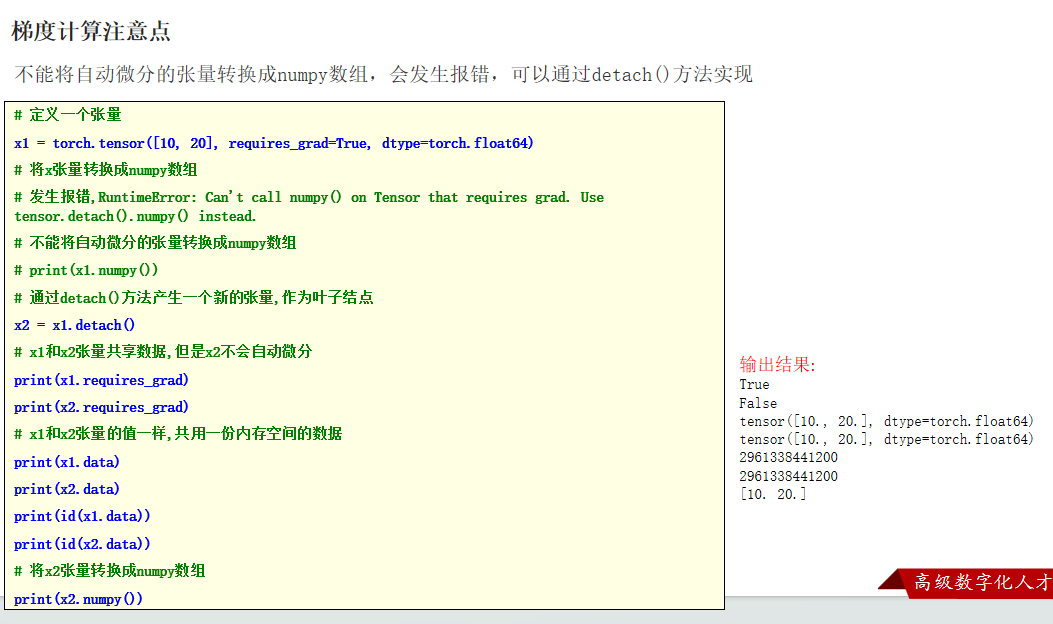
"""
案例:
    演示 detach()函数的功能, 解决 自动微分的弊端.

回顾:
    自动微分 = 求导, 即: 基于损失函数, 计算梯度.
    结合权重更新公式: w新 = w旧 - 学习率 * 梯度, 来更新权重的.

问题:
    一个张量一旦设置了 自动微分, 这个张量就不能直接转成 numpy的 ndarray对象了, 需要通过 detach()函数解决.
"""

# 导包
import torch
import numpy as np


# 1. 定义张量.
# 参1: 数据, 参2: 是否需要自动微分, 参3: 数据类型.
t1 = torch.tensor([10, 20], requires_grad=True ,dtype=torch.float)
print(f't1: {t1}, type: {type(t1)}')


# 2. 尝试把上述的张量 -> numpy对象.
# n1 = t1.numpy()         # 报错.
# print(f'n1: {n1}, type: {type(n1)}')


# 3. 解决方法: 通过 detach()函数, 拷贝一份张量, 然后转换.
t2 = t1.detach()
print(f't2: {t2}, type: {type(t2)}')

# 4. 测试上述的t1 和 t2是否共享同一块空间 -> 共享.
t1.data[0] = 100
print(f't1: {t1}, type: {type(t1)}')
print(f't2: {t2}, type: {type(t2)}')
print('-' * 30)

# 5. 查看t1 和 t2谁可以自动微分.
print(f't1: {t1.requires_grad}')    # True
print(f't2: {t2.requires_grad}')    # False
print('-' * 30)

# 6. 把t2转numpy对象.
n1 = t2.numpy()
print(f'n1: {n1}, type: {type(n1)}')

# 7. 最终版.
n2 = t1.detach().numpy()# 先detach(), 再转numpy对象.
print(f'n2: {n2}, type: {type(n2)}')
"""
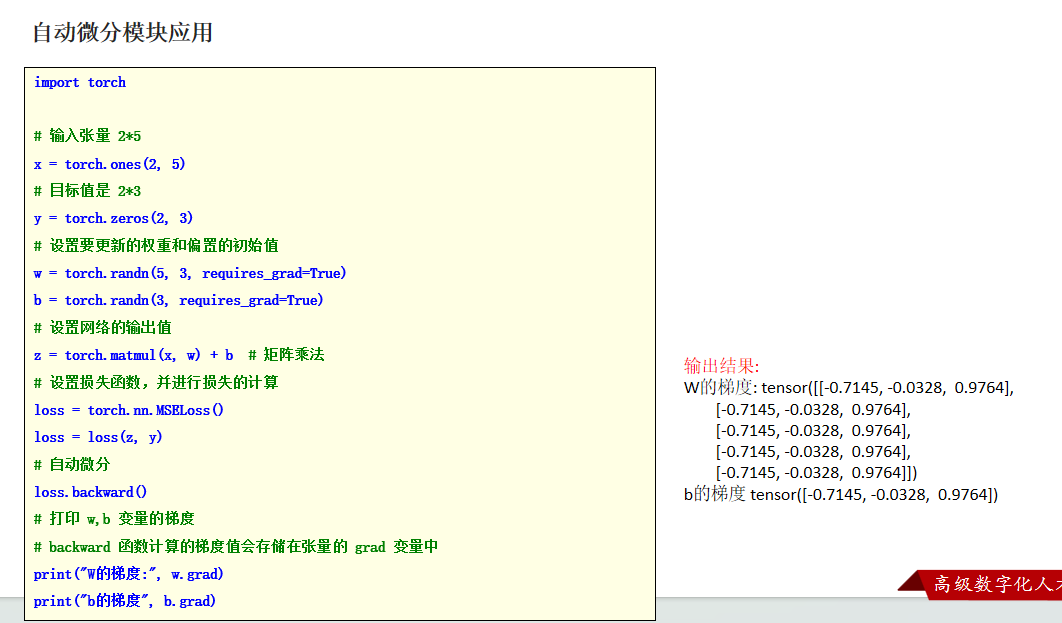
案例:
    演示自动微分的真实应用场景.

结论:
    1. 先前向转播(正向传播) 计算出 预测值(z)
    2. 基于损失函数, 结合 预测值(z) 和 真实值(y), 来计算 梯度.
    3. 结合权重更新公式 w新 = w旧 - 学习率 * 梯度, 来更新 权重.
"""

# 导包
import torch

# 1. 定义x, 表示: 特征(输入数据), 假设: 2行5列, 全1矩阵.
x = torch.ones(2, 5)
print(f'x: {x}')

# 2. 定义y, 表示: 标签(真实值), 假设: 2行3列, 全0矩阵.
y = torch.zeros(2, 3)
print(f'y: {y}')

# 3. 初始化(可自动微分的)权重 和 偏置.
w = torch.randn(5, 3, requires_grad=True)
print(f'w: {w}')

b = torch.randn(3, requires_grad=True)
print(f'b: {b}')

# 4. 前向转播(正向传播), 计算出 预测值(z).
z = torch.matmul(x, w) + b
# z = x @ w + b
print(f'z: {z}')

# 5. 定义损失函数.
criterion = torch.nn.MSELoss()  # neural network: 神经网络
loss = criterion(z, y)          # loss = 损失
print(f'loss: {loss}')

# 6. 进行自动微分, 求导, 结合反向传播, 更新权重.
loss.backward()

# 7. 打印w, b 用来更新的梯度.
print(f'w的梯度: {w.grad}')
print(f'b的梯度: {b.grad}')

# 后续就是: w新 = w旧 - 学习率 * 梯度, 来更新 权重.
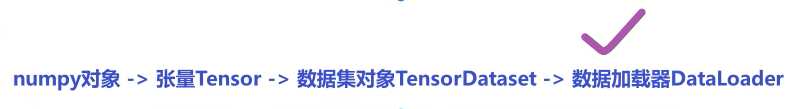
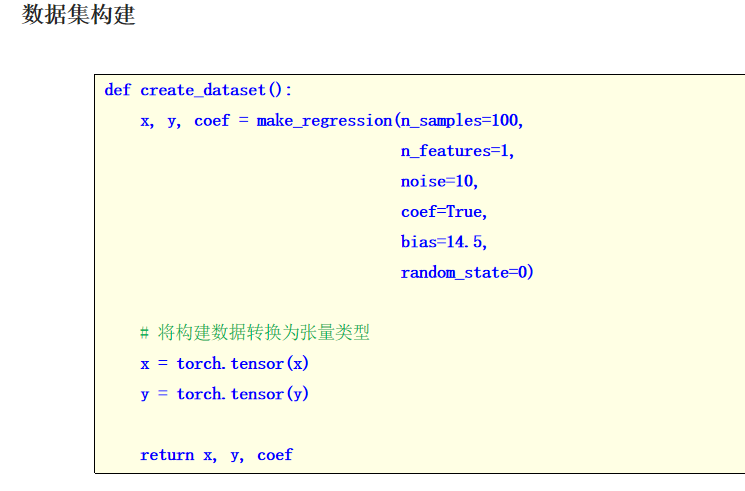
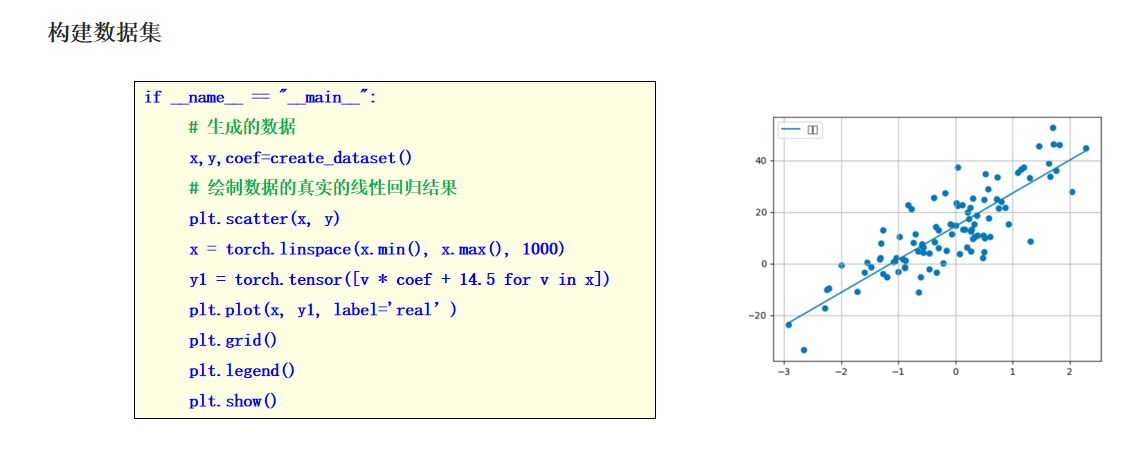
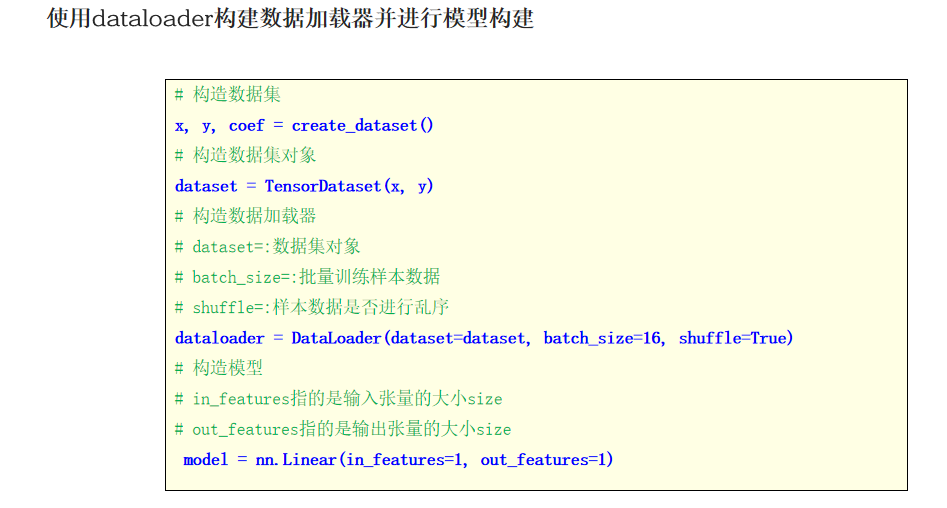
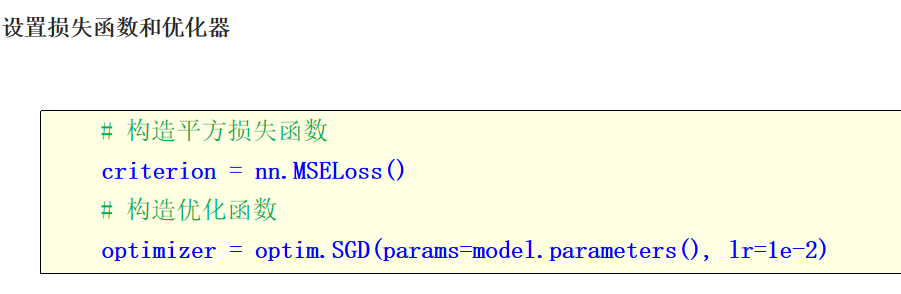
案例-线性回归案例
转换过程
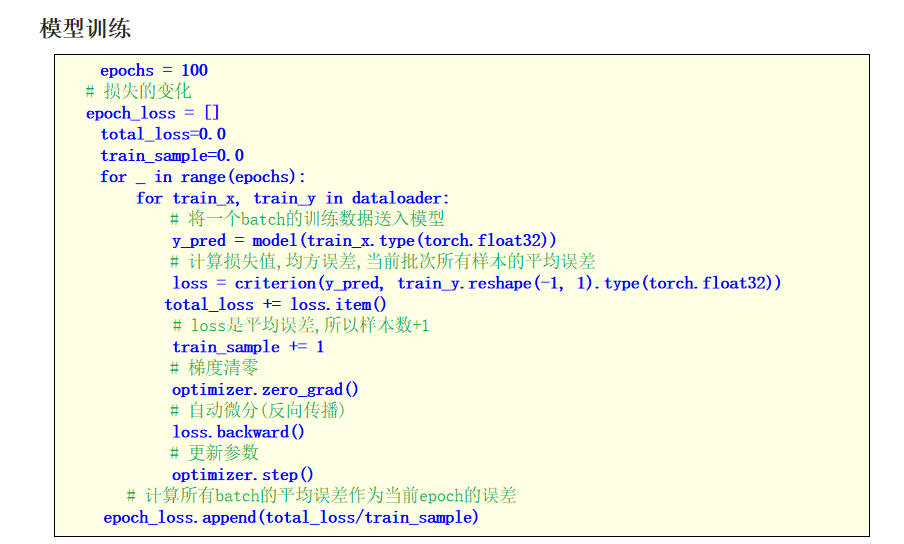
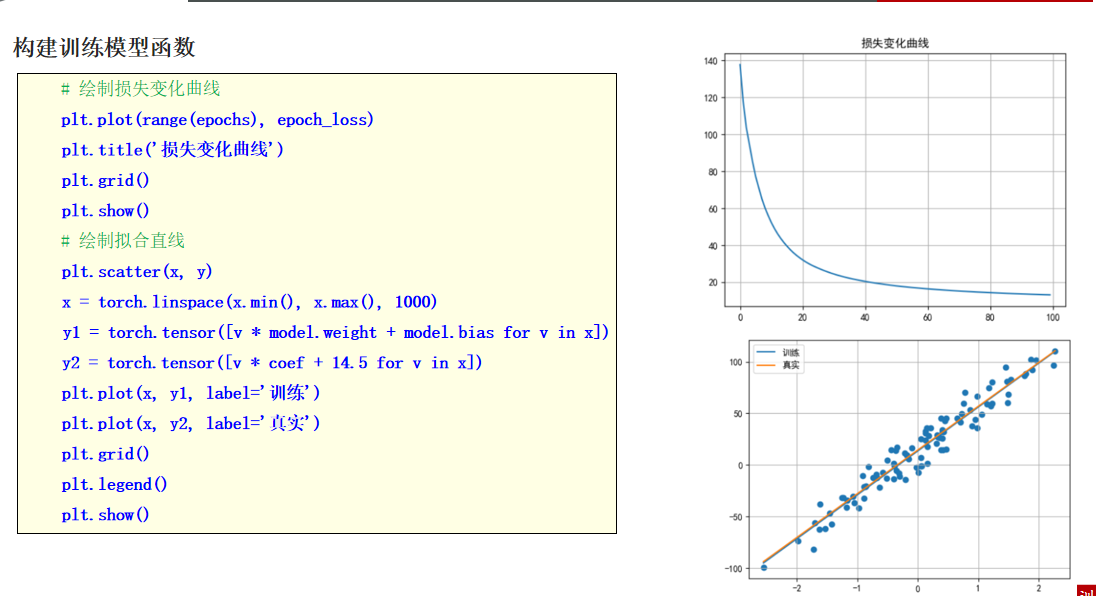
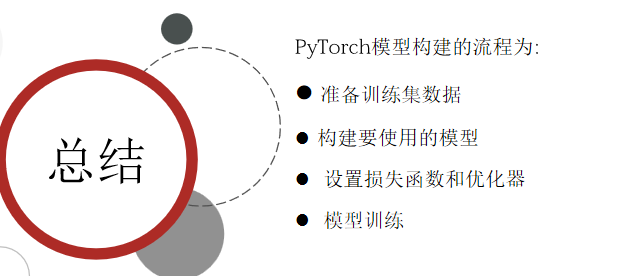
# 导入相关模块
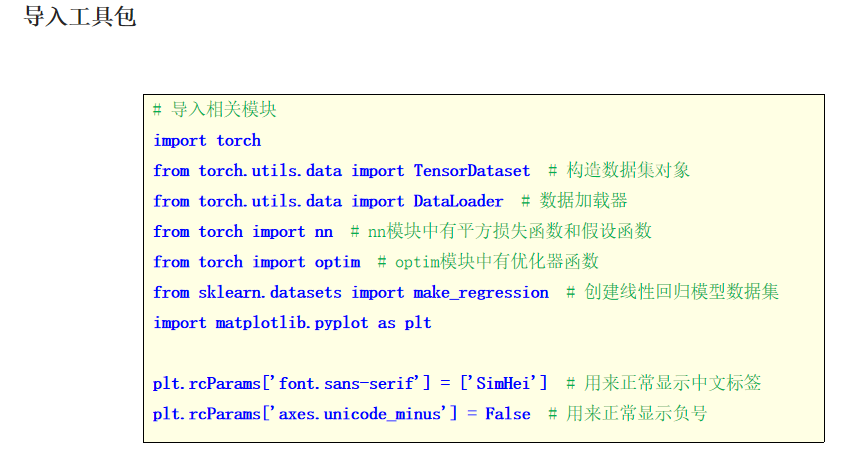
import torch
from torch.utils.data import TensorDataset  # 构造数据集对象
from torch.utils.data import DataLoader  # 数据加载器
from torch import nn  # nn模块中有平方损失函数和假设函数
from torch import optim  # optim模块中有优化器函数
from sklearn.datasets import make_regression  # 创建线性回归模型数据集
import matplotlib.pyplot as plt  # 可视化

plt.rcParams['font.sans-serif'] = ['SimHei']  # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False  # 用来正常显示负号
#1.定义函数,创建线性回归样本数据
def create_dataset():
    #1.创建数据集对象
    x,y,coef=make_regression(
        n_samples=100,#100条样本(100个样本点)
        n_features=1,#1个特征
        noise=10, #噪声,噪声越大,样本点越散,噪声越小,样本点越集中
        random_state=42,#随机种子,随机种子相同,输出的数据相同
        bias=14.5,#偏置项
        coef=True#是否返回系数,默认为False,返回值为None,这个是权重
    )
    #2.把上述的数据,封装成张量
    x=torch.tensor(x,dtype=torch.float)
    y=torch.tensor(y,dtype=torch.float)
    #3.返回数据集对象
    return x,y,coef
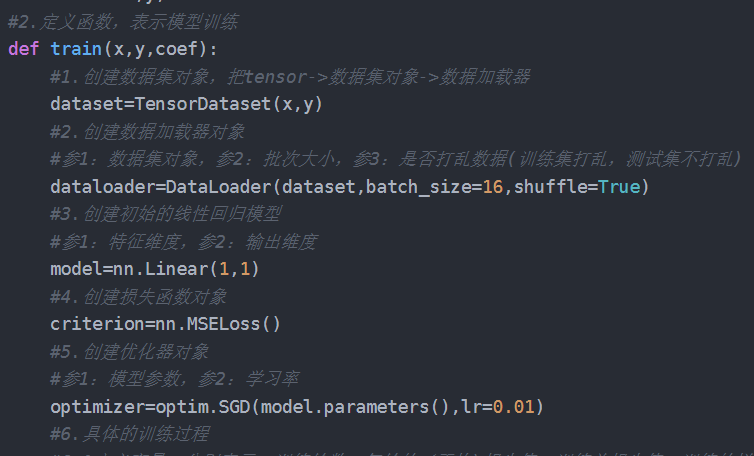
#2.定义函数,表示模型训练
def train(x,y,coef):
    #1.创建数据集对象,把tensor->数据集对象->数据加载器
    dataset=TensorDataset(x,y)
    #2.创建数据加载器对象
    #参1:数据集对象,参2:批次大小,参3:是否打乱数据(训练集打乱,测试集不打乱)
    dataloader=DataLoader(dataset,batch_size=16,shuffle=True)
    #3.创建初始的线性回归模型
    #参1:特征维度,参2:输出维度
    model=nn.Linear(1,1)
    #4.创建损失函数对象
    criterion=nn.MSELoss()
    #5.创建优化器对象
    #参1:模型参数,参2:学习率
    optimizer=optim.SGD(model.parameters(),lr=0.01)
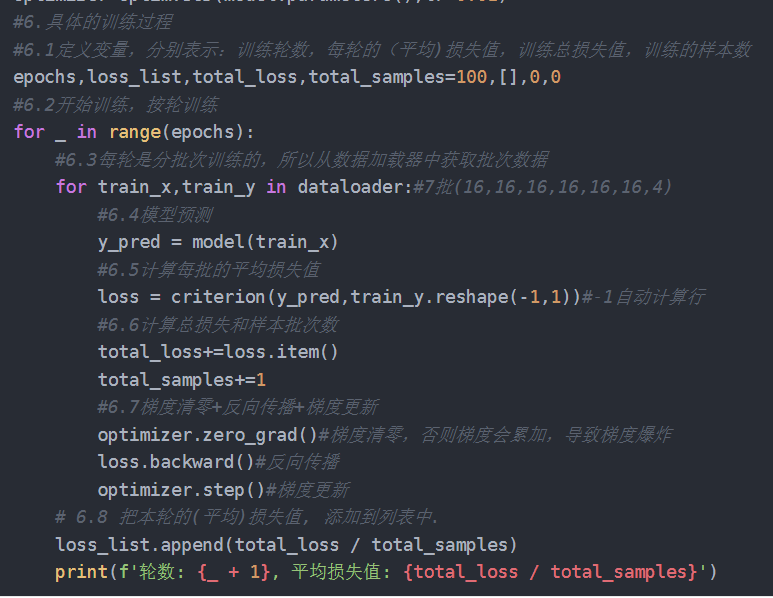
    #6.具体的训练过程
    #6.1定义变量,分别表示:训练轮数,每轮的(平均)损失值,训练总损失值,训练的样本数
    epochs,loss_list,total_loss,total_samples=100,[],0,0
    #6.2开始训练,按轮训练
    for _ in range(epochs):
        #6.3每轮是分批次训练的,所以从数据加载器中获取批次数据
        for train_x,train_y in dataloader:#7批(16,16,16,16,16,16,4)
            #6.4模型预测
            y_pred = model(train_x)
            #6.5计算每批的平均损失值
            loss = criterion(y_pred,train_y.reshape(-1,1))#-1自动计算行
            #6.6计算总损失和样本批次数
            total_loss+=loss.item()
            total_samples+=1
            #6.7梯度清零+反向传播+梯度更新
            optimizer.zero_grad()#梯度清零,否则梯度会累加,导致梯度爆炸
            loss.backward()#反向传播
            optimizer.step()#梯度更新
        # 6.8 把本轮的(平均)损失值, 添加到列表中.
        loss_list.append(total_loss / total_samples)
        print(f'轮数: {_ + 1}, 平均损失值: {total_loss / total_samples}')

    # 7. 打印(最终的)训练结果.
    print(f'{epochs} 轮的平均损失分别为: {loss_list}')
    print(f'模型参数, 权重: {model.weight}, 偏置: {model.bias}')
    # 8. 绘制损失曲线.
    #                 100轮         每轮的平均损失值
    plt.plot(range(epochs), loss_list)
    plt.title('损失值曲线变化图')
    plt.grid()      # 绘制网格线
    plt.show()

    # 9. 绘制预测值和真实值的关系.
    # 9.1 绘制样本点分布情况.
    plt.scatter(x, y)
    # 9.2 绘制训练模型的预测值.
    # x: 100个样本点的特征.
    y_pred = torch.tensor(data = [v * model.weight + model.bias for v in x])
    # 9.3 计算真实值.
    y_true = torch.tensor(data = [v * coef + 14.5 for v in x])
    # 9.4 绘制预测值 和 真实值的 折线图.
    plt.plot(x, y_pred, color='red', label='预测值')
    plt.plot(x, y_true, color='green', label='真实值')
    # 9.5 图例, 网格.
    plt.legend()
    plt.grid()
    # 9.6 显示图像.
    plt.show()


    # plt.show()


#测试
if __name__=='__main__':
    x,y,coef=create_dataset()
    train(x,y,coef)
重要模版!


 扫一扫


 1247

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


