


大模型在一定程度上去改变了我们生活生工作的思考的方式,然后也越来越多的个人还有企业在思考如何将大模型去应用到更加实际的呃生产生活中去,希望大语言模型能够呃有一些更多企业级别生产落地的实践,然后去帮助我们解决一些业务上的问题。
1 LLM的问题
1.1 幻觉
LLM因为是一个预训练模型,它已有一些知识储备,我们提的问题跟他的知识储备不相符时,会产生一些幻觉问题,看上去正确的回答
1.2 新鲜度
LLM预训练出来之后,不能感知到我们实时更新的工业数据,还有企业内部的一些私域数据
1.3 数据安全
LLM训练依赖很多训练数据集,然后为了保证大语言模型的效果更好,训练集的质量以及数据量越多对于大语言模型的一个训练。最终的一个效果会更好,但我们又期望LLM想要去帮我们解决一些垂类的问题,然后又是希望在数据安全这儿会有一些防范,就比如说像企业的一些内部的敏感数据以及敏感文档是一定不能够暴露出去,让公有的大语言模型去进行训练。
2 RAG是啥?
为解决单元模型刚刚提到问题,提出RAG,将企业内部私域数据以及实时更新的一些公域数据,通过一些处理之后,变成可进行相似性搜索的向量数据,然后存储到向量数据库。
在我们跟大约模型交互时,用户提问。首先在我们的相同数据库中去进行相似性检索,检索出与这个提问相关的知识内容,然后检索后交给LLM,连同用户的提问一起让 LLM 去生成回复。
RAG帮助我们个人及用户去把企业内部的一些知识数据,很快构建出一个庞大知识库,然后结合目前已有LLM能力,可快速制作智能问答机器人应用。
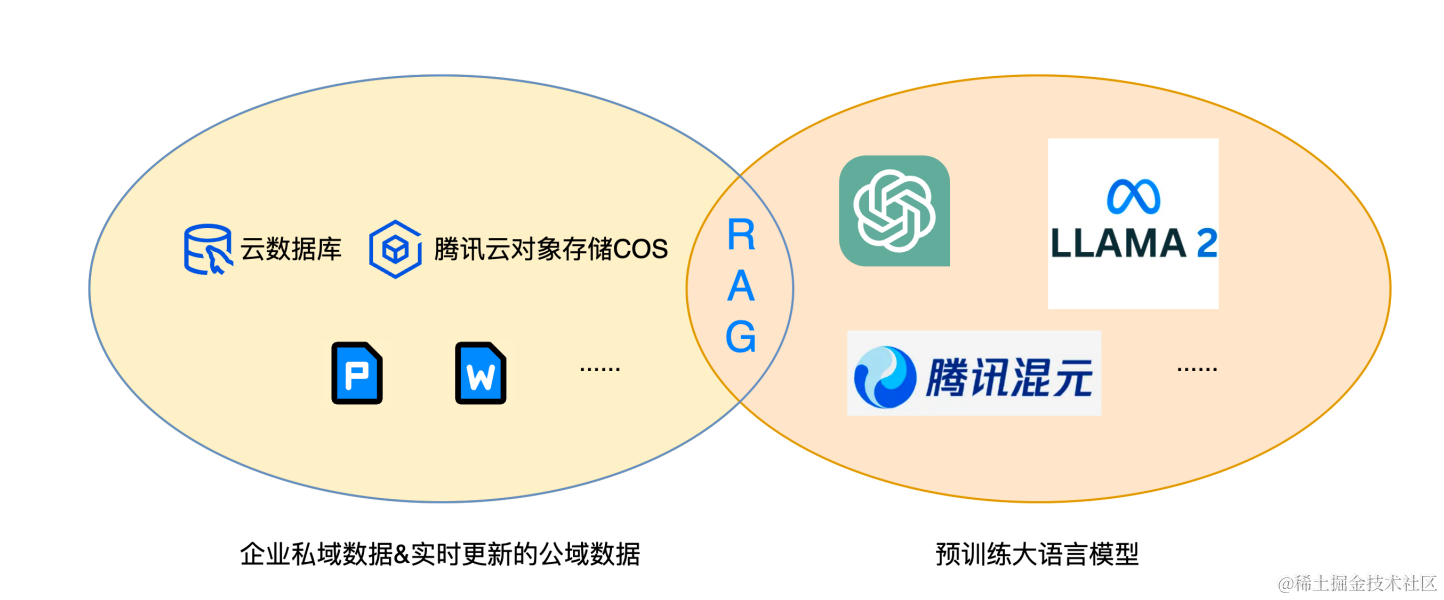
为LLM提供来自外部知识源的额外信息的概念。这允许它们生成更准确和有上下文的答案,同时减少幻觉
- 检索:外部相似搜索
- 增强:提示词更新
- 生成:更详细的提示词输入LLM
2 rag应用咋构建的?
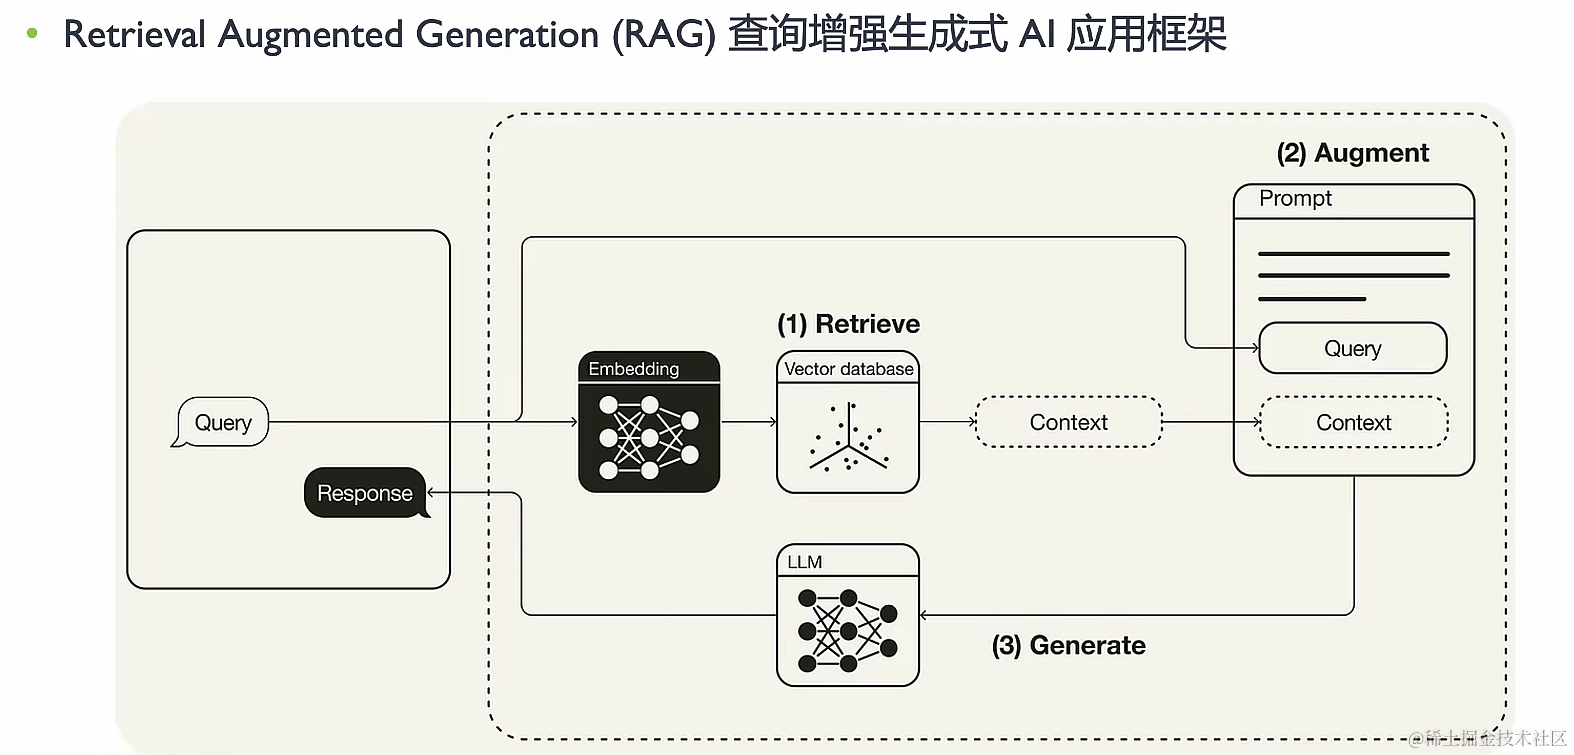
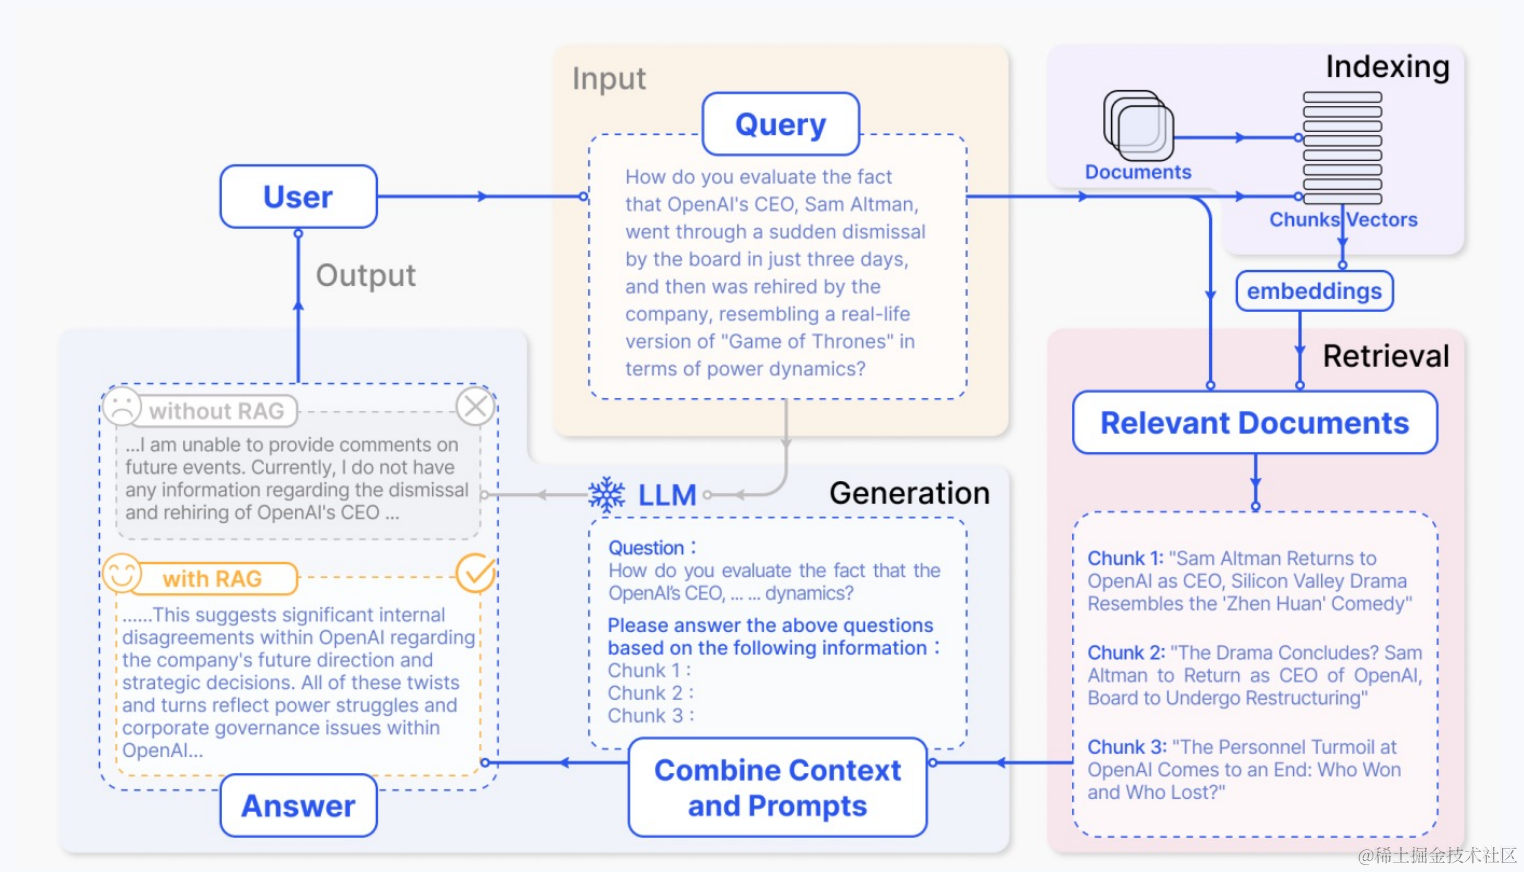
使用到RAG的这条链路之后,用户会先去构建好的知识库,也就是我们向量数据库里面去进行相似性检索,然后带出一部分的知识知识文档。这部分知识文档会跟用户的query结合。
然后我们通过prompt 技术组装成一个最终完成的一个输入给到LLM。然后让LLM生成回复。
最关键一点就是知识库生成这一步,因为主要涉及把我们的知识文档去做内容的提取及拆分。还要进行量化,存入数据库。
2.1 RAG步骤
-
知识切片成Chunk
-
向量化Chunk入库
前两步都是去知识库生成。
-
Query检索知识Chunk
-
构建Prompts
-
调用LLM生成回答
后三步都是知识库生成后,在检索方面需要做的。
2.2基于开源框架构建 RAG 应用
像LangChain快速构建一个RAG应用。Langchain中RAG的实现:
各种文档 - 各种 loader - 文本切片 - 嵌入向量化 - 向量存储 - 各种检索链。
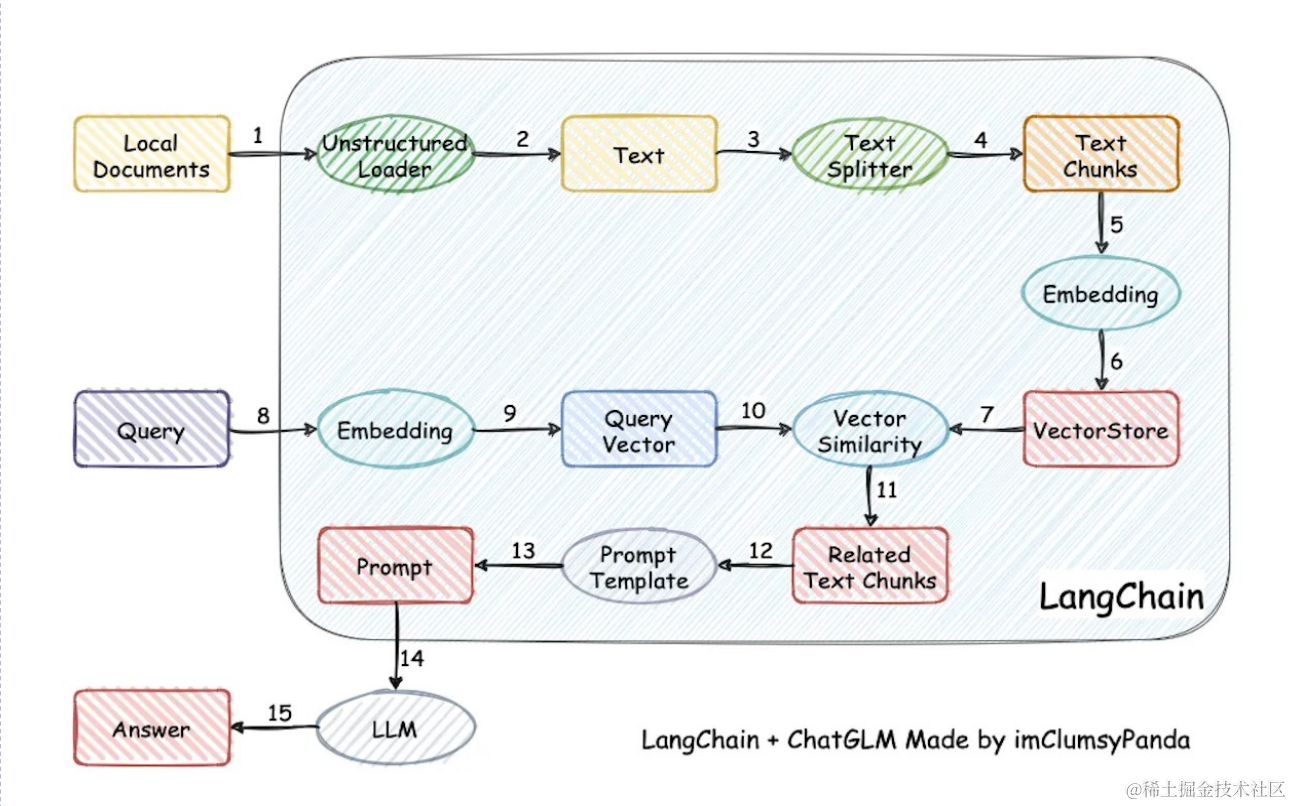
思想就是把那五个步骤拆成不同组件,然后由每个不同节点做相应处理。让用户去编写自己的业务逻辑的代码,然后去把这整个过程串起来。
优点和痛点都非常明显。
优势主要是:
- 可以快速构建一个demo起来,帮助我们的开发者去理解RAG应用
- 庞大的一个社区支持,如一些插件或它的一个版本更新迭代都会非常快
痛点也明显:通过开源框架构建出来的一个RAG应用,其实本质上它的通用性是非常强。为保证强通用性,它在效果层面不一定做到最好,就需要企业或个人投入比较大精力,较多研究去把这一个整体的RAG在召回层面的一个效果给提升到最佳。
3 bad case
介绍一下在整体构建整个RAG应用过程中会遇到的一些问题和解决方案。
3.1 第一个
用户提问:请问A产品分析报告多久分析一次?
然后我们召回的相关知识是:A产品的分析报告信息近30天的数据分析结果。
原因是我们用户的问题,在相关知识中没有明确提到,只是有一定相似度。但跟我们用户问题不直接相关。这样的相关知识以及用户的问题。组装之后交给LLM回答,本质上是人为搞干扰。
对此,有一个工程化实践叫拒答。
3.2 第二个
提问的A课程适合多大年龄小孩。
知识库里会召回来两条数据,然后其中一条数据是我们期望的一个知识。就在A课程文档。会有一段话跟提问相关,但还会召回其他的一个干扰知识。如其他文档里一些内容,像该课程适合3到7岁的小孩,适合6到8岁的女孩。这种知识内容也会被召回。
主要是期望的召回内容携带一部分干扰信息,这干扰信息没有A课程这个关键字,然后也不会召回回来。在这两个知识内容交给大源模型处理,他也无法理解哪个字内容是正确。
我们更希望在召回层面,就能有较好手段处理。工程化的实践里面,会对用户的进行改写,去增强query的一个效果。
然后也用到类似BM25这种倒排索引,提升关键字的权重。比如干扰知识里没生成这一个关键字,那它的相似度分数较低,就召不回来。
3.3 最后一个
可能有用户的提问是类似:服务器连接不上,应当如何解决?
现在给知识库里面注入的文档,都是类似连接服务器应该有哪些步骤。
- 第一个问题其实将这些知识内容召回,然后交给LLM也能引导用户。但并不能去直切要害,用户更希望,我现在连接不上了,我有什么样的一个排查手段。更好的还是通过提供一些专门QA文档,去增强整个知识召回内容准确性
- 第二个问题,用户可能会问一些跟他实例相关的问题。如CPU占用变高或内存变高,然后实际响应可能是我们支持文档里面的一些处理方案,就是我现在内存变更咋处理。但用户想知道为啥变高。有一个意图识别模型,判断我们现在用户他想要的问题具体是一个什么类的,需不需要用到RG,也是会去判断他是不是需要用到诊断引擎。类似问题2,需要用到诊断引擎的那我们会调用其他RCG无关的诊断相关技术为用户排查问题,并且给用户反馈一个结果。
4 如何提升RAG应用的效果
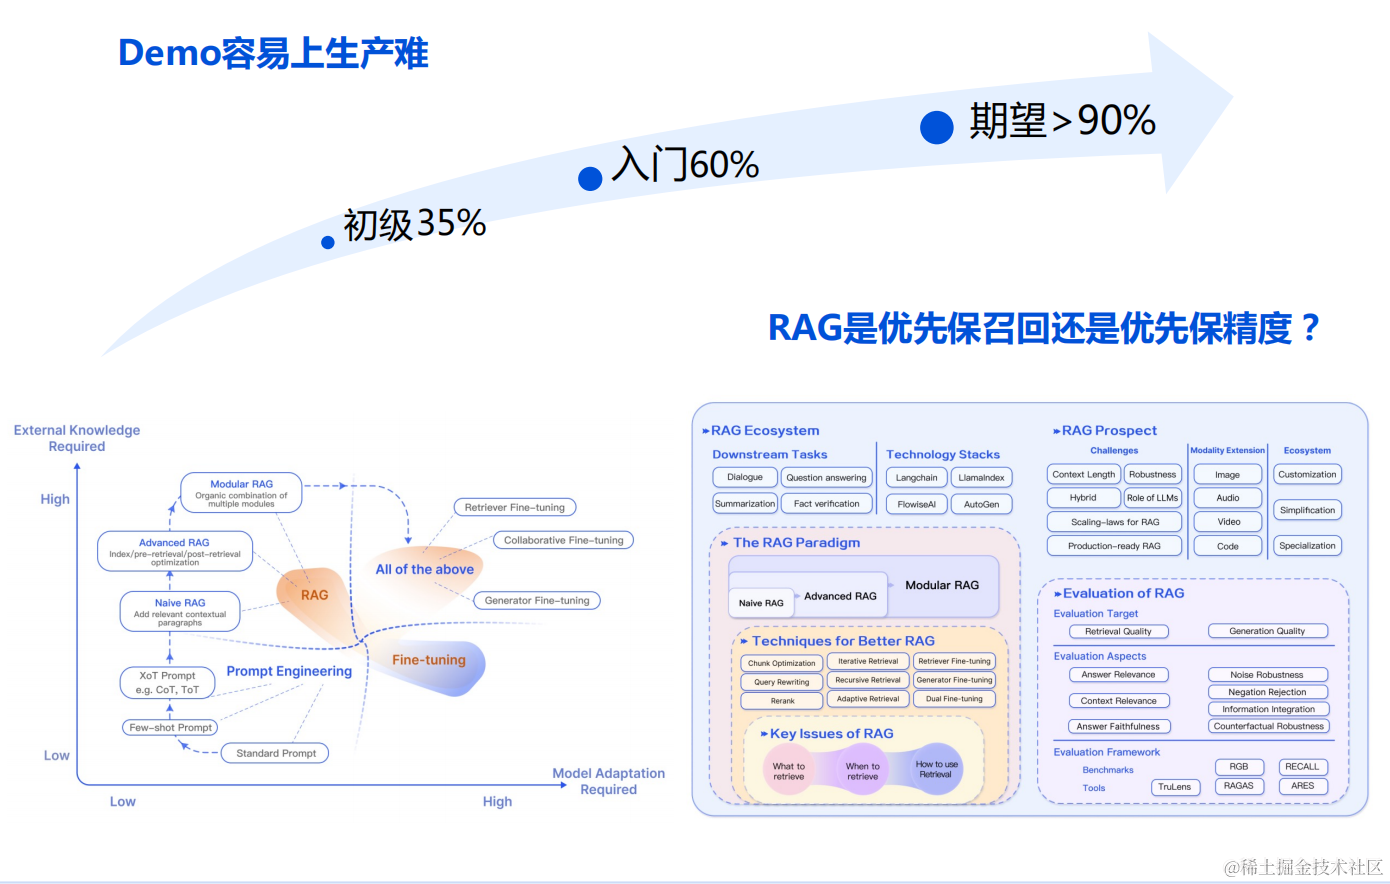
整体效果 = 文档处理效果 * Embedding效果 * Retrieval效果 * LLM效果。
demo易,但上手难的主要原因是因为像LangChain和 LLamIndex这种框架盛行。很快接入就是初级的一个状态,可能只能做到35%。如提高整体一个准确率,可通过在拆分那儿会拆更合理、提取内容时,把整个内容提取更好。做向量化时,去选择我们的向量,更好的一个embedding模型。在最终我们去跟LLM交流时,选择效果更好的LLM,然后把这个效果给提升到更高。但实际上60%的一个准确率还是达不到我们生产环境落地的一个期望值。希望准确率90%,在RAG应用构建的各个阶段,我们都会有很多工程化的一些手段实现。
可优化的效果的方式比较多,然后在整个课程里面我们也会去挑选一些核心关键的及怎么去把这个效果给做的更高。
目前RAG整体应用在界内的比较关注的一个地方就是在召回。因为涉及知识文档,思考方向:
- 优先保护保证这个召回率
- 优先保证这个精度
RAG召回回来是希望获得更多的跟用户提问相关的知识内容,还是说我只需要更关键的知识内容排在最顶。腾讯相关数据库的AI套件是选择前面这路,期望是召回回来更多跟用户相关的提问的内容。
精度尽量保证召回内容在top3、top5位置出现,因为召回的一些内容确实会有一部分干扰信息。但目前LLM 能力还可以,对这种干扰性信息的一个排除能力较好。
5 总结
如何系统的去学习AI大模型LLM ?
作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。
但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的 AI大模型资料 包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
所有资料 ⚡️ ,朋友们如果有需要全套 《LLM大模型入门+进阶学习资源包》,扫码获取~
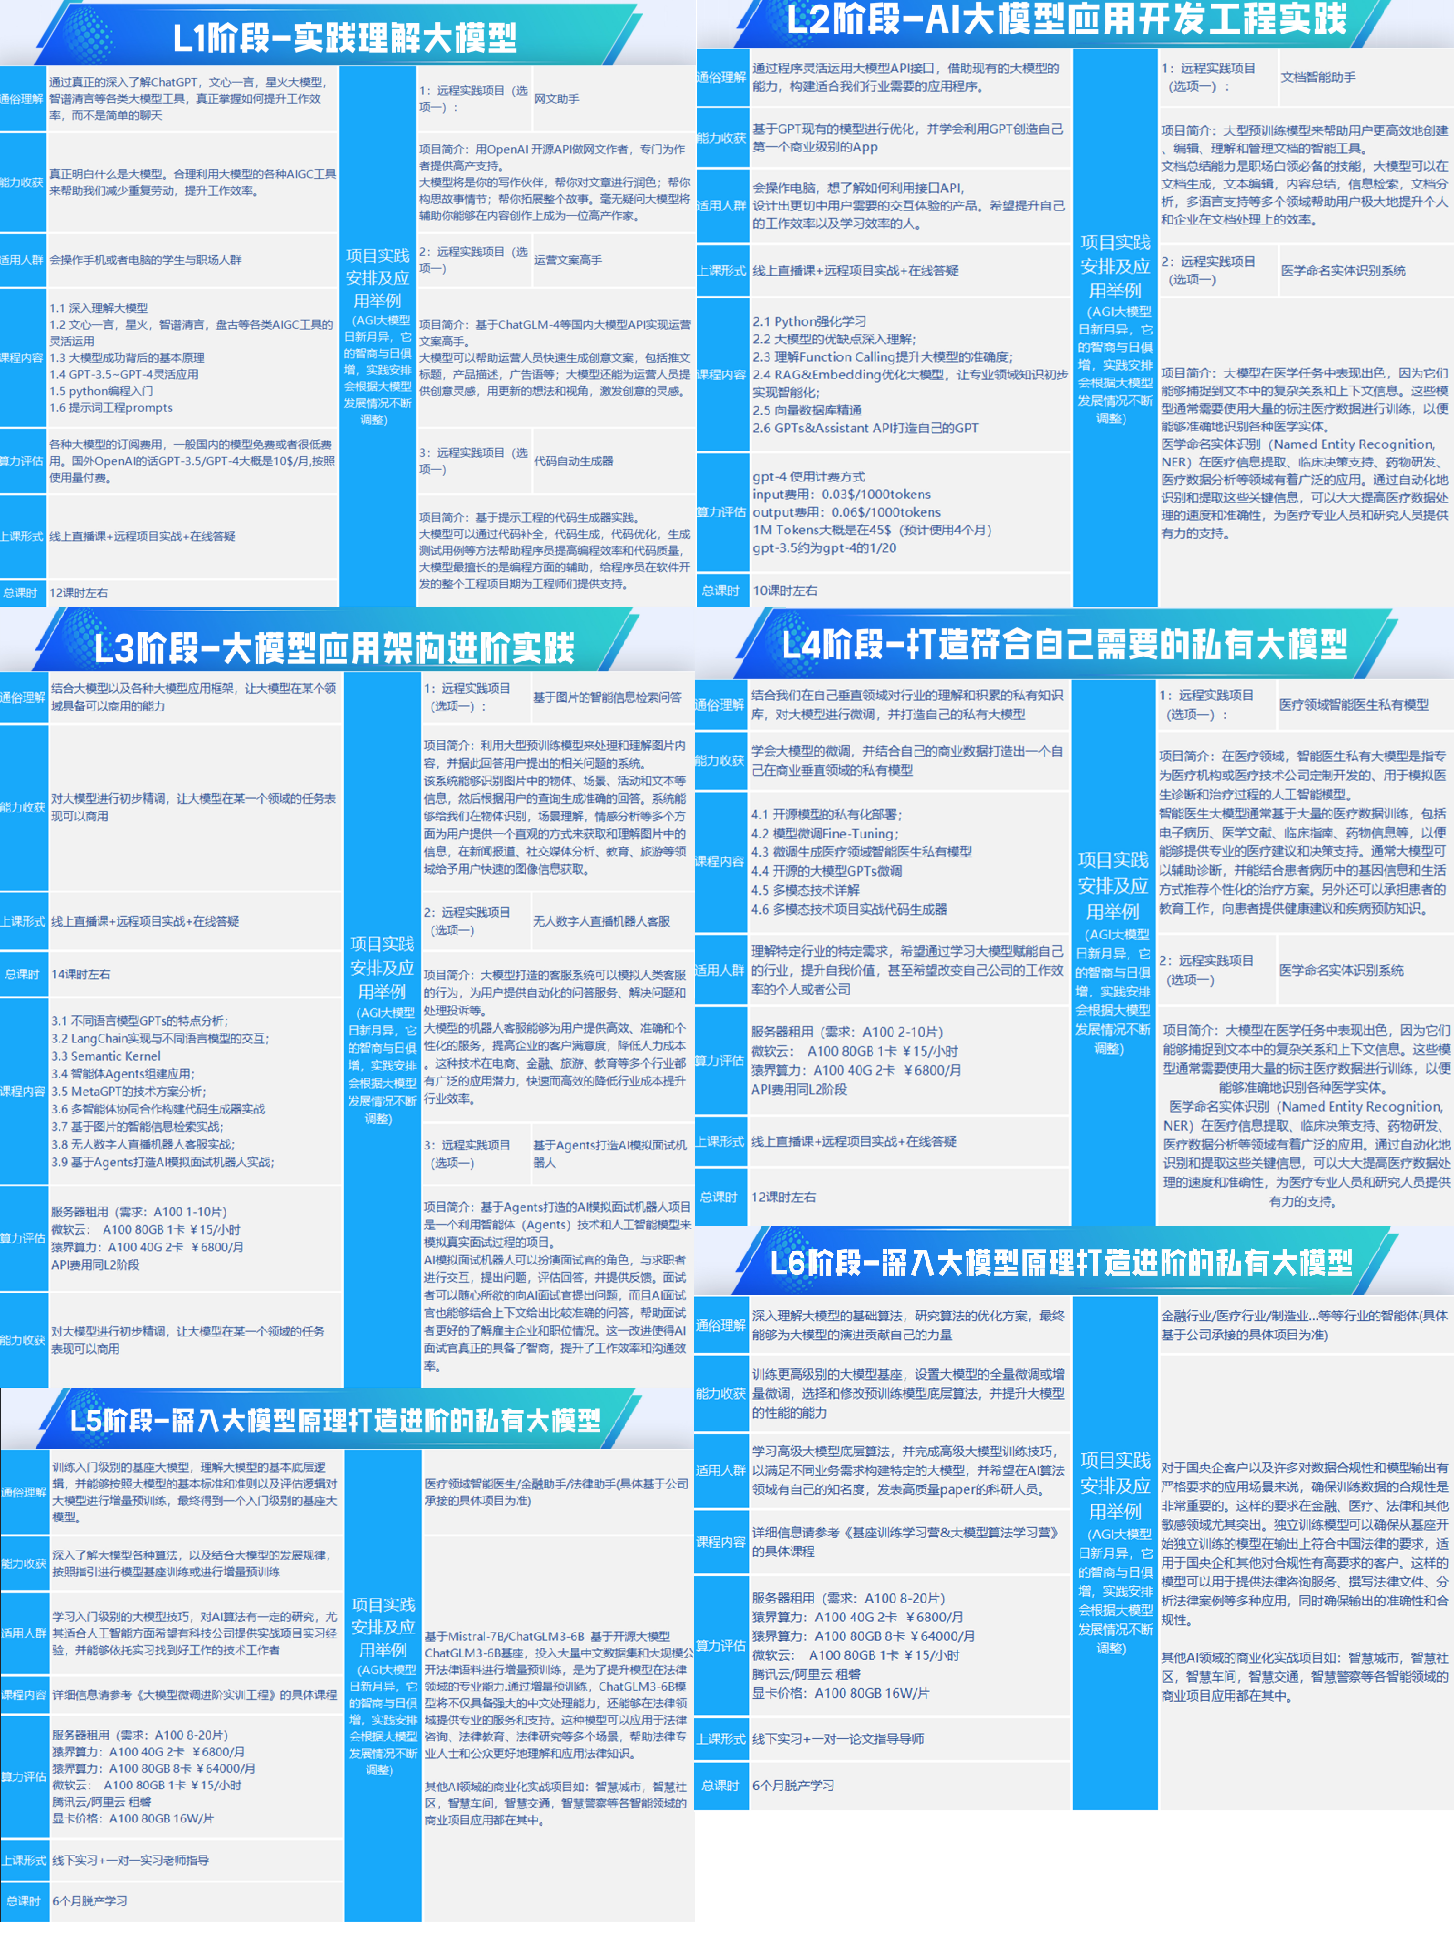
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案
阶段1:AI大模型时代的基础理解
- 目标:了解AI大模型的基本概念、发展历程和核心原理。
- 内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践 - L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
- 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
- 内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例 - L2.2 Prompt框架
- L2.2.1 什么是Prompt
- L2.2.2 Prompt框架应用现状
- L2.2.3 基于GPTAS的Prompt框架
- L2.2.4 Prompt框架与Thought
- L2.2.5 Prompt框架与提示词 - L2.3 流水线工程
- L2.3.1 流水线工程的概念
- L2.3.2 流水线工程的优点
- L2.3.3 流水线工程的应用 - L2.4 总结与展望
- L2.1 API接口
阶段3:AI大模型应用架构实践
- 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
- 内容:
- L3.1 Agent模型框架
- L3.1.1 Agent模型框架的设计理念
- L3.1.2 Agent模型框架的核心组件
- L3.1.3 Agent模型框架的实现细节 - L3.2 MetaGPT
- L3.2.1 MetaGPT的基本概念
- L3.2.2 MetaGPT的工作原理
- L3.2.3 MetaGPT的应用场景 - L3.3 ChatGLM
- L3.3.1 ChatGLM的特点
- L3.3.2 ChatGLM的开发环境
- L3.3.3 ChatGLM的使用示例 - L3.4 LLAMA
- L3.4.1 LLAMA的特点
- L3.4.2 LLAMA的开发环境
- L3.4.3 LLAMA的使用示例 - L3.5 其他大模型介绍
- L3.1 Agent模型框架
阶段4:AI大模型私有化部署
- 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
- 内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
学习计划:
- 阶段1:1-2个月,建立AI大模型的基础知识体系。
- 阶段2:2-3个月,专注于API应用开发能力的提升。
- 阶段3:3-4个月,深入实践AI大模型的应用架构和私有化部署。
- 阶段4:4-5个月,专注于高级模型的应用和部署。
这份完整版的所有 ⚡️ 大模型 LLM 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
全套 《LLM大模型入门+进阶学习资源包》↓↓↓ 获取~


 扫一扫


 7339

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


