


- 为什么需要输出解析器
在使用大语言模型的时候,无论是使用 LangChain,还是直接使用模型的 API,都会遇到大语言模型的输出解析问题. 模型输出是“自然语言”
大模型生成的内容通常是非结构化的自然语言,例如:
"好的,北京今天的天气是晴,气温25度。"
但是程序需要“结构化数据”,需要的是:
{
“city”: “北京”,
“weather”: “晴”,
“temperature”: 25
}
LangChain 提供了很多 OutputParser,可以自动把模型输出的自然语言变成结构化格式,比如:
- • 字典(Dict)
- • JSON
- • Pydantic 对象
- • 函数参数
- • SQL 查询语句
- • 正则提取结果
- • Markdown 表格解析
常见的输出解析器:
| 解析器 | 说明 | 示例输出 |
|---|---|---|
StrOutputParser | 原样输出字符串 | "你好,我是AI" |
RegexParser | 用正则提取结构 | 提取日期、数字等 |
StructuredOutputParser | 输出为 JSON 或 dict | {"city": "北京", "temp": 25} |
PydanticOutputParser | 输出为 Pydantic 对象 | Weather(city="北京", temp=25) |
CommaSeparatedListOutputParser | 输出为列表 | ["苹果", "香蕉", "橙子"] |
简单拆解: 输出解析器 = 预设提示 + 解析功能
输出解析器的解析场景:
-
- 将非结构化的文本转换为结构化的数据:将文本解析为一个 json 或者是 Python 里的字典等。
-
- 截取部分文本:只要结果中的某一部分即可。
-
- 自定义处理:在提示中注入其他的指令,告诉语言模型如何去给我返回一个格式的答案,然后解析
器可以根据返回提示文本对应的内容做对应的解析。
- 自定义处理:在提示中注入其他的指令,告诉语言模型如何去给我返回一个格式的答案,然后解析
-
OutputParser 输出解析器
在 LangChain 中预设了大量的输出解析器,可以从StrOutputParser:字符串输出解析器,将原有的内容完整输出。
在 LangChain 中,输出解析器通常包含两个抽象函数的实现,这也是自定义输出解析器需要实现的两个函数:
-
- get_format_instructions :用来约定输出的格式,并转换为描述文本。
-
- parse :用来解析 LLM 的输出为约定的格式。
但在实际的使用中,输出解析器大部分场景都是解析大语言模型的输出内容,所以可以直接使用invoke 函数进行调用,在 invoke 函数的底层,还是调用了 parse 函数进行解析。
在 LangChain 中 OutputParser 的基类及子类划分如下:

在这里插入图片描述
- parse :用来解析 LLM 的输出为约定的格式。
2.1 StrOutputParser
StrOutputParser 是 LangChain 中使用频率最高的输出解析器,使用也非常简单,将传入的文本原样返
回,用于解析得到 AIMessage 中的输出文本,使用示例如下:
from langchain_core.output_parsers import StrOutputParserStrOutputParser().parse("动画梦工厂")
2.2 JsonOutputParser
JsonOutputParser 用于将对应的 LLM 输出转换为特定格式的 json 或 Python 字典,在使用前必须定义BaseModel 类,告知解析器需要解析的数据结构,并将解析器提供的描述文本嵌入到提示中,使用示例如下:
import dotenvfrom langchain_core.output_parsers import JsonOutputParserfrom langchain_core.prompts import ChatPromptTemplatefrom langchain_core.pydantic_v1 import BaseModel, Fieldfrom langchain_openai import ChatOpenAIdotenv.load_dotenv()# 1.构建输出json格式类classJoke(BaseModel):joke: str = Field(description="回答用户的冷笑话")punchline: str = Field(description="冷笑话的笑点")# 2.编排提示词prompt = ChatPromptTemplate.from_template("回答用户的问题。\n{format_instructions}\n{query}\n")# 3.构建大语言模型llm = ChatOpenAI(model="gpt-3.5-turbo-16k")# 4.创建json输出解析器parser = JsonOutputParser(pydantic_object=Joke)# 5.将格式描述嵌入到prompt中prompt = prompt.partial(format_instructions=parser.get_format_instructions())# 6.调用模型并解析prompt_value = prompt.invoke({"query": "请讲一个关于程序员的冷笑话"})print("prompt_value:", prompt_value.to_string())ai_message = llm.invoke(prompt_value)print("ai_message:", ai_message)joke_json = parser.invoke(ai_message)print("joke_json:", joke_json)
- 备注
-
- 如果 OutputParser 输出解析失败了,该如何解决?有几种解决方案?
当使用 OutputParser(输出解析器)时,如果解析失败(比如模型返回的格式不符合预期),你可能会遇到如下错误:
- 如果 OutputParser 输出解析失败了,该如何解决?有几种解决方案?
OutputParserException: Failed to parse LLM output...
这是一个比较常见的问题,尤其是在使用结构化输出(如 JSON、Pydantic)时。下面是常见的 原因分析 和 解决方案。
-
- 模型输出格式不规范
- • 模型输出了多余的解释性文字、换行、注释等。
- • 没有严格按照你要求的格式返回。
-
- Prompt 提示词不清晰
- • 没有告诉模型“你必须返回 JSON 格式”或“不要输出任何解释”。
-
- 模型能力限制
- • 有些模型(尤其是小模型)对格式控制不强,容易输出错乱格式。
-
- OutputParser 本身限制
- • 有些解析器(如
StructuredOutputParser)要求严格的 JSON 格式,不能容忍多余字符。
1. 使用 get_format_instructions() 提示词
适用解析器:StructuredOutputParser, PydanticOutputParser, 等
format_instructions = parser.get_format_instructions()prompt = f"""你是一个天气助手,请根据用户输入返回城市天气信息。{format_instructions}用户输入:北京的天气如何?"""
说明:这是最推荐的方法,LangChain 的解析器会自动生成提示词,指导模型输出正确格式。
2. 使用 OutputFixingParser 自动修复输出
适用解析器:几乎所有结构化解析器
from langchain.output_parsers import OutputFixingParserfrom langchain.chat_models import ChatOpenAI# 假设你已有一个 StructuredOutputParserfixing_parser = OutputFixingParser.from_parser(parser, llm=ChatOpenAI())# 使用 fixing_parser.parse(output) 自动尝试修复格式错误
优点:即使模型输出不规范,也能尝试用大模型“修复”成正确格式。
3. 使用 Guardrails 或 JsonFormer 等工具限制输出结构
适用场景:对输出结构要求非常严格的生产环境。
- • Guardrails:通过 JSON schema + LLM 约束输出。
- • JsonFormer:通过 tokenizer 控制生成结构。
⚠️ 缺点:集成成本稍高。
4. 使用正则解析器(RegexParser)容错性更强
如果你不要求严格结构化,可以尝试用正则提取关键字段:
from langchain.output_parsers import RegexParserparser = RegexParser( regex=r"城市:(.*),天气:(.*),温度:(\d+)", output_keys=["city", "weather", "temperature"])
优点:易容错,适合轻量级提取。
5. 手动预处理模型输出(兜底方案)
如果以上都失败了,可以:
- • 手动清洗模型输出(去除解释性文字、换行)
- • 使用
json.loads()做容错解析 - • 加入异常捕获逻辑,提示用户或重试调用模型
try: result = parser.parse(output)except Exception as e: print("解析失败,尝试 fallback 逻辑") # fallback 方案
| 方法编号 | 方法名称 | 适用场景 |
|---|---|---|
| ✅ 1 | 使用 get_format_instructions() | 提示模型输出标准格式 |
| ✅ 2 | 使用 OutputFixingParser | 自动修复模型输出 |
| ✅ 3 | 使用 Guardrails 或 JsonFormer | 严格结构输出 |
| ✅ 4 | 使用 RegexParser | 容错性更强的字段提取 |
| ✅ 5 | 手动预处理 + 异常捕获 | 兜底方案 |
-
- 针对小参数的模型,并且没有函数/工具回调,哪一类输出解析器会更稳定?
非常好的问题!当你使用的是 小参数模型(如通义千问 Qwen-1.8B、LLaMA-7B、ChatGLM2-6B 等),并且 没有函数调用(function call)或工具回调(tool calling)支持的情况下,模型在结构化输出方面的稳定性会受到明显影响。
- 针对小参数的模型,并且没有函数/工具回调,哪一类输出解析器会更稳定?
推荐使用的输出解析器(稳定性从高到低)
| 输出解析器类型 | 稳定性 | 特点说明 |
|---|---|---|
StrOutputParser | ⭐⭐⭐⭐⭐ | 最稳定,直接输出原始字符串 |
RegexParser | ⭐⭐⭐⭐ | 容错性高,适合提取关键词/字段 |
CommaSeparatedListOutputParser | ⭐⭐⭐⭐ | 稳定性较好,适合列表提取 |
StructuredOutputParser | ⭐⭐ | 对格式要求严格,容易失败 |
PydanticOutputParser | ⭐ | 最易失败,对小模型不友好 |
推荐顺序说明(适用于小模型 + 无函数调用)
1. StrOutputParser(最稳定)
- • 适用场景:你只需要获取模型自然语言回复,不关心结构。
- • 示例输出:
"你好,我是AI助手,很高兴为你服务!"
✅ 稳定性极高,小模型几乎不会出错。
2. RegexParser(推荐)
-
• 适用场景:你只需要从输出中提取几个关键词或字段。
-
• 示例输出:```plaintext
城市:北京,天气:晴,温度:25℃ -
• 正则提取:```plaintext
RegexParser( regex=r"城市:(.),天气:(.),温度:(\d+)", output_keys=[“city”, “weather”, “temperature”])
容错能力强,即使模型多输出了一些解释性文字,也可以提取目标字段。
3. CommaSeparatedListOutputParser
-
• 适用场景:你让模型输出一个列表,比如推荐、关键词、选项。
-
• 示例输出:```plaintext
苹果, 香蕉, 橙子 -
• 解析结果:```plaintext
[“苹果”, “香蕉”, “橙子”]
稳定性较好,只要提示词设计合理,小模型也能正确输出。
4. ⚠️ StructuredOutputParser(不推荐)
- • 问题:小模型容易输出不规范 JSON,例如:
- • 多了注释、换行
- • 缺少引号、逗号
- • 输出为类自然语言描述,而不是 JSON
❌ 如果你不使用
OutputFixingParser或Guardrails,容易解析失败。
5. ❌ PydanticOutputParser(最不推荐)
- • 问题:
- • 需要模型输出严格的 Python 对象格式,比如
Weather(city="北京", temp=25) - • 小模型很难稳定输出这种结构,几乎每次都会出错
🧠 提示词建议(适用于小模型)
无论你使用哪种解析器,提示词设计非常关键。以下是建议模板:
请严格按照以下格式输出,不要添加任何额外说明:城市:<城市名>天气:<天气状况>温度:<温度数字>℃
小模型提示词要“傻瓜式”明确,强调“不要添加解释”、“只输出结构”。
总结:小模型 + 无函数调用,推荐解析器优先级
| 优先级 | 解析器类型 | 是否推荐 | 说明 |
|---|---|---|---|
| 1️⃣ | StrOutputParser | ✅ 强烈推荐 | 最稳定 |
| 2️⃣ | RegexParser | ✅ 推荐 | 容错强 |
| 3️⃣ | CommaSeparatedListOutputParser | ✅ 推荐 | 简单列表 |
| 4️⃣ | StructuredOutputParser | ⚠️ 慎用 | 容易失败 |
| 5️⃣ | PydanticOutputParser | ❌ 不推荐 | 小模型难以生成结构化对象 |
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
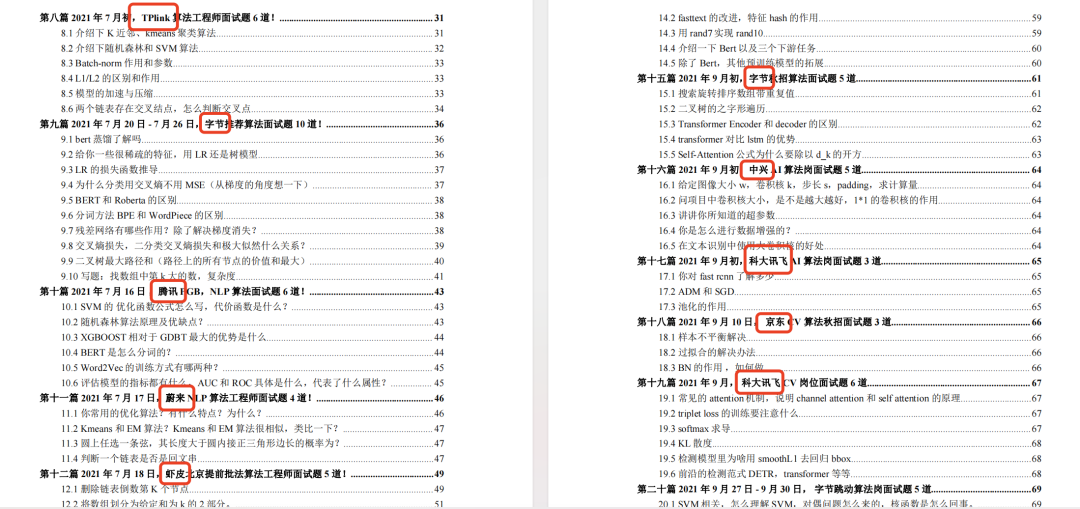
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
2. 102 道 AI 大模型真题:直击大模型核心考点
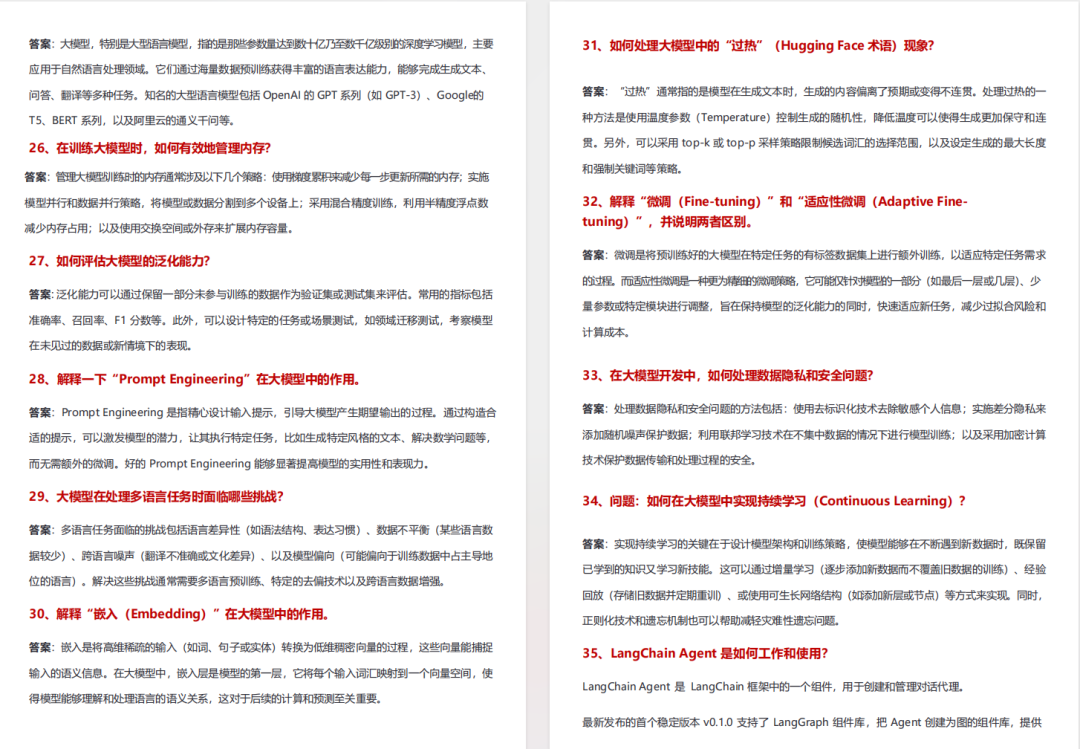
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
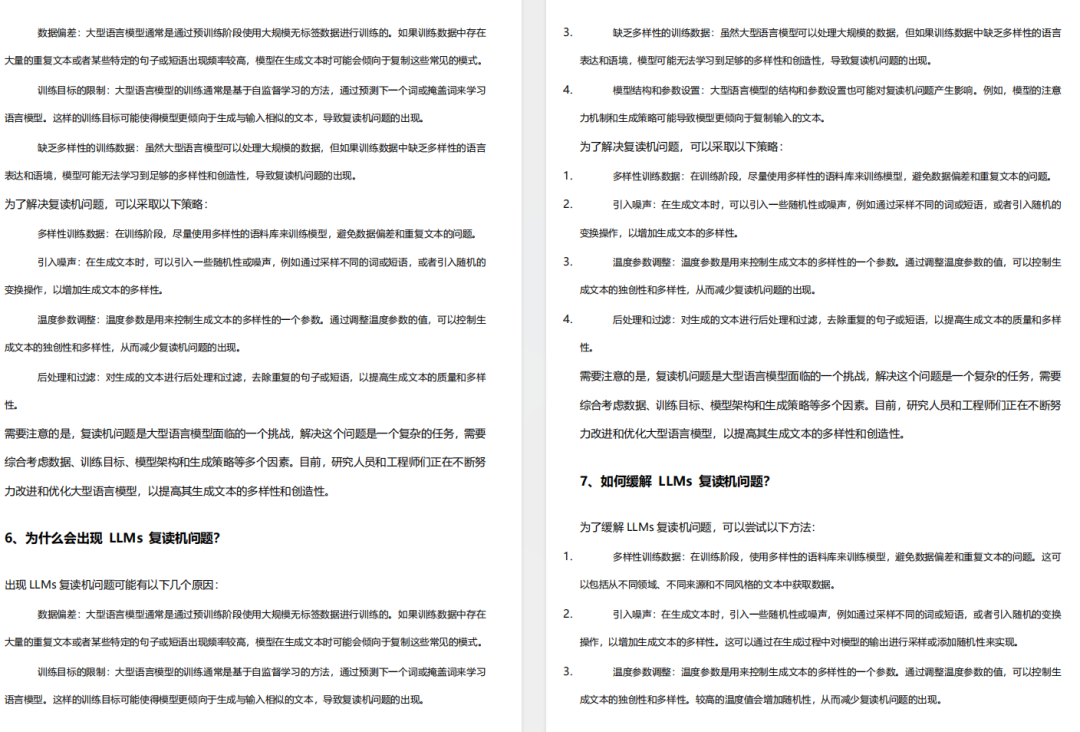
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
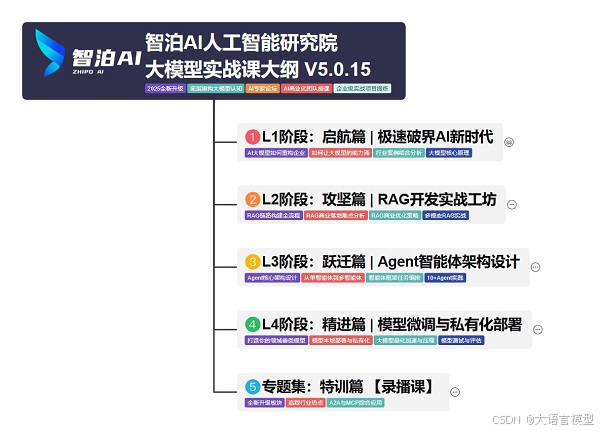
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
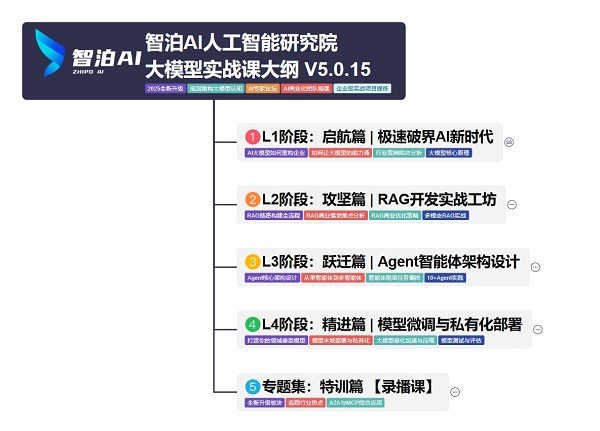
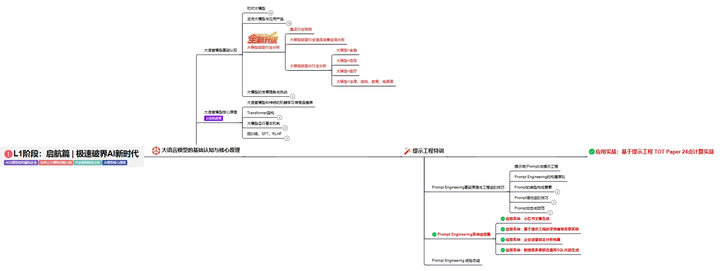
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
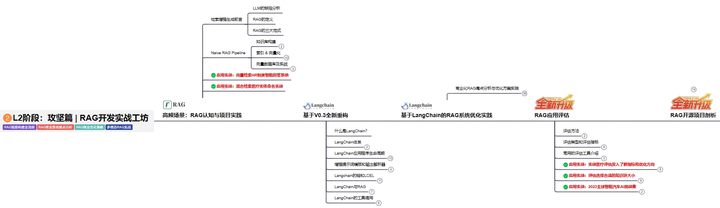
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
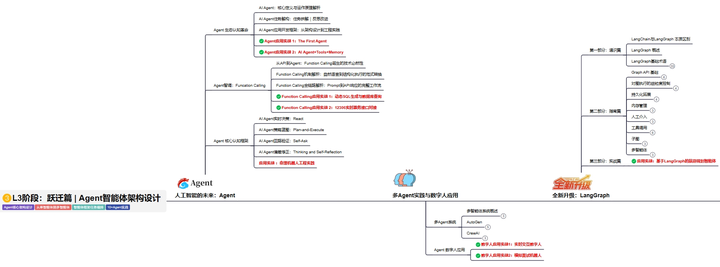
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
L4阶段:精进篇丨模型微调与私有化部署
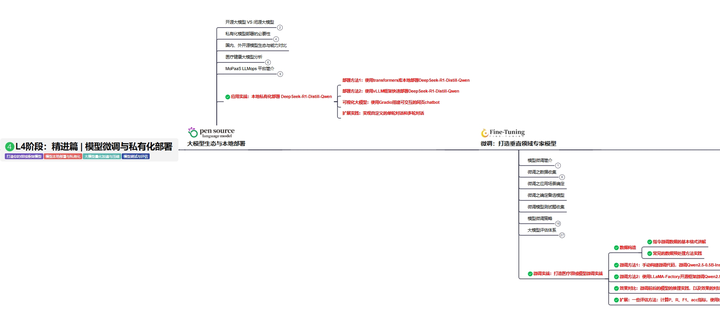
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
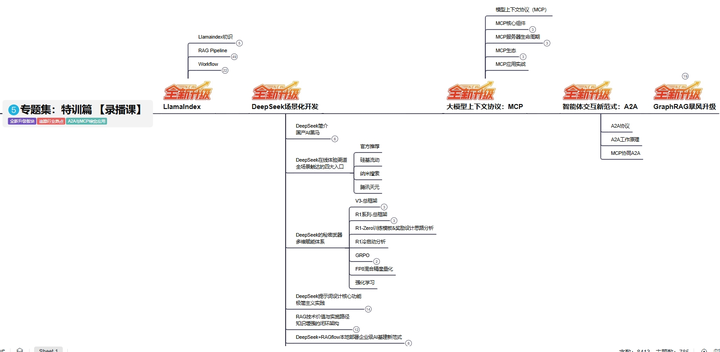
L5阶段:专题集丨特训篇 【录播课】
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 933


 扫一扫


——OutputParser 组件及使用技巧&spm=1001.2101.3001.11974&articleId=153622137&d=1&t=3&u=7a4e238d85214cdeb5663d20fe094b94)

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


