


HuggingGPT是一个结合了ChatGPT和Hugging Face平台上的各种专家模型,以解决复杂的AI任务,可以认为他是一种结合任务规划和工具调用两种Agent工作流的框架。它的工作流程主要分为以下几个步骤:
- 任务规划:使用ChatGPT分析用户的请求,理解他们的意图,并将其分解为可能可解决的任务。
- 模型选择:为了完成规划的任务,ChatGPT根据模型的描述选择托管在Hugging Face上的专家模型。
- 任务执行:调用并执行每个选定的模型,然后将结果返回给ChatGPT。
- 响应生成:最后,使用ChatGPT整合所有模型的预测结果,并生成响应。

光说不练假把式,我们先尝试运行,然后逐步分析各个阶段的Prompt设计和代码设计。
1. 运行
下载Repo git clone https://github.com/microsoft/JARVIS.git
1.1 安装依赖
安装server依赖
bash
复制代码
cd JARVIS/hugginggpt/server
conda create -n jarvis python=3.8
conda activate jarvis
pip install -r requirements.txt
安装前端页面
bash
复制代码
cd ../web
npm install
注意,requirment.txt中的的werkzeug要更新为Werkzeug==2.2.2,否则Flask会报不兼容问题。这里没有安装pytorch之类的,因为我们不打算在本地下载模型,所需空间过于巨大,直接访问线上的模型。
1.2 修改配置
既然需要在线使用HuggingGPT的模型,那么我们需要到HuggingGPT上申请Token。修改server/configs/config.lite.yaml,更新huggingface token。另外我们要使用本地的LLM模型,需要修改openai->api_key,必须添加sk开头的字符串,不然报错。必须添加local->endpoint, 就是你本地openai的地址。此外,你可能还要修改是否采用续写use_completion和模型。如果无法访问HuggingGPT你还需要添加proxy。
yaml
复制代码
openai:
  api_key: sk-xxxx # added
huggingface:
  token: hf_xxx # updated
dev: true
debug: false
log_file: logs/debug.log
model: gpt-3.5-turbo # updated
use_completion: false # updated
inference_mode: huggingface # local, huggingface or hybrid, prefer hybrid
local_deployment: minimal # minimal, standard or full, prefer full
num_candidate_models: 5
max_description_length: 100
proxy: http://127.0.0.1:7890 # optional: your proxy server "http://ip:port"
local:
  endpoint: http://localhost:11434 # updated
...
此外,还需要修改server/awsome_chat.py,添加API_KEY否则也无法运行本地LLM。
python
复制代码
if API_TYPE == "local":
     API_ENDPOINT = f"{config['local']['endpoint']}/v1/{api_name}"
+    API_KEY = config['openai']['api_key']
1.2 运行
开始运行
bash
复制代码
python  --config configs/config.lite.yaml --mode server
npm run dev
然后我们打开浏览器http://localhost:9999/#/, 出现类似下图的窗口。

输入类似
describe the image /examples/c.jpg.
其中examples位于是hugginggpt/server/public/examples/,所以如果你要测试自己的图片,可以考虑将图片放在这儿。会输出类似如下图的结果。

2. 分析
在文章开头我们有说过,任务是分为规划任务、选择模型、执行任务和生成响应。那么我们先从任务规划看起。
2.1 任务规划
任务规划需要LLM进行推理分解任务,对于这样一个将HuggingFace当做调用工具的框架,我们要如何设计Prompt?几个原则
- 说明任务
- 说明任务的输入输出
- Few-Shot示例
- 上下文
- 用户输入
此外,我们还需要将HuggingFace所包含的API给到LLM,进行推理用户问题所需任务步骤。我们当然不可能将所有HuggingFace上的Model都提供给LLM,所以我们提供任务类型,huggingface上大约有19个任务类型, 其中15个NLP任务类型,2个Audio任务类型,3个CV的任务类型。
我觉得这里通过任务类型缩小LLM选择工具选择范围,之后再通过任务类型,然后再让LLM选择具体的模型,相当于一种摘要技术,从大类选择,在缩小到具体选择。你要知道hugginggpt在p0_models.jsonl中缓存了大约673个任务,你不可能将他们所有的描述都发送给LLM,它包含2765000个字符。
说明任务,在输出上对LLM有强烈的要求,除了要求是JSON,而且要求推理各个任务的依赖关系,并且填充类似的JSON输出。然而我要说的这种复杂的输出要求,当前只能用于Demo,否则你会遇到非常多的解析,无法获得想要的JSON格式,或者丢失特定的字段
json
复制代码
The AI assistant can parse user input to several tasks: [{"task": task, "id": task_id, "dep": dependency_task_id, "args": {"text": text or <GENERATED>-dep_id, "image": image_url or <GENERATED>-dep_id, "audio": audio_url or <GENERATED>-dep_id}}].
说明任务的输入和输出,除了上文说的解释任务依赖关系和如何生成tasks之外,这里设定了task必须是HuggingFace支持的这些类别,args必须是text、imag和audio。还是老话,要求越多失败越多,我就遇到args偶尔缺失,task偶尔不对的问题。
json
复制代码
The special tag "<GENERATED>-dep_id" refer to the one generated text/image/audio in the dependency task (Please consider whether the dependency task generates resources of this type.) and "dep_id" must be in "dep" list. The "dep" field denotes the ids of the previous prerequisite tasks which generate a new resource that the current task relies on. The "args" field must in ["text", "image", "audio"], nothing else. The task MUST be selected from the following options: "token-classification", "text2text-generation", "summarization", "translation", "question-answering", "conversational", "text-generation", "sentence-similarity", "tabular-classification", "object-detection", "image-classification", "image-to-image", "image-to-text", "text-to-image", "text-to-video", "visual-question-answering", "document-question-answering", "image-segmentation", "depth-estimation", "text-to-speech", "automatic-speech-recognition", "audio-to-audio", "audio-classification", "canny-control", "hed-control", "mlsd-control", "normal-control", "openpose-control", "canny-text-to-image", "depth-text-to-image", "hed-text-to-image", "mlsd-text-to-image", "normal-text-to-image", "openpose-text-to-image", "seg-text-to-image".
让LLM推理规划,这里有个魔法Think step by step。
bash
复制代码
There may be multiple tasks of the same type. Think step by step about all the tasks needed to resolve the user's request. Parse out as few tasks as possible while ensuring that the user request can be resolved. Pay attention to the dependencies and order among tasks. If the user input can't be parsed, you need to reply empty JSON [], otherwise you must return JSON directly.
设定Few shot examples,大约有6个,考虑阅读体验,这里只放一个,更多的Few shot examples位于hugginggpt/server/demos/demo_parse_task.json。
json
复制代码
[
    {
        "role": "user",
        "content": "Give you some pictures e1.jpg, e2.png, e3.jpg, help me count the number of sheep?"
    },
    {
        "role": "assistant",
        "content": "[{"task": "image-to-text", "id": 0, "dep": [-1], "args": {"image": "e1.jpg" }}, {"task": "object-detection", "id": 1, "dep": [-1], "args": {"image": "e1.jpg" }}, {"task": "visual-question-answering", "id": 2, "dep": [1], "args": {"image": "<GENERATED>-1", "text": "How many sheep in the picture"}} }}, {"task": "image-to-text", "id": 3, "dep": [-1], "args": {"image": "e2.png" }}, {"task": "object-detection", "id": 4, "dep": [-1], "args": {"image": "e2.png" }}, {"task": "visual-question-answering", "id": 5, "dep": [4], "args": {"image": "<GENERATED>-4", "text": "How many sheep in the picture"}} }}, {"task": "image-to-text", "id": 6, "dep": [-1], "args": {"image": "e3.jpg" }},  {"task": "object-detection", "id": 7, "dep": [-1], "args": {"image": "e3.jpg" }}, {"task": "visual-question-answering", "id": 8, "dep": [7], "args": {"image": "<GENERATED>-7", "text": "How many sheep in the picture"}}]"
    },
    ...
]
最后上下文和用户输入,没什么好说的
json
复制代码
The chat log [ {{context}} ] may contain the resources I mentioned. Now I input { {{input}} }. Pay attention to the input and output types of tasks and the dependencies between tasks.
任务规划阶段的Promt就已经结束了,代码实现上这一段较为简单,核心流程是chat->chat_huggingface->parse_task->send_request。其中parse_task负责组装prompt和构造open ai API所需的data参数。这里有一个简易的对话上下文移动窗口,就是计算历史对话文本的tokens,如果超过最大token就尝试pop掉最后一个,这是移除最近的对话记录保留开始的策略,当然你也可以尝试其他策略。
python
复制代码
    # cut chat logs
    start = 0
    while start <= len(context):
        history = context[start:]
        prompt = replace_slot(parse_task_prompt, {
            "input": input,
            "context": history
        })
        messages.append({"role": "user", "content": prompt})
        history_text = "<im_end>\nuser<im_start>".join([m["content"] for m in messages])
        num = count_tokens(LLM_encoding, history_text)
        if get_max_context_length(LLM) - num > 800:
            break
        messages.pop()
        start += 2
2.2 模型选择
在上文parse_task完成后,在chat_huggingface中就会对返回的结果进行任务解析,此时由于LLM回复的不确定性,有时候你会遇到失败无法解析或者丢失字段,一个成功的任务会返回类似如下的JSON。
json
复制代码
[
  {'task': 'object-detection', 'id': 0, 'dep': [-1], 'args': {'image': '/examples/a.jpg'}},
  {'task': 'image-to-image', 'id': 1, 'dep': [-1], 'args': {'image': '/examples/a.jpg'}}
]
根据task信息,在run_task中根据task值去hugginggpt/server/data/p0_models.jsonl这个json中去搜索前10的具体模型,最后根据类型查找到可用模型如下。
python
复制代码
{'local': [], 'huggingface': ['hustvl/yolos-tiny', 'microsoft/table-transformer-structure-recognition', 'facebook/detr-resnet-50', 'TahaDouaji/detr-doc-table-detection', 'hustvl/yolos-small']}
这里在选择模型时候,需要修改一下代码否则你几乎获取不到任何一个可用模型。
进入函数choose_model再次构造Prompt,让LLM帮助决策哪个模型更好, 以下prompt只是示意,因为源代码将其转换为了role content组成的arraylist。
vbnet
复制代码
System: Given the user request and the parsed tasks, the AI assistant helps the user to select a suitable model from a list of models to process the user request. The assistant should focus more on the description of the model and find the model that has the most potential to solve requests and tasks. Also, prefer models with local inference endpoints for speed and stability.
[
User: {{input}},
Assistant: {{task}}..
]
User: Please choose the most suitable model from {{metas}} for the task {{task}}. The output must be in a strict JSON format: {"id": "id", "reason": "your detail reasons for the choice"}, the id in JSON must be the one provided in the model description.
输出如下,已经给出了最佳的模型和原因,接下来进入模型执行。
json
复制代码
{"id": "facebook/detr-resnet-50", "reason": "The model has the highest number of likes, and the description sounds promising with end-to-end detection using transformers. Also, it has a local inference endpoint for faster access."}
2.3 模型执行
上面模型已经选择,输入也有,接下来就是执行模型,这一步比较简单,就是构造huggingface api的请求。
python
复制代码
inference_result = model_inference(best_model_id, args, hosted_on, command['task'])
HuggingFace API的请求较为简单,只要你拥有Token,你甚至可以通过curl直接运行。
kotlin
复制代码
curl --location 'https://api-inference.huggingface.co/models/facebook/detr-resnet-50-panoptic' \
--header 'Authorization: Bearer replacewithyourowntoken' \
--header 'Content-Type: image/jpeg' \
--data '@/Users/xxxx/dc579d59_track_0.jpg'
由于可能包含多个任务,所以任务是通过thread并发执行的,最后通过queue进行收取结果如下所示。
python
复制代码
{'generated image': '/images/a59b.jpg', 'predicted': [{'score': 0.9699670672416687, 'label': 'potted plant', 'box': {'xmin': 0, 'ymin': 240, 'xmax': 187, 'ymax': 484}}, {'score': 0.9995023012161255, 'label': 'cat', 'box': {'xmin': 165, 'ymin': 59, 'xmax': 645, 'ymax': 522}}]}
DEBUG:__main__:{1: {'task': {'task': 'image-to-image', 'id': 1, 'dep': [-1], 'args': {'image': 'public//examples/a.jpg'}}, 'inference result': {'error': 'Model lambdalabs/sd-image-variations-diffusers is currently loading', 'estimated_time': 248.20472717285156}, 'choose model result': {'id': 'lambdalabs/sd-image-variations-diffusers', 'reason': "The model has the most likes and it's also the only model with the tag 'stable-diffusion', which indicates it's a robust and popular choice for various image tasks."}}, 0: {'task': {'task': 'object-detection', 'id': 0, 'dep': [-1], 'args': {'image': 'public//examples/a.jpg'}}, 'inference result': {'generated image': '/images/a59b.jpg', 'predicted': [{'score': 0.9699670672416687, 'label': 'potted plant', 'box': {'xmin': 0, 'ymin': 240, 'xmax': 187, 'ymax': 484}}, {'score': 0.9995023012161255, 'label': 'cat', 'box': {'xmin': 165, 'ymin': 59, 'xmax': 645, 'ymax': 522}}]}, 'choose model result': {'id': 'facebook/detr-resnet-50', 'reason': 'The model has the highest number of likes, and the description sounds promising with end-to-end detection using transformers. Also, it has a local inference endpoint for faster access.'}}}
2.4 响应生成
在chat_huggingface中调用response_results,给定input和收集的results来构造类似如下所示的Prompt,其中processes就是上文模型执行的结果。该prompt先给定输入的问题和模型执行的结果,然后要求LLM仔细甄别输出的推测结果和问题是否匹配,然后进行作答。最后要求输出的它的工作流,包括使用的模型和推测结果和生成的文件位置等信息。
vbscript
复制代码
System: #4 Response Generation Stage: With the task execution logs, the AI assistant needs to describe the process and inference results.
User: Look at /examples/a.jpg picture, can you tell me how many objects in the picture? Give me a picture similar to this one.
Assitant: Before give you a response, I want to introduce my workflow for your request, which is shown in the following JSON data: {{processes}}. Do you have any demands regarding my response?
User: Yes. Please first think carefully and directly answer my request based on the inference results. Some of the inferences may not always turn out to be correct and require you to make careful consideration in making decisions. Then please detail your workflow including the used models and inference results for my request in your friendly tone. Please filter out information that is not relevant to my request. Tell me the complete path or urls of files in inference results. If there is nothing in the results, please tell me you can't make it.
最终LLM输入如下响应
json
复制代码
Sure! Based on the inference results, there are two objects in the picture "/examples/a.jpg". They are a potted plant and a cat.
For your second request, after reviewing the available options, I've selected a similar image using a model with the ID "facebook/detr-resnet-50". This model identified a similar image with the path: "/images/a59b.jpg".
The workflow goes like this:
1. Object Detection: I used a model called "facebook/detr-resnet-50" to detect objects in your image. It's an end-to-end model that uses transformers and has shown great performance. It successfully identified two objects for us.
2. Image Similarity: To find a similar image, I picked another pre-trained model called "lambdalabs/sd-image-variations-diffusers". This model is known to create variations of input images while keeping the main content stable. It's a diffusion-based model, and these types of models are good at generating new content with preserving the essence of the original image.
However, I need to let you know that getting the similar image didn't work this time. The inference took longer than expected, which is not uncommon for some complex models, and eventually timed out. So, unfortunately, I couldn't generate a similar image within the given constraints.
I hope this helps! Let me know if you'd like more details on any specific steps or have additional questions.
3. 总结
纵观整个流程其实主要还是Prompt的设计,如何设计更好的Prompt生成任务规划、模型选择和响应生成。在这种中间就是各种结果的解析工作,以及调用各种工具完成任务。值得一说的是,我在实验过程中,遇到各种各样的错误,尤其是第一阶段的任务规划中的任务输出,它对LLM的要求非常高,如果你只是本地的小模型或许是难以胜任的。第二,当你有很多工具选择,不妨将他们先进行分类,让LLM先从分类中选择,然后筛选出缩小后具体的工具列表,再次给到LLM选择最优最匹配的工具。
如何系统的去学习大模型LLM ?
作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。
但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的 AI大模型资料 包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
😝有需要的小伙伴,可以V扫描下方二维码免费领取🆓

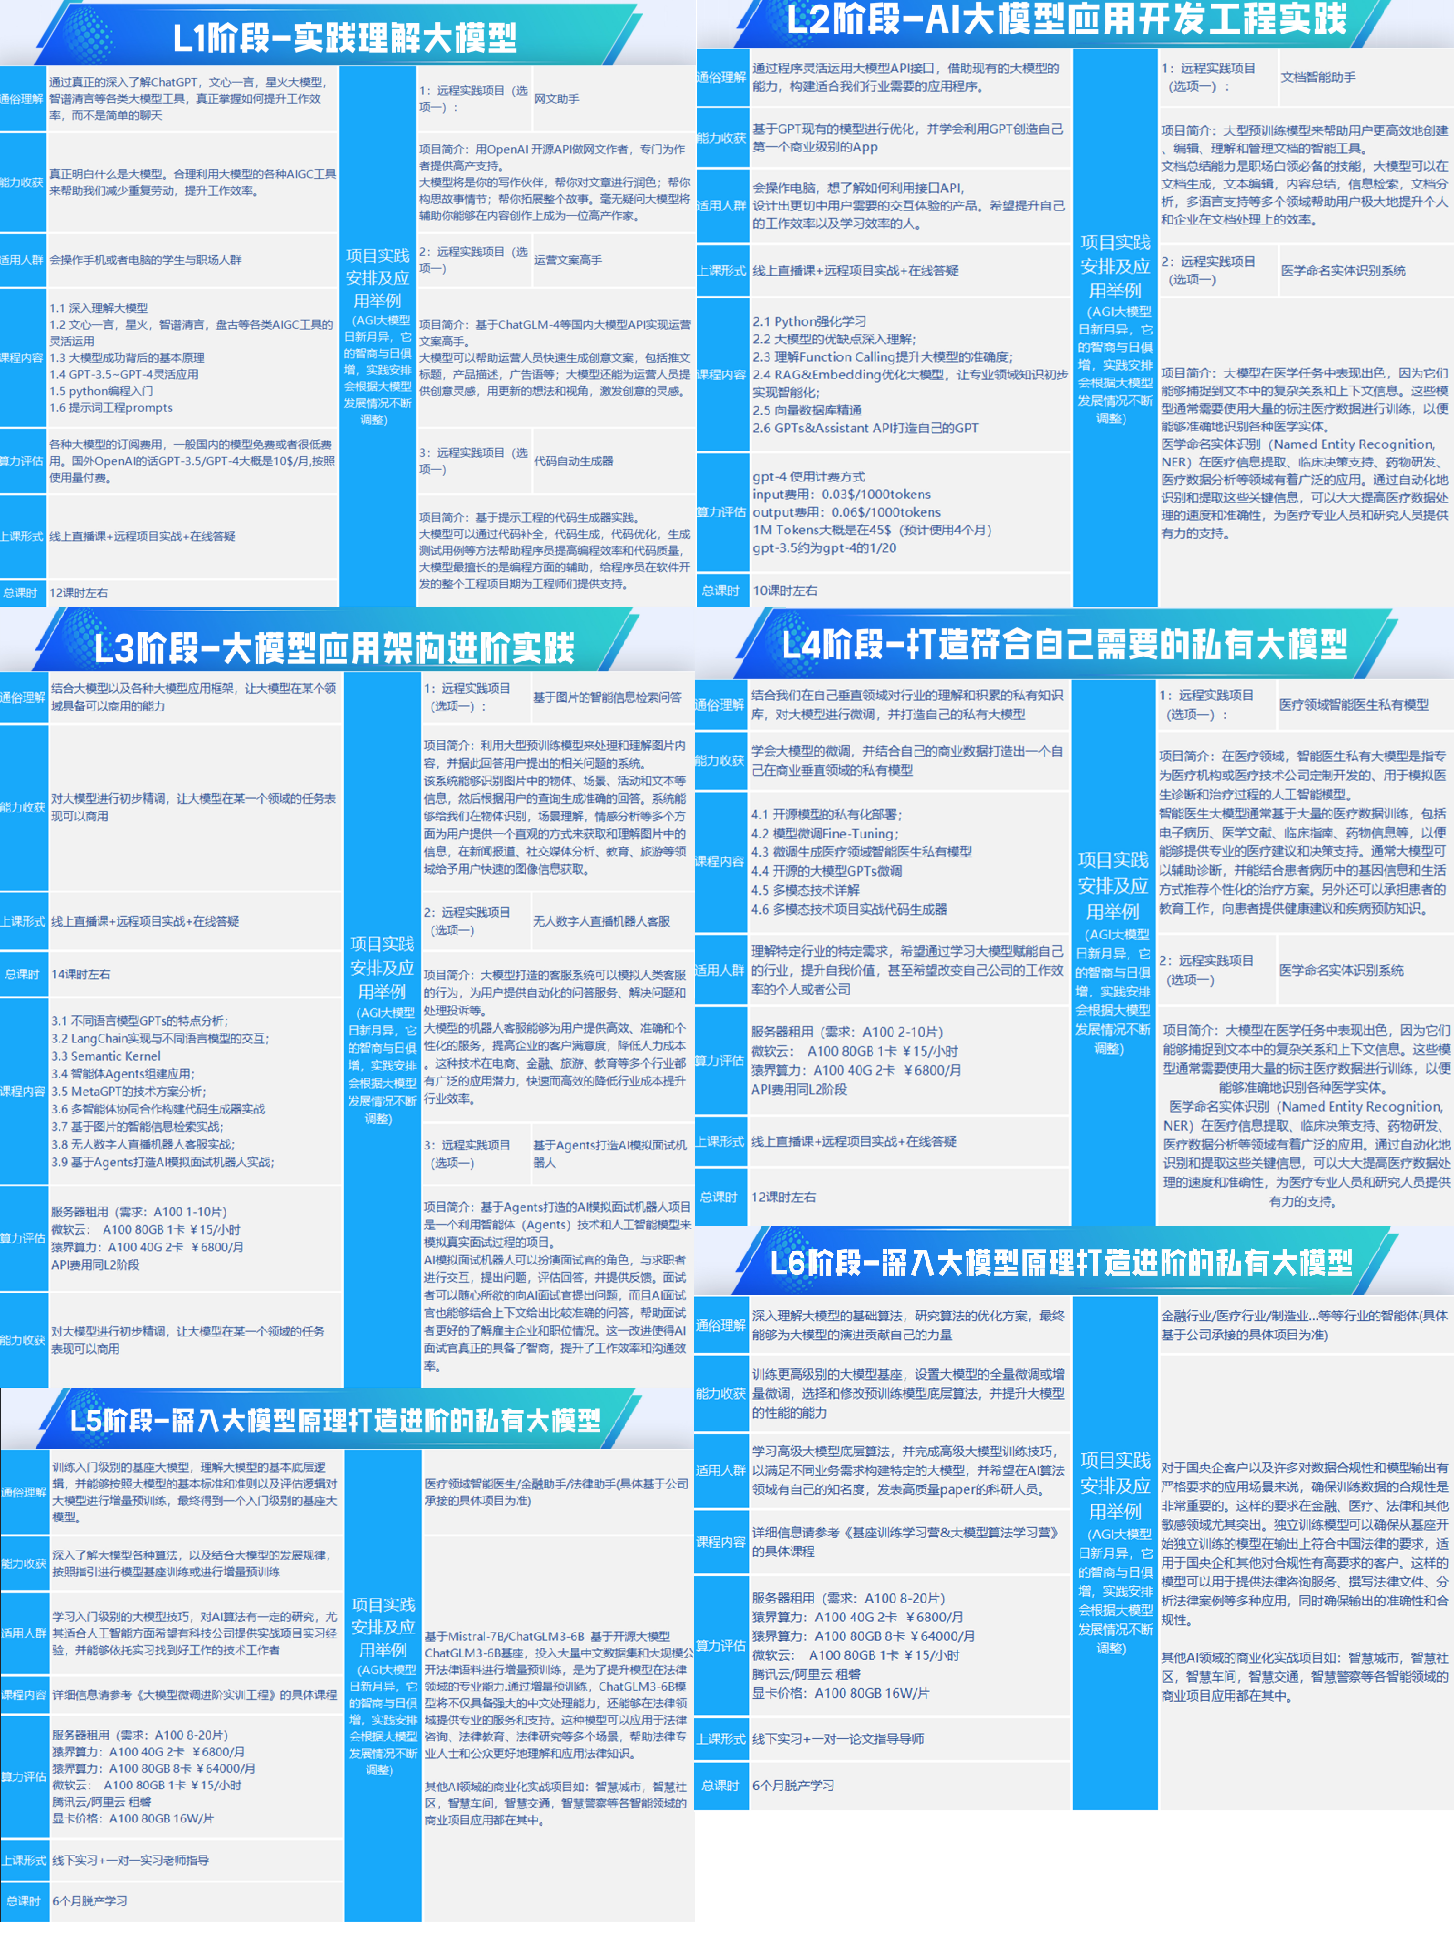
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
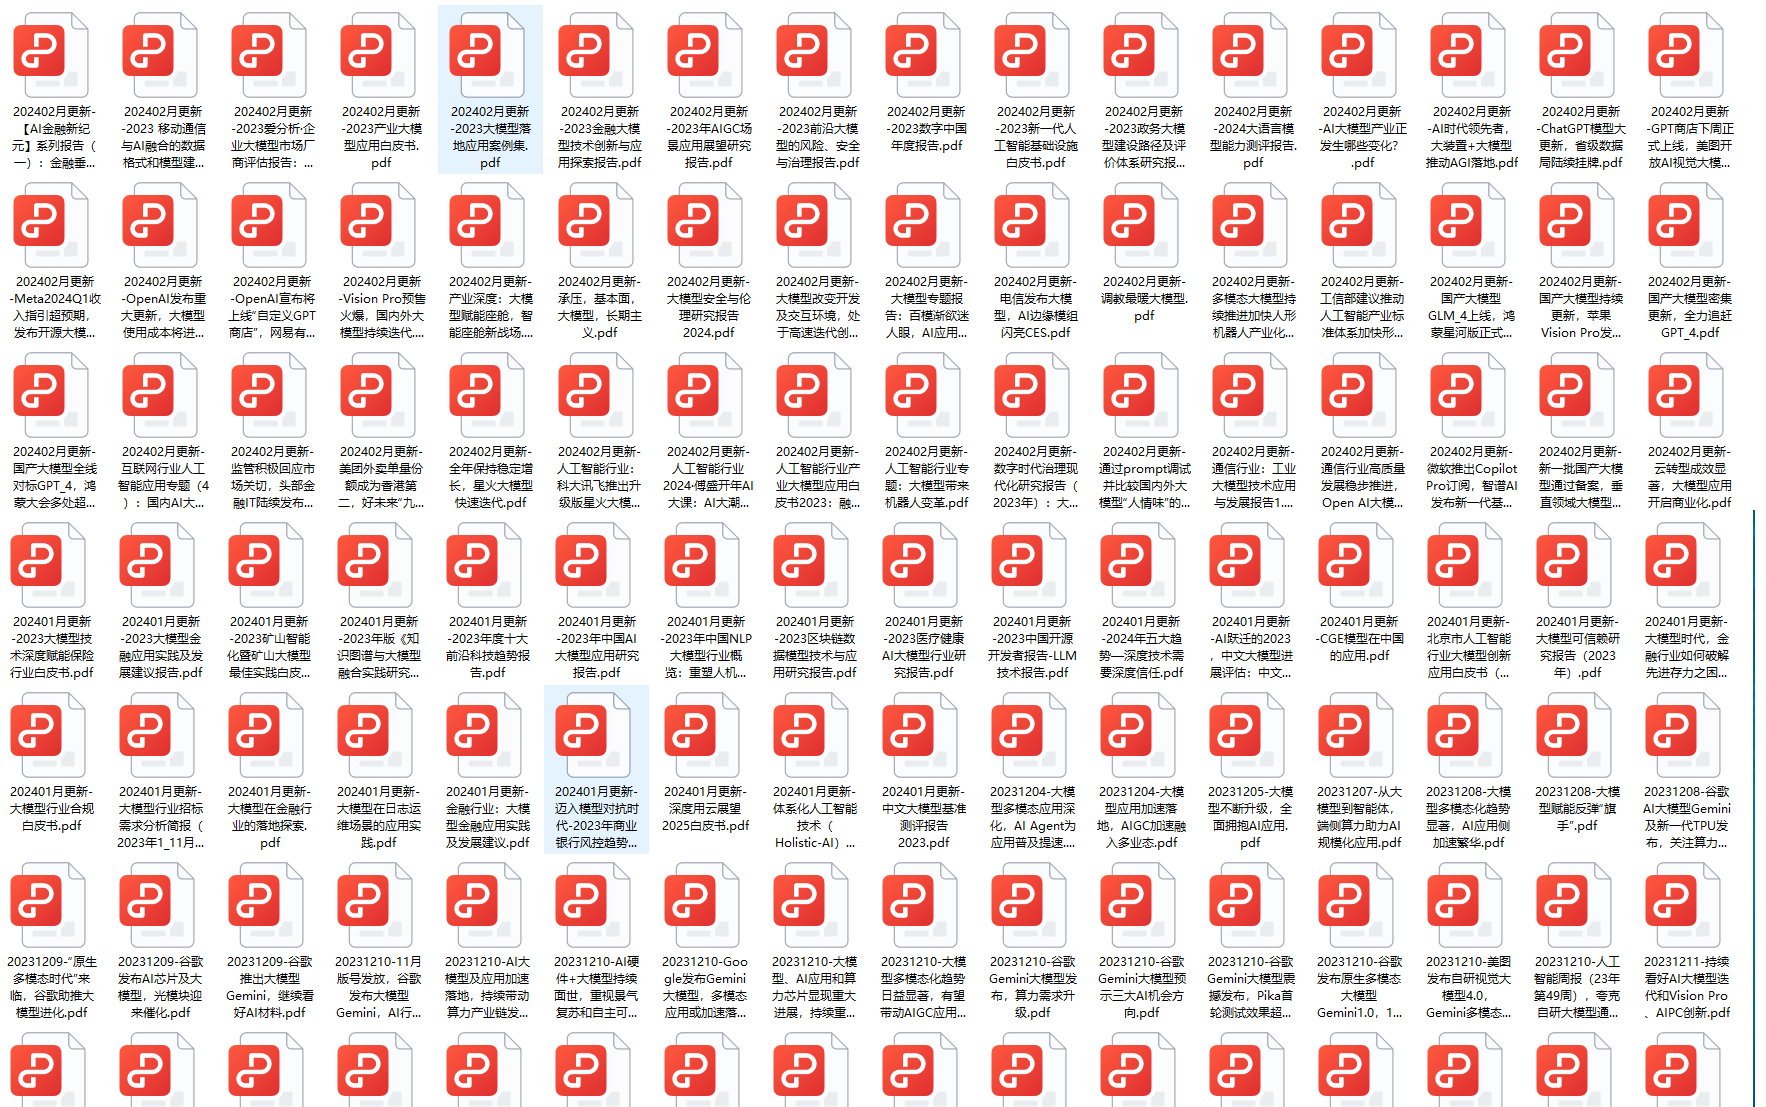
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
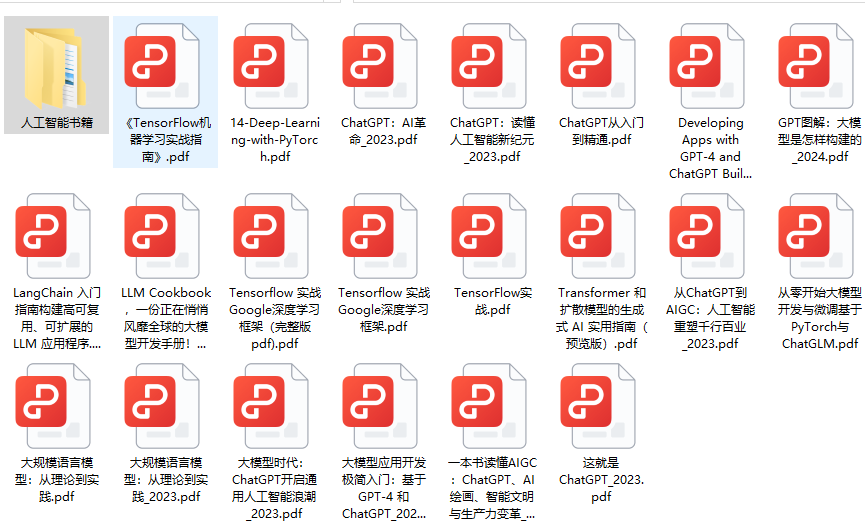
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

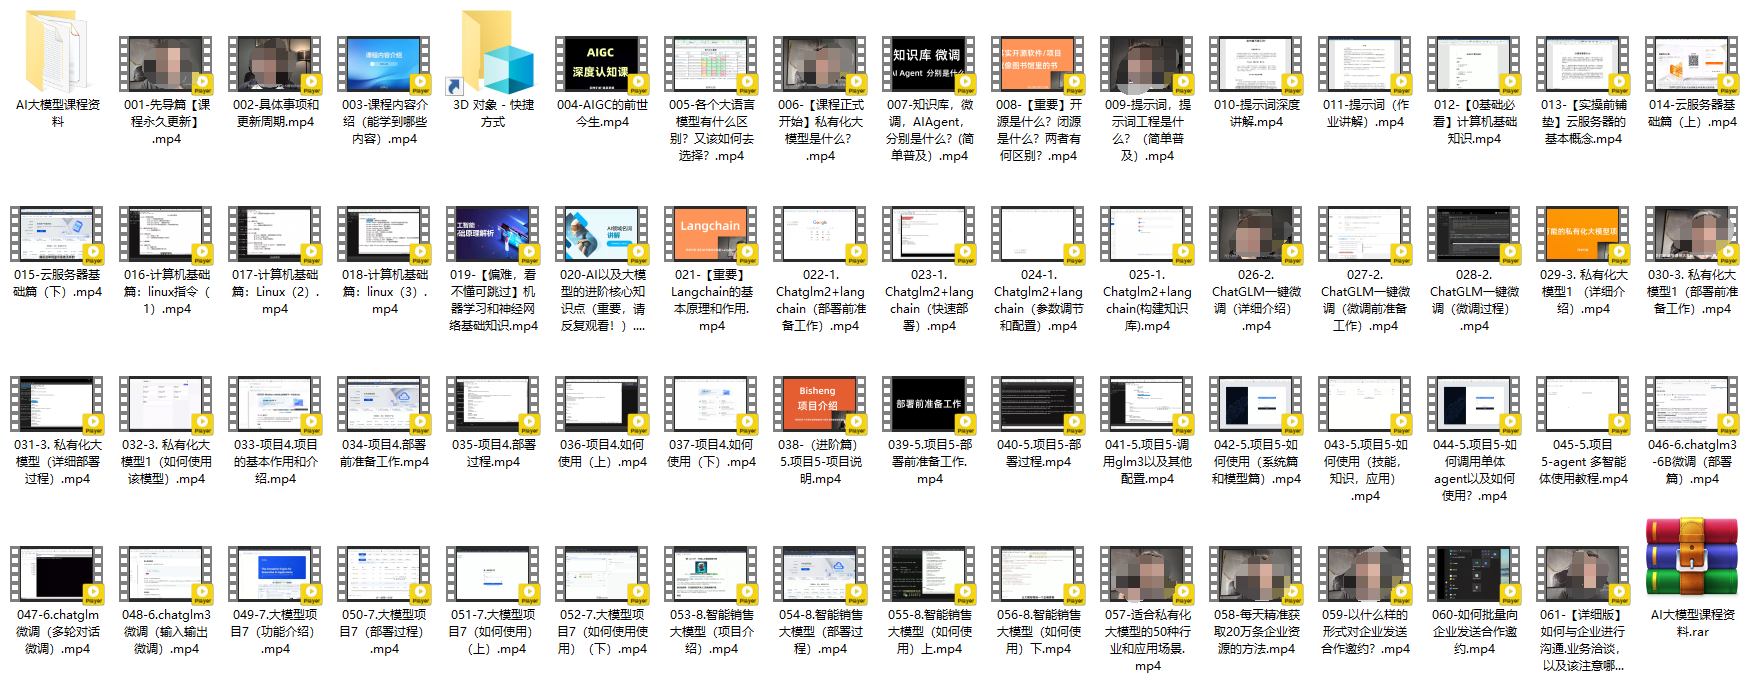
四、AI大模型商业化落地方案
阶段1:AI大模型时代的基础理解
- 目标:了解AI大模型的基本概念、发展历程和核心原理。
- 内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践 - L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
- 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
- 内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例 - L2.2 Prompt框架
- L2.2.1 什么是Prompt
- L2.2.2 Prompt框架应用现状
- L2.2.3 基于GPTAS的Prompt框架
- L2.2.4 Prompt框架与Thought
- L2.2.5 Prompt框架与提示词 - L2.3 流水线工程
- L2.3.1 流水线工程的概念
- L2.3.2 流水线工程的优点
- L2.3.3 流水线工程的应用 - L2.4 总结与展望
- L2.1 API接口
阶段3:AI大模型应用架构实践
- 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
- 内容:
- L3.1 Agent模型框架
- L3.1.1 Agent模型框架的设计理念
- L3.1.2 Agent模型框架的核心组件
- L3.1.3 Agent模型框架的实现细节 - L3.2 MetaGPT
- L3.2.1 MetaGPT的基本概念
- L3.2.2 MetaGPT的工作原理
- L3.2.3 MetaGPT的应用场景 - L3.3 ChatGLM
- L3.3.1 ChatGLM的特点
- L3.3.2 ChatGLM的开发环境
- L3.3.3 ChatGLM的使用示例 - L3.4 LLAMA
- L3.4.1 LLAMA的特点
- L3.4.2 LLAMA的开发环境
- L3.4.3 LLAMA的使用示例 - L3.5 其他大模型介绍
- L3.1 Agent模型框架
阶段4:AI大模型私有化部署
- 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
- 内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
学习计划:
- 阶段1:1-2个月,建立AI大模型的基础知识体系。
- 阶段2:2-3个月,专注于API应用开发能力的提升。
- 阶段3:3-4个月,深入实践AI大模型的应用架构和私有化部署。
- 阶段4:4-5个月,专注于高级模型的应用和部署。
这份完整版的大模型 LLM 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
😝有需要的小伙伴,可以Vx扫描下方二维码免费领取🆓

 8万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


